Cada vez que subes una foto y una aplicación nombra al instante los objetos que contiene, ha ocurrido algo silenciosamente notable. Una máquina sin ojos, sin sistema nervioso y sin experiencia vivida ha observado una cuadrícula de números de colores y ha extraído significado de ella. Ese proceso no es magia. Es un conjunto específico y aprendible de operaciones matemáticas que los investigadores llevaron décadas perfeccionando. Entender cómo sabe la IA cómo son las cosas revela algo sorprendente: la visión resulta tener mucho más que ver con la estadística que con la percepción.
Qué significa realmente "ver" para una máquina
Los píxeles son solo números
Para un equipo, una imagen no es más que una cuadrícula rectangular de números. Cada píxel contiene tres valores que representan la intensidad de rojo, verde y azul en una escala de 0 a 255. Una fotografía de 1920x1080 contiene más de seis millones de estos valores. En ninguno de ellos existe un concepto de "un gato" o "una silla". El significado tiene que construirse desde cero, capa a capa.
Ese es el desafío fundamental de la visión artificial: convertir datos numéricos en bruto en comprensión semántica. Durante mucho tiempo, los ingenieros intentaron escribir reglas explícitas. "Si ves una forma redonda sobre dos líneas verticales con una base plana, probablemente sea una lámpara." No funcionó. Los objetos del mundo real presentan una variación infinita en ángulo, iluminación, oclusión y contexto. Las reglas siempre fallaban.
Patrones ocultos a plena vista
El avance llegó cuando los investigadores dejaron de escribir reglas y empezaron a dejar que las máquinas encontraran patrones por su cuenta. En lugar de especificar cómo es un perro, le muestras a una red neuronal diez millones de fotos de perros etiquetadas y dejas que descubra qué patrones numéricos predicen de forma fiable la etiqueta "perro".
Suena sencillo. La implementación no lo es. La red necesita una arquitectura que respete la estructura espacial de las imágenes, datos de entrenamiento a una escala masiva y estrategias de optimización que le impidan simplemente memorizar ejemplos en lugar de generalizar a casos nuevos.
Cómo aprenden las redes neuronales a reconocer imágenes
Entrenamiento con millones de ejemplos
La palabra "entrenamiento" en el aprendizaje automático es un término técnico preciso. Significa ejecutar un algoritmo de optimización, normalmente una forma de descenso de gradiente estocástico, que ajusta gradualmente millones de valores internos de pesos hasta que las salidas de la red coinciden con las etiquetas correctas de un conjunto de entrenamiento. El proceso es iterativo. Le das a la red una imagen, comparas su predicción con la respuesta correcta, mides el error y actualizas los pesos para reducirlo. Se repite miles de millones de veces.
La escala necesaria es asombrosa. ImageNet, uno de los conjuntos de datos de entrenamiento más importantes, contiene más de catorce millones de imágenes etiquetadas en veintiún mil categorías. Los grandes modelos de visión actuales se entrenan con conjuntos de datos órdenes de magnitud mayores, extraídos de la web y procesados mediante canalizaciones de filtrado automatizadas.
Lo que hace realmente una capa convolucional
La mayoría de los sistemas de reconocimiento de imágenes se basan en redes neuronales convolucionales (CNN). La capa convolucional es su innovación central. En lugar de conectar cada píxel con cada neurona (lo que sería computacionalmente catastrófico para imágenes grandes), una capa convolucional desliza un filtro pequeño, normalmente de 3x3 o 5x5 píxeles, por la imagen y calcula un producto escalar en cada posición.
💡 Piénsalo así: un filtro de 3x3 que se activa cuando ve un borde horizontal producirá una respuesta fuerte allí donde aparezcan bordes horizontales en la imagen, y una respuesta débil en el resto. Apila cientos de filtros de este tipo y obtendrás un mapa rico de dónde aparece cada tipo de borde, gradiente y textura.
Las primeras capas detectan cosas simples: bordes con distintas orientaciones, gradientes de color, pequeñas texturas repetitivas. Las capas más profundas combinan esas detecciones en representaciones cada vez más abstractas. En las capas finales, neuronas individuales responden a patrones complejos como "pelo con manchas" o "la forma general de una oreja".
De los rasgos de bajo nivel a los objetos completos
Esta extracción jerárquica de rasgos es la razón por la que las redes profundas generalizan tan bien. La representación aprendida en las capas intermedias no es específica de una sola tarea. Esos mapas de rasgos de "textura de pelo" y "forma de ojo" pueden reutilizarse para clasificar razas, identificar especies o incluso generar nuevas imágenes de animales. Esta es la base del aprendizaje por transferencia, una de las ideas más útiles en la IA moderna.
El papel de los datos de entrenamiento
Por qué la escala lo cambia todo
Antes de 2012 aproximadamente, la mayoría de los clasificadores de imágenes podían manejar decenas de categorías con una precisión modesta. Cuando AlexNet ganó la competición de ImageNet ese año usando una CNN profunda entrenada en GPU, la tasa de error top-5 bajó más de diez puntos porcentuales respecto al siguiente competidor. La arquitectura importó, pero también el volumen puro de ejemplos de entrenamiento.
| Era | Tamaño del conjunto de datos | Error top-5 típico |
|---|
| Previa al aprendizaje profundo (2010) | ~1M de imágenes etiquetadas | ~28% |
| Era inicial de las CNN (2012) | 1,2M (ImageNet) | ~17% |
| Modelos de visión modernos (2024+) | Miles de millones de imágenes | ~1-2% |
La escala obliga a la red a encontrarse con casos límite poco frecuentes, ángulos inusuales, fondos diversos y extremos de iluminación. Un modelo entrenado solo con fotos de gatos en estudio fallará con un gato visto a través de la ventanilla de un coche bajo la lluvia. El volumen no es solo una comodidad; es el mecanismo que produce la robustez.
Cuando el sesgo envenena el modelo
Los datos de entrenamiento tienen una debilidad profunda: reflejan a quien los recopiló. Si un conjunto de datos de reconocimiento facial está compuesto sobre todo por rostros de piel clara fotografiados en interiores, el modelo funcionará mal con tonos de piel más oscuros y en condiciones exteriores. Esto no es una preocupación filosófica. Es un modo de fallo medible y documentado, con consecuencias reales en herramientas de contratación, sistemas de seguridad e imagen médica.
El problema va más allá de la demografía. Los modelos entrenados con imágenes de la web heredan los sesgos de lo que se fotografía y se comparte. Los perros aparecen con más frecuencia que los leopardos de las nieves. Las salas de estar aparecen con más frecuencia que los talleres de forja. El sentido interno que tiene el modelo de "cómo son las cosas" está moldeado por completo por la distribución de su conjunto de entrenamiento.
Detección de objetos frente a clasificación de imágenes
Nombrar una cosa frente a encontrarla
La clasificación de imágenes responde a una sola pregunta: ¿cuál es el sujeto dominante de esta imagen? La salida es una etiqueta de categoría, a menudo con una puntuación de confianza. La detección de objetos es más difícil. Responde: ¿dónde están todos los objetos de esta imagen y qué es cada uno de ellos?
La detección requiere que el modelo genere cuadros delimitadores junto con las etiquetas. Detectores modernos como YOLO (You Only Look Once) logran esto en una sola pasada hacia delante por la red, por lo que pueden funcionar en tiempo real sobre flujos de video.
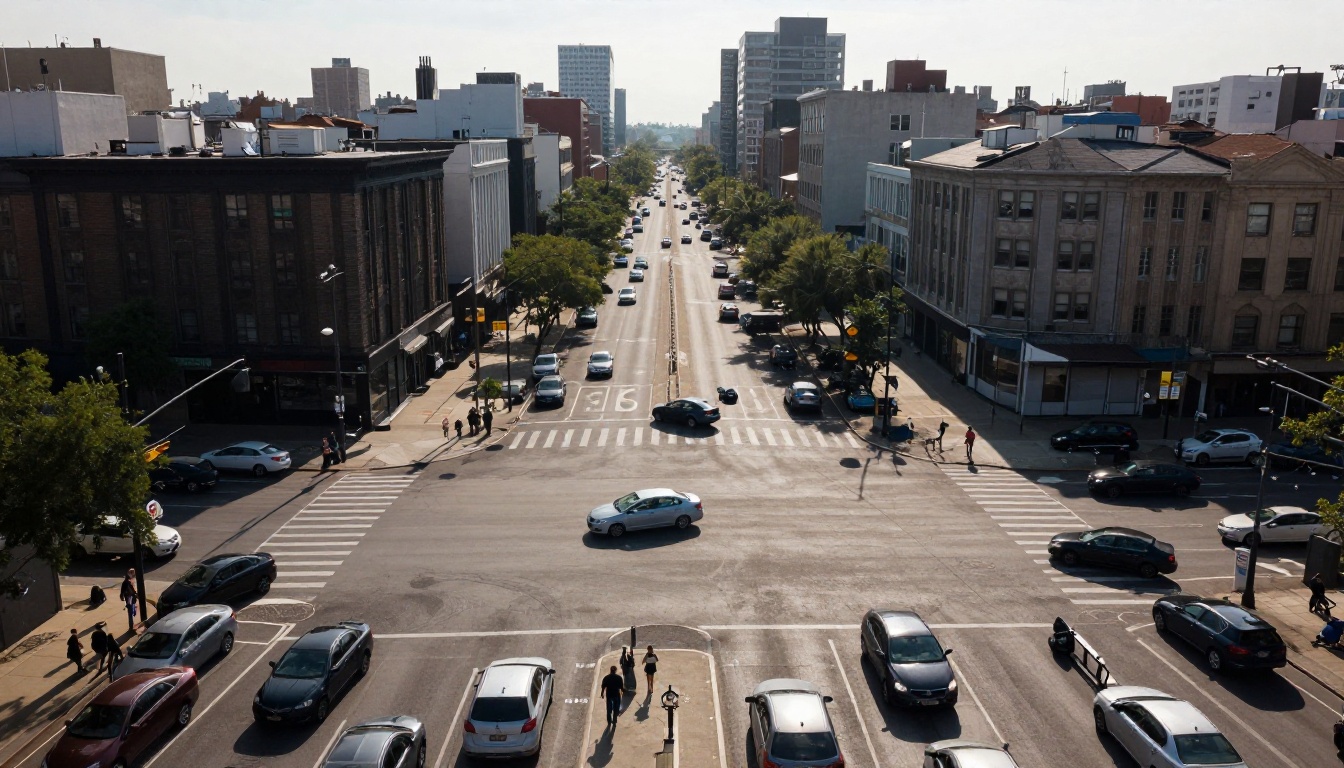
La escena urbana aérea de arriba ilustra el desafío. Cada peatón, vehículo y línea de paso de cebra tendría que ser localizado y etiquetado individualmente por un sistema de detección, a pesar de siluetas superpuestas, variaciones de tamaño y sombras que ocultan partes de cada sujeto.
Reconocimiento en tiempo real en entornos reales
Desplegar el reconocimiento en el mundo real añade restricciones que los benchmarks de laboratorio ignoran. La latencia debe ser lo bastante baja para la aplicación: un coche autónomo necesita decisiones en milisegundos. La memoria debe caber en el presupuesto de hardware del dispositivo de destino. La precisión debe mantenerse con cambios de clima, iluminación inusual y daños en la cámara.
Por eso el campo se ha desplazado hacia arquitecturas ligeras diseñadas para despliegue en el borde, y por eso los modelos están cada vez más cuantizados: se comprimen los valores de los pesos de números de coma flotante de 32 bits a enteros de 8 bits para reducir el uso de memoria y acelerar la inferencia sin una pérdida catastrófica de precisión.
Cómo los generadores de imágenes con IA aplican el conocimiento visual
Ver al revés
Entender cómo sabe la IA cómo son las cosas resulta especialmente interesante cuando se aplica a los modelos generativos. Un sistema de texto a imagen no solo reconoce objetos; los reconstruye a partir de una descripción. Para hacerlo de forma convincente, debe haber interiorizado un modelo estadístico profundo de cómo es realmente cada objeto, superficie, condición de iluminación y composición fotográfica.
Por eso los modelos entrenados con conjuntos de datos más grandes y diversos producen resultados más fotorrealistas. Su representación interna de "cómo son las cosas" es más rica, así que sus reconstrucciones son más precisas en temas inusuales y condiciones de iluminación variadas.
Por qué Flux Pro acierta con los rostros
Toma Flux Pro como ejemplo concreto. Su buen rendimiento con rostros humanos se debe en parte a su distribución de entrenamiento. Los rostros están entre los temas más fotografiados de la web, con una enorme variedad de iluminación, ángulos, expresiones y tonos de piel. El modelo ha visto suficiente variación como para construir un modelo estadístico detallado de la geometría facial, la textura de la piel y la forma en que la luz interactúa con las distintas estructuras del rostro.
Compáralo con Stable Diffusion, una referencia más antigua con datos de entrenamiento más pequeños y una arquitectura menos expresiva. Los rostros son notablemente más suaves, y los dedos a menudo fallan en las primeras versiones, porque el modelo tiene una representación interna más débil de la anatomía de la mano y de los detalles finos.
Flux 1.1 Pro Ultra va más allá, produciendo resultados de 4 megapíxeles en los que la textura de los poros de la piel resulta creíble. No añade detalle al azar; muestrea de su distribución aprendida de cómo es la piel fotográfica a muy alta resolución.
Modelos que vale la pena probar hoy
Varios modelos de la plataforma muestran distintas facetas del conocimiento visual de la IA:
| Modelo | Fortaleza | Ideal para |
|---|
| Flux Dev | Adherencia al prompt, composición | Escenas complejas con varios objetos |
| Flux Schnell | Velocidad, generación en 4 pasos | Iteración rápida |
| Imagen 4 | Iluminación natural, mucho detalle | Retratos fotorrealistas |
| SDXL | Flexibilidad de estilo | Composiciones artísticas |
| Ideogram v3 Quality | Renderizado de texto, realismo | Imágenes con palabras legibles |
| Recraft v4 | Precisión lista para impresión | Diseño y recursos de marca |
Reconocimiento de rostros y cuerpos
Por qué los rostros son especialmente difíciles
Los rostros son, a la vez, la categoría de objeto más estudiada en la visión artificial y una de las más exigentes desde el punto de vista técnico. Todo rostro humano comparte la misma estructura básica (dos ojos sobre una nariz, sobre una boca), lo que significa que pequeñas diferencias transmiten muchísima información. Reconocer a una persona concreta exige que el modelo sea sensible a variaciones sutiles entre individuos, pero que siga siendo robusto ante variaciones grandes dentro de un mismo individuo (la misma persona a distintas edades, con distintas expresiones, bajo distinta iluminación).
La geometría también importa. Un rostro visto a 45 grados se ve muy distinto del mismo rostro visto de frente. Los primeros sistemas de reconocimiento necesitaban una vista más o menos frontal. Los sistemas modernos manejan cualquier pose estimando primero un modelo 3D del rostro a partir de la imagen 2D, un proceso que a su vez se apoya en priors aprendidos sobre la geometría facial durante el entrenamiento.
Pose, profundidad y conciencia espacial
Más allá de los rostros, entender la pose corporal exige localizar las posiciones de las articulaciones (hombros, codos, muñecas, caderas, rodillas, tobillos) e inferir su configuración 3D a partir de una imagen 2D. Esto es fundamentalmente ambiguo desde un único punto de vista: un brazo levantado y un brazo escorzado pueden verse idénticos desde ciertos ángulos. Los modelos resuelven esta ambigüedad usando priors estadísticos aprendidos de miles de cuerpos humanos capturados con captura de movimiento.
La estimación de profundidad a partir de una sola imagen funciona de forma parecida. No hay señales estéreo ni paralaje de movimiento. El modelo usa atajos aprendidos: los objetos situados más arriba en el encuadre tienden a estar más lejos, los objetos de tamaño conocido como puertas y personas ofrecen información implícita de escala, y la neblina atmosférica aumenta con la distancia. Ninguna de estas señales está codificada de forma fija. Se absorben de la distribución de entrenamiento.
3 lugares donde la IA visual todavía falla
La trampa de la textura
Uno de los primeros casos de fallo documentados: las texturas adversarias. Los investigadores demostraron que, imprimiendo un patrón específico sobre un objeto 3D, podían hacer que una red neuronal lo clasificara con confianza de forma errónea. Una tortuga cubierta con la textura adecuada fue clasificada como un rifle. El modelo se apoyaba mucho en las estadísticas de textura en lugar de en la forma, lo que deja al descubierto una fragilidad que la visión humana no comparte.
En la práctica, esto se manifiesta cuando un modelo entrenado sobre todo con fotografías clasifica mal materiales en pinturas o superficies naturales poco habituales. Una pared de hormigón rugosa fotografiada en ángulo rasante puede etiquetarse con confianza como "corteza de árbol" porque las estadísticas de textura de bajo nivel coinciden.
Entradas fuera de la distribución
Las redes neuronales son interpoladores seguros dentro de su distribución de entrenamiento y extrapoladores poco fiables fuera de ella. Un modelo que nunca ha visto un tipo concreto de equipo industrial seguirá produciendo una etiqueta con confianza, normalmente algo visualmente parecido dentro de su conjunto de entrenamiento. En un clasificador estándar no existe un mecanismo integrado para expresar incertidumbre.
💡 Por eso importa la calibración. Los sistemas bien desplegados combinan la salida de clasificación con una puntuación de confianza calibrada y envían las predicciones de baja confianza a revisión humana, en lugar de actuar sobre ellas de forma automática.
Cómo aprenden los modelos a recuperarse
La respuesta del campo a estos modos de fallo consiste, en gran medida, en más datos y datos más variados. El aumento de datos (voltear, recortar, desplazar el color y añadir ruido a las imágenes de entrenamiento de forma aleatoria) obliga al modelo a aprender rasgos que se mantienen estables ante las transformaciones. Mixup y CutMix mezclan dos imágenes de entrenamiento y entrenan la red con la etiqueta mezclada, suavizando las fronteras de decisión.
Enfoques más recientes usan el preentrenamiento autosupervisado, en el que el modelo aprende de imágenes sin etiquetar resolviendo tareas auxiliares, como predecir regiones enmascaradas. Las representaciones resultantes son más robustas porque tienen que dar cuenta de toda la distribución del contenido de la imagen, y no solo de los rasgos relevantes para la clasificación.
Prueba a crear tu propio resultado de IA visual
Ahora que entiendes lo que realmente ocurre cuando una IA procesa una escena visual, puedes interactuar con los generadores de imágenes de forma más deliberada. El resultado del modelo no es aleatorio; es un muestreo de una distribución aprendida de cómo son las cosas. Tu prompt es un conjunto de restricciones que estrechan esa distribución hacia la imagen que tienes en mente.
Describir la dirección de la luz ("contraluz cálido de hora dorada desde la izquierda"), las características del objetivo de la cámara ("85 mm f/1.8 con profundidad de campo reducida") y las texturas de las superficies ("poros naturales visibles, mechones de pelo nítidos") activa regiones específicas de la representación visual aprendida por el modelo. Cuanto más precisamente describes cómo se ven físicamente las cosas, más puede recurrir el modelo a las partes más densas y detalladas de su distribución de entrenamiento.
Flux Dev y Flux Pro responden bien a los prompts con fundamento físico. Imagen 4 es especialmente bueno con condiciones de iluminación natural. Para retratos, Flux 1.1 Pro Ultra produce la textura de piel y cabello de mayor fidelidad, apoyándose en su modelo interno más rico de la apariencia humana.
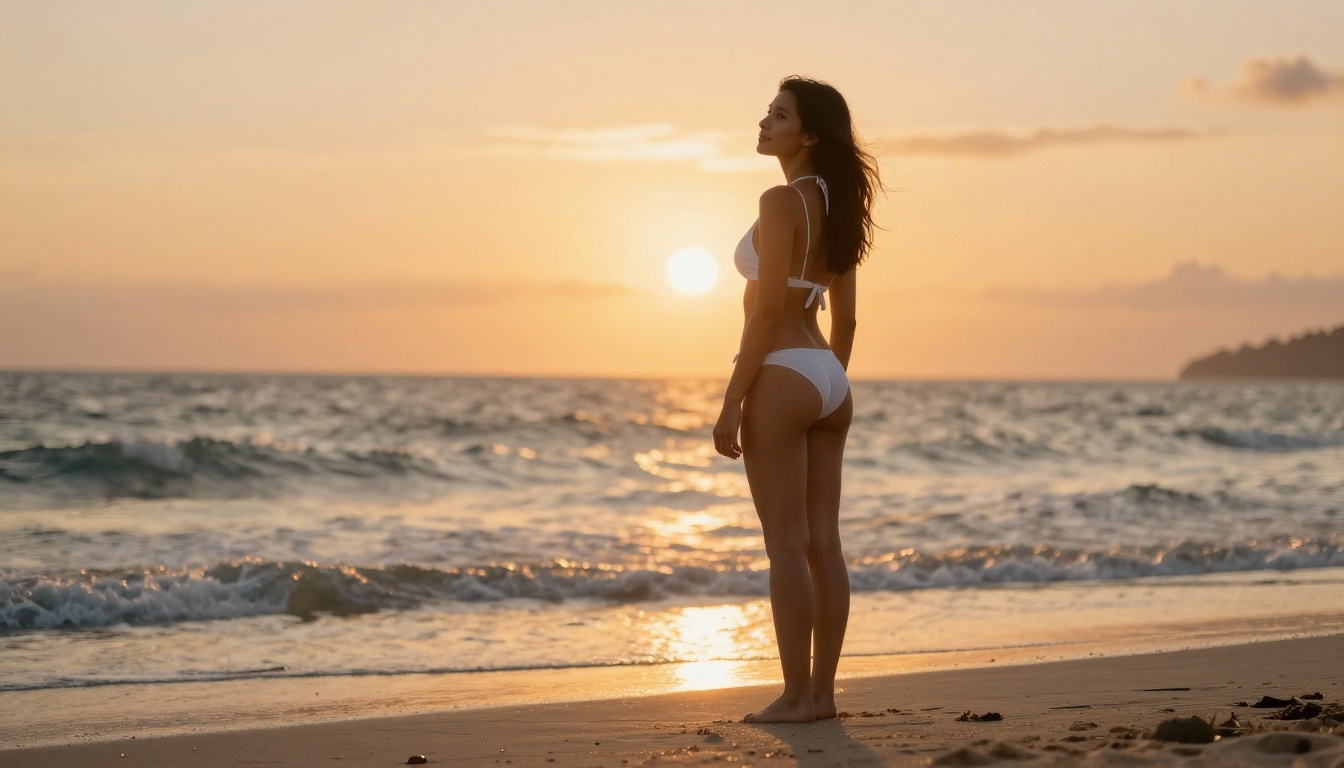
La mejor forma de desarrollar intuición es ejecutar el mismo prompt en varios modelos y comparar dónde pone cada uno el énfasis. Las diferencias revelan algo real sobre lo que cada modelo "sabe" a partir de sus datos de entrenamiento. Ve a Picasso IA, elige un modelo de la colección de texto a imagen y empieza a experimentar con prompts descriptivos desde el punto de vista físico. Lo que ves en el resultado es un reflejo directo de lo que el modelo ha aprendido sobre el mundo visual.


