Chaque fois que vous importez une photo et qu’une application nomme instantanément les objets qu’elle contient, quelque chose de remarquable s’est produit discrètement. Une machine sans yeux, sans système nerveux et sans expérience vécue a examiné une grille de nombres colorés et en a tiré du sens. Ce processus n’a rien de magique. Il s’agit d’un ensemble précis d’opérations mathématiques, que l’on peut apprendre, et que les chercheurs ont affinées pendant des décennies. Comprendre comment l’IA sait à quoi ressemblent les choses révèle quelque chose de surprenant : la vision repose bien plus sur les statistiques que sur la perception.
Ce que « voir » signifie réellement pour une machine
Les pixels ne sont que des nombres
Pour un ordinateur, une image n’est rien d’autre qu’une grille rectangulaire de nombres. Chaque pixel contient trois valeurs, qui représentent l’intensité du rouge, du vert et du bleu sur une échelle de 0 à 255. Une photo de 1920x1080 contient plus de six millions de ces valeurs. Aucune d’elles ne porte la notion de « un chat » ou de « une chaise ». Le sens doit être construit à partir de zéro, couche après couche.
C’est le défi fondamental de la vision par ordinateur : transformer des données numériques brutes en une compréhension sémantique. Pendant longtemps, les ingénieurs ont tenté d’écrire des règles explicites. « Si vous voyez une forme ronde au-dessus de deux lignes verticales avec une base plate, il s’agit probablement d’une lampe. » Cela n’a pas fonctionné. Les objets du monde réel varient à l’infini selon l’angle, l’éclairage, les occultations et le contexte. Les règles finissaient toujours par céder.
Des motifs sous les yeux de tous
La percée est venue lorsque les chercheurs ont cessé d’écrire des règles et ont commencé à laisser les machines trouver des motifs par elles-mêmes. Au lieu de décrire à quoi ressemble un chien, on montre à un réseau de neurones dix millions de photos de chiens étiquetées, et on le laisse déterminer quels motifs numériques prédisent de façon fiable l’étiquette « chien ».
Cela paraît simple. La mise en œuvre ne l’est pas. Le réseau a besoin d’une architecture qui respecte la structure spatiale des images, de données d’entraînement à très grande échelle et de stratégies d’optimisation qui l’empêchent de simplement mémoriser des exemples au lieu de généraliser à de nouveaux cas.
S’entraîner sur des millions d’exemples
Le mot « entraînement » en apprentissage automatique est un terme technique précis. Il désigne l’exécution d’un algorithme d’optimisation, généralement une forme de descente de gradient stochastique, qui ajuste progressivement des millions de valeurs de poids internes jusqu’à ce que les sorties du réseau correspondent aux bonnes étiquettes d’un jeu d’entraînement. Le processus est itératif. On soumet une image au réseau, on compare sa prédiction à la bonne réponse, on mesure l’erreur, puis on met à jour les poids pour la réduire. On répète l’opération des milliards de fois.
L’échelle requise est vertigineuse. ImageNet, l’un des jeux de données d’entraînement de référence, contient plus de quatorze millions d’images étiquetées réparties en vingt et un mille catégories. Les grands modèles de vision actuels s’entraînent sur des jeux de données de plusieurs ordres de grandeur supérieurs, collectés sur le web et traités par des chaînes de filtrage automatisées.
Ce que fait réellement une couche convolutive
La plupart des systèmes de reconnaissance d’images reposent sur des réseaux de neurones convolutifs (CNN). La couche convolutive est leur innovation centrale. Plutôt que de relier chaque pixel à chaque neurone (ce qui serait catastrophique en calcul pour de grandes images), une couche convolutive fait glisser un petit filtre, généralement de 3x3 ou 5x5 pixels, sur l’image et calcule un produit scalaire à chaque position.
💡 Voyez-le ainsi : un filtre 3x3 qui s’active lorsqu’il repère un contour horizontal produira une forte réponse partout où de tels contours apparaissent dans l’image, et une réponse faible ailleurs. Empilez des centaines de filtres de ce type et vous obtenez une carte riche de l’emplacement de chaque sorte de contour, de dégradé et de texture.
Les premières couches détectent des éléments simples : des contours d’orientations variées, des dégradés de couleur, de petites textures répétitives. Les couches plus profondes combinent ces détections en représentations de plus en plus abstraites. Dans les dernières couches, certains neurones réagissent à des motifs complexes comme « une fourrure tachetée » ou « la forme générale d’une oreille ».
Des caractéristiques élémentaires aux objets complets
Cette extraction hiérarchique des caractéristiques explique pourquoi les réseaux profonds généralisent si bien. La représentation apprise dans les couches intermédiaires n’est propre à aucune tâche précise. Ces cartes de caractéristiques pour « la texture de la fourrure » ou « la forme de l’œil » peuvent être réutilisées pour classer des races, identifier des espèces, voire générer de nouvelles images d’animaux. C’est le principe de base du transfert d’apprentissage, l’une des idées les plus utiles en pratique dans l’IA moderne.
Le rôle des données d’entraînement
Pourquoi l’échelle change tout
Avant 2012 environ, la plupart des classifieurs d’images savaient gérer quelques dizaines de catégories avec une précision modeste. Lorsqu’AlexNet a remporté la compétition ImageNet cette année-là grâce à un CNN profond entraîné sur GPU, le taux d’erreur top-5 a chuté de plus de dix points de pourcentage par rapport au concurrent suivant. L’architecture comptait, mais le volume considérable d’exemples d’entraînement comptait tout autant.
| Époque | Taille du jeu de données | Erreur top-5 typique |
|---|
| Avant le deep learning (2010) | ~1 M d’images étiquetées | ~28 % |
| Ère des premiers CNN (2012) | 1,2 M (ImageNet) | ~17 % |
| Modèles de vision modernes (2024+) | Des milliards d’images | ~1-2 % |
L’échelle oblige un réseau à rencontrer des cas limites rares, des angles inhabituels, des arrière-plans variés et des éclairages extrêmes. Un modèle entraîné uniquement sur des photos de chats en studio échouera face à un chat aperçu à travers la vitre d’une voiture sous la pluie. Le volume n’est pas un simple confort : c’est le mécanisme qui produit la robustesse.
Quand les biais corrompent le modèle
Les données d’entraînement ont une faiblesse profonde : elles reflètent ceux qui les ont collectées. Si un jeu de données de reconnaissance faciale est composé majoritairement de visages à peau claire photographiés en intérieur, le modèle sera peu performant avec des teints plus foncés et en extérieur. Ce n’est pas une préoccupation philosophique. C’est un mode de défaillance mesurable et documenté, aux conséquences réelles dans les outils de recrutement, les systèmes de sécurité et l’imagerie médicale.
Le problème dépasse la question démographique. Les modèles entraînés sur des images du web héritent des biais de ce qui est photographié et partagé. On voit plus souvent des chiens que des léopards des neiges. On voit plus souvent des salons que des ateliers de forge. La notion interne que le modèle se fait de « l’apparence des choses » est entièrement façonnée par la distribution de son jeu d’entraînement.
Détection d’objets ou classification d’images ?
Nommer une chose ou la localiser
La classification d’images répond à une seule question : quel est le sujet dominant de cette image ? Le résultat est une étiquette de catégorie, souvent accompagnée d’un score de confiance. La détection d’objets est plus exigeante. Elle répond à cette question : où se trouvent tous les objets de cette image, et de quoi s’agit-il pour chacun d’eux ?
La détection exige que le modèle produise des boîtes englobantes en plus des étiquettes. Les détecteurs modernes comme YOLO (You Only Look Once) y parviennent en un seul passage avant dans le réseau, ce qui leur permet de fonctionner en temps réel sur des flux vidéo.
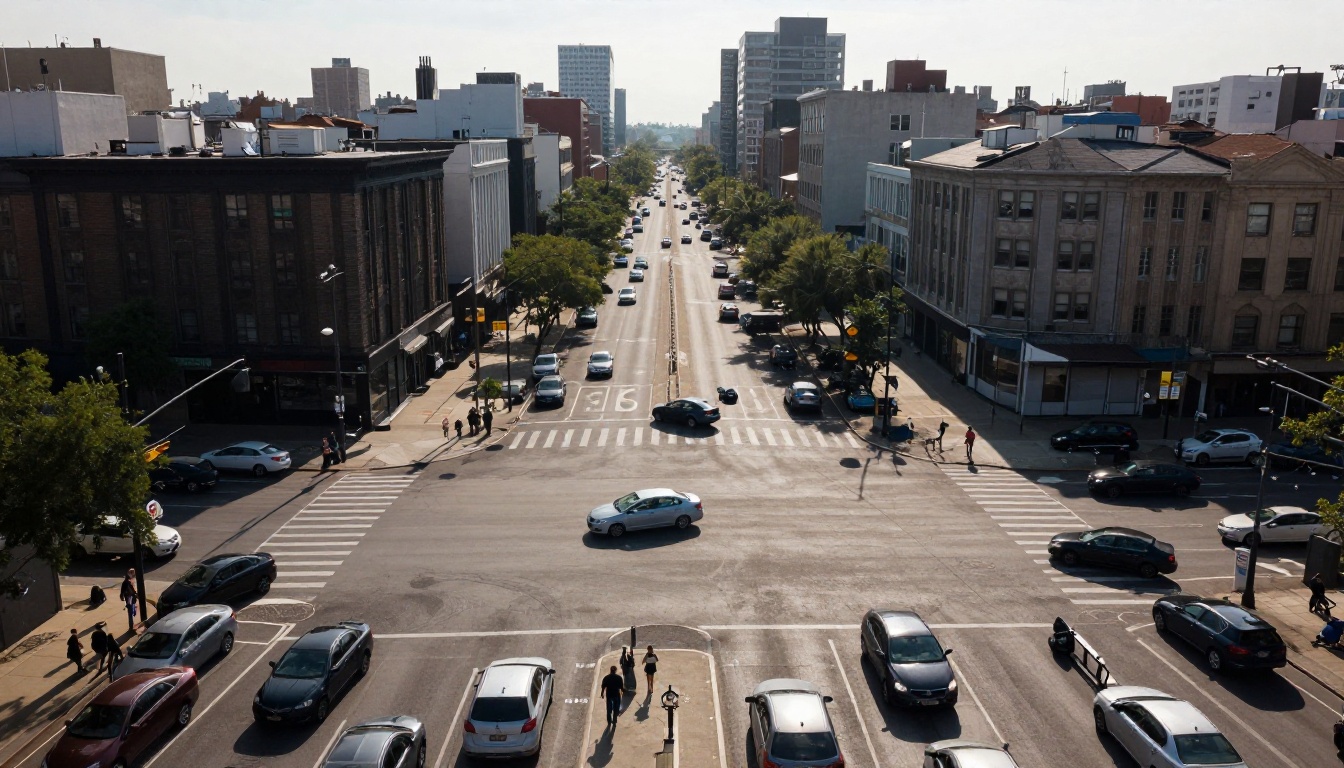
La scène urbaine aérienne ci-dessus illustre ce défi. Chaque piéton, véhicule et passage piéton devrait être localisé et étiqueté individuellement par un système de détection, malgré des silhouettes qui se chevauchent, des tailles variées et des ombres qui masquent certaines parties de chaque sujet.
La reconnaissance en temps réel, en conditions réelles
Déployer la reconnaissance dans le monde réel ajoute des contraintes que les benchmarks de laboratoire ignorent. La latence doit être suffisamment faible pour l’application : une voiture autonome a besoin de décisions en quelques millisecondes. La mémoire doit tenir dans le budget matériel de l’appareil cible. La précision doit se maintenir face aux changements météo, aux éclairages inhabituels et aux dégradations de la caméra.
C’est pourquoi le domaine s’est orienté vers des architectures légères, conçues pour un déploiement en périphérie, et pourquoi les modèles sont de plus en plus quantifiés : les valeurs de poids passent de flottants 32 bits à des entiers 8 bits, ce qui réduit l’usage de la mémoire et accélère l’inférence sans perte de précision catastrophique.
Voir à rebours
Comprendre comment l’IA sait à quoi ressemblent les choses devient particulièrement intéressant lorsqu’on l’applique aux modèles génératifs. Un système de texte vers image ne se contente pas de reconnaître des objets : il les reconstruit à partir d’une description. Pour y parvenir de façon convaincante, il doit avoir intériorisé un modèle statistique profond de ce à quoi ressemblent réellement chaque objet, chaque surface, chaque condition d’éclairage et chaque composition photographique.
C’est pourquoi les modèles entraînés sur des jeux de données plus vastes et plus variés produisent des résultats plus photoréalistes. Leur représentation interne de « l’apparence des choses » est plus riche, de sorte que leurs reconstructions sont plus précises pour des sujets inhabituels et des conditions d’éclairage variées.
Pourquoi Flux Pro rend bien les visages
Prenons Flux Pro comme exemple concret. Ses bons résultats sur les visages humains tiennent en partie à sa distribution d’entraînement. Les visages figurent parmi les sujets les plus photographiés sur le web, avec d’énormes variations d’éclairage, d’angle, d’expression et de teint. Le modèle a vu suffisamment de variété pour construire un modèle statistique détaillé de la géométrie du visage, de la texture de la peau et de la manière dont la lumière interagit avec les différentes structures faciales.
Comparez-le à Stable Diffusion, une référence plus ancienne, avec des données d’entraînement plus réduites et une architecture moins expressive. Les visages sont nettement plus flous, et les doigts échouent souvent dans les premières versions, car le modèle possède une représentation interne plus faible de l’anatomie de la main et des structures fines.
Flux 1.1 Pro Ultra va plus loin, en produisant des résultats de 4 mégapixels où la texture des pores de la peau devient plausible. Il n’ajoute pas de détails au hasard : il puise dans sa distribution apprise de ce à quoi ressemble une peau photographiée à très haute résolution.
Des modèles à tester dès aujourd’hui
Plusieurs modèles de la plateforme illustrent différentes facettes de la connaissance visuelle de l’IA :
| Modèle | Point fort | Idéal pour |
|---|
| Flux Dev | Respect du prompt, composition | Scènes complexes à plusieurs objets |
| Flux Schnell | Rapidité, génération en 4 étapes | Itérations rapides |
| Imagen 4 | Éclairage naturel, détails riches | Portraits photoréalistes |
| SDXL | Souplesse stylistique | Compositions artistiques |
| Ideogram v3 Quality | Rendu du texte, réalisme | Images avec des mots lisibles |
| Recraft v4 | Précision prête pour l’impression | Design et éléments de marque |
Reconnaissance des visages et du corps
Pourquoi les visages sont particulièrement difficiles
Les visages sont à la fois la catégorie d’objets la plus étudiée en vision par ordinateur et l’une des plus exigeantes sur le plan technique. Chaque visage humain partage la même structure de base (deux yeux au-dessus d’un nez, lui-même au-dessus d’une bouche), ce qui signifie que de petites différences portent une information considérable. Reconnaître une personne précise exige que le modèle soit sensible à de subtiles variations entre individus tout en restant robuste à de fortes variations au sein d’un même individu (la même personne à différents âges, avec différentes expressions, sous différents éclairages).
La géométrie compte aussi. Un visage vu à 45 degrés paraît sensiblement différent du même visage vu de face. Les premiers systèmes de reconnaissance exigeaient une vue à peu près frontale. Les systèmes modernes gèrent n’importe quelle pose en estimant d’abord un modèle 3D du visage à partir de l’image 2D, un processus qui repose lui-même sur des connaissances a priori apprises sur la géométrie du visage pendant l’entraînement.
Pose, profondeur et perception spatiale
Au-delà des visages, comprendre la pose du corps exige de localiser les articulations (épaules, coudes, poignets, hanches, genoux, chevilles) et d’en déduire la configuration en 3D à partir d’une image 2D. Cela reste fondamentalement ambigu depuis un seul point de vue : un bras levé et un bras raccourci peuvent sembler identiques sous certains angles. Les modèles lèvent cette ambiguïté grâce à des connaissances statistiques a priori, apprises à partir de milliers de corps humains capturés par mouvement.
L’estimation de la profondeur à partir d’une seule image fonctionne de manière similaire. Il n’existe ni indices stéréoscopiques ni parallaxe de mouvement. Le modèle utilise des raccourcis appris : les objets situés plus haut dans le cadre tendent à être plus éloignés, des objets de taille connue comme les portes et les personnes fournissent une échelle implicite, et la brume atmosphérique augmente avec la distance. Aucun de ces indices n’est codé en dur. Ils sont absorbés à partir de la distribution d’entraînement.
3 domaines où l’IA visuelle échoue encore
Le piège des textures
L’un des premiers cas d’échec documentés concerne les textures adverses. Des chercheurs ont montré qu’en imprimant un motif précis sur un objet en 3D, on pouvait amener un réseau de neurones à le classer avec assurance dans la mauvaise catégorie. Une tortue recouverte de la bonne texture a été classée comme un fusil. Le modèle se fiait fortement aux statistiques de texture plutôt qu’à la forme, révélant une fragilité que la vision humaine ne partage pas.
Concrètement, cela se manifeste lorsqu’un modèle entraîné principalement sur des photographies classe mal des matériaux présents dans des peintures ou des surfaces naturelles inhabituelles. Un mur de béton brut photographié sous un angle rasant peut être étiqueté avec assurance comme « écorce », parce que les statistiques de texture de bas niveau correspondent.
Les entrées hors distribution
Les réseaux de neurones sont d’excellents interpolateurs à l’intérieur de leur distribution d’entraînement, et des extrapolateurs peu fiables en dehors. Un modèle qui n’a jamais vu un type particulier d’équipement industriel produira tout de même une étiquette assurée, généralement une catégorie visuellement proche tirée de son jeu d’entraînement. Un classifieur standard ne dispose d’aucun mécanisme intégré pour exprimer son incertitude.
💡 C’est pourquoi la calibration compte. Les systèmes bien déployés associent la sortie de classification à un score de confiance calibré et orientent les prédictions à faible confiance vers une vérification humaine plutôt que d’agir automatiquement.
Comment les modèles apprennent à se rétablir
La réponse du domaine à ces modes de défaillance consiste surtout à fournir davantage de données, et des données plus variées. L’augmentation de données (retournement, recadrage, décalage des couleurs et ajout de bruit aléatoires sur les images d’entraînement) oblige le modèle à apprendre des caractéristiques stables face à ces transformations. Mixup et CutMix mélangent deux images d’entraînement et entraînent le réseau sur l’étiquette mélangée, ce qui adoucit les frontières de décision.
Des approches plus récentes utilisent le pré-entraînement auto-supervisé, dans lequel le modèle apprend à partir d’images non étiquetées en résolvant des tâches substitutives, comme prédire des zones masquées. Les représentations obtenues sont plus robustes, car elles doivent tenir compte de l’ensemble de la distribution du contenu des images, et non seulement des caractéristiques utiles à la classification.
Essayez de créer vos propres résultats de vision par IA
Maintenant que vous comprenez ce qui se passe réellement lorsqu’une IA traite une scène visuelle, vous pouvez interagir avec les générateurs d’images de façon plus réfléchie. Le résultat du modèle n’est pas aléatoire : il puise dans une distribution apprise de l’apparence des choses. Votre prompt est un ensemble de contraintes qui resserrent cette distribution vers l’image que vous avez en tête.
Décrire la direction de la lumière (« contre-jour chaud de l’heure dorée venant de la gauche »), les caractéristiques de l’objectif (« 85 mm f/1.8, faible profondeur de champ ») et les textures de surface (« pores de la peau visibles, mèches de cheveux nettes ») active des zones précises de la représentation visuelle apprise par le modèle. Plus vous décrivez précisément à quoi les choses ressemblent physiquement, plus le modèle peut puiser dans les parties les plus denses et les plus détaillées de sa distribution d’entraînement.
Flux Dev et Flux Pro répondent tous deux bien à un prompt ancré dans le réel. Imagen 4 est particulièrement performant sur les conditions d’éclairage naturel. Pour les portraits, Flux 1.1 Pro Ultra produit la texture de peau et de cheveux la plus fidèle, en s’appuyant sur sa représentation interne plus riche de l’apparence humaine.
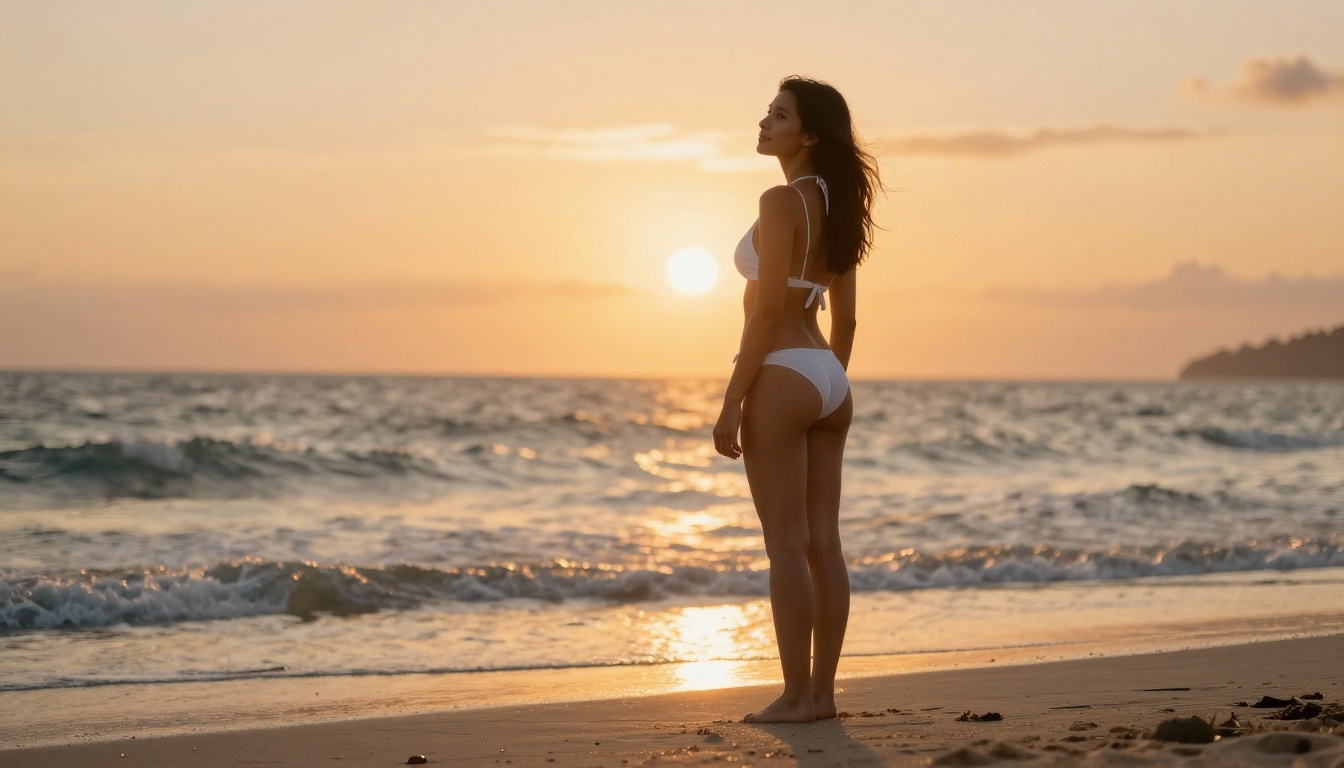
La meilleure façon de développer son intuition consiste à lancer le même prompt sur plusieurs modèles et à comparer où chacun met l’accent. Les écarts révèlent quelque chose de réel sur ce que chaque modèle « sait » grâce à ses données d’entraînement. Rendez-vous sur PicassoIA, choisissez un modèle dans la collection texte vers image et commencez à expérimenter avec des prompts décrivant la réalité physique. Ce que vous voyez dans le résultat est le reflet direct de ce que le modèle a appris sur le monde visuel.


