Toda vez que você envia uma foto e um aplicativo identifica instantaneamente os objetos nela, algo discretamente notável aconteceu. Uma máquina sem olhos, sem sistema nervoso e sem experiência de vida olhou para uma grade de números coloridos e produziu significado a partir dela. Esse processo não é mágica. É um conjunto específico e aprendível de operações matemáticas que pesquisadores passaram décadas refinando. Entender como a IA sabe como as coisas são revela algo surpreendente: a visão acaba sendo muito mais uma questão de estatística do que de percepção.
O que "ver" realmente significa para uma máquina
Pixels são apenas números
Para um computador, uma imagem não é nada além de uma grade retangular de números. Cada pixel guarda três valores que representam a intensidade de vermelho, verde e azul, em uma escala de 0 a 255. Uma foto de 1920x1080 contém mais de seis milhões desses valores. Não existe nenhum conceito de "um gato" ou "uma cadeira" embutido em nenhum deles. O significado precisa ser construído do zero, camada por camada.
Esse é o desafio fundamental da visão computacional: transformar dados numéricos brutos em compreensão semântica. Durante muito tempo, engenheiros tentaram escrever regras explícitas. "Se você vê uma forma redonda acima de duas linhas verticais com uma base plana, provavelmente é um abajur." Não funcionou. Objetos do mundo real têm variação infinita de ângulo, iluminação, oclusão e contexto. As regras sempre quebravam.
Padrões escondidos à vista de todos
O avanço veio quando pesquisadores pararam de escrever regras e começaram a deixar as máquinas encontrarem padrões por conta própria. Em vez de especificar como é um cachorro, você mostra a uma rede neural dez milhões de fotos de cachorros rotuladas e deixa que ela descubra quais padrões numéricos prevêem de forma confiável o rótulo "cachorro".
Isso parece simples. A implementação não é. A rede precisa de uma arquitetura que respeite a estrutura espacial das imagens, de dados de treinamento em escala massiva e de estratégias de otimização que impeçam que ela simplesmente memorize exemplos em vez de generalizar para novos casos.
Como as redes neurais aprendem a reconhecer imagens
Treinamento com milhões de exemplos
A palavra "treinamento" em aprendizado de máquina é um termo técnico preciso. Significa executar um algoritmo de otimização, geralmente uma forma de gradiente descendente estocástico, que ajusta gradualmente milhões de valores internos de pesos até que as saídas da rede correspondam aos rótulos corretos em um conjunto de treinamento. O processo é iterativo. Você alimenta a rede com uma imagem, compara sua previsão com a resposta correta, mede o erro e atualiza os pesos para reduzir esse erro. Repita bilhões de vezes.
A escala necessária é impressionante. O ImageNet, um dos conjuntos de dados de treinamento marcantes, contém mais de catorze milhões de imagens rotuladas em vinte e um mil categorias. Os grandes modelos de visão atuais treinam com conjuntos de dados muitas ordens de grandeza maiores, coletados da web e processados por pipelines de filtragem automatizados.
O que uma camada convolucional realmente faz
A maioria dos sistemas de reconhecimento de imagem é construída sobre redes neurais convolucionais (CNNs). A camada convolucional é a inovação central delas. Em vez de conectar cada pixel a cada neurônio (o que seria computacionalmente catastrófico para imagens grandes), uma camada convolucional desliza um filtro pequeno, tipicamente de 3x3 ou 5x5 pixels, pela imagem e calcula um produto escalar em cada posição.
💡 Pense assim: um filtro 3x3 que se ativa ao ver uma borda horizontal vai produzir uma resposta forte onde quer que bordas horizontais apareçam na imagem, e uma resposta fraca em todos os outros lugares. Empilhe centenas desses filtros e você obtém um mapa rico de onde cada tipo de borda, gradiente e textura aparece.
As camadas iniciais detectam coisas simples: bordas em várias orientações, gradientes de cor, pequenas texturas repetitivas. As camadas mais profundas combinam essas detecções em representações cada vez mais abstratas. Nas camadas finais, neurônios individuais respondem a padrões complexos como "pelo com manchas" ou "a forma geral de uma orelha".
De características de baixo nível a objetos completos
Essa extração hierárquica de características é o motivo pelo qual redes profundas generalizam tão bem. A representação aprendida nas camadas do meio não é específica de nenhuma tarefa. Esses mapas de características para "textura de pelo" e "formato de olho" podem ser reutilizados para classificar raças, identificar espécies ou até gerar novas imagens de animais. Essa é a base do aprendizado por transferência, uma das ideias mais úteis na prática em IA moderna.
O papel dos dados de treinamento
Por que a escala muda tudo
Antes de cerca de 2012, a maioria dos classificadores de imagem conseguia lidar com dezenas de categorias com precisão modesta. Quando o AlexNet venceu a competição ImageNet naquele ano, usando uma CNN profunda treinada em GPUs, a taxa de erro top-5 caiu mais de dez pontos percentuais em relação ao concorrente seguinte. A arquitetura importou, mas o volume enorme de exemplos de treinamento também teve peso.
| Era | Tamanho do conjunto de dados | Erro top-5 típico |
|---|
| Pré-aprendizado profundo (2010) | ~1M de imagens rotuladas | ~28% |
| Era inicial das CNNs (2012) | 1,2M (ImageNet) | ~17% |
| Modelos de visão modernos (2024+) | Bilhões de imagens | ~1-2% |
A escala força uma rede a encontrar casos extremos raros, ângulos incomuns, fundos diversos e extremos de iluminação. Um modelo treinado apenas com fotos de gatos em estúdio vai falhar com um gato visto através da janela de um carro na chuva. Volume não é só uma conveniência; é o mecanismo que produz robustez.
Quando o viés contamina o modelo
Os dados de treinamento têm uma fraqueza profunda: eles refletem quem os coletou. Se um conjunto de dados de reconhecimento facial é formado principalmente por rostos de pele clara fotografados em ambientes internos, o modelo terá um desempenho ruim em tons de pele mais escuros e em condições externas. Isso não é uma preocupação filosófica. É um modo de falha mensurável e documentado, com consequências reais em ferramentas de contratação, sistemas de segurança e imagens médicas.
O problema vai além da demografia. Modelos treinados com imagens da web herdam os vieses do que é fotografado e compartilhado. Cachorros aparecem com mais frequência do que leopardos-das-neves. Salas de estar aparecem com mais frequência do que oficinas de forja. O senso interno do modelo sobre "como as coisas são" é moldado inteiramente pela distribuição do seu conjunto de treinamento.
Detecção de objetos ou classificação de imagens
Nomear uma coisa ou encontrá-la
A classificação de imagens responde a uma pergunta: qual é o assunto dominante desta imagem? A saída é um rótulo de categoria, muitas vezes com uma pontuação de confiança. A detecção de objetos é mais difícil. Ela responde: onde estão todos os objetos nesta imagem, e o que é cada um deles?
A detecção exige que o modelo produza caixas delimitadoras junto com os rótulos. Detectores modernos como o YOLO (You Only Look Once) realizam isso em uma única passagem direta pela rede, e é por isso que podem operar em tempo real em fluxos de vídeo.
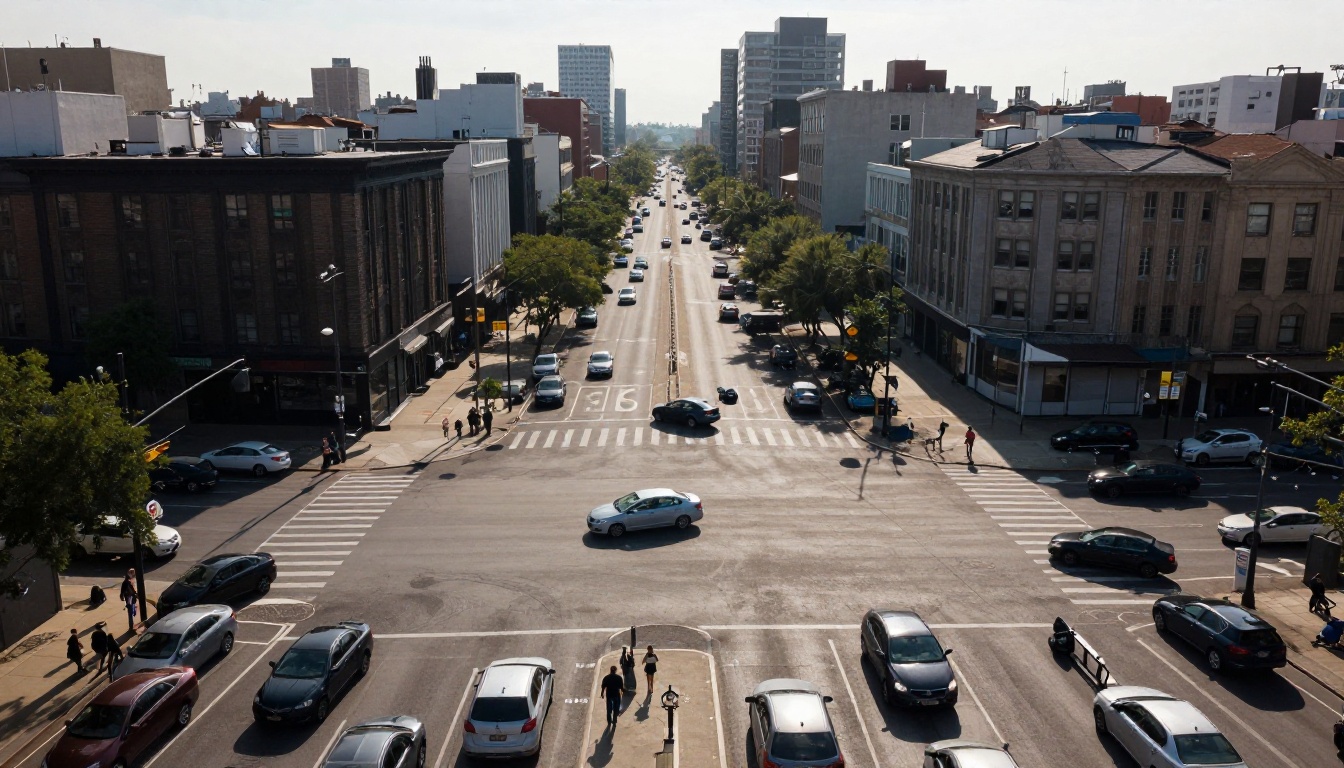
A cena urbana aérea acima ilustra o desafio. Cada pedestre, veículo e faixa de pedestres precisaria ser localizado e rotulado individualmente por um sistema de detecção, apesar de silhuetas sobrepostas, variação de tamanho e sombras que obscurecem partes de cada sujeito.
Reconhecimento em tempo real em condições reais
Colocar o reconhecimento no mundo real adiciona restrições que os benchmarks de laboratório ignoram. A latência precisa ser baixa o suficiente para a aplicação: um carro autônomo precisa de decisões em milissegundos. A memória precisa caber no orçamento de hardware do dispositivo-alvo. A precisão precisa se manter diante de mudanças de clima, iluminação incomum e danos na câmera.
É por isso que a área avançou para arquiteturas leves, projetadas para implantação na borda, e por que os modelos estão cada vez mais quantizados, comprimindo valores de pesos de floats de 32 bits para inteiros de 8 bits para reduzir o uso de memória e acelerar a inferência sem uma perda catastrófica de precisão.
Como os geradores de imagem por IA aplicam o conhecimento visual
Ver ao contrário
Entender como a IA sabe como as coisas são fica especialmente interessante quando você aplica isso a modelos generativos. Um sistema de texto para imagem não apenas reconhece objetos; ele reconstrói esses objetos a partir de uma descrição. Para fazer isso de forma convincente, ele precisa ter internalizado um modelo estatístico profundo de como é cada objeto, superfície, condição de iluminação e composição fotográfica.
É por isso que modelos treinados com conjuntos de dados maiores e mais diversos produzem resultados mais fotorrealistas. A representação interna deles sobre "como as coisas são" é mais rica, então as reconstruções são mais precisas em assuntos incomuns e condições de iluminação variadas.
Por que o Flux Pro acerta nos rostos
Veja o Flux Pro como exemplo concreto. Seu desempenho forte em rostos humanos vem em parte da sua distribuição de treinamento. Rostos estão entre os assuntos mais fotografados da web, com enorme variação de iluminação, ângulo, expressão e tom de pele. O modelo viu variação suficiente para construir um modelo estatístico detalhado da geometria facial, da textura da pele e de como a luz interage com diferentes estruturas faciais.
Compare com o Stable Diffusion, uma base mais antiga, com dados de treinamento menores e uma arquitetura menos expressiva. Os rostos são visivelmente mais suaves, e os dedos costumam falhar nas versões anteriores, porque o modelo tem uma representação interna mais fraca da anatomia das mãos e de estruturas finas.
O Flux 1.1 Pro Ultra vai além, produzindo saídas de 4 megapixels em que a textura individual dos poros da pele se torna plausível. Ele não está acrescentando detalhes ao acaso; está amostrando da sua distribuição aprendida sobre como a pele fotográfica é em altíssima resolução.
Modelos que valem a pena testar hoje
Vários modelos da plataforma demonstram diferentes facetas do conhecimento visual da IA:
| Modelo | Ponto forte | Melhor para |
|---|
| Flux Dev | Aderência ao prompt, composição | Cenas complexas com múltiplos objetos |
| Flux Schnell | Velocidade, geração em 4 etapas | Iteração rápida |
| Imagen 4 | Iluminação natural, muitos detalhes | Retratos fotorrealistas |
| SDXL | Flexibilidade de estilo | Composições artísticas |
| Ideogram v3 Quality | Renderização de texto, realismo | Imagens com palavras legíveis |
| Recraft v4 | Precisão pronta para impressão | Design e ativos de marca |
Reconhecimento de rostos e corpos
Por que os rostos são singularmente difíceis
Rostos são, ao mesmo tempo, a categoria de objeto mais estudada em visão computacional e uma das mais exigentes tecnicamente. Todo rosto humano compartilha a mesma estrutura básica (dois olhos acima de um nariz, acima de uma boca), o que significa que pequenas diferenças carregam uma enorme quantidade de informação. Reconhecer uma pessoa específica exige que o modelo seja sensível a variações sutis entre indivíduos e, ao mesmo tempo, robusto a grandes variações dentro de um mesmo indivíduo (a mesma pessoa em idades diferentes, com expressões diferentes, sob iluminações diferentes).
A geometria também importa. Um rosto visto a 45 graus parece substancialmente diferente do mesmo rosto visto de frente. Os primeiros sistemas de reconhecimento exigiam uma visão aproximadamente frontal. Os sistemas modernos lidam com qualquer pose estimando primeiro um modelo 3D do rosto a partir da imagem 2D, um processo que também depende de conhecimentos prévios aprendidos sobre a geometria facial adquiridas durante o treinamento.
Pose, profundidade e percepção espacial
Além dos rostos, entender a pose corporal exige localizar as posições das articulações (ombros, cotovelos, pulsos, quadris, joelhos, tornozelos) e inferir sua configuração 3D a partir de uma imagem 2D. Isso é fundamentalmente ambíguo a partir de um único ponto de vista: um braço levantado e um braço em escorço podem parecer idênticos de certos ângulos. Os modelos resolvem essa ambiguidade usando premissas estatísticas aprendidas com milhares de corpos humanos capturados por movimento.
A estimativa de profundidade a partir de uma única imagem funciona de forma semelhante. Não há pistas estereoscópicas nem paralaxe de movimento. O modelo usa atalhos aprendidos: objetos mais altos no quadro tendem a estar mais distantes, objetos de tamanho conhecido, como portas e pessoas, fornecem informação implícita de escala, e a névoa atmosférica aumenta com a distância. Nenhuma dessas pistas é codificada diretamente. Elas são absorvidas da distribuição de treinamento.
3 lugares onde a IA visual ainda falha
A armadilha da textura
Um dos casos de falha documentados mais antigos: texturas adversariais. Pesquisadores mostraram que, ao imprimir um padrão específico em um objeto 3D, era possível fazer uma rede neural classificá-lo com confiança de forma errada. Uma tartaruga coberta com a textura certa foi classificada como um rifle. O modelo dependia muito de estatísticas de textura em vez de forma, expondo uma fragilidade que a visão humana não compartilha.
Na prática, isso aparece quando um modelo treinado principalmente com fotografias classifica erroneamente materiais em pinturas ou superfícies naturais incomuns. Uma parede de concreto áspero fotografada em ângulo raso pode ser rotulada com confiança como "casca de árvore" porque as estatísticas de textura de baixo nível coincidem.
Entradas fora da distribuição
Redes neurais são interpoladoras confiantes dentro da sua distribuição de treinamento e extrapoladoras não confiáveis fora dela. Um modelo que nunca viu determinado tipo de equipamento industrial ainda vai produzir um rótulo com confiança, normalmente algo visualmente parecido dentro do seu conjunto de treinamento. Não existe um mecanismo embutido para expressar incerteza em um classificador padrão.
💡 É por isso que a calibração importa. Sistemas bem implantados combinam a saída de classificação com uma pontuação de confiança calibrada e encaminham previsões de baixa confiança para revisão humana, em vez de agir sobre elas automaticamente.
Como os modelos aprendem a se recuperar
A resposta da área a esses modos de falha é, em grande parte, mais dados e dados mais variados. O aumento de dados (inverter, recortar, alterar cores e adicionar ruído às imagens de treinamento de forma aleatória) força o modelo a aprender características que permanecem estáveis sob essas transformações. Mixup e CutMix misturam duas imagens de treinamento e treinam a rede com o rótulo misturado, suavizando as fronteiras de decisão.
Abordagens mais recentes usam pré-treinamento autossupervisionado, em que o modelo aprende com imagens sem rótulo ao resolver tarefas auxiliares, como prever regiões mascaradas. As representações resultantes são mais robustas porque precisam dar conta de toda a distribuição do conteúdo da imagem, e não apenas das características relevantes para a classificação.
Experimente criar sua própria saída de IA visual
Agora que você entende o que realmente acontece quando uma IA processa uma cena visual, pode interagir com os geradores de imagem de forma mais deliberada. A saída do modelo não é aleatória; ela é uma amostragem de uma distribuição aprendida sobre como as coisas são. Seu prompt é um conjunto de restrições que estreita essa distribuição em direção à imagem que você tem em mente.
Descrever a direção da luz ("contraluz dourada de fim de tarde vindo da esquerda"), as características da lente da câmera ("85mm f/1.8 com profundidade de campo rasa") e as texturas das superfícies ("poros naturais visíveis, fios de cabelo individuais nítidos") ativam regiões específicas da representação visual aprendida pelo modelo. Quanto mais precisamente você descreve como as coisas fisicamente se parecem, mais o modelo pode recorrer às partes mais densas e detalhadas da sua distribuição de treinamento.
O Flux Dev e o Flux Pro respondem bem a prompts fundamentados fisicamente. O Imagen 4 é especialmente forte em condições de iluminação natural. Para retratos, o Flux 1.1 Pro Ultra produz a textura de pele e cabelo de maior fidelidade, recorrendo à sua representação interna mais rica da aparência humana.
A melhor forma de desenvolver intuição é rodar o mesmo prompt em vários modelos e comparar onde cada um coloca sua ênfase. As diferenças revelam algo real sobre o que cada modelo "sabe" a partir dos dados de treinamento. Acesse o PicassoIA, escolha um modelo na coleção de texto para imagem e comece a experimentar prompts descritivos do ponto de vista físico. O que você vê na saída é um reflexo direto do que o modelo aprendeu sobre o mundo visual.


