जब भी आप कोई फ़ोटो अपलोड करते हैं और कोई ऐप उसके अंदर की वस्तुओं के नाम तुरंत बता देता है, तो कुछ चुपचाप लेकिन उल्लेखनीय हो चुका होता है। एक मशीन, जिसकी न आँखें हैं, न तंत्रिका तंत्र, और न कोई जीवित अनुभव, रंगीन संख्याओं की एक ग्रिड को देखती है और उससे अर्थ निकाल लेती है। यह प्रक्रिया जादू नहीं है। यह गणितीय संक्रियाओं का एक ख़ास, सीखा जा सकने वाला सेट है, जिसे शोधकर्ताओं ने दशकों तक निखारा है। यह समझना कि AI चीज़ें कैसी दिखती हैं यह कैसे जानता है, एक चौंकाने वाली बात सामने लाता है: विज़न असल में धारणा से कहीं ज़्यादा सांख्यिकी के बारे में है।
मशीन के लिए "देखना" असल में क्या होता है
पिक्सल बस संख्याएँ हैं
कंप्यूटर के लिए कोई इमेज संख्याओं की एक आयताकार ग्रिड से ज़्यादा कुछ नहीं होती। हर पिक्सल में 0 से 255 के पैमाने पर लाल, हरे और नीले रंग की तीव्रता के तीन मान होते हैं। 1920x1080 की फ़ोटो में ऐसे 60 लाख से ज़्यादा मान होते हैं। इनमें से किसी में भी "एक बिल्ली" या "एक कुर्सी" की कोई अवधारणा पहले से नहीं होती। अर्थ को शुरू से, परत-दर-परत बनाना पड़ता है।
यही कंप्यूटर विज़न की बुनियादी चुनौती है: कच्चे संख्यात्मक डेटा से सेमेंटिक समझ तक पहुँचना। लंबे समय तक इंजीनियर साफ़ नियम लिखने की कोशिश करते रहे। "अगर आपको सपाट आधार वाली दो खड़ी रेखाओं के ऊपर एक गोल आकार दिखे, तो वह शायद लैंप है।" यह काम नहीं किया। असली दुनिया की वस्तुओं में कोण, रोशनी, ओक्लूज़न और संदर्भ की अनगिनत विविधताएँ होती हैं। नियम हमेशा टूट जाते थे।
सामने छिपे पैटर्न
सफलता तब मिली जब शोधकर्ताओं ने नियम लिखना बंद किया और मशीनों को खुद पैटर्न खोजने दिए। यह बताने के बजाय कि कुत्ता कैसा दिखता है, आप एक न्यूरल नेटवर्क को दस मिलियन लेबल वाली कुत्ते की फ़ोटो दिखाते हैं और उसे ख़ुद पता लगाने देते हैं कि कौन-से संख्यात्मक पैटर्न "कुत्ता" लेबल का भरोसेमंद अनुमान देते हैं।
यह सुनने में सरल लगता है। लेकिन इसे लागू करना सरल नहीं है। नेटवर्क को ऐसी आर्किटेक्चर चाहिए जो इमेज की स्पेशियल संरचना का सम्मान करे, बहुत बड़े पैमाने पर ट्रेनिंग डेटा चाहिए, और ऐसी ऑप्टिमाइज़ेशन रणनीतियाँ चाहिए जो उसे नए उदाहरणों तक सामान्यीकरण करने के बजाय सिर्फ़ उदाहरण याद करने से रोकें।
न्यूरल नेटवर्क इमेज पहचानना कैसे सीखते हैं
लाखों उदाहरणों पर ट्रेनिंग
मशीन लर्निंग में "ट्रेनिंग" शब्द एक सटीक तकनीकी पद है। इसका मतलब है एक ऑप्टिमाइज़ेशन एल्गोरिदम चलाना, आमतौर पर स्टोकेस्टिक ग्रेडिएंट डिसेंट का कोई रूप, जो लाखों आंतरिक वेट मानों को धीरे-धीरे समायोजित करता है, जब तक नेटवर्क के आउटपुट ट्रेनिंग सेट के सही लेबलों से मेल न खाने लगें। यह प्रक्रिया दोहराव वाली है। नेटवर्क को एक इमेज दें, उसके अनुमान की तुलना सही उत्तर से करें, त्रुटि मापें, और उस त्रुटि को घटाने के लिए वेट अपडेट करें। यह अरबों बार दोहराया जाता है।
ज़रूरी पैमाना चौंकाने वाला है। ImageNet, जो सबसे अहम ट्रेनिंग डेटासेट में से एक है, इक्कीस हज़ार श्रेणियों में चौदह मिलियन से ज़्यादा लेबल वाली इमेज रखता है। आधुनिक लार्ज विज़न मॉडल इससे कई गुना बड़े डेटासेट पर ट्रेन होते हैं, जो वेब से जुटाए जाते हैं और स्वचालित फ़िल्टरिंग पाइपलाइन से गुज़ारे जाते हैं।
कन्वोल्यूशनल लेयर असल में क्या करती है
ज़्यादातर इमेज रिकग्निशन सिस्टम कन्वोल्यूशनल न्यूरल नेटवर्क (CNN) पर बने होते हैं। कन्वोल्यूशनल लेयर उनका मूल नवाचार है। हर पिक्सल को हर न्यूरॉन से जोड़ने के बजाय (जो बड़ी इमेज के लिए कम्प्यूटेशनल रूप से बेहद महँगा होता), कन्वोल्यूशनल लेयर एक छोटा फ़िल्टर, आमतौर पर 3x3 या 5x5 पिक्सल का, इमेज पर सरकाती है और हर स्थिति पर डॉट प्रोडक्ट निकालती है।
💡 इसे इस तरह समझें: एक 3x3 फ़िल्टर जो क्षैतिज किनारा दिखने पर सक्रिय होता है, इमेज में जहाँ भी क्षैतिज किनारे आते हैं वहाँ मज़बूत प्रतिक्रिया देगा, और बाकी हर जगह कमज़ोर। ऐसे सैकड़ों फ़िल्टर जोड़ें, तो आपको हर तरह के किनारे, ग्रेडिएंट और टेक्सचर कहाँ दिखते हैं, इसका समृद्ध नक्शा मिल जाता है।
शुरुआती लेयर सरल चीज़ें पहचानती हैं: अलग-अलग दिशाओं के किनारे, रंग के ग्रेडिएंट, छोटे दोहराने वाले टेक्सचर। गहरी लेयर इन पहचानों को जोड़कर धीरे-धीरे ज़्यादा अमूर्त प्रतिनिधित्व बनाती हैं। आख़िरी लेयर तक, व्यक्तिगत न्यूरॉन "रोएँ जिन पर धब्बे हैं" या "कान का सामान्य आकार" जैसे जटिल पैटर्न पर प्रतिक्रिया देने लगते हैं।
निचले स्तर के फ़ीचर से पूरी वस्तु तक
इसी श्रेणीबद्ध फ़ीचर निष्कर्षण की वजह से गहरे नेटवर्क इतनी अच्छी तरह सामान्यीकरण कर पाते हैं। बीच की लेयर में सीखा गया प्रतिनिधित्व किसी एक काम तक सीमित नहीं होता। "रोएँ के टेक्सचर" और "आँख के आकार" के वे फ़ीचर मैप नस्लों को वर्गीकृत करने, प्रजातियाँ पहचानने, या नई पशु इमेज जनरेट करने में दोबारा इस्तेमाल हो सकते हैं। यही ट्रांसफ़र लर्निंग का आधार है, जो आधुनिक AI के सबसे व्यावहारिक रूप से उपयोगी विचारों में से एक है।
ट्रेनिंग डेटा की भूमिका
पैमाना सब कुछ क्यों बदल देता है
लगभग 2012 से पहले, ज़्यादातर इमेज क्लासिफ़ायर मामूली सटीकता के साथ दर्जनों श्रेणियाँ ही संभाल पाते थे। जब AlexNet ने उस साल GPU पर ट्रेन किए गए एक डीप CNN से ImageNet प्रतियोगिता जीती, तो अगले प्रतिस्पर्धी की तुलना में टॉप-5 एरर रेट दस प्रतिशत अंकों से भी ज़्यादा गिर गया। आर्किटेक्चर मायने रखता था, लेकिन ट्रेनिंग उदाहरणों की विशाल मात्रा भी उतनी ही मायने रखती थी।
| युग | डेटासेट का आकार | सामान्य टॉप-5 एरर |
|---|
| डीप लर्निंग से पहले (2010) | ~1M लेबल वाली इमेज | ~28% |
| शुरुआती CNN युग (2012) | 1.2M (ImageNet) | ~17% |
| आधुनिक विज़न मॉडल (2024+) | अरबों इमेज | ~1-2% |
पैमाना नेटवर्क को दुर्लभ एज केस, असामान्य कोण, विविध पृष्ठभूमि और रोशनी की अति स्थितियों से टकराने के लिए मजबूर करता है। जो मॉडल सिर्फ़ स्टूडियो में ली गई बिल्लियों की फ़ोटो पर ट्रेन हुआ है, वह बारिश में कार की खिड़की से दिखी बिल्ली को पहचानने में नाकाम रहेगा। मात्रा कोई सुविधा भर नहीं है; यही वह तंत्र है जो मज़बूती पैदा करता है।
जब पूर्वाग्रह मॉडल को बिगाड़ देता है
ट्रेनिंग डेटा की एक गहरी कमज़ोरी है: वह उसी को प्रतिबिंबित करता है जिसने उसे इकट्ठा किया। अगर किसी फ़ेस रिकग्निशन डेटासेट में ज़्यादातर गोरे चेहरे हैं जिनकी तस्वीरें घर के अंदर ली गई हैं, तो मॉडल गहरे रंग की त्वचा और बाहरी परिस्थितियों में ख़राब प्रदर्शन करेगा। यह कोई दार्शनिक चिंता नहीं है। यह एक मापी जा सकने वाली, प्रलेखित विफलता है, जिसके असली नतीजे भर्ती टूल्स, सुरक्षा प्रणालियों और मेडिकल इमेजिंग में होते हैं।
समस्या जनसांख्यिकी से आगे जाती है। वेब इमेज पर ट्रेन हुए मॉडल उन चीज़ों के पूर्वाग्रह विरासत में लेते हैं जिनकी तस्वीरें खींची और साझा की जाती हैं। कुत्तों की तस्वीरें बर्फ़ीले तेंदुओं से ज़्यादा दिखती हैं। ड्रॉइंग रूम की तस्वीरें लोहारों की वर्कशॉप से ज़्यादा दिखती हैं। मॉडल की आंतरिक समझ कि "चीज़ें कैसी दिखती हैं" पूरी तरह उसके ट्रेनिंग सेट के वितरण से बनती है।
ऑब्जेक्ट डिटेक्शन बनाम इमेज क्लासिफ़िकेशन
किसी चीज़ का नाम बताना बनाम उसे ढूँढना
इमेज क्लासिफ़िकेशन एक ही सवाल का जवाब देता है: इस इमेज का मुख्य सब्जेक्ट क्या है? आउटपुट एक श्रेणी लेबल होता है, अक्सर कॉन्फ़िडेंस स्कोर के साथ। ऑब्जेक्ट डिटेक्शन कठिन है। यह जवाब देता है: इस इमेज में सभी वस्तुएँ कहाँ हैं, और उनमें से हर एक क्या है?
डिटेक्शन के लिए मॉडल को लेबल के साथ बाउंडिंग बॉक्स भी देने पड़ते हैं। YOLO (You Only Look Once) जैसे आधुनिक डिटेक्टर यह नेटवर्क के एक ही फ़ॉरवर्ड पास में कर लेते हैं, इसीलिए वे वीडियो स्ट्रीम पर रीयल टाइम में काम कर सकते हैं।
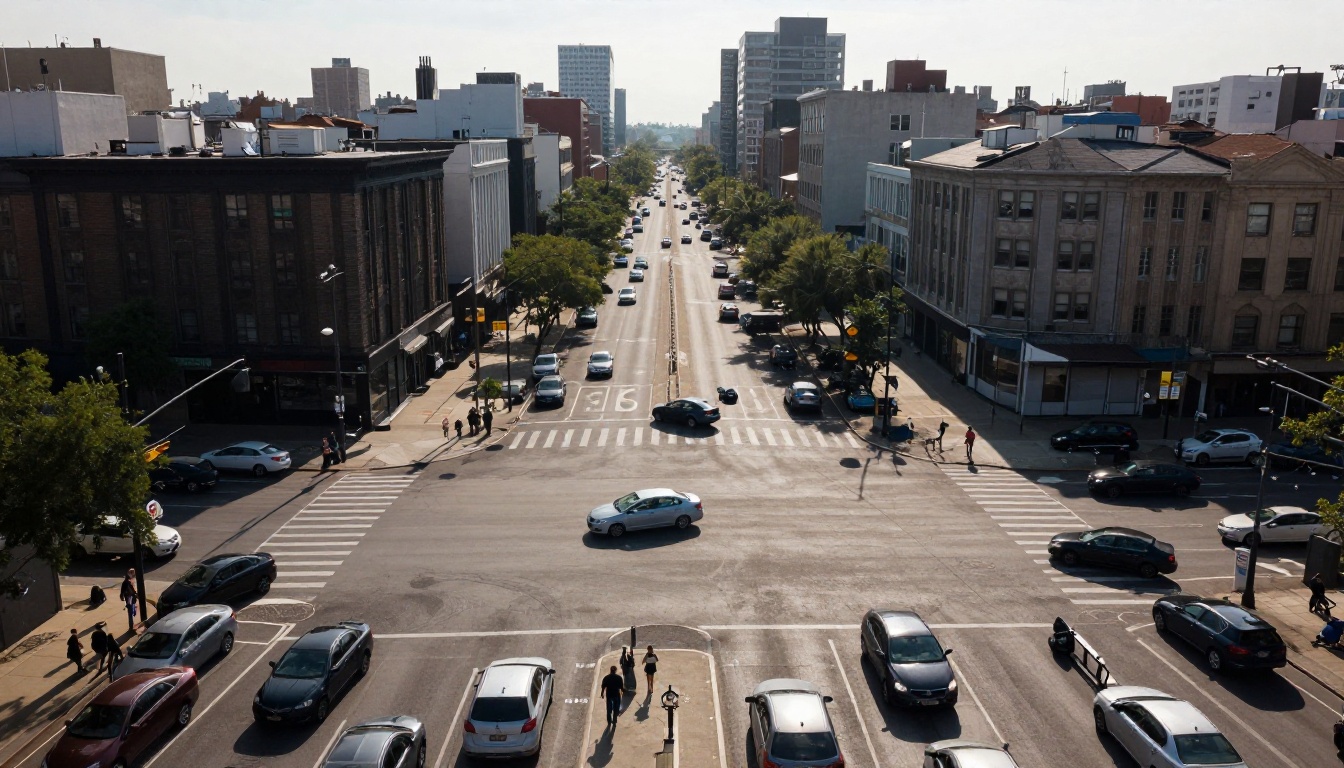
ऊपर का एरियल शहरी दृश्य चुनौती को दिखाता है। हर पैदल यात्री, वाहन और क्रॉसवॉक की लाइन को एक डिटेक्शन सिस्टम को अलग-अलग ढूँढकर लेबल करना होगा, भले ही सिल्हूट एक-दूसरे पर चढ़े हों, आकार अलग-अलग हों, और परछाइयाँ हर सब्जेक्ट के कुछ हिस्से ढक रही हों।
खुली दुनिया में रीयल-टाइम पहचान
असल दुनिया में पहचान तैनात करने पर ऐसी बाधाएँ आती हैं जिन्हें लैब बेंचमार्क नज़रअंदाज़ कर देते हैं। लेटेंसी इतनी कम होनी चाहिए कि ऐप के लिए काम चले: एक सेल्फ़-ड्राइविंग कार को मिलीसेकंड में फ़ैसले चाहिए। मेमोरी को टारगेट डिवाइस के हार्डवेयर बजट में फ़िट होना चाहिए। सटीकता मौसम के बदलाव, असामान्य रोशनी और कैमरे की क्षति के बावजूद बनी रहनी चाहिए।
इसी वजह से यह क्षेत्र एज डिप्लॉयमेंट के लिए बने हल्के आर्किटेक्चर की ओर बढ़ा है, और मॉडल तेज़ी से क्वांटाइज़्ड होते जा रहे हैं। वे वेट मानों को 32-बिट फ़्लोट से 8-बिट इंटीजर में संपीड़ित करते हैं, ताकि मेमोरी कम लगे और इनफ़रेंस तेज़ हो, बिना सटीकता में बड़ी गिरावट के।
AI इमेज जनरेटर विज़ुअल ज्ञान कैसे लागू करते हैं
उल्टी दिशा में देखना
यह समझना कि AI चीज़ें कैसी दिखती हैं यह कैसे जानता है, जेनरेटिव मॉडल पर लागू करने पर ख़ास तौर पर दिलचस्प हो जाता है। टेक्स्ट-टू-इमेज सिस्टम सिर्फ़ वस्तुएँ नहीं पहचानता; वह एक विवरण से उन्हें दोबारा बनाता है। ऐसा विश्वसनीय तरीके से करने के लिए, उसे हर वस्तु, सतह, रोशनी की स्थिति और फ़ोटोग्राफ़िक संरचना कैसी दिखती है, इसका गहरा सांख्यिकीय मॉडल अपने भीतर समाहित करना होता है।
इसीलिए बड़े और ज़्यादा विविध डेटासेट पर ट्रेन हुए मॉडल ज़्यादा फ़ोटोरियलिस्टिक आउटपुट देते हैं। "चीज़ें कैसी दिखती हैं" का उनका आंतरिक प्रतिनिधित्व ज़्यादा समृद्ध होता है, इसलिए असामान्य सब्जेक्ट और रोशनी की स्थितियों में उनके पुनर्निर्माण ज़्यादा सटीक होते हैं।
Flux Pro चेहरे सही क्यों बनाता है
इसका एक ठोस उदाहरण Flux Pro है। मानव चेहरों पर इसका मज़बूत प्रदर्शन आंशिक रूप से इसके ट्रेनिंग वितरण से आता है। चेहरे वेब पर सबसे ज़्यादा फ़ोटो खिंचे जाने वाले विषयों में से हैं, जिनमें रोशनी, कोण, भाव और त्वचा के रंग की भारी विविधता है। मॉडल ने चेहरे की ज्यामिति, त्वचा के टेक्सचर और अलग-अलग चेहरे की संरचनाओं पर रोशनी कैसे असर करती है, इसका विस्तृत सांख्यिकीय मॉडल बनाने लायक विविधता देखी है।
इसकी तुलना Stable Diffusion से करें, जो एक पुराना बेसलाइन है, जिसका ट्रेनिंग डेटा छोटा है और आर्किटेक्चर कम अभिव्यंजक है। चेहरे साफ़ तौर पर नरम दिखते हैं, और शुरुआती वर्ज़न में उंगलियाँ अक्सर बिगड़ जाती थीं, क्योंकि मॉडल के पास हाथ की शारीरिक रचना और बारीक संरचना का कमज़ोर आंतरिक प्रतिनिधित्व था।
Flux 1.1 Pro Ultra इससे आगे जाता है, और 4-मेगापिक्सल आउटपुट देता है, जिनमें त्वचा पर हर रोमछिद्र का टेक्सचर विश्वसनीय लगने लगता है। यह बेतरतीब तरीके से डिटेल नहीं जोड़ता; यह बहुत उच्च रिज़ॉल्यूशन पर फ़ोटोग्राफ़िक त्वचा कैसी दिखती है, उसके सीखे हुए वितरण से सैंपल लेता है।
आज आज़माने लायक मॉडल
प्लेटफ़ॉर्म पर कई मॉडल विज़ुअल AI ज्ञान के अलग-अलग पहलू दिखाते हैं:
| मॉडल | ताकत | सबसे अच्छा किसके लिए |
|---|
| Flux Dev | प्रॉम्प्ट का पालन, कम्पोज़िशन | जटिल मल्टी-ऑब्जेक्ट दृश्य |
| Flux Schnell | गति, 4-स्टेप जनरेशन | तेज़ दोहराव |
| Imagen 4 | प्राकृतिक रोशनी, समृद्ध डिटेल | फ़ोटोरियलिस्टिक पोर्ट्रेट |
| SDXL | स्टाइल का लचीलापन | कलात्मक कम्पोज़िशन |
| Ideogram v3 Quality | टेक्स्ट रेंडरिंग, यथार्थवाद | पढ़े जा सकने वाले शब्दों वाली इमेज |
| Recraft v4 | प्रिंट-तैयार सटीकता | डिज़ाइन और ब्रांड एसेट |
चेहरा और शरीर पहचान
चेहरे इतने कठिन क्यों हैं
चेहरे एक साथ कंप्यूटर विज़न में सबसे ज़्यादा अध्ययन की गई वस्तु श्रेणी हैं और तकनीकी रूप से सबसे चुनौतीपूर्ण भी। हर मानव चेहरे की बुनियादी संरचना एक जैसी होती है (नाक के ऊपर दो आँखें और नाक के नीचे मुँह), इसलिए छोटे अंतर भी भारी जानकारी रखते हैं। किसी ख़ास व्यक्ति को पहचानने के लिए मॉडल को व्यक्तियों के बीच के सूक्ष्म अंतर के प्रति संवेदनशील होना पड़ता है, और साथ ही एक ही व्यक्ति में बड़े बदलावों (अलग-अलग उम्र, अलग-अलग भाव, अलग-अलग रोशनी में एक ही इंसान) के प्रति मज़बूत रहना पड़ता है।
ज्यामिति भी मायने रखती है। 45 डिग्री से देखा गया चेहरा सीधे सामने से देखे गए उसी चेहरे से काफ़ी अलग दिखता है। शुरुआती पहचान सिस्टम को लगभग सामने से दिखने वाले दृश्य की ज़रूरत होती थी। आधुनिक सिस्टम किसी भी पोज़ को संभालते हैं, पहले 2D इमेज से चेहरे का 3D मॉडल अनुमानित करके, और यह प्रक्रिया भी ट्रेनिंग के दौरान सीखी गई चेहरे की ज्यामिति की धारणाओं पर निर्भर करती है।
पोज़, गहराई और स्पेशियल जागरूकता
चेहरों से आगे, बॉडी पोज़ को समझने के लिए जोड़ों की स्थिति (कंधे, कोहनी, कलाई, कूल्हे, घुटने, टखने) खोजनी पड़ती है और एक 2D इमेज से उनकी 3D संरचना का अनुमान लगाना पड़ता है। यह एक ही व्यूपॉइंट से मूल रूप से अस्पष्ट है: उठी हुई बाँह और छोटे कोण में दिखी बाँह कुछ कोणों से बिल्कुल एक जैसी दिख सकती हैं। मॉडल इस अस्पष्टता को हज़ारों मोशन-कैप्चर किए गए मानव शरीरों से सीखी गई सांख्यिकीय धारणाओं से हल करते हैं।
एक इमेज से गहराई का अनुमान भी इसी तरह काम करता है। यहाँ कोई स्टीरियो संकेत नहीं होते और न ही मोशन पैरालैक्स। मॉडल सीखे हुए शॉर्टकट इस्तेमाल करता है: फ़्रेम में ऊपर की वस्तुएँ आम तौर पर ज़्यादा दूर होती हैं, दरवाज़ों और लोगों जैसी ज्ञात आकार की वस्तुएँ अप्रत्यक्ष रूप से पैमाना बताती हैं, और वायुमंडलीय धुंध दूरी के साथ बढ़ती है। इनमें से कोई भी संकेत कोड में फ़िक्स्ड नहीं होता। वे ट्रेनिंग वितरण से आत्मसात किए जाते हैं।
3 जगहें जहाँ विज़ुअल AI अब भी विफल होता है
टेक्सचर का जाल
शुरुआती दर्ज की गई विफलताओं में से एक: एडवर्सेरियल टेक्सचर। शोधकर्ताओं ने दिखाया कि किसी 3D वस्तु पर एक ख़ास पैटर्न छापकर, आप न्यूरल नेटवर्क को उसे आत्मविश्वास से ग़लत वर्गीकृत करने पर मजबूर कर सकते हैं। सही टेक्सचर से ढका कछुआ राइफ़ल के रूप में वर्गीकृत हुआ। मॉडल आकार के बजाय टेक्सचर के आँकड़ों पर भारी निर्भर था, और यह एक ऐसी नाज़ुकता उजागर करता है जो मानव दृष्टि में नहीं होती।
व्यावहारिक रूप से, यह तब दिखता है जब मुख्य रूप से फ़ोटो पर ट्रेन हुआ मॉडल पेंटिंग या असामान्य प्राकृतिक सतहों की सामग्री को ग़लत पहचानता है। उथले कोण से ली गई खुरदरी कंक्रीट की दीवार को आत्मविश्वास से "छाल" लेबल किया जा सकता है, क्योंकि निचले स्तर के टेक्सचर आँकड़े मेल खाते हैं।
ट्रेनिंग वितरण से बाहर के इनपुट
न्यूरल नेटवर्क अपने ट्रेनिंग वितरण के भीतर भरोसेमंद इंटरपोलेटर हैं, और उसके बाहर अविश्वसनीय एक्सट्रापोलेटर। जिस मॉडल ने किसी ख़ास तरह के औद्योगिक उपकरण को कभी नहीं देखा, वह फिर भी आत्मविश्वास से लेबल देगा, आमतौर पर अपने ट्रेनिंग सेट में से दृश्य रूप से मिलती-जुलती कोई चीज़। स्टैंडर्ड क्लासिफ़ायर में अनिश्चितता जताने का कोई अंतर्निहित तंत्र नहीं होता।
💡 इसीलिए कैलिब्रेशन मायने रखता है। अच्छी तरह तैनात सिस्टम क्लासिफ़िकेशन आउटपुट के साथ कैलिब्रेटेड कॉन्फ़िडेंस स्कोर जोड़ते हैं और कम कॉन्फ़िडेंस वाले अनुमानों को अपने-आप कार्रवाई में लेने के बजाय मानव समीक्षा के लिए भेजते हैं।
मॉडल वसूली कैसे सीखते हैं
इन विफलता के तरीकों पर क्षेत्र की प्रतिक्रिया मुख्य रूप से ज़्यादा डेटा और ज़्यादा विविध डेटा है। डेटा ऑगमेंटेशन (ट्रेनिंग इमेज को बेतरतीब तरीके से फ़्लिप करना, क्रॉप करना, रंग बदलना और उनमें नॉइज़ जोड़ना) मॉडल को ऐसे फ़ीचर सीखने पर मजबूर करता है जो परिवर्तनों के बावजूद स्थिर रहें। Mixup और CutMix दो ट्रेनिंग इमेज को मिलाते हैं और नेटवर्क को मिश्रित लेबल पर ट्रेन करते हैं, जिससे निर्णय सीमाएँ चिकनी होती हैं।
हाल के तरीके सेल्फ़-सुपरवाइज़्ड प्री-ट्रेनिंग इस्तेमाल करते हैं, जहाँ मॉडल बिना लेबल वाली इमेज से सीखता है, मास्क किए गए हिस्सों का अनुमान लगाने जैसे प्रॉक्सी टास्क हल करके। इससे बने प्रतिनिधित्व ज़्यादा मज़बूत होते हैं, क्योंकि उन्हें सिर्फ़ क्लासिफ़िकेशन से जुड़े फ़ीचर के बजाय इमेज कंटेंट के पूरे वितरण का हिसाब रखना पड़ता है।
अपना विज़ुअल AI आउटपुट बनाकर देखें
अब जब आप समझ गए हैं कि जब AI कोई विज़ुअल दृश्य प्रोसेस करता है तो असल में क्या होता है, तो आप इमेज जनरेटर के साथ ज़्यादा सोच-समझकर काम कर सकते हैं। मॉडल का आउटपुट बेतरतीब नहीं है; वह "चीज़ें कैसी दिखती हैं" के सीखे हुए वितरण से सैंपल लेता है। आपका प्रॉम्प्ट कुछ बाधाओं का सेट है, जो उस वितरण को उस इमेज की ओर सीमित करता है जो आपके मन में है।
रोशनी की दिशा ("बाईं ओर से गर्म गोल्डन-आवर बैकलाइट"), कैमरा लेंस की विशेषताएँ ("85mm f/1.8 शैलो डेप्थ ऑफ़ फ़ील्ड"), और सतह के टेक्सचर ("प्राकृतिक रोमछिद्र दिखें, हर बाल की रेखा तीखी हो") बताना मॉडल के सीखे हुए विज़ुअल प्रतिनिधित्व के ख़ास हिस्सों को सक्रिय करता है। आप जितनी सटीकता से बताएँगे कि चीज़ें भौतिक रूप से कैसी दिखती हैं, मॉडल उसके ट्रेनिंग वितरण के सबसे घने और सबसे विस्तृत हिस्सों से उतना ही ज़्यादा काम ले सकेगा।
Flux Dev और Flux Pro दोनों भौतिक रूप से आधारित प्रॉम्प्टिंग पर अच्छी प्रतिक्रिया देते हैं। Imagen 4 प्राकृतिक रोशनी की स्थितियों में ख़ास तौर पर मज़बूत है। पोर्ट्रेट के लिए, Flux 1.1 Pro Ultra त्वचा और बालों का सबसे उच्च-गुणवत्ता वाला टेक्सचर देता है, क्योंकि यह मानव रूप की अपनी समृद्ध आंतरिक समझ पर काम करता है।
अपनी समझ बनाने का सबसे अच्छा तरीका है एक ही प्रॉम्प्ट को कई मॉडल पर चलाना और देखना कि हर एक किस पर ज़ोर देता है। ये अंतर असल में बताते हैं कि हर मॉडल अपने ट्रेनिंग डेटा से क्या "जानता" है। Picasso IA पर जाएँ, टेक्स्ट-टू-इमेज कलेक्शन से एक मॉडल चुनें, और भौतिक रूप से वर्णनात्मक प्रॉम्प्ट के साथ प्रयोग शुरू करें। आउटपुट में आप जो देखते हैं, वह इस बात का सीधा प्रतिबिंब है कि मॉडल ने विज़ुअल दुनिया के बारे में क्या सीखा है।


