ترفع مقطعًا لوجه شخص ما. تضيف مسارًا صوتيًا مختلفًا تمامًا، ربما تعليقًا صوتيًا مدبلجًا بالإسبانية، أو صوتًا مولّدًا بالذكاء الاصطناعي بالإنجليزية. خلال ثوانٍ، يحرّك الوجه في الفيديو فمه بتزامن تام مع الصوت الجديد، مطابقًا كل مقطع صوتي بوضع الشفتين الصحيح. يبدو الأمر حقيقيًا. لا شاشة خضراء، ولا استوديو، ولا إعادة تصوير.
هذا ما تفعله مزامنة الشفاه بالذكاء الاصطناعي. والعلم الذي يقف خلفها مثير للاهتمام فعلًا.
ماذا يفعل ذكاء مزامنة الشفاه فعليًا؟
يعتقد معظم الناس أن ذكاء مزامنة الشفاه "يخمّن" مكان الفم في أي لحظة. لكن الواقع أدق بكثير. النظام لا يخمّن، بل يقرأ. كل مسار صوتي هو مصدر بيانات منظّم. يقسّم الذكاء الاصطناعي هذه الإشارة إلى أصغر مكوناتها القابلة للقياس، ويقارن كل مكون بما يفعله الوجه البشري جسديًا عند نطق تلك الأصوات، ثم يشوّه منطقة الفم في إطار الفيديو إطارًا تلو الآخر لتطابقها. والنتيجة تبدو سلسة لأنها مبنية على علم الكلام الحقيقي، لا على التقريب.
تفكيك الإشارة الصوتية
عندما تُدخل مسارًا صوتيًا إلى نموذج لمزامنة الشفاه، أول ما يفعله هو تمرير الصوت عبر مسار معالجة الكلام. يحوّل هذا المسار الموجة الخام إلى سلسلة من الفونيمات، وهي أصغر وحدات الصوت في أي لغة منطوقة.
فكّر في الفونيمات باعتبارها اللبنات الأولية للكلام. تحتوي كلمة "hello" على خمسة فونيمات: /h/، /ɛ/، /l/، /l/، /oʊ/. لكل فونيم مدة متوقعة، ومغلف طاقة، ونمط تردد. يستطيع نموذج مدرَّب جيدًا استخراج كل هذه الخصائص من ملف صوتي نظيف خلال أجزاء من الثانية.
تستخدم طبقة معالجة الصوت عادةً تمثيل المعاملات السمعية لتردد مل (MFCC)، الذي يلتقط الشكل الطيفي للكلام بطريقة تحاكي عمل السمع البشري فعليًا. بعض النماذج الأحدث تستبدل MFCC كليًا بتمثيلات صوتية متعلَّمة من مشفّرات كلام قائمة على المحوّلات (transformers)، ما يمنحها أداءً أفضل عبر اللهجات واللغات وظروف التسجيل المختلفة.
💡 لماذا يهم هذا: جودة تحليل الصوت تتحكم مباشرة في دقة مزامنة الشفاه. الصوت النظيف لمتحدث واحد بتردد 44.1 كيلوهرتز ينتج نتائج أفضل بوضوح من التسجيلات المضغوطة أو الصاخبة.
تحمل الفونيمات المختلفة بصمات صوتية مختلفة في المجال الترددي. فالصوت الاحتكاكي المجهور مثل /v/ له شكل طيفي مختلف تمامًا عن الصوت الأنفي مثل /m/ أو الانفجاري مثل /p/. يتعلم النموذج التعرف على هذه البصمات بموثوقية حتى عندما تتداخل في كلام طبيعي متدفق. التداخل الصوتي (Coarticulation)، أي انتقال فونيم بسلاسة إلى الذي يليه دون فاصل واضح، من أصعب مشكلات معالجة الكلام. والبنى الحديثة تتعامل معه بنمذجة الصوت في نوافذ زمنية متداخلة، بدلًا من تحليل الفونيمات بمعزل عن بعضها.
ربط الصوت بأشكال الفم
بعد تقسيم الصوت إلى فونيمات، يحتاج النظام إلى ترجمة كل فونيم إلى شكل فم مقابل. في الرسوم المتحركة، تُسمّى هذه الأشكال الفيزيمات (visemes). تشترك كل اللغات في مجموعة أساسية من الفيزيمات، حتى لو اختلف مخزون الفونيمات بين لغة وأخرى اختلافًا كبيرًا.
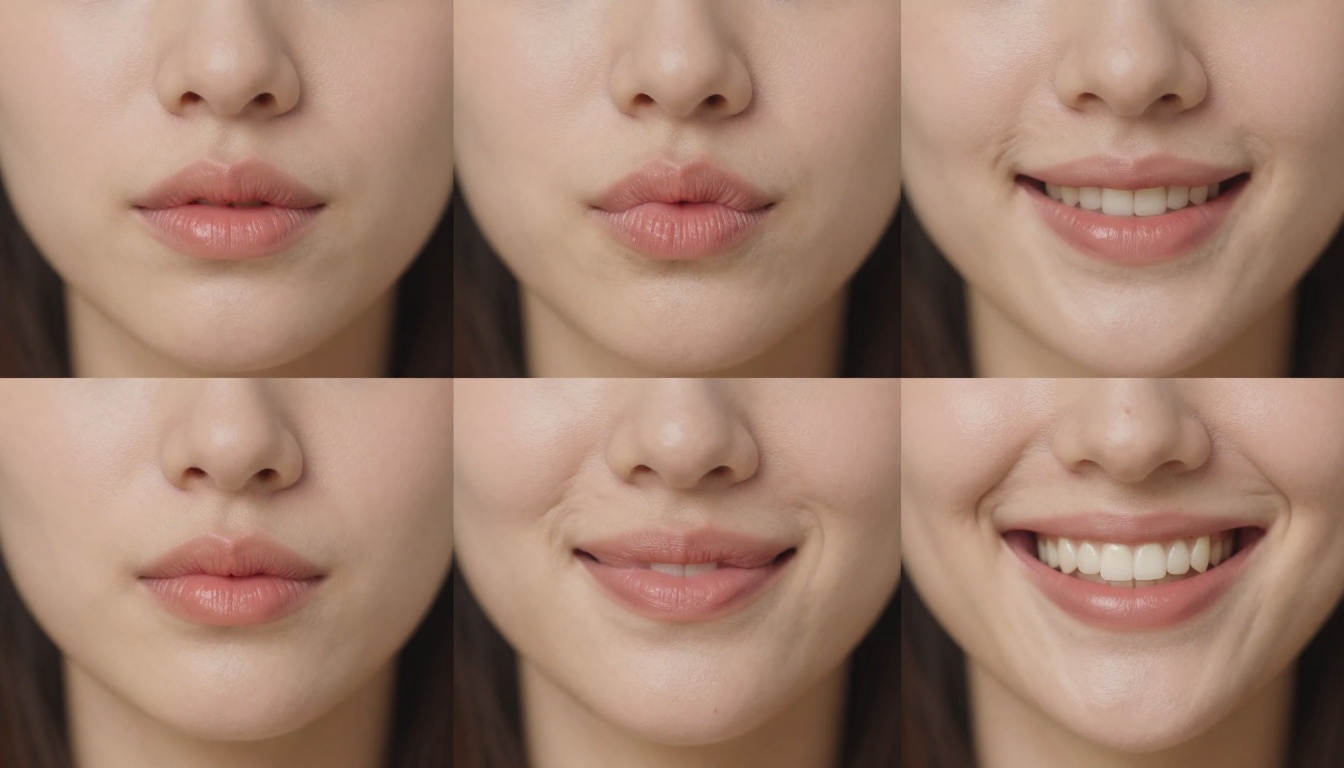
الربط بين الفونيم والفيزيم ليس تطابقًا بواحد لواحد. فعدة فونيمات كثيرًا ما تشترك في شكل الفم المرئي نفسه. الأصوات /p/ و/b/ و/m/ تبدو متشابهة تقريبًا على الشفتين، رغم اختلافها الصوتي. وهذا تحديدًا ما يجعل قراءة الشفاه صعبة على البشر، لكنها ممكنة لأنظمة الذكاء الاصطناعي التي تقرأ أيضًا حركة الفك الدقيقة، وانخفاض الذقن، وشد الخدين كإشارات مساعدة.
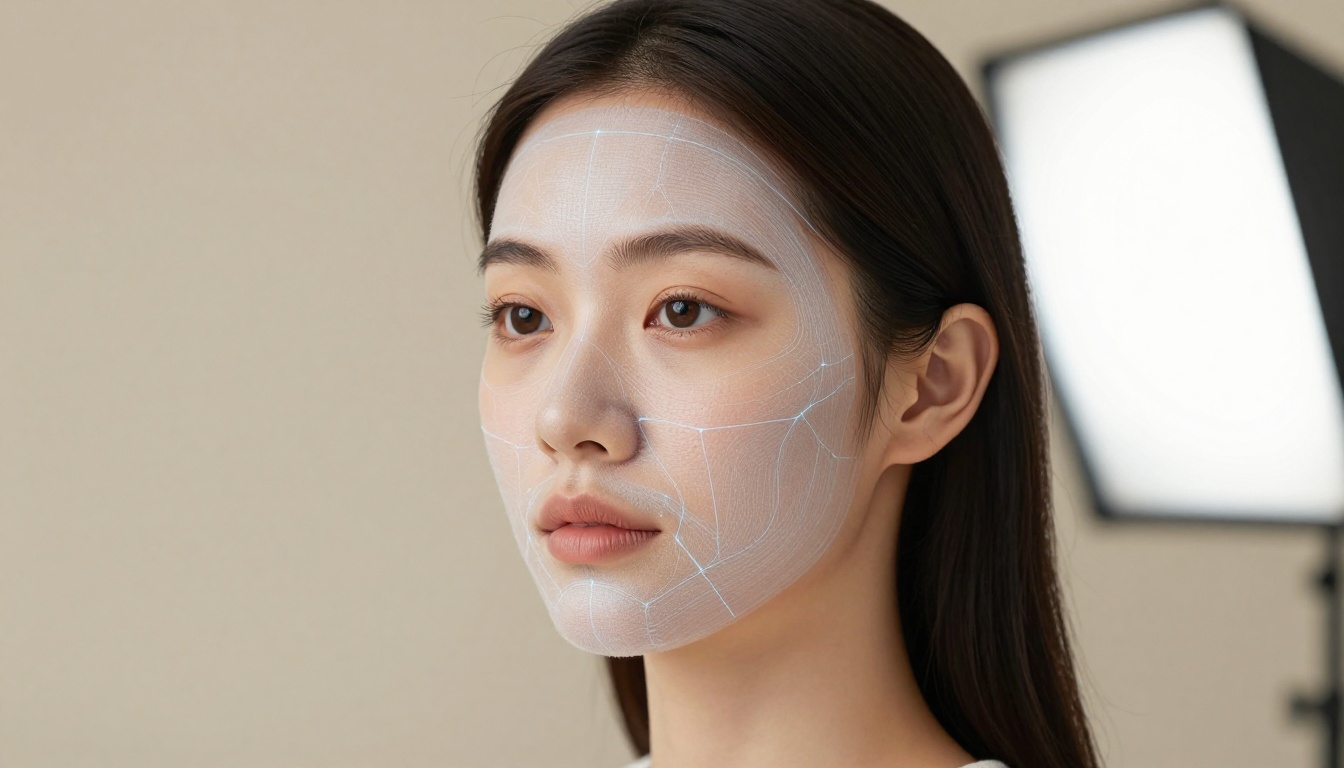
يستخدم الذكاء الاصطناعي كشف معالم الوجه (facial landmark detection) لتحديد من 68 إلى 478 نقطة مرجعية على الوجه، تشمل زوايا الشفتين بدقة، وقوس كيوبيد، وطرف الذقن، ومفصل الفك. تصبح هذه المعالم الهيكل العظمي الذي يعدّله النموذج إطارًا تلو الآخر لإنتاج كل فيزيم. ثم تُشوَّه منطقة الفم بالملمس لتطابق الشكل المستهدف، وتُدمج النتيجة مرة أخرى في الفيديو الأصلي مع الحرص على الحفاظ على ملمس البشرة، واستمرارية الإضاءة، والنعومة الطبيعية لحواف الشفتين.
البُعد الزمني لا يقل أهمية عن المكاني. فالفونيم لا يملك شكل فم فحسب، بل يملك لحظة بداية، وذروة، ثم انتهاء. يضبط الذكاء الاصطناعي توقيت كل فيزيم على هذه الأحداث الزمنية في الصوت بدقة على مستوى الإطار، ويعمل عادةً بمعدل 25 أو 30 إطارًا في الثانية لمطابقة صيغ الفيديو القياسية.
الشبكات العصبية التي تقف خلفه
ذكاء مزامنة الشفاه ليس نظامًا قائمًا على قواعد يكتبها أحدهم، مثل "عندما يحتوي الصوت على /m/ أغلق الشفتين". السلوك ينشأ كليًا من التدريب على مجموعات ضخمة من الكلام البشري الحقيقي والفيديو.
كيف تحدد بيانات التدريب الدقة
يُدرَّب نموذج جيد لمزامنة الشفاه على آلاف الساعات من فيديوهات الرؤوس المتحدثة مع صوت متزامن بدقة، تغطي لغات ولهجات وأعمارًا وظروف إضاءة متعددة. أثناء التدريب، يتعلم النموذج العلاقة الإحصائية بين خصائص الصوت وحركة الوجه، ويبني تمثيلًا داخليًا يتعمم إلى ما هو أبعد بكثير مما يمكن لمجموعة قواعد مصممة يدويًا أن تلتقطه.
لهذا تتعمم النماذج الحديثة بشكل جيد على متحدثين جدد. فهي لا تحفظ مجموعة ثابتة من أشكال الفم لكل متحدث. بل تبني دالة مستمرة قادرة على الاستيفاء بين الحالات المعروفة، ومعالجة التداخل الصوتي حيث يمتزج فونيم بما يليه، واحترام الديناميكيات الزمنية للكلام الطبيعي بما فيها الوقفات والتأكيد وأنماط التنفس.
| الميزة | الأنظمة القائمة على القواعد | نماذج الشبكات العصبية |
|---|
| دعم اللغات | مجموعة ثابتة فقط | متعددة اللغات |
| التعامل مع اللهجات | ضعيف | قوي |
| التداخل الصوتي | مُتجاهَل | مُنمذَج بدقة |
| التكيف مع متحدث جديد | غير موجود | فوري |
| الواقعية البصرية | منخفضة | عالية |
| إمكانية الضبط الدقيق | لا | نعم |
تنوع بيانات التدريب هو العامل الأهم الذي يفصل النماذج المتوسطة عن نماذج الجودة الإنتاجية. النموذج المدرَّب في الأساس على مذيعي أخبار إنجليزية سيواجه صعوبة مع الكلام السريع العامي، أو مع اللغات التي تستخدم فونيمات خارج توزيع بيانات تدريبه. وتستخدم أفضل النماذج الحالية بيانات من مئات المتحدثين عبر عشرات اللغات لبناء تغطية واسعة حقًا.
Wav2Lip وما تلاه
البنية التي وضعت مزامنة الشفاه بالذكاء الاصطناعي على الخريطة كانت Wav2Lip، المنشورة عام 2020. استخدمت نهجًا قائمًا على GAN مع مميّز مخصص لمزامنة الشفاه يقيّم ليس الجودة البصرية فقط، بل دقة التزامن إطارًا تلو الآخر. دُرِّب المميّز مسبقًا على مجموعة ضخمة من البيانات السمعية البصرية ليتعرف على ما إذا كانت حركة الشفاه تطابق مقطعًا صوتيًا معينًا.
أنتج Wav2Lip نتائج مثيرة للإعجاب، لكن كان له ضعف موثّق جيدًا: كان يُليّن منطقة الفم أحيانًا قليلًا، إذ كان يضحّي بحدة الملمس في سبيل دقة التزامن. تطور المجال كثيرًا منذ ذلك الحين.
تستخدم نماذج الإنتاج الحالية بنى الانتشار (diffusion)، ونماذج الوجوه ثلاثية الأبعاد القابلة للتشكيل (3DMMs)، والانتشار الكامن المشروط بالصوت لإنتاج نتائج دقيقة زمنيًا وواقعية كالصور الفوتوغرافية في آن واحد. وبدلًا من تشويه البكسلات مباشرة، تعيد بعض النماذج بناء منطقة الفم من الصفر، موجَّهةً بالإشارة الصوتية ومقيَّدةً بهندسة الوجه الأصلي. يحافظ هذا النهج على ملمس البشرة ويلغي أثر الضبابية. وتعمل عدة نماذج رائدة اليوم في الوقت الفعلي بمعدل 30 إطارًا في الثانية، ما يفتح الباب أمام البث المباشر وتطبيقات مؤتمرات الفيديو.
استخدامات واقعية موجودة بالفعل
ذكاء مزامنة الشفاه ليس نظريًا. إنه قيد الاستخدام الإنتاجي في صناعات متعددة اليوم.
الدبلجة المرئية بأي لغة
أهم تطبيق تجاري هو الدبلجة المرئية متعددة اللغات. تاريخيًا، كانت دبلجة فيلم أو وثائقي تتطلب ممثلين صوتيين، واستوديو تسجيل، وأسابيع من أعمال ما بعد الإنتاج لمطابقة التوقيت. وحتى مع هذا الجهد، كانت حركات الشفاه تبدو غالبًا خاطئة، لأن الحوار البديل يختلف في طوله عن الأصلي.
يغيّر ذكاء مزامنة الشفاه هذا تمامًا. يمكن دبلجة وثائقي يُعلَّق عليه بالإنجليزية إلى البرتغالية أو الهندية، مع إعادة توليد حركات الشفاه لتطابق المسار الصوتي الجديد. يتحرك وجه المتحدث في الفيديو بشكل طبيعي مع الكلام المترجم، دون أي إعادة تصوير.
💡 تأثير حقيقي: تستخدم منصات البث الآن الدبلجة بالذكاء الاصطناعي لإطلاق المحتوى بعشرات اللغات في وقت واحد، مع دقة في مزامنة الشفاه تصمد في ظروف المشاهدة العادية عبر جميعها.
المقدِّمون الافتراضيون والأفاتار بالذكاء الاصطناعي
تستخدم برامج التدريب المؤسسية ومنصات التعلم الإلكتروني وفيديوهات التسويق بشكل متزايد مقدِّمين متحركين بالذكاء الاصطناعي يقدمون محتوى مكتوبًا دون الحاجة إلى وقوف إنسان أمام الكاميرا في كل مراجعة. المقدِّم إما أفاتار اصطناعي واقعي كالصور الفوتوغرافية، أو صورة مسجلة لشخص حقيقي، تُدار بالكامل بمدخل صوتي.
يستفيد هذا الاستخدام بشكل كبير من ربط الفونيم بالفيزيم بدقة. فالفيديو التعليمي الذي لا تتطابق فيه حركة فم المقدِّم مع السرد يثير الانزعاج فورًا. إنه يشتت تركيز المشاهد ويضعف المصداقية في المحتوى. وعندما يكون التزامن محكمًا، يختفي العبء المعرفي ويبقى المشاهد مركزًا على المعلومات المقدَّمة.
إنشاء المحتوى دون إعادة تصوير
بالنسبة إلى صانعي المحتوى الأفراد، التطبيق الأكثر عملية فورًا هو تصحيح أخطاء التزامن بين الصوت والصورة في المحتوى المسجَّل. إذا انزاح المسار الصوتي لصانع المحتوى قليلًا أثناء التسجيل، أو إذا أراد إعادة تسجيل التعليق الصوتي بميكروفون أنظف، يمكن لمزامنة الشفاه بالذكاء الاصطناعي إعادة محاذاة الفيديو مع الصوت الجديد دون أي إعادة تصوير.
كما يتيح إنتاج نسخ متعددة اللغات من الفيديو نفسه. يمكن لقناة على YouTube أن تنشر المحتوى ذاته بالإنجليزية والإسبانية والفرنسية، مع مزامنة وجه المقدِّم مع كل مسار صوتي، كل ذلك من جلسة تسجيل أصلية واحدة. وهذا يقلّص وقت إنتاج المحتوى المحلّي من أيام إلى دقائق.
ما مدى دقته اليوم؟
تنقسم دقة مزامنة الشفاه بالذكاء الاصطناعي إلى بُعدين منفصلين: الدقة الزمنية (هل يتحرك الفم في اللحظة المناسبة تمامًا؟) والأمانة البصرية (هل يبدو شكل الفم طبيعيًا ويطابق الفونيم الذي يُنطق؟).
متى تكون النتائج متقنة؟
تعمل النماذج الحالية بأفضل شكل في هذه الظروف:
- توجيه الرأس أماميًا أو قريبًا من الأمامي ضمن نحو 30 درجة من مواجهة الكاميرا
- متحدث واحد دون أي وجوه أخرى في الإطار نفسه
- صوت نظيف خالٍ من الضوضاء مسجَّل بمعدل عينة قياسي
- إضاءة ثابتة ومتسقة دون تغيرات سريعة عبر المقطع
- موضع رأس مستقر نسبيًا دون حركة جانبية سريعة
في ظل هذه الظروف، تنتج النماذج المتقدمة نتائج لا تكاد تتمايز عن اللقطات الحقيقية عند سرعة التشغيل العادية. التزامن دقيق على مستوى الإطار، والفيزيمات صحيحة، وملمس البشرة حول منطقة الفم محفوظ دون أي تشوهات.
أين لا يزال يواجه صعوبات؟
لا يتعامل أي نموذج مع كل السيناريوهات بإتقان تام. تشمل حالات المشكلات الشائعة:
- زوايا الوجه الجانبية الحادة: عندما يُدار الرأس أكثر من 45 درجة، يكون لدى النموذج معالم مرئية أقل، وتصبح إعادة البناء أقل موثوقية.
- عدة متحدثين في الإطار: معظم النماذج مدرَّبة على سيناريوهات الوجه الواحد. تحدث أخطاء في نسبة الكلام إلى كل متحدث عادةً عندما يتكلم شخصان في الوقت نفسه.
- الكلام السريع جدًا: عند معدلات تتجاوز نحو 300 كلمة في الدقيقة، تنخفض الدقة الزمنية قليلًا.
- لغات ذات فونيمات نادرة: تغطية بيانات التدريب تحدد الأداء مباشرة على الفونيمات التي تظهر بشكل نادر في المجموعة.
- فيديو مصدر منخفض الدقة: لا توجد طريقة يستطيع بها النموذج توليد تفاصيل ملمس لم تكن موجودة في البكسلات الأصلية.
💡 نصيحة إنتاجية: سجّل الفيديو الأصلي والشخص يتحدث مباشرة إلى الكاميرا على خلفية نظيفة وذات إضاءة متساوية. سيُنتج النموذج نتائج أفضل بكثير مقارنةً باللقطات المصورة في ظروف صعبة.
كيفية استخدام ذكاء مزامنة الشفاه على PicassoIA
تقدم PicassoIA مجموعة كاملة من نماذج مزامنة الشفاه مباشرة داخل المنصة. لا إعداد محلي، ولا بيانات اعتماد API تحتاج إلى إدارة، ولا حاجة إلى GPU. ترفع الفيديو، وتقدم المسار الصوتي، ويتولى النموذج الباقي.
الخطوة 1: اختر نموذجك
تقدم PicassoIA عدة نماذج لمزامنة الشفاه، لكل منها نقاط قوة مختلفة:
- Lipsync 2 Pro من Sync: الخيار الأعلى دقةً المتاح. ينتج تزامنًا دقيقًا على مستوى الإطار مع جودة بصرية ممتازة عبر مجموعة واسعة من أنواع الوجوه وأساليب الصوت. ابدأ من هنا للحصول على مخرجات احترافية.
- Lipsync 2 من Sync: إصدار أسرع للحصول على نتائج سريعة حين لا تكون أقصى جودة بالغة الأهمية.
- React 1 من Sync: يضيف مزامنة شفاه واقعية إلى أي فيديو، مع التركيز على مخرجات طبيعية المظهر وأداء جيد على لقطات متنوعة.
- Kling Lip Sync من Kwaivgi: قوي في ظروف التصوير المتنوعة، بما في ذلك اللقطات المسجلة في بيئات أكثر تحديًا.
- PixVerse Lipsync: محسَّن للسرعة. مناسب للمعاينات السريعة والتكرار السريع.
- Omni Human من ByteDance: يحرّك صورة ثابتة لتصبح فيديو متحدثًا كاملًا من صورة واحدة ومسار صوتي. لا حاجة إلى فيديو مصدر.
- Fabric 1.0 من Veed: يجعل أي صورة تتحدث بالصوت عبر رسوم متحركة يحركها الصوت، ومحسَّن لصيغ وسائل التواصل الاجتماعي.
الخطوة 2: ارفع الفيديو
انتقل إلى صفحة النموذج وارفع مقطع الفيديو الأصلي. للحصول على أفضل النتائج:
- الصيغة: يُفضَّل MP4 أو MOV
- الدقة: 720p على الأقل، مع 1080p لنتائج أفضل بوضوح
- الشخص: وجه واحد واضح، أماميّ وجيد الإضاءة
- المدة: تتعامل معظم النماذج مع مقاطع من بضع ثوانٍ حتى عدة دقائق
تجنب الملفات المضغوطة بشدة، واللقطات التي تحتوي على ضبابية حركة، أو المقاطع ذات التغيرات السريعة في الإضاءة بين اللقطات.
الخطوة 3: أضف الصوت
ارفع المسار الصوتي الذي تريد مزامنته مع الفيديو. يمكن أن يكون:
- تعليقًا صوتيًا مدبلجًا سجّله ممثل صوتي
- صوتًا مولّدًا بالذكاء الاصطناعي من نظام تحويل النص إلى كلام. تقدم PicassoIA أيضًا نماذج تحويل النص إلى كلام التي تتناسب بشكل طبيعي مع سير عمل مزامنة الشفاه.
- تسجيلًا معادًا لسردك الخاص بجودة ميكروفون أفضل
- أي كلام مسجل بصيغة WAV أو MP3 أو M4A
💡 يجب أن يحتوي الصوت على كلام فقط. الموسيقى الخلفية أو الضوضاء المحيطة المختلطة بالمسار الصوتي تقلل دقة المزامنة بشكل كبير. استخدم تسجيلًا صوتيًا نظيفًا ومعزولًا عندما يكون ذلك ممكنًا.
الخطوة 4: أنشئ وحمّل
اضغط على التوليد. يعتمد وقت المعالجة على مدة المقطع والنموذج المختار، ويتراوح من بضع ثوانٍ إلى دقيقتين تقريبًا للمحتوى الأطول. فيديو الناتج متاح للتحميل مباشرة من المنصة، مع حركات شفاه متزامنة تمامًا مع مسارك الصوتي، وجودة الفيديو الأصلية محفوظة خارج منطقة الفم.
ما الذي يصنع نتيجة جيدة لمزامنة الشفاه؟
يتولى النموذج العبء الأكبر، لكن مدخلاتك تحدد سقف الجودة.
جودة الصوت هي كل شيء
يستحق هذا التكرار لأنه العامل الأكثر إغفالًا. يقرأ نموذج مزامنة الشفاه خصائص الصوت لتحديد وضع الفم إطارًا تلو الآخر. إذا كان الصوت صاخبًا، أو مضغوطًا بمعدل بت منخفض، أو يحتوي على صوتين في الوقت نفسه، يصبح استخراج الخصائص غير موثوق، ويتراجع المخرج المرئي بنسبة مماثلة.
أفضل الممارسات لمدخل الصوت:
- سجّل في غرفة هادئة خالية من ضوضاء الخلفية
- استخدم ميكروفونًا مخصصًا بدلًا من ميكروفون الحاسوب المحمول أو الهاتف المدمج
- صدّر بمعدل 44.1 كيلوهرتز بصيغة WAV أو FLAC
- طبّع مستوى الصوت قبل الرفع، مستهدفًا نحو -14 LUFS للكلام
- شغّل مرحلة تقليل الضوضاء إذا لم تكن بيئة التسجيل مثالية
متطلبات مدخل الفيديو
يحدد مدخل الفيديو الأساس البصري الذي يعمل عليه النموذج. لا توجد طريقة لاستعادة تفاصيل غير موجودة في البكسلات الأصلية.
أفضل الممارسات لمدخل الفيديو:
- صوّر بدقة 1080p كحد أدنى، و4K إذا كان سير عملك يدعمها
- استخدم إضاءة متسقة ومتساوية دون ظلال حادة تقع على منطقة الفم
- حافظ على الشخص ثابتًا نسبيًا ومتمركزًا في الإطار طوال المقطع
- تجنب تطبيق معالجة لاحقة ثقيلة أو فلاتر على اللقطات الأصلية قبل الرفع
- تأكد من أن الوجه واضح تمامًا وغير مخفي جزئيًا بالأيدي أو الشعر أو الأشياء
الفرق في الجودة بين مدخل مُعدّ جيدًا ومقطع سُجّل على عجل كبير في المخرج النهائي. بضع دقائق من التحضير قبل التسجيل تؤتي ثمارًا كبيرة.
ابدأ الإنشاء بمزامنة الشفاه بالذكاء الاصطناعي
انتقل ذكاء مزامنة الشفاه من فضول بحثي إلى أداة إنتاج عملية حقًا. سواء كنت تقوم بتوطين محتوى الفيديو بعدة لغات، أو تبني مقدمين مدعومين بالذكاء الاصطناعي لمواد التدريب، أو تصلح تعليقًا صوتيًا لم يكن موفقًا تمامًا، فالأدوات متاحة الآن دون أي إعداد تقني.
تضع مجموعة PicassoIA لمزامنة الشفاه كامل نطاق النماذج الحالية في مكان واحد، من Omni Human من ByteDance لتحريك صورة ثابتة إلى فيديو متحدث، إلى Lipsync 2 Pro من Sync للمزامنة الصوتية المرئية بجودة احترافية على أي لقطات موجودة.
الفجوة بين ما سجّلته وما كنت تنوي إنشاءه أصبحت أصغر بكثير. ارفع مقطعًا، وأضف صوتك، وشاهد بنفسك ما تستطيع هذه النماذج فعله.


