Subes un clip con el rostro de alguien. Añades una pista de audio completamente distinta, quizá una voz en off doblada al español, quizá una voz generada por IA en inglés. En cuestión de segundos, el rostro del video mueve la boca en perfecta sincronía con el nuevo audio, ajustando cada sílaba a la posición correcta de los labios. Parece real. No hace falta pantalla verde, ni estudio, ni repetir tomas.
Eso es lo que hace la sincronización labial con IA. Y la ciencia que hay detrás es realmente fascinante.
Qué hace realmente la IA de sincronización labial
La mayoría de la gente cree que la IA de sincronización labial "adivina" dónde debe estar la boca en cada momento. La realidad es mucho más precisa. El sistema no adivina, lee. Cada fragmento de audio es una fuente de datos estructurada. La IA descompone esa señal en sus componentes medibles más pequeños, compara cada componente con lo que hace físicamente un rostro humano al producir esos sonidos y luego deforma la zona de la boca fotograma a fotograma para igualarlos. El resultado parece natural porque se basa en la ciencia real del habla, no en aproximaciones.
Cómo se descompone la señal de audio
Cuando introduces una pista de audio en un modelo de sincronización labial, lo primero que hace es pasar el audio por un pipeline de procesamiento del habla. Este pipeline convierte la forma de onda original en una secuencia de fonemas, las unidades de sonido más pequeñas de cualquier idioma hablado.
Piensa en los fonemas como los bloques básicos del habla. La palabra "hola" contiene tres fonemas: /o/, /l/, /a/. Cada fonema tiene una duración, una envolvente de energía y un patrón de frecuencia predecibles. Un modelo bien entrenado puede extraer todas estas características de un archivo de audio limpio en milisegundos.
La capa de procesamiento de audio suele usar una representación de coeficientes cepstrales en la escala de Mel (MFCC), que captura la forma espectral del habla de un modo que refleja cómo funciona realmente la audición humana. Algunos modelos más recientes reemplazan los MFCC por incrustaciones de audio aprendidas con codificadores de habla basados en transformers, lo que ofrece mejores resultados con distintos acentos, idiomas y condiciones de grabación.
💡 Por qué importa: La calidad del análisis de audio determina directamente la precisión de la sincronización labial. Un audio limpio, de un solo hablante y a 44,1 kHz produce resultados notablemente mejores que las grabaciones comprimidas o con ruido.
Los distintos fonemas tienen huellas acústicas diferentes en el dominio de la frecuencia. Una fricativa sonora como /v/ tiene una forma espectral completamente distinta a una nasal como /m/ o a una oclusiva como /p/. El modelo aprende a reconocer estas firmas con fiabilidad incluso cuando se mezclan en el habla natural y fluida. La coarticulación, en la que un fonema pasa suavemente al siguiente sin una pausa clara, es uno de los problemas más difíciles del procesamiento del habla. Las arquitecturas modernas lo resuelven modelando el audio en ventanas temporales superpuestas, en lugar de analizar los fonemas de forma aislada.
Cómo se asocia el sonido con la forma de la boca
Una vez que el audio se descompone en fonemas, el sistema necesita traducir cada fonema a una forma de boca correspondiente. En animación, estas formas se llaman visemas. Todos los idiomas comparten un conjunto básico de visemas, aunque el inventario de fonemas difiera mucho de un idioma a otro.
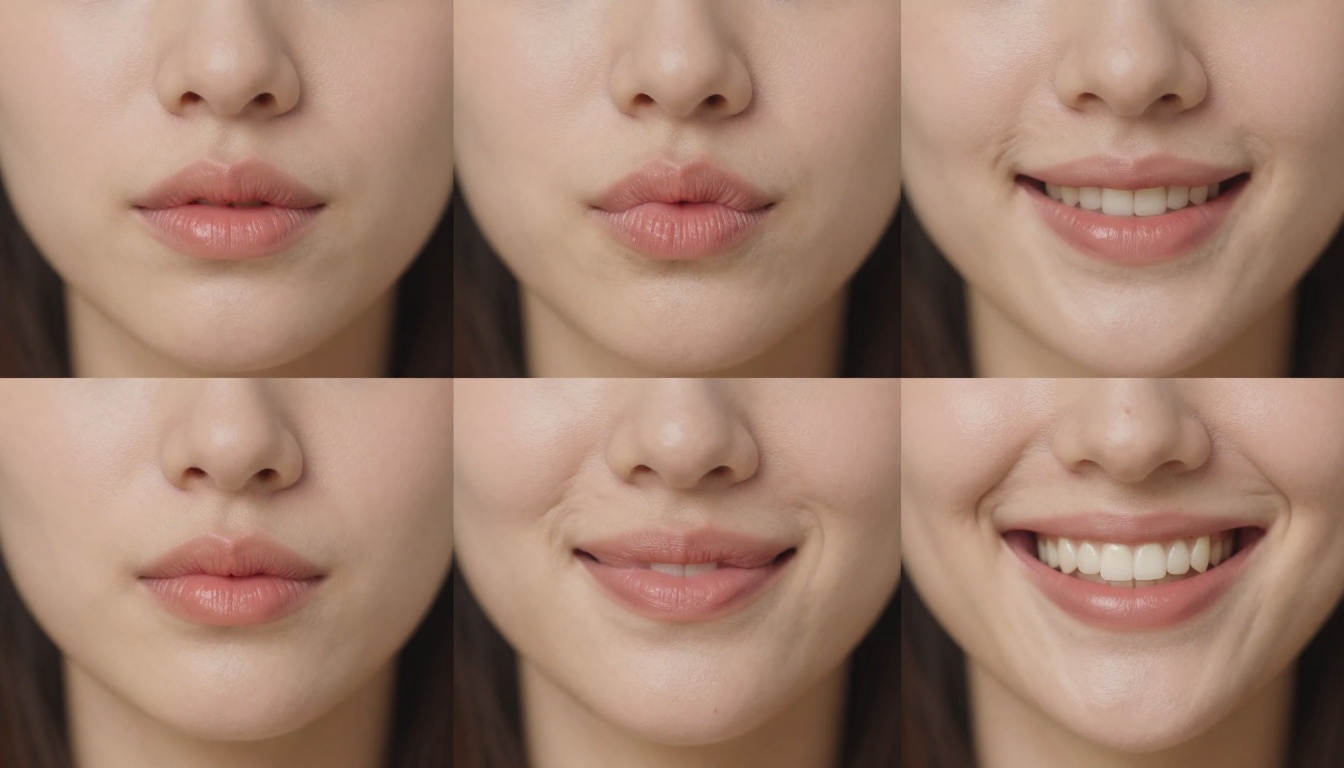
La correspondencia entre fonema y visema no es uno a uno. Varios fonemas suelen compartir la misma forma visible de la boca. Los sonidos /p/, /b/ y /m/ se ven casi idénticos en los labios, aunque sean acústicamente distintos. Por eso la lectura labial es difícil para las personas, pero manejable para los sistemas de IA, que también leen como indicios complementarios el sutil movimiento de la mandíbula, la caída del mentón y la tensión de las mejillas.
La IA usa la detección de puntos de referencia faciales para identificar entre 68 y 478 puntos de referencia en el rostro, incluidas las comisuras exactas de los labios, el arco de Cupido, la punta del mentón y la articulación de la mandíbula. Estos puntos forman el esqueleto que el modelo manipula fotograma a fotograma para producir cada visema. Después, la zona alrededor de la boca se deforma en textura para ajustarse a la forma objetivo, y el resultado se integra de nuevo en el video original cuidando la textura de la piel, la continuidad de la iluminación y la suavidad natural de los bordes de los labios.
La dimensión temporal es tan importante como la espacial. Un fonema no solo tiene una forma de boca. Tiene un inicio, un pico y una caída. La IA sincroniza cada visema con esos eventos temporales del audio con precisión de fotograma, normalmente trabajando a 25 o 30 fotogramas por segundo para ajustarse a los formatos de video estándar.
Las redes neuronales que hay detrás
La IA de sincronización labial no es un sistema basado en reglas en el que alguien escribió "cuando el audio contiene /m/, cierra los labios". El comportamiento surge por completo del entrenamiento con enormes conjuntos de datos de habla humana real y video.
Cómo los datos de entrenamiento determinan la precisión
Un buen modelo de sincronización labial se entrena con miles de horas de video de cabezas parlantes con audio sincronizado con precisión, que cubren varios idiomas, acentos, edades y condiciones de iluminación. Durante el entrenamiento, el modelo aprende la relación estadística entre las características del audio y el movimiento facial, y construye una representación interna que se generaliza mucho más allá de lo que podría captar un conjunto de reglas programadas a mano.
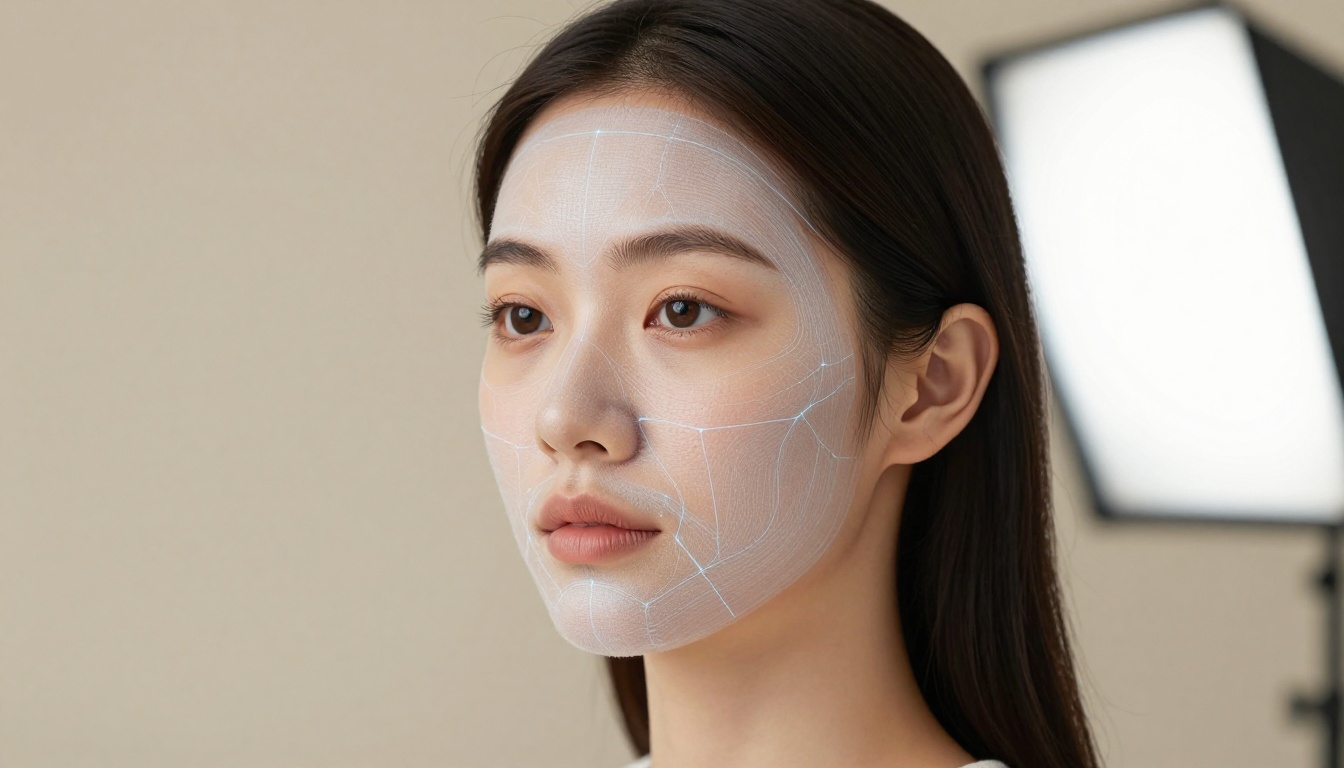
Por eso los modelos actuales generalizan tan bien a nuevos hablantes. No memorizan un conjunto fijo de formas de boca para cada persona. Construyen una función continua que puede interpolar entre estados conocidos, gestionar la coarticulación en la que un fonema se funde con el siguiente y respetar la dinámica temporal del habla natural, con sus pausas, énfasis y patrones de respiración.
| Característica | Sistemas basados en reglas | Modelos de redes neuronales |
|---|
| Soporte de idiomas | Solo un conjunto fijo | Multilingüe |
| Manejo de acentos | Deficiente | Sólido |
| Coarticulación | Ignorada | Modelada con precisión |
| Adaptación a nuevos hablantes | Ninguna | Inmediata |
| Realismo visual | Bajo | Alto |
| Ajuste fino posible | No | Sí |
La diversidad de los datos de entrenamiento es el factor individual más importante que separa los modelos corrientes de los de calidad de producción. Un modelo entrenado sobre todo con presentadores de noticias en inglés tendrá problemas con el habla rápida y coloquial, o con idiomas que usan fonemas fuera de su distribución de entrenamiento. Los mejores modelos actuales usan datos de cientos de hablantes en decenas de idiomas para lograr una cobertura realmente amplia.
Wav2Lip y lo que vino después
La arquitectura que puso la sincronización labial con IA en el mapa fue Wav2Lip, publicada en 2020. Usaba un enfoque basado en GAN con un discriminador de sincronización labial dedicado, que evaluaba no solo la calidad visual sino también la precisión de la sincronía fotograma a fotograma. El discriminador estaba preentrenado con un conjunto de datos audiovisual masivo para reconocer si un movimiento de labios coincidía con un segmento de audio dado.
Wav2Lip producía resultados impresionantes, pero tenía una debilidad bien documentada: a veces suavizaba ligeramente la zona de la boca, sacrificando la textura nítida a cambio de precisión en la sincronía. El campo ha avanzado mucho desde entonces.
Los modelos de producción actuales usan arquitecturas de difusión, modelos faciales 3D morfables (3DMM) y difusión latente condicionada por audio para producir resultados que son a la vez precisos en el tiempo y fotorrealistas. En lugar de deformar píxeles directamente, algunos modelos reconstruyen la zona de la boca desde cero, guiados por la señal de audio y limitados por la geometría del rostro original. Este enfoque conserva la textura de la piel y elimina el efecto de desenfoque. Varios modelos líderes ya funcionan en tiempo real a 30 fps, lo que abre la puerta a aplicaciones de transmisión en vivo y videoconferencias.
Usos reales que ya existen
La IA de sincronización labial no es teórica. Ya se usa en producción en varios sectores.
Doblaje de video en cualquier idioma
La aplicación con más peso comercial es el doblaje de video multilingüe. Antes, doblar una película o un documental exigía actores de voz, un estudio de grabación y semanas de posproducción para ajustar los tiempos. Aun con ese esfuerzo, los movimientos de los labios solían verse mal, porque el diálogo de reemplazo tenía una duración distinta a la original.
La sincronización labial con IA cambia todo esto por completo. Un documental narrado en inglés puede doblarse al portugués o al hindi, con los movimientos de los labios regenerados para ajustarse a la nueva pista de audio. El rostro del hablante en el video se mueve con naturalidad al ritmo del habla traducida, sin necesidad de repetir la grabación.
💡 Impacto real: Las plataformas de streaming ya usan el doblaje con IA para estrenar contenido en decenas de idiomas a la vez, con una precisión de sincronización labial que se mantiene aceptable en condiciones normales de visionado en todos ellos.
Presentadores virtuales y avatares de IA
La formación corporativa, las plataformas de e-learning y los videos de marketing usan cada vez más presentadores animados por IA que ofrecen contenido guionizado sin que una persona tenga que ponerse frente a la cámara en cada revisión. El presentador es un avatar sintético fotorrealista o la imagen grabada de una persona real, controlado por completo mediante audio.
Este caso de uso se beneficia enormemente de una correspondencia precisa entre fonema y visema. Un video de e-learning en el que la boca del presentador no coincide con la narración resulta chocante de inmediato. Rompe la concentración del espectador y resta credibilidad al contenido. Cuando la sincronía es ajustada, la carga cognitiva desaparece y el espectador se mantiene centrado en la información que se transmite.
Crear contenido sin repetir tomas
Para los creadores independientes, la aplicación más práctica de inmediato es corregir errores de sincronización entre audio y video en contenido ya grabado. Si la pista de audio de un creador se desfasó ligeramente durante la grabación, o si quiere volver a grabar la locución con un micrófono mejor, la sincronización labial con IA puede realinear el video con el nuevo audio sin repetir la grabación.
También permite producir versiones multilingües del mismo video. Un canal de YouTube puede publicar el mismo contenido en inglés, español y francés, con el rostro del presentador sincronizado con cada pista de audio, todo a partir de una única sesión de grabación original. Esto reduce el tiempo de producción de contenido localizado de días a minutos.
¿Hasta qué punto es precisa hoy?
La precisión de la sincronización labial con IA se divide en dos dimensiones distintas: la precisión temporal (¿la boca se mueve exactamente en el momento justo?) y la fidelidad visual (¿la forma de la boca se ve natural y corresponde al fonema concreto que se pronuncia?).
Cuándo los resultados son impecables
Los modelos actuales funcionan mejor en estas condiciones:
- Orientación de la cabeza de frente o casi de frente, dentro de unos 30 grados respecto a la cámara
- Un solo hablante sin otros rostros en el mismo encuadre
- Audio limpio y sin ruido grabado a una frecuencia de muestreo estándar
- Iluminación estable y constante sin cambios bruscos durante el clip
- Posición de la cabeza relativamente estable, sin movimientos laterales rápidos
En estas condiciones, los modelos más avanzados producen resultados prácticamente indistinguibles de una grabación real a velocidad normal de reproducción. La sincronía es precisa fotograma a fotograma, los visemas son correctos y la textura de la piel alrededor de la boca se conserva sin artefactos.
Dónde todavía tiene problemas
Ningún modelo maneja todos los escenarios a la perfección. Entre los casos problemáticos más habituales están:
- Vistas de perfil extremo: Cuando la cabeza gira más de 45 grados, el modelo tiene menos puntos de referencia visibles y la reconstrucción es menos fiable.
- Varios hablantes en el encuadre: La mayoría de los modelos se entrenan con escenarios de un solo rostro. Dos personas que hablan a la vez suelen provocar errores de atribución.
- Habla muy rápida: A velocidades superiores a unas 300 palabras por minuto, la precisión temporal disminuye ligeramente.
- Idiomas con fonemas poco frecuentes: La cobertura de los datos de entrenamiento determina directamente el rendimiento con los fonemas que aparecen poco en el conjunto de datos.
- Video de origen de baja resolución: El modelo no puede generar detalle de textura que no estuviera en los píxeles originales.
💡 Consejo de producción: Graba el video original con el sujeto hablando directamente a cámara, sobre un fondo limpio e iluminado de forma uniforme. El modelo producirá resultados mucho mejores en comparación con las grabaciones hechas en condiciones difíciles.
Cómo usar la IA de sincronización labial en PicassoIA
PicassoIA ofrece una colección completa de modelos de lipsync directamente en la plataforma. Sin instalación local, sin credenciales de API que gestionar y sin necesidad de GPU. Subes tu video, aportas tu pista de audio y el modelo se encarga del resto.
Paso 1: Elige tu modelo
PicassoIA ofrece varios modelos de lipsync, cada uno con sus puntos fuertes:
- Lipsync 2 Pro de Sync: La opción de mayor fidelidad disponible. Produce una sincronía precisa fotograma a fotograma, con una calidad visual excelente en una amplia gama de tipos de rostro y estilos de audio. Empieza por aquí si buscas un resultado profesional.
- Lipsync 2 de Sync: Una versión más rápida para entregas más ágiles en las que la calidad máxima es menos crítica.
- React 1 de Sync: Añade sincronización labial realista a cualquier video, con foco en un resultado de aspecto natural y buen rendimiento con material variado.
- Kling Lip Sync de Kwaivgi: Funciona muy bien en condiciones de grabación variadas, incluido el material filmado en entornos más difíciles.
- PixVerse Lipsync: Optimizado para la velocidad. Ideal para vistas previas rápidas e iteraciones ágiles.
- Omni Human de ByteDance: Anima una foto fija hasta convertirla en un video completo de una persona hablando, a partir de una sola imagen y una pista de audio. No necesita video de origen.
- Fabric 1.0 de Veed: Hace que cualquier foto hable con animación impulsada por audio, optimizada para formatos de redes sociales.
Paso 2: Sube tu video
Ve a la página del modelo y sube tu clip de video original. Para obtener mejores resultados:
- Formato: MP4 o MOV, preferiblemente
- Resolución: Al menos 720p, y 1080p ofrece resultados notablemente mejores
- Sujeto: Un rostro claramente visible, de frente y bien iluminado
- Duración: La mayoría de los modelos admiten clips de unos pocos segundos hasta varios minutos
Evita los archivos muy comprimidos, el material con desenfoque por movimiento o los clips con cambios bruscos de iluminación entre cortes.
Paso 3: Añade tu audio
Sube la pista de audio que quieres sincronizar con el video. Puede ser:
- Una voz en off doblada, grabada por un actor de voz
- Una voz generada por IA a partir de un sistema de texto a voz. PicassoIA también ofrece modelos de texto a voz que encajan de forma natural con el flujo de trabajo de lipsync.
- Una versión regrabada de tu propia narración, con mejor calidad de micrófono
- Cualquier audio de habla en formato WAV, MP3 o M4A
💡 El audio debe contener solo habla. La música de fondo o el ruido ambiental mezclados en la pista reducen mucho la precisión de la sincronización. Usa, siempre que sea posible, una grabación de voz limpia y aislada.
Paso 4: Genera y descarga
Pulsa generar. El tiempo de procesamiento depende de la duración del clip y del modelo elegido, y va desde unos pocos segundos hasta un par de minutos en contenidos más largos. El video resultante puede descargarse directamente desde la plataforma, con los movimientos de labios completamente sincronizados con tu pista de audio y la calidad original del video conservada fuera de la zona de la boca.
Qué hace que un resultado de sincronización labial sea bueno
El modelo hace el trabajo pesado, pero tus entradas determinan el techo de calidad.
La calidad del audio lo es todo
Conviene insistir en esto, porque es el factor que más se pasa por alto. Un modelo de sincronización labial lee las características del audio para determinar la posición de la boca fotograma a fotograma. Si el audio tiene ruido, está comprimido con una tasa de bits baja o contiene dos voces a la vez, la extracción de características se vuelve poco fiable y el resultado visual sufre en la misma proporción.
Buenas prácticas para la entrada de audio:
- Graba en una habitación silenciosa, sin ruido de fondo
- Usa un micrófono dedicado en lugar del micrófono integrado de un equipo portátil o de un teléfono
- Exporta a 44,1 kHz en formato WAV o FLAC
- Normaliza el nivel de audio antes de subirlo, con un objetivo de alrededor de -14 LUFS para la voz
- Aplica una pasada de reducción de ruido si el entorno de grabación no era el ideal
Requisitos del video de entrada
El video de entrada sienta la base visual sobre la que trabaja el modelo. No hay forma de recuperar detalle que no esté en los píxeles originales.
Buenas prácticas para la entrada de video:
- Graba a 1080p como mínimo, o a 4K si tu flujo de trabajo lo permite
- Usa una iluminación uniforme y constante, sin sombras duras sobre la zona de la boca
- Mantén al sujeto relativamente quieto y centrado en el encuadre durante todo el clip
- Evita aplicar un postprocesado intenso o filtros al material original antes de subirlo
- Asegúrate de que el rostro se vea con claridad y no quede tapado parcialmente por manos, cabello u objetos
La diferencia de calidad entre una entrada bien preparada y un clip grabado a toda prisa es considerable en el resultado final. Unos minutos de preparación antes de grabar compensan con creces.
Empieza a crear con la sincronización labial con IA
La sincronización labial con IA ha pasado de ser una curiosidad de investigación a una herramienta de producción realmente práctica. Ya sea que estés adaptando contenido de video a varios idiomas, creando presentadores con IA para materiales de formación o corrigiendo una locución que no quedó del todo bien, las herramientas para hacerlo están disponibles ahora mismo y no requieren ninguna configuración técnica.
La colección de lipsync de PicassoIA reúne en un solo lugar toda la gama de modelos actuales, desde Omni Human de ByteDance para animar una foto fija hasta convertirla en un video que habla, y hasta Lipsync 2 Pro de Sync para una sincronización audio-video de nivel profesional sobre cualquier material existente.
La distancia entre lo que grabaste y lo que querías crear se ha reducido mucho. Sube un clip, añade tu audio y descubre lo que pueden hacer estos modelos.


