आप किसी के चेहरे का एक क्लिप अपलोड करते हैं। फिर एक बिल्कुल अलग ऑडियो ट्रैक डालते हैं, शायद स्पैनिश में डब की गई वॉइसओवर, या अंग्रेज़ी में AI से बनी आवाज़। कुछ ही सेकंड में वीडियो में चेहरा नए ऑडियो के साथ परफ़ेक्ट सिंक में अपना मुँह हिलाने लगता है, हर अक्षर के साथ होंठों की सही स्थिति मिलाते हुए। यह असली लगता है। कोई ग्रीन स्क्रीन, स्टूडियो या रीटेक ज़रूरी नहीं।
यही AI लिप सिंक करता है। और इसके पीछे का विज्ञान सच में दिलचस्प है।
लिप सिंक AI असल में क्या करता है
ज़्यादातर लोग मानते हैं कि लिप सिंक AI किसी भी पल मुँह कहाँ होना चाहिए, इसका "अंदाज़ा" लगाता है। असलियत इससे कहीं ज़्यादा सटीक है। सिस्टम अंदाज़ा नहीं लगाता। वह पढ़ता है। हर ऑडियो एक संरचित डेटा स्रोत है। AI उस सिग्नल को उसके सबसे छोटे मापने योग्य हिस्सों में तोड़ता है, हर हिस्से को उन ध्वनियों के समय चेहरे की असली हरकत से मिलाता है, और फिर वीडियो के हर फ़्रेम में मुँह वाले हिस्से को उसी के हिसाब से मोड़ता है। नतीजा सहज लगता है, क्योंकि यह असली बोलने के विज्ञान पर बना है, अनुमान पर नहीं।
ऑडियो सिग्नल को तोड़कर समझना
जब आप किसी लिप सिंक मॉडल में ऑडियो ट्रैक डालते हैं, तो सबसे पहले वह उसे एक स्पीच प्रोसेसिंग पाइपलाइन से गुज़ारता है। यह पाइपलाइन कच्चे वेवफ़ॉर्म को फ़ोनीम्स के क्रम में बदलती है, यानी किसी भी बोली जाने वाली भाषा की सबसे छोटी ध्वनि इकाइयों में।
फ़ोनीम्स को बोली के बुनियादी बिल्डिंग ब्लॉक्स समझें। शब्द "hello" में पाँच फ़ोनीम हैं: /h/, /ɛ/, /l/, /l/, /oʊ/। हर फ़ोनीम की एक अनुमानित अवधि, एनर्जी एनवेलप और फ़्रीक्वेंसी पैटर्न होता है। एक अच्छी तरह प्रशिक्षित मॉडल साफ़ ऑडियो फ़ाइल से ये सभी फ़ीचर मिलीसेकंड में निकाल सकता है।
ऑडियो प्रोसेसिंग लेयर आम तौर पर Mel-frequency cepstral coefficient (MFCC) प्रतिनिधित्व इस्तेमाल करती है, जो बोली के स्पेक्ट्रल आकार को इस तरह पकड़ता है जैसे इंसानी सुनने की क्षमता काम करती है। कुछ नए मॉडल MFCCs की जगह पूरी तरह ट्रांसफ़ॉर्मर-आधारित स्पीच एन्कोडर से सीखे गए ऑडियो एम्बेडिंग्स इस्तेमाल करते हैं, जिससे अलग-अलग लहजों, भाषाओं और रिकॉर्डिंग की परिस्थितियों में बेहतर प्रदर्शन मिलता है।
💡 यह क्यों मायने रखता है: ऑडियो विश्लेषण की गुणवत्ता सीधे लिप सिंक की सटीकता को नियंत्रित करती है। 44.1kHz पर साफ़, एक ही वक्ता वाला ऑडियो संकुचित या शोर वाली रिकॉर्डिंग से साफ़ तौर पर बेहतर नतीजे देता है।
अलग-अलग फ़ोनीम्स की फ़्रीक्वेंसी डोमेन में अलग-अलग ध्वनिक पहचान होती है। /v/ जैसे वॉइस्ड फ़्रिकेटिव का स्पेक्ट्रल आकार /m/ जैसे नेज़ल या /p/ जैसे प्लोसिव से बिल्कुल अलग होता है। मॉडल इन पहचानों को भरोसे से पहचानना सीखता है, भले ही वे स्वाभाविक, बहते हुए बोलचाल में आपस में मिल जाएँ। कोआर्टिक्युलेशन, यानी जब एक फ़ोनीम बिना किसी साफ़ विराम के अगले में धीरे से बदल जाता है, स्पीच प्रोसेसिंग की सबसे कठिन समस्याओं में से एक है। आधुनिक आर्किटेक्चर इसे ऑडियो को ओवरलैपिंग टेम्पोरल विंडोज़ में मॉडल करके सँभालते हैं, न कि फ़ोनीम्स को अलग-अलग करके।
ध्वनि को मुँह के आकार से जोड़ना
जब ऑडियो फ़ोनीम्स में बँट जाता है, तो सिस्टम को हर फ़ोनीम को उसके मेल खाते मुँह के आकार में बदलना होता है। एनिमेशन में इन आकारों को विज़ीम्स कहा जाता है। हर भाषा में कुछ मूल विज़ीम्स साझा होते हैं, भले ही उसके फ़ोनीम्स का भंडार एक-दूसरी भाषा से काफ़ी अलग हो।
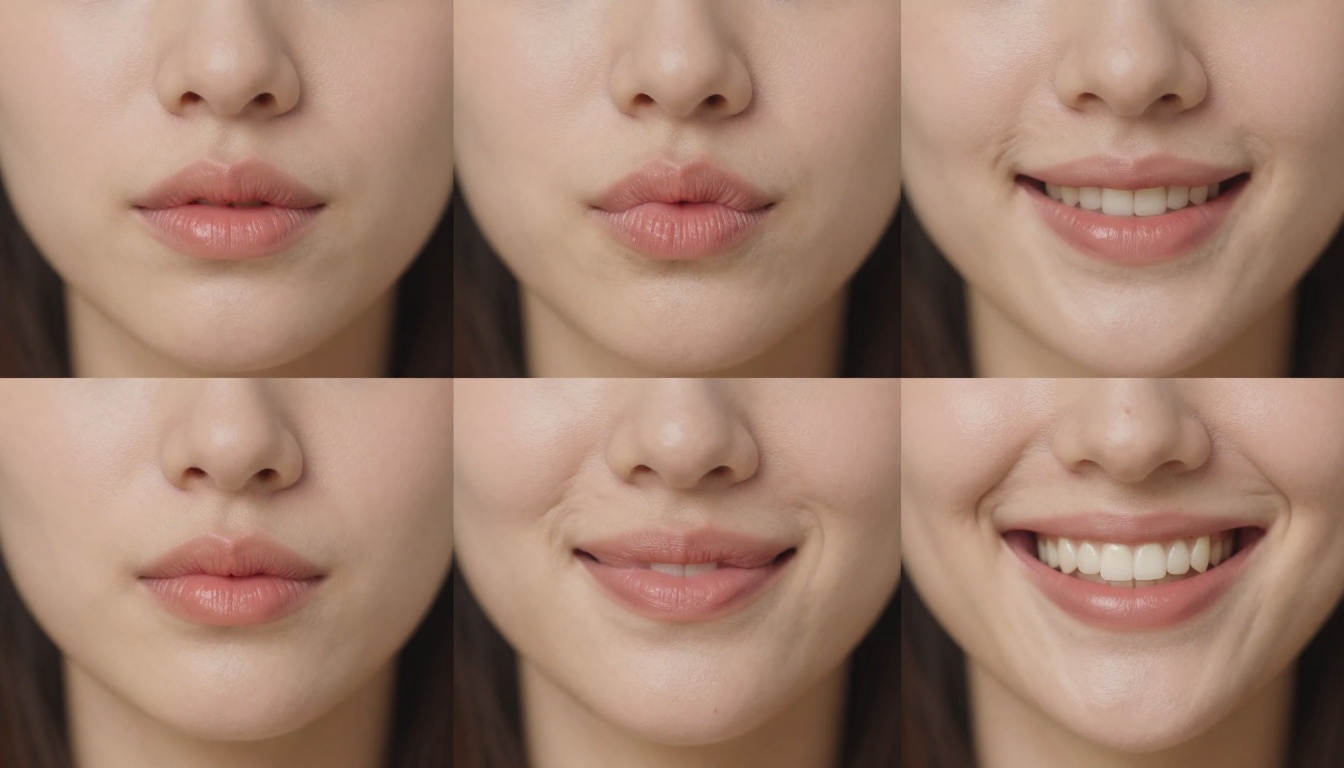
फ़ोनीम से विज़ीम तक का मैपिंग एक-से-एक नहीं है। कई फ़ोनीम्स अक्सर एक ही दिखने वाला मुँह का आकार साझा करते हैं। /p/, /b/ और /m/ होठों पर लगभग एक जैसे दिखते हैं, भले ही ध्वनिक रूप से वे अलग हों। यही वजह है कि इंसानों के लिए होंठ पढ़ना कठिन है, लेकिन AI सिस्टमों के लिए यह संभव है, क्योंकि वे सहायक संकेतों के तौर पर जबड़े की सूक्ष्म हरकत, ठोड़ी के झुकाव और गाल के तनाव को भी पढ़ते हैं।
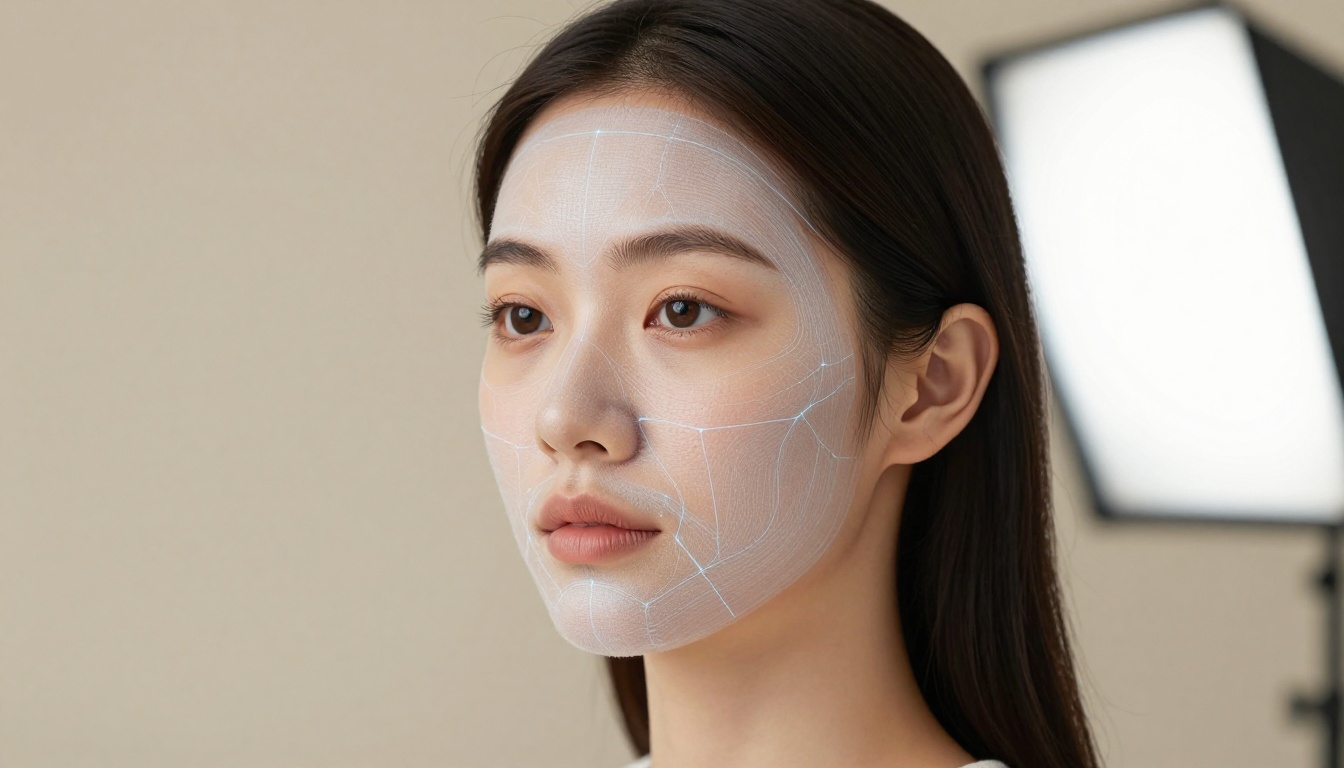
AI चेहरे पर 68 से 478 संदर्भ बिंदु पहचानने के लिए फ़ेशियल लैंडमार्क डिटेक्शन का इस्तेमाल करता है, जिनमें होंठों के ठीक कोने, ऊपरी होंठ का कपिड्स बो, ठोड़ी की नोक और जबड़े का जोड़ शामिल हैं। ये लैंडमार्क वह ढाँचा बनते हैं जिसे मॉडल हर फ़्रेम में हेरफेर करके हर विज़ीम तैयार करता है। फिर मुँह के आसपास के हिस्से को लक्ष्य आकार से मेल खाने के लिए टेक्सचर-वार्प किया जाता है, और नतीजा मूल वीडियो में वापस मिलाया जाता है, जिसमें त्वचा की बनावट, रोशनी की निरंतरता और होंठों के किनारों की स्वाभाविक नरमी का ध्यान रखा जाता है।
समय का आयाम स्थानिक आयाम जितना ही अहम है। किसी फ़ोनीम का सिर्फ़ मुँह का आकार नहीं होता। उसका एक ऑनसेट समय, एक पीक और एक रिलीज़ होता है। AI हर विज़ीम को ऑडियो में इन टेम्पोरल घटनाओं के साथ फ़्रेम-स्तर की सटीकता से समय देता है, आम तौर पर मानक वीडियो फ़ॉर्मेट से मेल खाने के लिए 25 या 30 फ़्रेम प्रति सेकंड पर काम करते हुए।
इसके पीछे के न्यूरल नेटवर्क
लिप सिंक AI कोई रूल-आधारित सिस्टम नहीं है, जिसमें किसी ने लिखा हो कि "जब ऑडियो में /m/ हो, तो होंठ बंद करो।" इसका व्यवहार पूरी तरह असली इंसानी बोली और वीडियो के विशाल डेटासेट पर प्रशिक्षण से उभरता है।
प्रशिक्षण डेटा सटीकता कैसे तय करता है
एक अच्छा लिप सिंक मॉडल सटीक रूप से सिंक किए गए ऑडियो वाले हज़ारों घंटे के टॉकिंग-हेड वीडियो पर प्रशिक्षित होता है, जिनमें कई भाषाएँ, लहजे, उम्र और रोशनी की स्थितियाँ शामिल होती हैं। प्रशिक्षण के दौरान मॉडल ऑडियो फ़ीचर्स और चेहरे की हरकत के बीच सांख्यिकीय संबंध सीखता है, और एक आंतरिक प्रतिनिधित्व बनाता है जो हाथ से बनाए गए नियमों के सेट की पकड़ से कहीं आगे तक सामान्यीकृत होता है।
इसी वजह से आधुनिक मॉडल नए स्पीकर्स पर इतनी अच्छी तरह सामान्यीकरण करते हैं। वे हर स्पीकर के लिए मुँह के आकारों का तय सेट याद नहीं करते। वे एक निरंतर फ़ंक्शन बनाते हैं, जो ज्ञात अवस्थाओं के बीच इंटरपोलेट कर सके, कोआर्टिक्युलेशन को सँभाल सके जहाँ एक फ़ोनीम अगले में घुल जाता है, और स्वाभाविक बोली की टेम्पोरल गतिशीलता का सम्मान कर सके, जिसमें विराम, ज़ोर और साँस के पैटर्न शामिल हैं।
| फ़ीचर | रूल-आधारित सिस्टम | न्यूरल नेटवर्क मॉडल |
|---|
| भाषा सपोर्ट | केवल तय सेट | बहु-भाषा |
| लहजे की हैंडलिंग | कमज़ोर | मज़बूत |
| कोआर्टिक्युलेशन | नज़रअंदाज़ | सटीक रूप से मॉडल किया गया |
| नए स्पीकर के अनुसार ढलना | कोई नहीं | तुरंत |
| विज़ुअल यथार्थता | कम | अधिक |
| फाइन-ट्यूनिंग संभव | नहीं | हाँ |
प्रशिक्षण डेटा की विविधता औसत मॉडलों को प्रोडक्शन-गुणवत्ता वाले मॉडलों से अलग करने वाला अकेला सबसे बड़ा कारक है। मुख्य रूप से अंग्रेज़ी न्यूज़ एंकरों पर प्रशिक्षित मॉडल तेज़, बोलचाल वाली बोली या ऐसी भाषाओं के साथ संघर्ष करेगा जिनके फ़ोनीम्स उसके प्रशिक्षण वितरण से बाहर हैं। आज के सबसे अच्छे मॉडल दर्जनों भाषाओं में सैकड़ों स्पीकर्स का डेटा इस्तेमाल करते हैं, ताकि सचमुच व्यापक कवरेज बन सके।
Wav2Lip और उसके बाद आए मॉडल
जिस आर्किटेक्चर ने AI लिप सिंक को पहचान दिलाई, वह Wav2Lip था, जो 2020 में प्रकाशित हुआ। इसने GAN-आधारित तरीका इस्तेमाल किया, जिसमें एक समर्पित लिप-सिंक डिस्क्रिमिनेटर था। यह डिस्क्रिमिनेटर केवल विज़ुअल गुणवत्ता नहीं, बल्कि फ़्रेम-दर-फ़्रेम सिंक की सटीकता भी परखता था। डिस्क्रिमिनेटर को एक विशाल ऑडियो-विज़ुअल डेटासेट पर पहले से प्रशिक्षित किया गया था, ताकि यह पहचान सके कि होंठों की हरकत किसी दिए गए ऑडियो सेगमेंट से मेल खाती है या नहीं।
Wav2Lip ने प्रभावशाली नतीजे दिए, लेकिन उसकी एक अच्छी तरह दस्तावेज़ित कमज़ोरी थी: वह कभी-कभी मुँह वाले हिस्से को थोड़ा नरम कर देता था, सिंक की सटीकता के बदले तीखी बनावट गँवा देता था। तब से इस क्षेत्र में काफ़ी आगे बढ़ा है।
आज के प्रोडक्शन मॉडल डिफ़्यूज़न-आधारित आर्किटेक्चर, 3D मॉर्फ़ेबल फ़ेस मॉडल्स (3DMMs), और ऑडियो-कंडीशन्ड लेटेंट डिफ़्यूज़न इस्तेमाल करते हैं, ताकि ऐसे नतीजे मिलें जो टेम्पोरल रूप से सटीक और फ़ोटोरियलिस्टिक दोनों हों। सीधे पिक्सेल वार्प करने के बजाय कुछ मॉडल मुँह वाले हिस्से को शुरू से फिर से बनाते हैं, जिसे ऑडियो सिग्नल दिशा देता है और मूल चेहरे की ज्यामिति सीमित करती है। यह तरीका त्वचा की बनावट बचाता है और ब्लर वाले आर्टिफ़ैक्ट को खत्म करता है। कई अग्रणी मॉडल अब 30fps पर रियल टाइम में चलते हैं, जिससे लाइव स्ट्रीमिंग और वीडियो कॉन्फ़्रेंसिंग के अनुप्रयोगों के द्वार खुलते हैं।
असल दुनिया में पहले से चल रहे उपयोग
लिप सिंक AI सिर्फ़ सैद्धांतिक नहीं है। यह अभी कई उद्योगों में सक्रिय रूप से प्रोडक्शन में इस्तेमाल हो रहा है।
किसी भी भाषा में वीडियो डबिंग
सबसे अहम व्यावसायिक उपयोग बहुभाषी वीडियो डबिंग है। पहले किसी फ़िल्म या डॉक्यूमेंट्री को डब करने के लिए वॉइस एक्टर, रिकॉर्डिंग स्टूडियो और समय मिलाने के लिए हफ़्तों की पोस्ट-प्रोडक्शन मेहनत चाहिए थी। इतनी मेहनत के बाद भी होंठों की हरकत अक्सर गलत लगती थी, क्योंकि नया संवाद मूल से अलग लंबाई का होता था।
AI लिप सिंक इसे पूरी तरह बदल देता है। अंग्रेज़ी में नैरेट की गई डॉक्यूमेंट्री को पुर्तगाली या हिंदी में डब किया जा सकता है, जिसमें होंठों की हरकत नए ऑडियो ट्रैक से मेल खाने के लिए फिर से बनाई जाती है। वीडियो में बोलने वाले का चेहरा अनुवादित बोली के साथ स्वाभाविक ढंग से हिलता है, और दोबारा शूटिंग की ज़रूरत नहीं होती।
💡 वास्तविक असर: स्ट्रीमिंग प्लेटफ़ॉर्म अब AI डबिंग से एक साथ दर्जनों भाषाओं में कंटेंट रिलीज़ कर रहे हैं, जिसमें सभी भाषाओं में लिप सिंक की सटीकता सामान्य व्यूइंग स्थितियों में टिकती है।
वर्चुअल प्रस्तुतकर्ता और AI अवतार
कॉर्पोरेट ट्रेनिंग, ई-लर्निंग प्लेटफ़ॉर्म और मार्केटिंग वीडियो तेज़ी से AI-एनिमेटेड प्रस्तुतकर्ताओं का इस्तेमाल कर रहे हैं, जो हर संशोधन के लिए किसी इंसान को कैमरे के सामने खड़ा किए बिना स्क्रिप्ट वाला कंटेंट पेश करते हैं। प्रस्तुतकर्ता या तो फ़ोटोरियलिस्टिक सिंथेटिक अवतार होता है, या किसी असली व्यक्ति की रिकॉर्ड की गई छवि, जिसे पूरी तरह ऑडियो इनपुट से चलाया जाता है।
यह उपयोग सटीक फ़ोनीम-टू-विज़ीम मैपिंग से बहुत फ़ायदा उठाता है। ई-लर्निंग वीडियो में अगर प्रस्तुतकर्ता का मुँह नरेशन से मेल न खाए, तो वह तुरंत खटकता है। इससे दर्शक का ध्यान टूटता है और कंटेंट की विश्वसनीयता कमज़ोर होती है। जब सिंक कसा हुआ हो, तो मानसिक बोझ गायब हो जाता है और दर्शक दी जा रही जानकारी पर केंद्रित रहता है।
बिना रीटेक के कंटेंट निर्माण
व्यक्तिगत क्रिएटर्स के लिए सबसे तुरंत व्यावहारिक उपयोग है रिकॉर्ड किए गए कंटेंट में ऑडियो-वीडियो सिंक की गलतियों को ठीक करना। अगर क्रिएटर का ऑडियो ट्रैक रिकॉर्डिंग के दौरान थोड़ा खिसक गया, या वे बेहतर माइक्रोफ़ोन टेक के साथ वॉइसओवर दोबारा रिकॉर्ड करना चाहते हैं, तो AI लिप सिंक बिना दोबारा शूट किए वीडियो को नए ऑडियो के साथ फिर से संरेखित कर सकता है।
यह एक ही वीडियो के बहुभाषी संस्करण बनाने में भी मदद करता है। एक YouTube चैनल एक ही कंटेंट को अंग्रेज़ी, स्पैनिश और फ़्रेंच में रिलीज़ कर सकता है, जिसमें प्रस्तुतकर्ता का चेहरा हर ऑडियो ट्रैक से सिंक होता है, और यह सब एक ही मूल रिकॉर्डिंग सत्र से। इससे स्थानीयकृत कंटेंट का प्रोडक्शन समय दिनों से घटकर मिनटों में आ जाता है।
आज यह कितना सटीक है?
AI लिप सिंक की सटीकता दो अलग आयामों में बँटी है: टेम्पोरल सटीकता (क्या मुँह बिल्कुल सही पल पर हिलता है?) और विज़ुअल फ़िडेलिटी (क्या मुँह का आकार स्वाभाविक दिखता है और उस विशेष फ़ोनीम से मेल खाता है जो बोला जा रहा है?)।
जब नतीजे परफ़ेक्ट होते हैं
आज के मॉडल इन परिस्थितियों में सबसे अच्छा प्रदर्शन करते हैं:
- कैमरे की ओर लगभग 30 डिग्री के दायरे में सीधा या लगभग सीधा सिर का रुख
- एक स्पीकर, फ़्रेम में कोई और चेहरा नहीं
- मानक सैंपल रेट पर रिकॉर्ड किया गया साफ़, शोर-रहित ऑडियो
- स्थिर, एक-सी रोशनी जिसमें क्लिप के दौरान तेज़ बदलाव न हों
- सिर की अपेक्षाकृत स्थिर स्थिति, बिना तेज़ पार्श्व (लेटरल) हरकत के
इन परिस्थितियों में सबसे उन्नत मॉडल सामान्य प्लेबैक स्पीड पर असली फ़ुटेज से लगभग अलग न पहचाने जाने योग्य नतीजे देते हैं। सिंक फ़्रेम-स्तर पर सटीक होता है, विज़ीम सही होते हैं, और मुँह वाले हिस्से के आसपास की त्वचा की बनावट बिना आर्टिफ़ैक्ट के बची रहती है।
जहाँ अब भी दिक्कत होती है
कोई भी मॉडल हर परिस्थिति को पूरी तरह नहीं सँभाल पाता। आम समस्या वाले मामले इस प्रकार हैं:
- चरम प्रोफ़ाइल व्यू: जब सिर 45 डिग्री से ज़्यादा घुमा हो, तो मॉडल के पास दिखने वाले लैंडमार्क कम होते हैं और रिकॉन्स्ट्रक्शन कम भरोसेमंद हो जाता है।
- फ़्रेम में कई स्पीकर: ज़्यादातर मॉडल सिंगल-फ़ेस परिदृश्यों पर प्रशिक्षित होते हैं। एक साथ बोलने वाले दो लोग अक्सर अट्रिब्यूशन की गलतियाँ पैदा करते हैं।
- बहुत तेज़ बोली: लगभग 300 शब्द प्रति मिनट से ऊपर की गति पर टेम्पोरल सटीकता थोड़ी घट जाती है।
- दुर्लभ फ़ोनीम्स वाली भाषाएँ: प्रशिक्षण डेटा का कवरेज ही उन फ़ोनीम्स पर प्रदर्शन तय करता है जो डेटासेट में कम आते हैं।
- कम रेज़ोल्यूशन वाला सोर्स वीडियो: मॉडल के पास ऐसी टेक्सचर डिटेल बनाने का कोई तरीका नहीं है जो मूल पिक्सेल में थी ही नहीं।
💡 प्रोडक्शन टिप: सोर्स वीडियो ऐसे रिकॉर्ड करें जिसमें सब्जेक्ट सीधे कैमरे की ओर बोल रहा हो और पृष्ठभूमि साफ़ और समान रोशनी वाली हो। चुनौतीपूर्ण परिस्थितियों में शूट किए गए फ़ुटेज की तुलना में मॉडल काफ़ी बेहतर नतीजे देगा।
PicassoIA पर लिप सिंक AI कैसे इस्तेमाल करें
PicassoIA प्लेटफ़ॉर्म पर ही लिप सिंक मॉडल्स का पूरा संग्रह देता है। कोई लोकल सेटअप नहीं, कोई API क्रेडेंशियल्स संभालने नहीं, कोई GPU नहीं चाहिए। आप अपना वीडियो अपलोड करते हैं, अपना ऑडियो ट्रैक देते हैं, और बाकी काम मॉडल सँभाल लेता है।
चरण 1: अपना मॉडल चुनें
PicassoIA कई लिप सिंक मॉडल देता है, जिनकी अलग-अलग ताकतें हैं:
- Lipsync 2 Pro by Sync: उपलब्ध सबसे उच्च-फ़िडेलिटी विकल्प। यह विस्तृत चेहरों और ऑडियो शैलियों की व्यापक रेंज पर उत्कृष्ट विज़ुअल गुणवत्ता के साथ फ़्रेम-सटीक सिंक देता है। पेशेवर आउटपुट के लिए यहीं से शुरू करें।
- Lipsync 2 by Sync: तेज़ नतीजों के लिए एक तेज़ वैरिएंट, जहाँ अधिकतम गुणवत्ता उतनी ज़रूरी नहीं है।
- React 1 by Sync: किसी भी वीडियो में यथार्थवादी लिप सिंक जोड़ता है, जिसका ध्यान स्वाभाविक दिखने वाले आउटपुट और विविध फ़ुटेज पर अच्छे प्रदर्शन पर है।
- Kling Lip Sync by Kwaivgi: विविध शूटिंग परिस्थितियों पर मज़बूत, जिसमें ज़्यादा चुनौतीपूर्ण माहौल में रिकॉर्ड किया गया फ़ुटेज भी शामिल है।
- PixVerse Lipsync: गति के लिए अनुकूलित। त्वरित प्रीव्यू और तेज़ इटरेशन के लिए अच्छा।
- Omni Human by ByteDance: एक स्थिर फ़ोटो और एक ऑडियो ट्रैक से पूरे बोलते वीडियो में एनिमेट करता है। किसी सोर्स वीडियो की ज़रूरत नहीं।
- Fabric 1.0 by Veed: ऑडियो-संचालित एनिमेशन के साथ किसी भी फ़ोटो को बोलने योग्य बनाता है, जो सोशल मीडिया फ़ॉर्मेट के लिए अनुकूलित है।
चरण 2: अपना वीडियो अपलोड करें
मॉडल पेज पर जाएँ और अपनी सोर्स वीडियो क्लिप अपलोड करें। बेहतरीन नतीजों के लिए:
- फ़ॉर्मेट: MP4 या MOV बेहतर
- रेज़ोल्यूशन: कम से कम 720p, 1080p पर नतीजे उल्लेखनीय रूप से बेहतर
- सब्जेक्ट: एक साफ़ दिखने वाला चेहरा, सामने की ओर और अच्छी रोशनी में
- लंबाई: ज़्यादातर मॉडल कुछ सेकंड से लेकर कई मिनट तक की क्लिप सँभाल लेते हैं
भारी कंप्रेस्ड फ़ाइलें, मोशन ब्लर वाले फ़ुटेज, या कटों के बीच तेज़ रोशनी बदलाव वाली क्लिप से बचें।
चरण 3: अपना ऑडियो जोड़ें
वह ऑडियो ट्रैक अपलोड करें जिसे आप वीडियो से सिंक करना चाहते हैं। यह हो सकता है:
- किसी वॉइस एक्टर द्वारा रिकॉर्ड किया गया डब्ड वॉइसओवर
- टेक्स्ट-टू-स्पीच सिस्टम से बनी AI आवाज़। PicassoIA टेक्स्ट-टू-स्पीच मॉडल भी देता है, जो लिप सिंक वर्कफ़्लो के साथ स्वाभाविक रूप से मेल खाते हैं।
- बेहतर माइक्रोफ़ोन गुणवत्ता के साथ दोबारा रिकॉर्ड किया गया आपका अपना नैरेशन
- WAV, MP3 या M4A फ़ॉर्मेट में कोई भी स्पीच ऑडियो
💡 ऑडियो में केवल स्पीच होनी चाहिए। ऑडियो ट्रैक में मिले बैकग्राउंड म्यूज़िक या परिवेशी शोर से सिंक की सटीकता काफ़ी घट जाती है। जहाँ संभव हो, साफ़ और अलग की गई आवाज़ की रिकॉर्डिंग इस्तेमाल करें।
चरण 4: जनरेट करें और डाउनलोड करें
जनरेट बटन दबाएँ। प्रोसेसिंग का समय क्लिप की लंबाई और चुने गए मॉडल पर निर्भर करता है, कुछ सेकंड से लेकर लंबे कंटेंट के लिए कुछ मिनट तक। आउटपुट वीडियो प्लेटफ़ॉर्म से सीधे डाउनलोड के लिए उपलब्ध है, जिसमें होंठों की हरकत आपके ऑडियो ट्रैक से पूरी तरह सिंक्रनाइज़ होती है और मुँह वाले हिस्से के बाहर मूल वीडियो की गुणवत्ता बनी रहती है।
एक अच्छे लिप सिंक नतीजे को क्या बनाता है
भारी काम मॉडल करता है, लेकिन आपके इनपुट तय करते हैं कि गुणवत्ता की ऊपरी सीमा कहाँ तक जाएगी।
ऑडियो की गुणवत्ता ही सब कुछ है
यह बात बार-बार दोहराने लायक है, क्योंकि यही सबसे अक्सर नज़रअंदाज़ होने वाला कारक है। लिप सिंक मॉडल फ़्रेम-दर-फ़्रेम मुँह की स्थिति तय करने के लिए ऑडियो फ़ीचर्स पढ़ता है। अगर ऑडियो शोर वाला है, कम बिटरेट पर कंप्रेस्ड है, या एक साथ दो आवाज़ें रखता है, तो फ़ीचर एक्सट्रैक्शन अविश्वसनीय हो जाता है और विज़ुअल आउटपुट उसी अनुपात में खराब होता है।
ऑडियो इनपुट के लिए सर्वोत्तम अभ्यास:
- बिना बैकग्राउंड शोर वाले शांत कमरे में रिकॉर्ड करें
- लैपटॉप या फ़ोन के अंतर्निहित माइक की बजाय समर्पित माइक्रोफ़ोन इस्तेमाल करें
- WAV या FLAC फ़ॉर्मेट में 44.1kHz पर एक्सपोर्ट करें
- अपलोड से पहले ऑडियो लेवल नॉर्मलाइज़ करें, स्पीच के लिए लगभग -14 LUFS का लक्ष्य रखें
- अगर रिकॉर्डिंग का माहौल आदर्श नहीं था, तो नॉइज़ रिडक्शन पास चलाएँ
वीडियो इनपुट की ज़रूरतें
वीडियो इनपुट वह विज़ुअल आधार बनाता है जिस पर मॉडल काम करता है। ऐसी डिटेल वापस लाने का कोई तरीका नहीं है जो मूल पिक्सेल में नहीं थी।
वीडियो इनपुट के लिए सर्वोत्तम अभ्यास:
- कम से कम 1080p पर शूट करें, और अगर आपका वर्कफ़्लो सपोर्ट करता है तो 4K
- एक-सी, समान रोशनी इस्तेमाल करें, जिसमें मुँह वाले क्षेत्र पर कठोर परछाइयाँ न पड़ें
- पूरी क्लिप में सब्जेक्ट को अपेक्षाकृत स्थिर और फ़्रेम के बीच में रखें
- अपलोड से पहले मूल फ़ुटेज पर भारी पोस्ट-प्रोसेसिंग या फ़िल्टर लगाने से बचें
- सुनिश्चित करें कि चेहरा साफ़ दिखे और हाथों, बालों या वस्तुओं से आंशिक रूप से ढका न हो
अच्छी तरह तैयार इनपुट और जल्दबाज़ी में रिकॉर्ड की गई क्लिप के बीच अंतिम आउटपुट में गुणवत्ता का फ़र्क काफ़ी बड़ा होता है। रिकॉर्डिंग से पहले कुछ मिनट की तैयारी का फ़ायदा साफ़ मिलता है।
AI लिप सिंक के साथ बनाना शुरू करें
लिप सिंक AI एक शोध की जिज्ञासा से निकलकर सचमुच व्यावहारिक प्रोडक्शन टूल बन गया है। चाहे आप वीडियो कंटेंट को कई भाषाओं में स्थानीयकृत कर रहे हों, ट्रेनिंग सामग्री के लिए AI-संचालित प्रस्तुतकर्ता बना रहे हों, या कोई ऐसा वॉइसओवर ठीक कर रहे हों जो सही नहीं बैठा, इसे करने के औज़ार अभी बिना किसी तकनीकी सेटअप के उपलब्ध हैं।
PicassoIA का लिप सिंक संग्रह आज के मॉडलों की पूरी रेंज एक ही जगह रखता है। इसमें Omni Human by ByteDance है, जो एक स्थिर फ़ोटो को बोलते वीडियो में बदलता है, और Lipsync 2 Pro by Sync है, जो किसी भी मौजूदा फ़ुटेज पर पेशेवर-स्तर का ऑडियो-से-वीडियो सिंक्रनाइज़ेशन देता है।
आपने जो रिकॉर्ड किया और जो बनाना चाहते थे, उनके बीच का फ़ासला अब काफ़ी छोटा हो गया है। एक क्लिप अपलोड करें, अपना ऑडियो जोड़ें, और देखें कि ये मॉडल वास्तव में क्या कर सकते हैं।


