Você envia um clipe com o rosto de alguém. Depois, insere uma faixa de áudio completamente diferente, talvez uma narração dublada em espanhol, talvez uma voz gerada por IA em inglês. Em poucos segundos, o rosto no vídeo move a boca em perfeita sincronia com o novo áudio, combinando cada sílaba com a posição certa dos lábios. Parece real. Não é preciso tela verde, estúdio nem refilmagens.
É isso que a sincronização labial por IA faz. E a ciência por trás disso é genuinamente fascinante.
O que a IA de sincronização labial realmente faz
A maioria das pessoas acha que a IA de sincronização labial "adivinha" onde a boca deveria estar em cada momento. A realidade é bem mais precisa. O sistema não adivinha. Ele lê. Cada trecho de áudio é uma fonte de dados estruturada. A IA decompõe esse sinal em seus menores componentes mensuráveis, compara cada componente com o que um rosto humano faz fisicamente ao produzir esses sons e, então, deforma a região da boca quadro a quadro para combinar com eles. O resultado parece natural porque se baseia em ciência real da fala, e não em aproximação.
Decompondo o sinal de áudio
Quando você alimenta um modelo de sincronização labial com uma faixa de áudio, a primeira coisa que ele faz é passar o áudio por um pipeline de processamento de fala. Esse pipeline converte a forma de onda bruta em uma sequência de fonemas, as menores unidades sonoras de qualquer idioma falado.
Pense nos fonemas como os blocos atômicos da fala. A palavra "hello" tem cinco fonemas: /h/, /ɛ/, /l/, /l/, /oʊ/. Cada fonema tem duração, envelope de energia e padrão de frequência previsíveis. Um modelo bem treinado consegue extrair todas essas características de um arquivo de áudio limpo em milissegundos.
A camada de processamento de áudio normalmente usa a representação de coeficientes cepstrais de frequência Mel (MFCC), que captura o formato espectral da fala de um modo que espelha como a audição humana funciona de fato. Alguns modelos mais novos substituem completamente os MFCCs por embeddings de áudio aprendidos a partir de codificadores de fala baseados em transformers, o que oferece melhor desempenho em diferentes sotaques, idiomas e condições de gravação.
💡 Por que isso importa: a qualidade da análise de áudio controla diretamente a precisão da sincronização labial. Áudio limpo, com um único falante e 44,1 kHz, produz resultados visivelmente melhores do que gravações comprimidas ou com ruído.
Fonemas diferentes carregam impressões acústicas diferentes no domínio da frequência. Uma fricativa sonora como /v/ tem um formato espectral completamente diferente de uma nasal como /m/ ou de uma oclusiva como /p/. O modelo aprende a reconhecer essas assinaturas de forma confiável, mesmo quando elas se misturam na fala natural e fluida. A coarticulação, em que um fonema passa suavemente para o seguinte sem uma pausa nítida, é um dos problemas mais difíceis do processamento de fala. As arquiteturas modernas lidam com isso modelando o áudio em janelas temporais sobrepostas, em vez de analisar os fonemas isoladamente.
Associando som a formatos de boca
Depois que o áudio é dividido em fonemas, o sistema precisa traduzir cada fonema em um formato correspondente de boca. Na animação, esses formatos são chamados de visemas. Todos os idiomas compartilham um conjunto básico de visemas, mesmo que o inventário de fonemas varie muito de um idioma para outro.
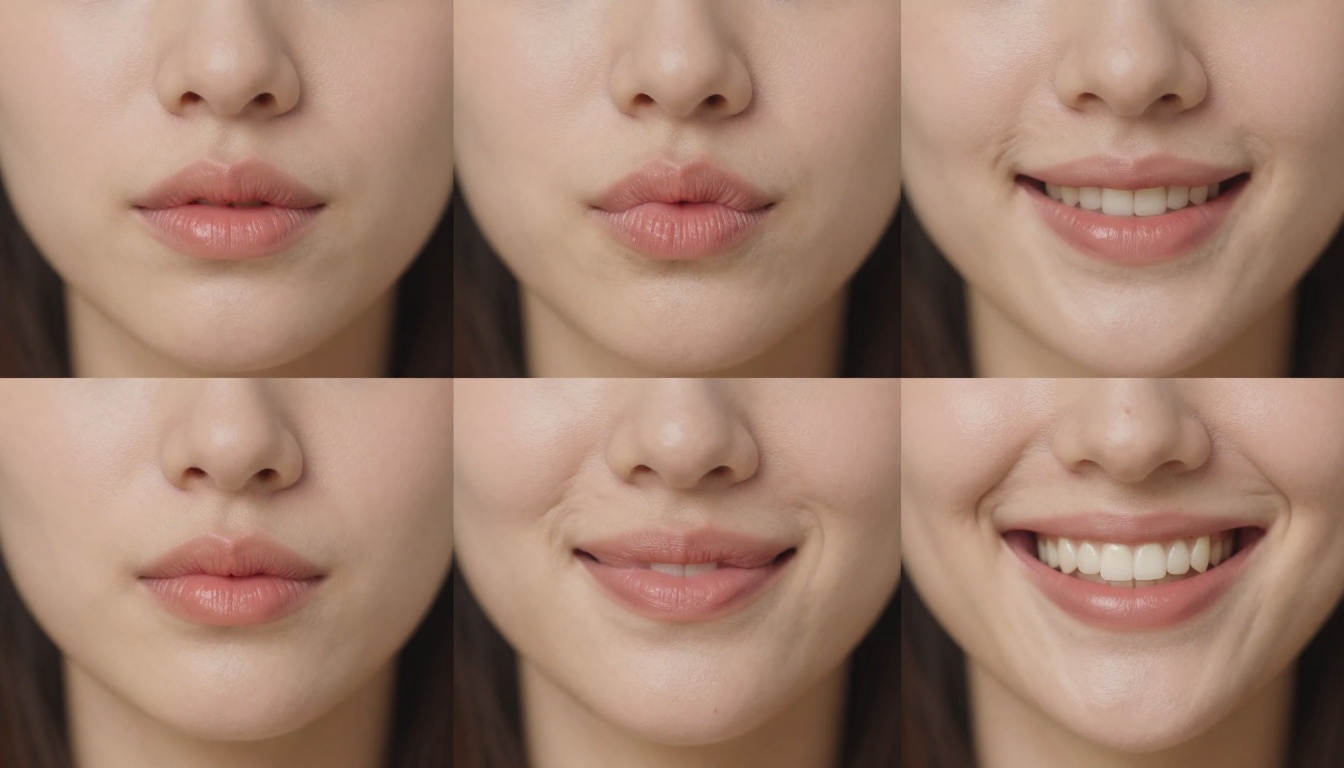
O mapeamento de fonema para visema não é um para um. Vários fonemas costumam compartilhar o mesmo formato visível da boca. Os sons /p/, /b/ e /m/ parecem quase idênticos nos lábios, mesmo sendo acusticamente distintos. É exatamente por isso que a leitura labial é difícil para humanos, mas administrável para sistemas de IA que também leem movimentos sutis da mandíbula, a queda do queixo e a tensão das bochechas como pistas complementares.
A IA usa detecção de marcos faciais para identificar de 68 a 478 pontos de referência no rosto, incluindo os cantos exatos dos lábios, o arco de cupido, a ponta do queixo e a articulação da mandíbula. Esses marcos se tornam o esqueleto que o modelo manipula quadro a quadro para produzir cada visema. Em seguida, a região ao redor da boca é deformada na textura para combinar com o formato-alvo, e o resultado é mesclado de volta ao vídeo original, com atenção à preservação da textura da pele, à continuidade da iluminação e à suavidade natural das bordas dos lábios.
A dimensão temporal é tão importante quanto a espacial. Um fonema não tem apenas um formato de boca. Ele tem um início, um pico e um fim. A IA ajusta cada visema a esses eventos temporais do áudio com precisão de quadro, normalmente operando em 25 ou 30 quadros por segundo para acompanhar os formatos de vídeo padrão.
As redes neurais por trás disso
A IA de sincronização labial não é um sistema baseado em regras, em que alguém escreveu "quando o áudio contiver /m/, feche os lábios". O comportamento surge inteiramente do treinamento com enormes conjuntos de dados de fala e vídeo humanos reais.
Como os dados de treinamento moldam a precisão
Um bom modelo de sincronização labial é treinado com milhares de horas de vídeos de pessoas falando, com áudio precisamente sincronizado, abrangendo vários idiomas, sotaques, idades e condições de iluminação. Durante o treinamento, o modelo aprende a relação estatística entre as características do áudio e o movimento facial, construindo uma representação interna que generaliza muito além do que qualquer conjunto de regras escritas à mão poderia capturar.
É por isso que os modelos modernos generalizam tão bem para novos falantes. Eles não memorizam um conjunto fixo de formatos de boca por falante. Eles constroem uma função contínua que consegue interpolar entre estados conhecidos, lidar com a coarticulação em que um fonema se mistura ao seguinte e respeitar a dinâmica temporal da fala natural, incluindo pausas, ênfases e padrões de respiração.
| Característica | Sistemas baseados em regras | Modelos de redes neurais |
|---|
| Suporte a idiomas | Apenas um conjunto fixo | Multi-idioma |
| Tratamento de sotaques | Fraco | Forte |
| Coarticulação | Ignorada | Modelada com precisão |
| Adaptação a novo falante | Nenhuma | Imediata |
| Realismo visual | Baixo | Alto |
| Fine-tuning possível | Não | Sim |
A diversidade dos dados de treinamento é o fator único mais importante que separa modelos medianos de modelos de qualidade para produção. Um modelo treinado principalmente com apresentadores de notícias em inglês terá dificuldade com fala rápida e coloquial, ou com idiomas que usam fonemas fora da sua distribuição de treinamento. Os melhores modelos atuais usam dados de centenas de falantes em dezenas de idiomas para construir uma cobertura genuinamente ampla.
Wav2Lip e o que veio depois
A arquitetura que colocou a sincronização labial por IA no mapa foi o Wav2Lip, publicado em 2020. Ele usava uma abordagem baseada em GAN, com um discriminador dedicado de sincronização labial que avaliava não apenas a qualidade visual, mas também a precisão de sincronia quadro a quadro. O discriminador foi pré-treinado em um enorme conjunto de dados audiovisuais para reconhecer se um movimento labial correspondia a um determinado trecho de áudio.
O Wav2Lip produzia resultados impressionantes, mas tinha uma fraqueza bem documentada: às vezes suavizava um pouco a região da boca, sacrificando a textura nítida em troca da precisão de sincronia. A área avançou muito desde então.
Os modelos de produção atuais usam arquiteturas de difusão, modelos faciais 3D morfáveis (3DMMs) e difusão latente condicionada por áudio para produzir resultados que são ao mesmo tempo temporalmente precisos e fotorrealistas. Em vez de deformar pixels diretamente, alguns modelos reconstroem a região da boca do zero, guiados pelo sinal de áudio e limitados pela geometria do rosto original. Essa abordagem preserva a textura da pele e elimina o artefato de borramento. Vários modelos líderes já funcionam em tempo real a 30 fps, o que abre espaço para transmissões ao vivo e aplicações de videoconferência.
Usos reais que já existem
A IA de sincronização labial não é teórica. Ela está em produção ativa em vários setores agora mesmo.
Dublagem de vídeo em qualquer idioma
A aplicação com maior impacto comercial é a dublagem de vídeo multilíngue. Historicamente, dublar um filme ou documentário exigia atores de voz, um estúdio de gravação e semanas de trabalho de pós-produção para ajustar o tempo. Mesmo com todo esse esforço, os movimentos labiais muitas vezes pareciam errados, porque o novo diálogo tinha duração diferente do original.
A sincronização labial por IA muda isso por completo. Um documentário narrado em inglês pode ser dublado para o português ou para o hindi, com os movimentos dos lábios regenerados para combinar com a nova faixa de áudio. O rosto do falante no vídeo se move naturalmente com a fala traduzida, sem nenhuma refilmagem.
💡 Impacto real: as plataformas de streaming agora usam dublagem por IA para lançar conteúdo em dezenas de idiomas simultaneamente, com precisão de sincronização labial que se sustenta em condições normais de exibição em todos eles.
Apresentadores virtuais e avatares de IA
Treinamentos corporativos, plataformas de ensino a distância e vídeos de marketing usam cada vez mais apresentadores animados por IA que entregam conteúdo roteirizado sem exigir que uma pessoa fique diante da câmera a cada revisão. O apresentador é um avatar sintético fotorrealista ou a imagem gravada de uma pessoa real, conduzido inteiramente por uma entrada de áudio.
Este caso de uso se beneficia enormemente do mapeamento preciso de fonema para visema. Um vídeo de ensino a distância em que a boca do apresentador não combina com a narração é imediatamente incômodo. Ele quebra o foco do espectador e enfraquece a credibilidade do conteúdo. Quando a sincronia é precisa, a carga cognitiva desaparece e o espectador continua concentrado na informação transmitida.
Criação de conteúdo sem refilmagens
Para criadores individuais, a aplicação mais imediatamente prática é corrigir erros de sincronia entre áudio e vídeo em conteúdo já gravado. Se a faixa de áudio de um criador saiu um pouco do ritmo durante a gravação, ou se ele quer regravar a narração com uma captação melhor de microfone, a sincronização labial por IA pode realinhar o vídeo ao novo áudio sem nenhuma refilmagem.
Ela também permite produzir versões multilíngues do mesmo vídeo. Um canal no YouTube pode lançar o mesmo conteúdo em inglês, espanhol e francês, com o rosto do apresentador sincronizado a cada faixa de áudio, tudo a partir de uma única sessão de gravação original. Isso reduz o tempo de produção de conteúdo localizado de dias para minutos.
Qual é a precisão atual?
A precisão na sincronização labial por IA se divide em duas dimensões separadas: precisão temporal (a boca se move exatamente no momento certo?) e fidelidade visual (o formato da boca parece natural e corresponde ao fonema específico sendo produzido?).
Quando os resultados são impecáveis
Os modelos atuais têm melhor desempenho nestas condições:
- Cabeça de frente ou quase de frente, a até cerca de 30 graus de estar de frente para a câmera
- Um único falante, sem outros rostos no mesmo quadro
- Áudio limpo, sem ruído, gravado em uma taxa de amostragem padrão
- Iluminação estável e consistente, sem mudanças bruscas ao longo do clipe
- Posição da cabeça relativamente estável, sem movimentos laterais rápidos
Nessas condições, os modelos de ponta produzem resultados essencialmente indistinguíveis de imagens reais na velocidade normal de reprodução. A sincronia é precisa quadro a quadro, os visemas estão corretos e a textura da pele ao redor da boca é preservada, sem artefatos.
Onde ainda há dificuldades
Nenhum modelo lida perfeitamente com todos os cenários. Casos problemáticos comuns incluem:
- Perfis extremos: quando a cabeça está virada mais de 45 graus, o modelo tem menos marcos visíveis e a reconstrução fica menos confiável.
- Vários falantes no quadro: a maioria dos modelos é treinada com cenários de um único rosto. Duas pessoas falando ao mesmo tempo costumam causar erros de atribuição.
- Fala muito rápida: acima de cerca de 300 palavras por minuto, a precisão temporal cai um pouco.
- Idiomas com fonemas raros: a cobertura dos dados de treinamento determina diretamente o desempenho em fonemas que aparecem com pouca frequência no conjunto.
- Vídeo de origem em baixa resolução: não há como o modelo gerar detalhes de textura que não estavam nos pixels originais.
💡 Dica de produção: grave o vídeo de origem com o sujeito falando diretamente para a câmera, em um fundo limpo e com iluminação uniforme. O modelo produzirá resultados muito melhores em comparação com imagens captadas em condições difíceis.
Como usar a IA de sincronização labial no PicassoIA
O PicassoIA oferece uma coleção completa de modelos de sincronização labial diretamente na plataforma. Sem configuração local, sem credenciais de API para gerenciar, sem necessidade de GPU. Você envia seu vídeo, fornece a faixa de áudio e o modelo cuida do resto.
Passo 1: escolha seu modelo
O PicassoIA oferece vários modelos de sincronização labial, cada um com pontos fortes diferentes:
- Lipsync 2 Pro da Sync: a opção de maior fidelidade disponível. Produz sincronização precisa quadro a quadro, com excelente qualidade visual em uma ampla variedade de tipos de rosto e estilos de áudio. Comece por aqui para resultados profissionais.
- Lipsync 2 da Sync: uma versão mais rápida, para entregas mais ágeis em que a qualidade máxima é menos crítica.
- React 1 da Sync: adiciona sincronização labial realista a qualquer vídeo, com foco em resultados de aparência natural e bom desempenho em imagens variadas.
- Kling Lip Sync da Kwaivgi: forte em condições de filmagem variadas, incluindo imagens gravadas em ambientes mais desafiadores.
- PixVerse Lipsync: otimizado para velocidade. Bom para prévias rápidas e iterações ágeis.
- Omni Human da ByteDance: anima uma foto estática em um vídeo completo de alguém falando, a partir de uma única imagem e uma faixa de áudio. Não é preciso vídeo de origem.
- Fabric 1.0 da Veed: faz qualquer foto falar com animação guiada por áudio, otimizada para formatos de redes sociais.
Passo 2: envie seu vídeo
Acesse a página do modelo e envie seu clipe de vídeo de origem. Para melhores resultados:
- Formato: MP4 ou MOV, de preferência
- Resolução: pelo menos 720p, sendo que 1080p oferece resultados visivelmente melhores
- Sujeito: um rosto bem visível, de frente e bem iluminado
- Duração: a maioria dos modelos aceita clipes de alguns segundos até vários minutos
Evite arquivos muito comprimidos, imagens com desfoque de movimento ou clipes com mudanças rápidas de iluminação entre cortes.
Passo 3: adicione seu áudio
Envie a faixa de áudio que você quer sincronizar ao vídeo. Ela pode ser:
- Uma narração dublada gravada por um ator de voz
- Uma voz gerada por IA a partir de um sistema de texto para fala. O PicassoIA também oferece modelos de texto para fala que combinam naturalmente com o fluxo de trabalho de sincronização labial.
- Uma nova gravação da sua própria narração, com melhor qualidade de microfone
- Qualquer áudio de fala em formato WAV, MP3 ou M4A
💡 O áudio deve conter apenas fala. Música de fundo ou ruído ambiente misturado à faixa reduz substancialmente a precisão da sincronia. Use uma gravação de voz limpa e isolada sempre que possível.
Passo 4: gere e baixe
Clique em gerar. O tempo de processamento depende da duração do clipe e do modelo escolhido, indo de alguns segundos a alguns minutos para conteúdos mais longos. O vídeo final pode ser baixado diretamente da plataforma, com os movimentos dos lábios totalmente sincronizados à sua faixa de áudio e a qualidade original do vídeo preservada fora da região da boca.
O que faz um bom resultado de sincronização labial
O modelo faz o trabalho pesado, mas as suas entradas determinam o teto de qualidade.
A qualidade do áudio é tudo
Vale repetir isso porque é o fator mais negligenciado. Um modelo de sincronização labial lê as características do áudio para determinar a posição da boca quadro a quadro. Se o áudio tiver ruído, for comprimido com baixa taxa de bits ou contiver duas vozes ao mesmo tempo, a extração de características se torna pouco confiável e a saída visual sofre na mesma proporção.
Boas práticas para o áudio de entrada:
- Grave em um cômodo silencioso, sem ruído de fundo
- Use um microfone dedicado, e não o microfone embutido de um notebook ou celular
- Exporte em 44,1 kHz, no formato WAV ou FLAC
- Normalize o nível do áudio antes do envio, mirando algo em torno de -14 LUFS para fala
- Faça uma passagem de redução de ruído se o ambiente de gravação não tiver sido ideal
Requisitos do vídeo de entrada
O vídeo de entrada define a base visual com a qual o modelo trabalha. Não há como recuperar detalhes que não estejam nos pixels originais.
Boas práticas para o vídeo de entrada:
- Filme em pelo menos 1080p, e em 4K se o seu fluxo de trabalho permitir
- Use iluminação uniforme e consistente, sem sombras duras sobre a região da boca
- Mantenha o sujeito relativamente parado e centralizado no quadro ao longo de todo o clipe
- Evite filtros ou pós-processamento pesado aplicados ao material original antes do envio
- Garanta que o rosto esteja bem visível e não parcialmente coberto por mãos, cabelo ou objetos
A diferença de qualidade entre uma entrada bem preparada e um clipe gravado às pressas é grande no resultado final. Alguns minutos de preparação antes da gravação compensam bastante.
A IA de sincronização labial deixou de ser uma curiosidade de pesquisa para se tornar uma ferramenta de produção genuinamente prática. Seja para localizar conteúdo de vídeo em vários idiomas, criar apresentadores com IA para materiais de treinamento ou corrigir uma narração que não ficou como você queria, as ferramentas para isso estão disponíveis agora, sem nenhuma configuração técnica.
A coleção de sincronização labial do PicassoIA reúne a gama completa de modelos atuais em um só lugar, desde o Omni Human da ByteDance para animar uma foto estática em um vídeo falado, até o Lipsync 2 Pro da Sync para sincronização de áudio e vídeo de nível profissional em qualquer material já existente.
A distância entre o que você gravou e o que queria criar ficou bem menor. Envie um clipe, adicione seu áudio e veja exatamente o que esses modelos são capazes de fazer.


