Vous importez une vidéo du visage de quelqu’un. Vous ajoutez une piste audio totalement différente, peut-être une voix off doublée en espagnol, peut-être une voix générée par IA en anglais. En quelques secondes, le visage de la vidéo bouge la bouche en parfaite synchronisation avec le nouvel audio, en faisant correspondre chaque syllabe à la bonne position des lèvres. Le résultat paraît réel. Aucun fond vert, aucun studio, aucune reprise nécessaire.
C’est ce que fait la synchronisation labiale par IA. Et la science qui se cache derrière est vraiment fascinante.
Ce que fait réellement l’IA de synchronisation labiale
La plupart des gens pensent que l’IA de synchronisation labiale « devine » où doit se trouver la bouche à chaque instant. La réalité est bien plus précise. Le système ne devine pas, il lit. Chaque piste audio est une source de données structurée. L’IA décompose ce signal en ses plus petits composants mesurables, compare chaque composant à ce que fait physiquement un visage humain en produisant ces sons, puis déforme la zone de la bouche image par image pour correspondre. Le résultat paraît naturel parce qu’il repose sur une véritable science de la parole, et non sur une approximation.
Décomposer le signal audio
Lorsque vous envoyez une piste audio à un modèle de synchronisation labiale, la première chose qu’il fait est de faire passer l’audio dans un pipeline de traitement de la parole. Ce pipeline convertit l’onde brute en une suite de phonèmes, les plus petites unités sonores de n’importe quelle langue parlée.
Considérez les phonèmes comme les briques élémentaires de la parole. Le mot « hello » contient cinq phonèmes : /h/, /ɛ/, /l/, /l/, /oʊ/. Chacun a une durée, une enveloppe d’énergie et un motif de fréquence prévisibles. Un modèle bien entraîné peut extraire toutes ces caractéristiques d’un fichier audio propre en quelques millisecondes.
La couche de traitement audio utilise généralement une représentation coefficients cepstraux en fréquence de Mel (MFCC), qui capture la forme spectrale de la parole d’une manière qui reflète le fonctionnement réel de l’audition humaine. Certains modèles récents remplacent entièrement les MFCC par des embeddings audio appris, issus d’encodeurs de parole basés sur des transformers, qui offrent de meilleures performances selon les accents, les langues et les conditions d’enregistrement.
💡 Pourquoi c’est important : La qualité de l’analyse audio détermine directement la précision de la synchronisation labiale. Un audio propre, avec un seul locuteur, à 44,1 kHz, produit des résultats nettement meilleurs que des enregistrements compressés ou bruités.
Différents phonèmes ont des empreintes acoustiques distinctes dans le domaine fréquentiel. Une fricative sonore comme /v/ a une forme spectrale totalement différente d’une nasale comme /m/ ou d’une occlusive comme /p/. Le modèle apprend à reconnaître ces signatures de façon fiable, même lorsqu’elles sont mêlées dans une parole naturelle et fluide. La coarticulation, où un phonème passe en douceur dans le suivant sans coupure nette, est l’un des problèmes les plus difficiles du traitement de la parole. Les architectures modernes le traitent en modélisant l’audio dans des fenêtres temporelles qui se chevauchent, plutôt qu’en analysant les phonèmes isolément.
Associer les sons aux formes de la bouche
Une fois l’audio découpé en phonèmes, le système doit traduire chaque phonème en une forme de bouche correspondante. En animation, ces formes sont appelées visèmes. Toutes les langues partagent un ensemble de visèmes de base, même si l’inventaire des phonèmes diffère fortement d’une langue à l’autre.
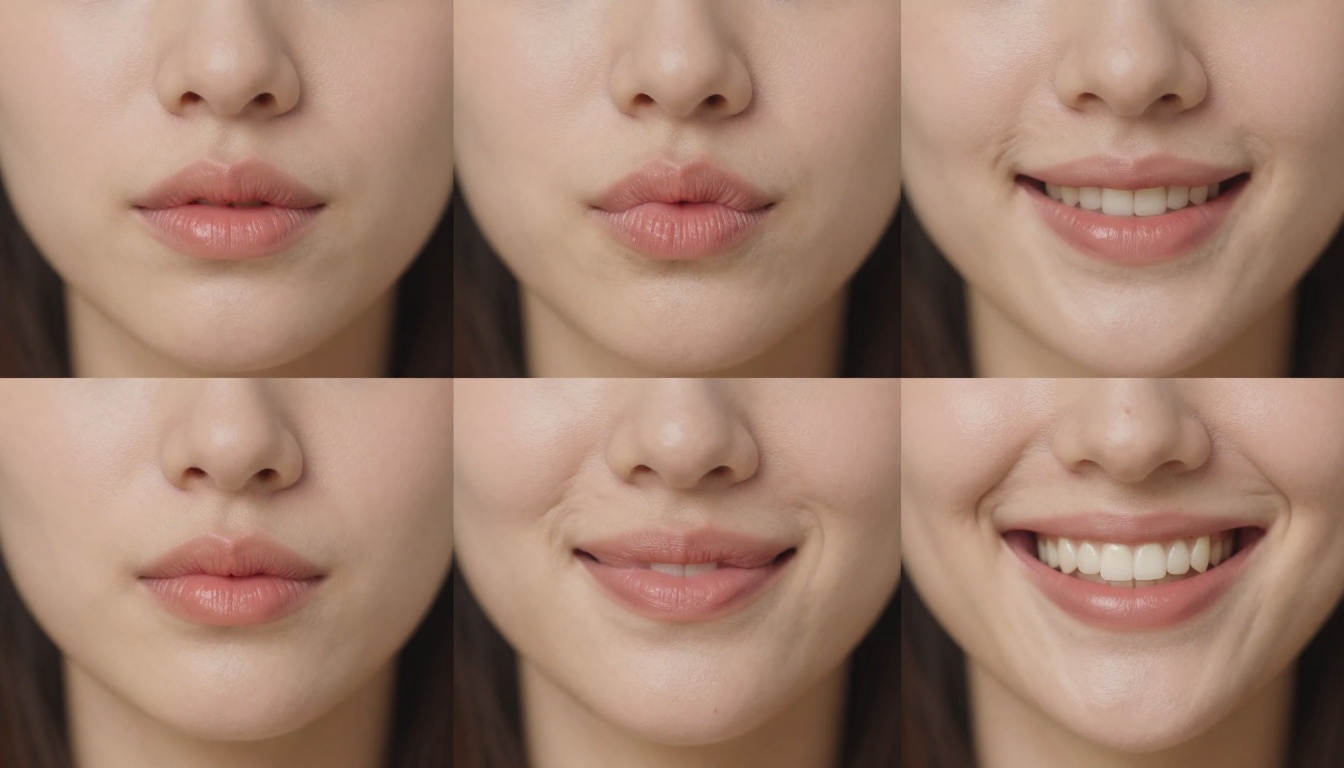
La correspondance entre phonème et visème n’est pas univoque. Plusieurs phonèmes partagent souvent la même forme de bouche visible. Les sons /p/, /b/ et /m/ ont presque la même apparence sur les lèvres, bien qu’ils soient acoustiquement distincts. C’est précisément pour cette raison que la lecture labiale est difficile pour les humains, mais gérable pour les systèmes d’IA, qui exploitent aussi les subtils mouvements de la mâchoire, l’abaissement du menton et la tension des joues comme indices complémentaires.
L’IA utilise la détection de points de repère faciaux pour identifier entre 68 et 478 points de référence sur le visage, notamment les commissures des lèvres, l’arc de Cupidon, le bout du menton et l’articulation de la mâchoire. Ces points forment le squelette que le modèle manipule image par image pour produire chaque visème. La zone autour de la bouche est ensuite déformée en texture pour correspondre à la forme cible, puis le résultat est réintégré dans la vidéo d’origine en veillant à préserver la texture de la peau, la continuité de l’éclairage et la douceur naturelle des contours des lèvres.
La dimension temporelle est tout aussi importante que la dimension spatiale. Un phonème ne se résume pas à une forme de bouche. Il possède un début, un pic et un relâchement. L’IA synchronise chaque visème sur ces événements temporels de l’audio avec une précision à l’image près, en travaillant généralement à 25 ou 30 images par seconde pour correspondre aux formats vidéo standard.
Les réseaux de neurones à l’origine du résultat
L’IA de synchronisation labiale n’est pas un système à règles, où quelqu’un a écrit « quand l’audio contient /m/, fermer les lèvres ». Le comportement émerge entièrement de l’entraînement sur d’immenses jeux de données de parole et de vidéos humaines réelles.
Comment les données d’entraînement façonnent la précision
Un bon modèle de synchronisation labiale est entraîné sur des milliers d’heures de vidéos de personnes qui parlent face caméra, avec un audio synchronisé avec précision, couvrant plusieurs langues, accents, âges et conditions d’éclairage. Pendant l’entraînement, le modèle apprend la relation statistique entre les caractéristiques audio et les mouvements du visage, en construisant une représentation interne qui se généralise bien au-delà de tout ce qu’un ensemble de règles codées à la main pourrait capturer.
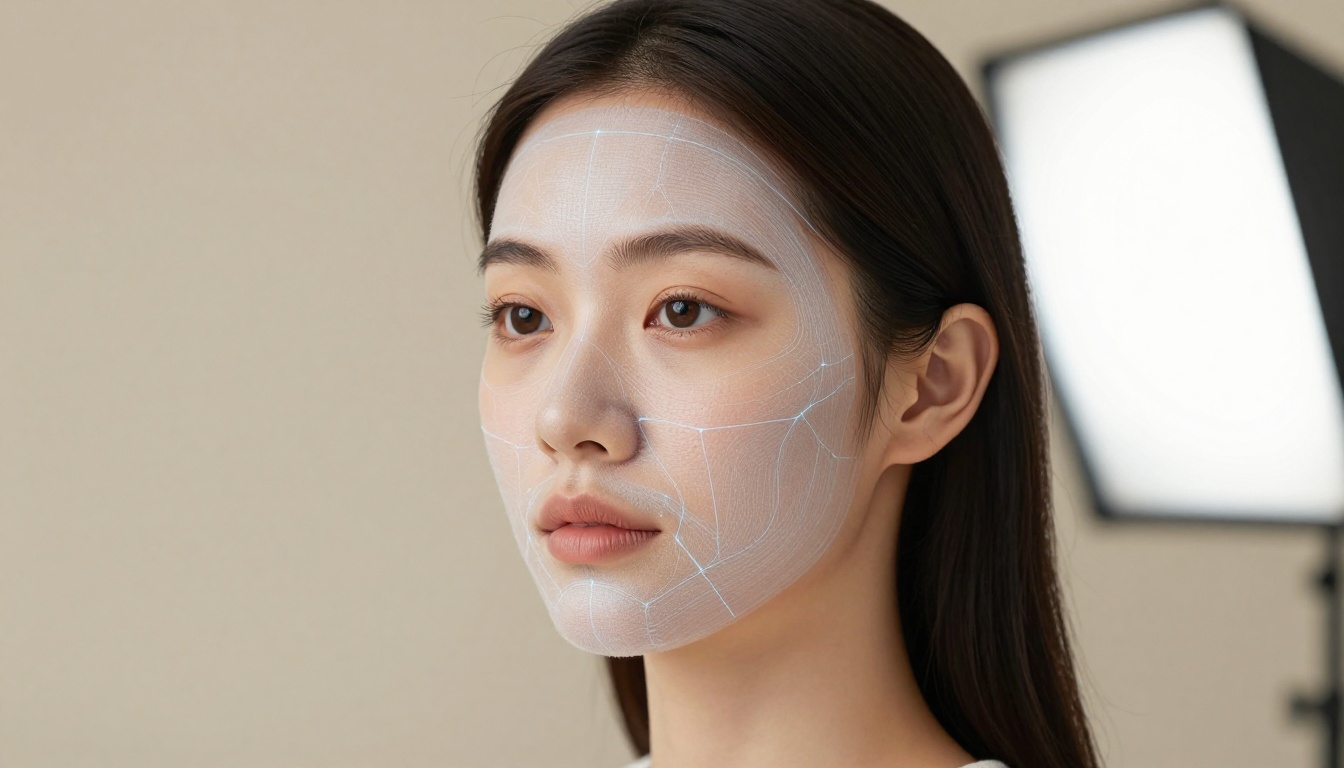
C’est pourquoi les modèles modernes se généralisent si bien à de nouveaux locuteurs. Ils ne mémorisent pas un ensemble fixe de formes de bouche par personne. Ils construisent une fonction continue capable d’interpoler entre des états connus, de gérer la coarticulation où un phonème se fond dans le suivant, et de respecter la dynamique temporelle de la parole naturelle, y compris les pauses, l’accentuation et les rythmes de respiration.
| Caractéristique | Systèmes à règles | Modèles de réseaux de neurones |
|---|
| Prise en charge des langues | Ensemble fixe uniquement | Multilingue |
| Gestion des accents | Faible | Solide |
| Coarticulation | Ignorée | Modélisée avec précision |
| Adaptation à un nouveau locuteur | Aucune | Immédiate |
| Réalisme visuel | Faible | Élevé |
| Fine-tuning possible | Non | Oui |
La diversité des données d’entraînement est le facteur unique le plus déterminant qui sépare les modèles moyens des modèles de qualité de production. Un modèle entraîné principalement sur des présentateurs de journaux télévisés anglophones aura du mal avec une parole rapide et familière, ou avec des langues qui utilisent des phonèmes en dehors de sa distribution d’entraînement. Les meilleurs modèles actuels utilisent des données provenant de centaines de locuteurs et de dizaines de langues pour construire une couverture réellement large.
Wav2Lip et ce qui a suivi
L’architecture qui a fait connaître la synchronisation labiale par IA était Wav2Lip, publiée en 2020. Elle reposait sur une approche GAN avec un discriminateur de synchronisation labiale dédié, qui évaluait non seulement la qualité visuelle, mais aussi la précision de la synchronisation image par image. Ce discriminateur était préentraîné sur un vaste jeu de données audiovisuelles pour reconnaître si un mouvement des lèvres correspondait à un segment audio donné.
Wav2Lip produisait des résultats impressionnants, mais présentait une faiblesse bien documentée : elle adoucissait parfois légèrement la zone de la bouche, en sacrifiant la netteté de la texture au profit de la précision de la synchronisation. Le domaine a beaucoup évolué depuis.
Les modèles de production actuels utilisent des architectures de diffusion, des modèles de visage 3D déformables (3DMM) et une diffusion latente conditionnée par l’audio pour produire des résultats à la fois précis dans le temps et photoréalistes. Plutôt que de déformer directement les pixels, certains modèles reconstruisent la zone de la bouche à partir de zéro, guidés par le signal audio et contraints par la géométrie du visage d’origine. Cette approche préserve la texture de la peau et supprime l’effet de flou. Plusieurs modèles de référence fonctionnent désormais en temps réel à 30 fps, ce qui ouvre la voie à des applications de diffusion en direct et de visioconférence.
Des usages concrets qui existent déjà
La synchronisation labiale par IA n’est pas théorique. Elle est utilisée en production dans de nombreux secteurs, dès aujourd’hui.
Le doublage vidéo dans toutes les langues
L’application la plus importante sur le plan commercial est le doublage vidéo multilingue. Historiquement, doubler un film ou un documentaire exigeait des comédiens de doublage, un studio d’enregistrement et des semaines de post-production pour synchroniser les répliques. Même avec tout cet effort, les mouvements des lèvres paraissaient souvent faux, car le nouveau dialogue n’avait pas la même durée que l’original.
L’IA de synchronisation labiale change radicalement la donne. Un documentaire narré en anglais peut être doublé en portugais ou en hindi, les mouvements des lèvres étant régénérés pour correspondre à la nouvelle piste audio. Le visage du locuteur bouge naturellement avec la parole traduite, sans aucun nouveau tournage.
💡 Impact réel : Les plateformes de streaming utilisent désormais le doublage par IA pour diffuser simultanément des contenus dans des dizaines de langues, avec une précision de synchronisation labiale qui tient la route dans des conditions de visionnage normales, dans toutes ces langues.
Présentateurs virtuels et avatars IA
La formation en entreprise, les plateformes d’apprentissage en ligne et les vidéos marketing utilisent de plus en plus des présentateurs animés par IA qui délivrent des contenus scénarisés, sans qu’un humain doive se placer devant une caméra à chaque révision. Le présentateur est soit un avatar de synthèse photoréaliste, soit l’image enregistrée d’une vraie personne, piloté entièrement par un signal audio.
Ce cas d’usage profite énormément d’une correspondance précise entre phonèmes et visèmes. Une vidéo d’e-learning dont la bouche du présentateur ne correspond pas à la narration paraît immédiatement fausse. Elle détourne l’attention du spectateur et nuit à la crédibilité du contenu. Lorsque la synchronisation est serrée, la charge cognitive disparaît et le spectateur reste concentré sur l’information transmise.
Création de contenu sans reprise
Pour les créateurs indépendants, l’application la plus immédiatement pratique est la correction des décalages entre image et son dans les contenus enregistrés. Si la piste audio d’un créateur a légèrement dérivé pendant l’enregistrement, ou s’il veut réenregistrer la voix off avec une meilleure prise de son, la synchronisation labiale par IA peut réaligner la vidéo sur le nouvel audio, sans aucun nouveau tournage.
Elle permet aussi de produire des versions multilingues d’une même vidéo. Une chaîne YouTube peut publier le même contenu en anglais, en espagnol et en français, avec le visage du présentateur synchronisé sur chaque piste audio, à partir d’une seule session d’enregistrement. Cela réduit le temps de production des contenus localisés de quelques jours à quelques minutes.
Quelle est sa précision aujourd’hui ?
La précision de la synchronisation labiale par IA se décline en deux dimensions distinctes : la précision temporelle (la bouche bouge-t-elle exactement au bon moment ?) et la fidélité visuelle (la forme de la bouche paraît-elle naturelle et correspond-elle au phonème précis prononcé ?).
Quand les résultats sont irréprochables
Les modèles actuels donnent leurs meilleurs résultats dans les conditions suivantes :
- Tête de face ou quasi de face, à environ 30 degrés près de l’axe de la caméra
- Un seul locuteur, sans autre visage dans le même cadre
- Audio propre et sans bruit, enregistré à un taux d’échantillonnage standard
- Éclairage stable et constant, sans changements brusques pendant le plan
- Position de la tête relativement stable, sans mouvement latéral rapide
Dans ces conditions, les modèles les plus avancés produisent des résultats pratiquement indiscernables d’une prise de vue réelle à vitesse de lecture normale. La synchronisation est précise à l’image près, les visèmes sont corrects et la texture de la peau autour de la bouche est préservée, sans artefacts.
Là où cela pose encore problème
Aucun modèle ne gère parfaitement tous les scénarios. Les cas problématiques courants incluent :
- Vues de profil extrême : lorsque la tête est tournée de plus de 45 degrés, le modèle dispose de moins de points de repère visibles et la reconstruction devient moins fiable.
- Plusieurs locuteurs dans le cadre : la plupart des modèles sont entraînés sur des scénarios à un seul visage. Deux personnes qui parlent en même temps provoquent souvent des erreurs d’attribution.
- Parole très rapide : au-delà d’environ 300 mots par minute, la précision temporelle baisse légèrement.
- Langues avec des phonèmes rares : la couverture des données d’entraînement détermine directement les performances sur les phonèmes peu fréquents dans le jeu de données.
- Vidéo source en basse résolution : le modèle ne peut pas générer de détails de texture qui ne figuraient pas dans les pixels d’origine.
💡 Conseil de production : Enregistrez la vidéo source avec le sujet qui parle directement face à la caméra, sur un fond propre et uniformément éclairé. Le modèle produira des résultats nettement meilleurs que pour des images tournées dans des conditions difficiles.
PicassoIA propose une collection complète de modèles de synchronisation labiale directement sur la plateforme. Pas d’installation locale, pas d’identifiants API à gérer, pas de GPU requis. Vous importez votre vidéo, fournissez votre piste audio, et le modèle s’occupe du reste.
Étape 1 : choisissez votre modèle
PicassoIA propose plusieurs modèles de synchronisation labiale, chacun avec ses propres atouts :
- Lipsync 2 Pro de Sync : l’option la plus fidèle disponible. Produit une synchronisation précise à l’image près, avec une excellente qualité visuelle sur un large éventail de types de visages et de styles audio. Commencez ici pour un résultat professionnel.
- Lipsync 2 de Sync : une variante plus rapide pour des délais plus courts, lorsque la qualité maximale est moins critique.
- React 1 de Sync : ajoute une synchronisation labiale réaliste à n’importe quelle vidéo, avec un accent sur un rendu naturel et de bonnes performances sur des images variées.
- Kling Lip Sync de Kwaivgi : performant dans des conditions de tournage variées, y compris pour des images enregistrées dans des environnements plus difficiles.
- PixVerse Lipsync : optimisé pour la vitesse. Idéal pour des aperçus rapides et des itérations rapides.
- Omni Human de ByteDance : anime une photo fixe en une vidéo complète de personne qui parle, à partir d’une seule image et d’une piste audio. Aucune vidéo source n’est nécessaire.
- Fabric 1.0 de Veed : fait parler n’importe quelle photo grâce à une animation pilotée par l’audio, optimisée pour les formats des réseaux sociaux.
Étape 2 : importez votre vidéo
Rendez-vous sur la page du modèle et importez votre extrait vidéo source. Pour de meilleurs résultats :
- Format : MP4 ou MOV de préférence
- Résolution : au moins 720p, la 1080p donnant des résultats nettement meilleurs
- Sujet : un seul visage bien visible, de face et bien éclairé
- Durée : la plupart des modèles acceptent des extraits de quelques secondes à plusieurs minutes
Évitez les fichiers fortement compressés, les images avec du flou de bougé ou les clips présentant des changements brusques d’éclairage entre les plans.
Étape 3 : ajoutez votre audio
Importez la piste audio que vous souhaitez synchroniser avec la vidéo. Il peut s’agir :
- D’une voix off doublée, enregistrée par un comédien de doublage
- D’une voix générée par IA, produite avec un système de synthèse vocale. PicassoIA propose également des modèles de synthèse vocale qui s’associent naturellement au flux de travail de synchronisation labiale.
- D’une version réenregistrée de votre propre narration, avec une meilleure qualité de micro
- De tout audio de parole au format WAV, MP3 ou M4A
💡 L’audio ne doit contenir que de la parole. Une musique de fond ou un bruit ambiant mélangé à la piste réduit fortement la précision de la synchronisation. Utilisez un enregistrement de voix propre et isolé dans la mesure du possible.
Étape 4 : générez et téléchargez
Lancez la génération. Le temps de traitement dépend de la durée de l’extrait et du modèle choisi : de quelques secondes à quelques minutes pour les contenus plus longs. La vidéo obtenue peut être téléchargée directement depuis la plateforme, avec les mouvements des lèvres entièrement synchronisés sur votre piste audio et la qualité vidéo d’origine préservée en dehors de la zone de la bouche.
Ce qui fait un bon résultat de synchronisation labiale
Le modèle fait l’essentiel du travail, mais vos entrées déterminent le plafond de qualité.
La qualité audio est primordiale
Ce point mérite d’être répété, car c’est le facteur le plus souvent négligé. Un modèle de synchronisation labiale lit les caractéristiques audio pour déterminer la position de la bouche image par image. Si l’audio est bruité, compressé à faible débit ou contient deux voix simultanément, l’extraction des caractéristiques devient peu fiable et le rendu visuel en pâtit proportionnellement.
Bonnes pratiques pour l’audio :
- Enregistrez dans une pièce calme, sans bruit de fond
- Utilisez un micro dédié plutôt que le micro intégré d’un ordinateur portable ou d’un téléphone
- Exportez à 44,1 kHz au format WAV ou FLAC
- Normalisez le niveau audio avant l’import, en visant environ -14 LUFS pour la parole
- Appliquez une réduction de bruit si l’environnement d’enregistrement n’était pas idéal
Exigences relatives à la vidéo source
La vidéo source pose les bases visuelles sur lesquelles travaille le modèle. Il n’existe aucun moyen de récupérer des détails absents des pixels d’origine.
Bonnes pratiques pour la vidéo source :
- Tournez en 1080p au minimum, en 4K si votre flux de travail le permet
- Utilisez un éclairage constant et uniforme, sans ombres marquées sur la zone de la bouche
- Gardez le sujet relativement immobile et centré dans le cadre tout au long du plan
- Évitez les traitements ou filtres lourds appliqués aux images d’origine avant l’import
- Assurez-vous que le visage est bien visible et n’est pas partiellement masqué par des mains, des cheveux ou des objets
L’écart de qualité entre une entrée bien préparée et un extrait enregistré à la hâte est considérable dans le résultat final. Quelques minutes de préparation avant le tournage valent largement l’effort.
Commencez à créer avec la synchronisation labiale par IA
L’IA de synchronisation labiale est passée du stade de curiosité de recherche à celui d’outil de production réellement pratique. Que vous localisiez des contenus vidéo dans plusieurs langues, que vous créiez des présentateurs IA pour des supports de formation, ou que vous corrigiez une voix off qui ne sonnait pas tout à fait juste, les outils pour le faire sont disponibles dès maintenant, sans aucune configuration technique.
La collection de synchronisation labiale de PicassoIA réunit la gamme complète des modèles actuels, de Omni Human de ByteDance pour animer une photo fixe en vidéo parlante, à Lipsync 2 Pro de Sync pour une synchronisation audio-vidéo de niveau professionnel sur n’importe quelle vidéo existante.
L’écart entre ce que vous avez enregistré et ce que vous vouliez créer vient de se réduire considérablement. Importez un extrait, ajoutez votre audio et voyez exactement ce que ces modèles peuvent faire.


