تعاني الفيديوهات المدبلجة من مشكلة في المزامنة منذ عقود. يتحرك الفم، وتخرج الكلمات، ولا يتطابق الاثنان تمامًا في النهاية. تراها في الأفلام الأجنبية، وفي مقاطع التدريب المؤسسي، وفي محتوى وسائل التواصل الاجتماعي حيث استُبدل الصوت بعد التصوير. الشفاه تروي قصة، والصوت يروي أخرى، ويلتقط دماغك الفجوة فورًا، حتى لو لم تستطع تحديد الخلل بدقة.
يعالج تزامن الشفاه بالذكاء الاصطناعي هذه المشكلة على مستوى البكسل، لا عبر تخمينات ما بعد الإنتاج. لا يتعلق الأمر بقص المقاطع لإخفاء عدم التطابق، ولا بتعديل إزاحة الصوت بمقدار 200 ملّي ثانية. يتعلق الأمر بفهم كل صوت يصدره الشخص، والتنبؤ بشكل الفم الدقيق الذي يتطلبه ذلك الصوت، ثم تصيير نسخة جديدة من الفم تتبع الصوت إطارًا بعد إطار دون أي فاصل مرئي.
إليك الطريقة الدقيقة التي يعمل بها.
لماذا تبدو الفيديوهات المدبلجة خاطئة
طوّر الدماغ البشري قدرة دقيقة على رصد عدم التطابق بين الصوت والوجه. تُظهر الأبحاث في إدراك الكلام السمعي البصري، المستندة إلى أعمال مرتبطة بتأثير ماكغورك، أننا نعالج الصوت وحركة الشفاه معًا، لا كمسارين منفصلين. وعندما يختلفان بمقدار 80 إلى 100 ملّي ثانية فقط، يُسجَّل عدم التطابق على أنه "خطأ" حتى دون انتباه واعٍ.
تترجم سير عمل الدبلجة التقليدية الحوار، وتعيد تسجيل الصوت مع الممثلين، ثم تحاول مطابقة الصوت الجديد مع حركة الفم الموجودة عبر المونتاج الإبداعي. تعتمد النتائج كليًا على ما كان فم الممثل الأصلي يفعله. لا توجد طريقة لتغيير اللقطات الأصلية، لذلك يُخفى كل مقطع صوتي لا يتناسب بقطعة أو لقطة رد فعل.
يفعل تزامن الشفاه بالذكاء الاصطناعي العكس تمامًا. يبدأ من الصوت بوصفه المرجع الحقيقي، ويولّد حركة فم جديدة تطابقه، بصرف النظر عمّا كان المتحدث الأصلي يفعله. تبقى هوية الفيديو سليمة، ويبقى السياق سليمًا. الشيء الوحيد الذي يتغير هو الفم.
💡 الفارق بين المحتوى المدبلج بشكل سيئ والمحتوى المتزامن باحترافية يضيق بسرعة. ما كان يستغرق أسبوعًا كاملًا من فريق ما بعد الإنتاج في الاستوديو صار يستغرق دقائق مع الأدوات المناسبة.
كيف يقرأ الذكاء الاصطناعي صوتك
من الموجة الصوتية إلى الفونيم: الخطوة الأولى
قبل أن يتحرك أي فم، يجب أن يفهم الذكاء الاصطناعي الأصوات التي تُنتَج. يصل الصوت الخام على شكل موجة صوتية: تمثيل زمني لتغيرات ضغط الهواء، مُلتقَط بمعدل 44,100 عينة في الثانية في الصوت القياسي. هذه الموجة ليست مفيدة مباشرة لتزامن الشفاه. فذروة سعة واحدة قد تمثل أي صوت.
يمرر النظام الموجة عبر مسار للتعرف على الكلام يحدد الفونيمات: أصغر الوحدات الصوتية المميزة في اللغة. تحتوي الإنجليزية على نحو 44 فونيمًا. تتفكك كل كلمة إلى تسلسل منها. تحتوي كلمة "mouth" على أربعة فونيمات مميزة: /m/ و/aʊ/ و/θ/. لكل فونيم مقابل فيزيائي في الوجه، وهو شكل تتخذه الشفاه واللسان والأسنان والفك معًا لإنتاج ذلك الصوت بعينه.
يُسمّى ربط الصوت بالفونيمات المحاذاة القسرية. تستخدم الأنظمة الحديثة نماذج صوتية قائمة على المحوّلات (Transformers) مدرّبة على آلاف الساعات من الكلام المفرّغ، لتنفيذ هذه المحاذاة بدقة على مستوى الإطار، وغالبًا ما تكون دقيقة في حدود 10 إلى 15 ملّي ثانية.
طيف ميل وبصمات الصوت
تعمل معظم نماذج تزامن الشفاه لا مع الموجات الصوتية الخام، بل مع أطياف ميل: تمثيلات ثنائية الأبعاد للصوت يمثل محورها الأفقي الزمن، ومحورها الرأسي التردد وفق مقياس ميل (الذي يقارب السمع البشري)، ويمثل سطوع البكسل شدة الطاقة عند كل نقطة زمن-تردد.
تمنح أطياف ميل الشبكة العصبية رؤية أغنى وأكثر تماسكًا مكانيًا لإشارة الصوت. فالشبكة لا ترى فقط متى تحدث الأصوات، بل كيف تنتقل بين بعضها، وكيف تتحول الفورمانتات (الترددات الرنينية) عندما ينزلق فونيم إلى الذي يليه، وكيف يبدو الإيقاع والنغمة العامة للكلام عبر المقطع كله. يغذي هذا التمثيل الصوتي نواة نموذج تزامن الشفاه بوصفه الإشارة الأساسية للتكييف طوال عملية التركيب.
رصد الفم، إطارًا بعد إطار
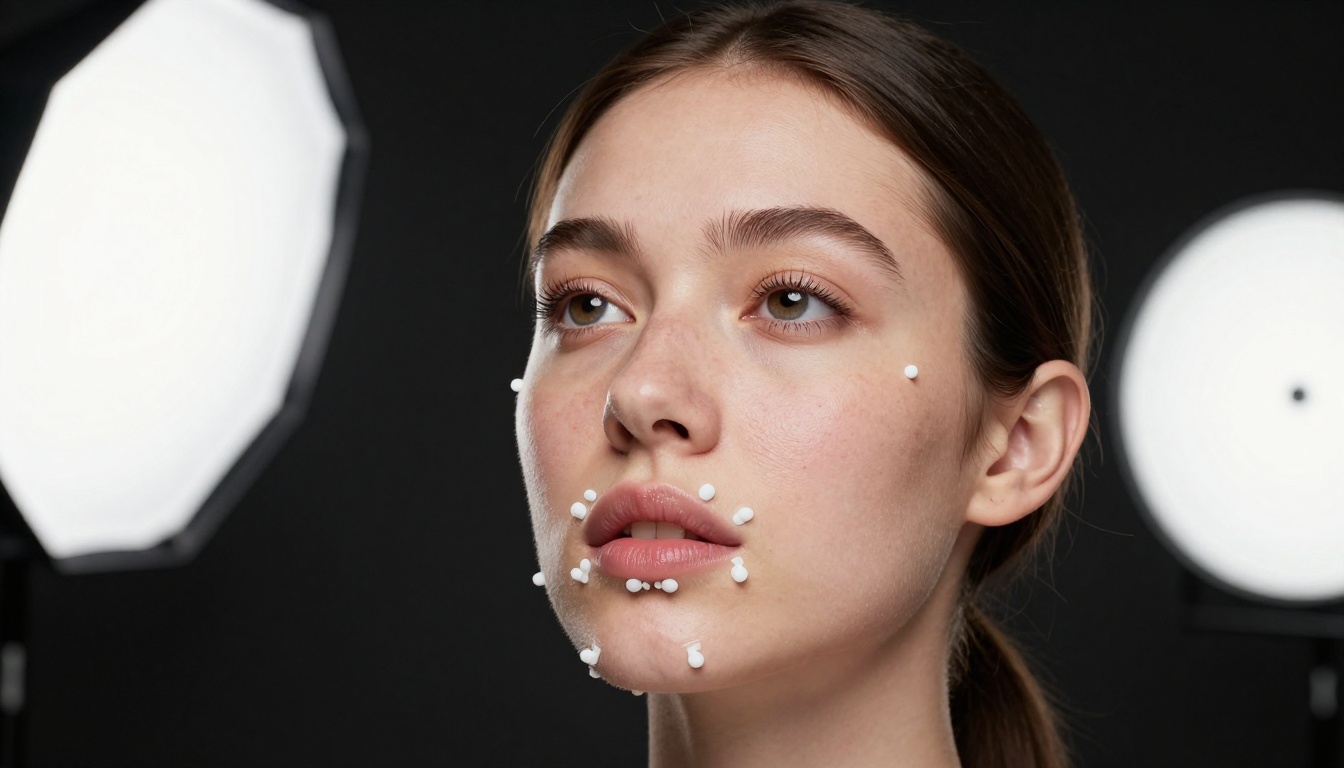
قبل أن يتمكن الذكاء الاصطناعي من تغيير الفم، يجب أن يعرف بدقة مكانه في كل إطار وما الذي يفعله في تلك اللحظة. وهذا يتجاوز بكثير رسم مربع إحاطة حول منطقة الشفاه.
شبكات النقاط المرجعية للوجه
تستخدم أنظمة تزامن الشفاه المتطورة أدوات رصد النقاط المرجعية للوجه التي تحدد من 68 إلى 478 نقطة دقيقة عبر الوجه، بحسب بنية النموذج. تتكثف النقاط حول منطقة الفم: زوايا الشفتين، والحافة الحمراء للشفاه، وقوس كيوبيد، والمسافة بين الأنف والشفة العليا، والمسافات بين الأسنان، وخط الذقن، وتتلقى كل منها تتبعًا فرديًا للإحداثيات في كل إطار.
تُتنبأ هذه النقاط لكل إطار باستخدام الشبكات العصبية الالتفافية المدرّبة على مجموعات كبيرة من بيانات الوجوه المُعلَّمة. والنتيجة شبكة ثلاثية الأبعاد لكل إطار تُسقَط فوق الوجه، ترسم هندسة الوجه بدقة عالية حتى عندما يدير الشخص رأسه قليلًا، أو يغيّر تعبيره، أو يتحرك داخل الإطار. تصبح هذه الشبكة المرساة المكانية التي تحدد لمرحلة التركيب بالضبط أين يجب أن يقع الفم الجديد داخل الوجه في كل لحظة.
تتبع الفك وزاوية الشفة والأسنان
يحتاج تزامن الشفاه تحديدًا إلى تتبع دقيق لعدة مكونات منفصلة في الفم تتحرك كلٌّ منها باستقلالية:
- انفتاح الشفتين: مدى انفتاح الفم أو إغلاقه رأسيًا في كل إطار على حدة
- موضع زاوية الشفة: ما إذا كان الفم ممدودًا عرضيًا أو مسترخيًا إلى الداخل
- ظهور الأسنان العلوية والسفلية: حاسم للأصوات الاحتكاكية والصفيرية مثل /s/ و/f/
- إزاحة الفك: الحركة الرأسية للفك السفلي بمعزل عن شكل الشفتين
- موضع اللسان: نادرًا ما يُنمذج، لكنه يُدمج بشكل متزايد في أنظمة التوليد الأحدث
تنشئ بيانات الحركة لكل إطار مرجعًا هندسيًا تستخدمه مرحلة التركيب كبنية بداية لتصيير الفم الجديد. ومن دون طبقة التتبع هذه، تنحرف الأفواه المركّبة عن الوجه خلال ثوانٍ.
تركيب حركة فم جديدة
بمجرد أن يعرف النظام الأصوات المستهدفة وهندسة الوجه الحالية، يجب أن يولّد منطقة فم جديدة تُظهر النطق الصحيح لكل فونيم في كل إطار، ومصيّرة لتطابق مظهر الشخص الأصلي.
رسم الفيزيمات
الفيزيمات هي المقابلات البصرية للفونيمات. فبينما تحتوي الإنجليزية على 44 فونيمًا، تتجمع أشكال الفم المرئية التي تنتجها في نحو 14 إلى 21 فئة فيزيمية مميزة. كثير من الفونيمات المختلفة صوتيًا تبدو متطابقة على الشفاه عند النظر من الأمام. فالفونيمات /p/ و/b/ و/m/ جميعها تنتج فيزيم الشفتين المغلقتين، ولهذا يسهل الخلط بينها بشهرة عند قراءة الشفاه دون صوت.
عمل الجيل الأول من تزامن الشفاه بالذكاء الاصطناعي انطلاقًا من جداول بحث فيزيمية صريحة: يحدد الفونيم، ويسترجع صورة الفم المخزنة المقابلة، ويدمجها في الإطار. جاءت النتائج آلية، مع انتقالات غير طبيعية، ومن دون أي تكيّف مع هوية المتحدث أو السياق.
تستبدل الأنظمة الحديثة ذلك الجدول برسم مُتعلَّم: شبكة عصبية مدرّبة على ملايين أزواج الصوت والفيديو المتزامنة، وقد استوعبت التوزيع الإحصائي الكامل لكيفية تحرك الأفواه لكل صوت، في كل سياق، ولكل لهجة وملف متحدث.
التصيير العصبي ومطابقة الملمس
تستخدم خطوة التركيب نموذجًا توليديًا (غالبًا بنية GAN أو قائمة على الانتشار) يأخذ ثلاثة مدخلات في آنٍ واحد:
- ميزات الصوت المستهدف، مُرمَّزة من شريحة طيف ميل المقابلة لهذه اللحظة الزمنية
- هوية الوجه المرجعية، مستخرجة كتضمين ميزات من الفيديو المدخل
- هندسة وجه الإطار الحالي، كما يوفرها متتبع النقاط المرجعية
المخرج منطقة فم جديدة: مقطع فيديو مركّب يُظهر حركة الفم الصحيحة لتلك الشريحة الصوتية، مصيّر بالأسلوب البصري وملمس بشرة الشخص الأصلي تحت الإضاءة الأصلية للمادة المصدر.
التحدي المركزي هو اتساق الملمس. يجب أن يطابق الجزء الفموي المركّب لون البشرة المحيط، واتجاه الإضاءة الموجودة وجودتها، وحبيبات البشرة وبنية المسام، وأي ضبابية حركة موجودة في الإطار الأصلي. تستخدم أفضل النماذج مرمّزات الهوية التي تستخرج تضمين ميزات عالي الأبعاد من وجه المصدر، وتُكيّف المصيّر عليه طوال مرحلة التركيب بأكملها.
| المكوّن | الوظيفة | لماذا يهم |
|---|
| مرمّز الصوت | يحوّل شريحة الصوت إلى متجهات ميزات | يحدد شكل الفم الصحيح لكل إطار |
| مرمّز الهوية | يلتقط المظهر البصري للمتحدث | يحافظ على شبه الشخص |
| متتبع النقاط المرجعية | يرسم هندسة الوجه في كل إطار | يثبّت الفم المركّب في الموضع الصحيح |
| المصيّر العصبي | يركّب منطقة الفم الجديدة | ينتج مخرجات واقعية كالصور الفوتوغرافية |
| المُنعِّم الزمني | يزيل الارتعاش بين الإطارات | يمنع الوميض وعيوب الحركة |
المحاذاة الزمنية: الجزء الأصعب
جعل إطار واحد يبدو صحيحًا مشكلة قابلة للحل. أما جعل 30 إطارًا في الثانية تبدو صحيحة، بحركة سلسة، ودون وميض أو انجراف في الهوية عبر طول المقطع كله، فهنا تكشف معظم أنظمة تزامن الشفاه عن قيودها الحقيقية.
عدم تطابق معدل الإطارات
يوجد الصوت في زمن متصل. ويوجد الفيديو في إطارات منفصلة. عندما يقول الصوت إن الفم يجب أن يكون عند موضع انفتاح محدد عند 1.033 ثانية، قد يكون أقرب إطار فيديو عند 1.033 ثانية (30 إطارًا في الثانية) أو عند 1.025 ثانية (40 إطارًا في الثانية). يتراكم هذا الفارق الصغير عبر المقاطع الطويلة، فينتج انجرافًا زمنيًا خفيًا لكنه مرئي.
تعالج الأنظمة المتقدمة هذا بـالاستيفاء دون الإطاري: توليد حالات وسيطة للفم بين الإطارات المصيّرة، ودمجها مع ضبابية حركة مناسبة لخلق انطباع بحركة سلسة ومتصلة فيزيائيًا لا تتقطع عند حدود الإطارات.
الحفاظ على الهوية سليمة
انجراف الهوية نمط فشل خفي لكنه مهم يظهر في المقاطع الأطول. بعد عدة ثوانٍ من رقع الفم المصيّرة عصبيًا، قد يبدأ الوجه في الظهور مختلفًا بشكل طفيف عن الأصل: لون البشرة أدفأ قليلًا، والأسنان أكثر بياضًا بقليل، وكنتور الشفة معاد تشكيله بالحد الأدنى. تتراكم الأخطاء الصغيرة في كل إطار لتصبح انحرافًا مرئيًا مع الوقت.
تطبّق أحدث النماذج دالة خسارة هوية إدراكية أثناء التدريب، تعاقب أي انحراف عن هوية المصدر عبر دفعة من الإطارات. وأثناء الاستدلال، تطبّق أيضًا إعادة محاذاة دورية تقارن كل رقعة مصيّرة بتضمين هوية المصدر، وتدفعها عائدة نحو المظهر الأصلي.
💡 الاتساق الزمني هو ما يفصل بين تزامن الشفاه بجودة المستهلك ونتائج الاحتراف. الفارق غالبًا ما يكون غير مرئي في إطار ثابت واحد، لكنه واضح فورًا لحظة تشغيل الفيديو بسرعته الكاملة.
تزامن الشفاه الفوري مقابل تزامن ما بعد الإنتاج
هناك سياقان متمايزان لنشر تزامن الشفاه بالذكاء الاصطناعي، ويتضمنان مفاضلات تقنية مختلفة جوهريًا بين الجودة والسرعة.
تزامن الشفاه الفوري يعمل أثناء البث المباشر، أو مكالمات الفيديو، أو الجلسات التفاعلية. يجب أن يعالج الصوت ويصيّر مخرجات فيديو معدّلة بزمن استجابة إجمالي من البداية إلى النهاية أقل من 100 ملّي ثانية، وغالبًا على أجهزة بمستوى المستهلك دون موارد GPU مخصصة. لتحقيق هذا القيد، تستخدم الأنظمة الفورية بنى نماذج أصغر، ومناطق فم بدقة أقل، وتنعيمًا زمنيًا قويًا يقبل بعض فقدان الدقة مقابل السرعة. وتشمل التطبيقات الرئيسية الأفاتارات الافتراضية المباشرة، وشخصيات الألعاب التفاعلية، وأنابيب المقدمين الافتراضيين.
تزامن الشفاه في مرحلة ما بعد الإنتاج يعمل بمعالجة مؤجلة على محتوى مسجّل مسبقًا. لا يُعتد بزمن الاستجابة هنا. يستطيع النظام استخدام نماذج أكبر بكثير، وإجراء عدة مرات على أي مقطع يُظهر عيوبًا، وتطبيق تحسين تكراري بالدقة الكاملة، وأخذ الوقت الكافي لإنتاج أفضل مخرج ممكن. هذا هو الوضع المستخدم في دبلجة الأفلام الاحترافية، وتوطين الفيديو المؤسسي، وإنشاء المحتوى الاجتماعي عالي الجودة.
تعمل معظم النماذج المتاحة على PicassoIA في وضع ما بعد الإنتاج، وهذا يعني أن سقف الجودة أعلى بكثير مما تواجهه في تطبيقات الأفاتار المباشرة للمستهلكين.
أفضل نماذج تزامن الشفاه على PicassoIA
تستضيف PicassoIA 12 نموذجًا لتزامن الشفاه تغطي مزودين مختلفين، وفئات جودة متعددة، وحالات استخدام محددة. إليك النماذج البارزة التي تستحق المعرفة لكل سيناريو.
Sync Lipsync 2 Pro
Sync Lipsync 2 Pro هو العرض المتميز من Sync، أحد أكثر مزودي تزامن الشفاه تركيزًا على الجانب التقني في السوق. يتعامل مع حالات النطق الصعبة، ومنها ظهور الأسنان عند الحركات الواسعة للحروف المتحركة، والحروف الجانبية، والانتقالات السريعة بين الفونيمات التي تربك النماذج الأقل تطورًا. وتبقى جودة المخرجات بالدقة الكاملة مناسبة للبث، وتصمد جيدًا في لقطات الوجه المقرّبة حيث يكون أي عيب مرئيًا فورًا.
HeyGen Lipsync Precision
يجري HeyGen Lipsync Precision تحليلًا عميقًا للفونيمات على الصوت المدخل قبل بدء التركيب، مما يجعل المحاذاة الزمنية محكمة بشكل غير معتاد عبر المقطع كله. وهو قوي بشكل خاص لمزامنة التعليق الصوتي مع الوجه حين يكون الصوت البديل مسجّلًا بشكل مستقل ولا تربطه علاقة زمنية متأصلة بالفيديو الأصلي.
Kling Lip Sync
يطبّق Kling Lip Sync من Kwaivgi تزامن الشفاه ضمن خط أوسع لفهم الفيديو يُنمذج السياق الكامل للجسم. يتعامل مع حركة الرأس والبيئة بشكل أفضل من أنظمة منطقة الفم وحدها، مما يجعله الخيار الصحيح للقطات يتحرك فيها المتحدث أثناء الإلقاء بدلًا من أن يتحدث مباشرة إلى الكاميرا.
ByteDance Omni Human 1.5
يحوّل ByteDance Omni Human 1.5 صورة ثابتة إلى فيديو متحدث كامل باستخدام مدخل صوتي فقط. هذه مشكلة أصعب من مزامنة مادة مصوّرة موجودة، لأن النموذج يجب أن يولّد أيضًا حركة طبيعية للرأس، ورمشًا للعين، وتعابير دقيقة من الصفر دون أي مرجع حركي. النتائج طبيعية بشكل غير معتاد بالنسبة إلى خط تحويل الصورة إلى فيديو، وتعمل جيدًا في إنشاء الأفاتارات وسير عمل المقدمين.
من الخيارات القوية الأخرى المتاحة على المنصة Sync Lipsync 2 لمزامنة عالية الجودة بمستوى أدنى قليلًا من فئة Pro، وHeyGen Lipsync Speed عندما يكون وقت المعالجة أولوية، وPixverse Lipsync لمزامنة فورية من الصوت إلى الفيديو، وVEED Fabric 1.0 لجعل الصور تتكلم، وSync React 1 لإضافات واقعية إلى المادة المصوّرة الموجودة، وHeyGen Video Translate عندما يكون الهدف الدبلجة متعددة اللغات عبر 150 لغة أو أكثر. أما الأفاتارات المتحدثة المتحركة بالكامل انطلاقًا من صورة ثابتة، فيكتمل المشهد مع P Video Avatar وByteDance Omni Human.
كيفية استخدام Lipsync 2 Pro على PicassoIA
يُعد Sync Lipsync 2 Pro نقطة البداية الموصى بها للحصول على نتائج احترافية على المادة المصوّرة الموجودة. إليك الطريقة الدقيقة لتشغيله من البداية إلى النهاية.
الخطوة 1: جهّز ملفاتك. تحتاج إلى ملفين: فيديو للشخص الذي تريد مزامنة فمه، وملف صوتي يحتوي على الكلام المستهدف. ينبغي أن يكون الفيديو بدقة 720p على الأقل مع رؤية واضحة للمتحدث من الأمام. ويجب أن يكون الصوت نظيفًا مع الحد الأدنى من ضجيج الخلفية أو الصدى أو الضغط الديناميكي الثقيل.
الخطوة 2: افتح النموذج. انتقل إلى Sync Lipsync 2 Pro على PicassoIA وانقر على "Try Now" لفتح الواجهة.
الخطوة 3: ارفع الفيديو. استخدم حقل رفع الفيديو لتزويد المادة المصدر. يقبل النموذج صيغ MP4 وMOV وWebM. تُعالَج المقاطع التي تقل مدتها عن 3 دقائق بسرعة وموثوقية أكبر في المحاولة الأولى.
الخطوة 4: ارفع الصوت. في حقل إدخال الصوت، زوّد ملف الكلام المستهدف. تعمل صيغ MP3 وWAV وM4A جميعها. ينبغي أن تقارب مدة الصوت طول الفيديو للحصول على أنظف مخرج مركّب.
الخطوة 5: اضبط قوة المزامنة. تعرض معظم الواجهات معلمة لقوة المزامنة أو شدتها. ابدأ بالقيمة 0.8 كخط أساس. تنتج القيم الأعلى مزامنة أكثر إحكامًا لكنها قد تُدخل عيوبًا في الملمس عند الانفتاحات القصوى للفم. أما القيم الأدنى فتمزج قدرًا أكبر من حركة الفم الأصلية في النتيجة، وهذا مفيد عندما يكون الصوت البديل قريبًا جدًا من الأصلي.
الخطوة 6: ولّد وراجع. تستغرق المعالجة عادةً من 30 إلى 90 ثانية حسب طول المقطع. عند مراجعة المخرج، ركّز أولًا على الحروف الوقفية (/b/ و/p/ و/m/) والأصوات الصفيرية (/s/ و/z/)، لأنها أكثر فئات الفونيمات تميزًا بصريًا، وهي المواضع التي يصبح فيها سوء المحاذاة أكثر وضوحًا للمشاهد.
الخطوة 7: كرّر عند الحاجة. إذا بدت أقسام محددة غير صحيحة، فدوّن الطوابع الزمنية الدقيقة وأعد التشغيل مع تعديل طفيف في قوة المزامنة. وبالنسبة إلى المشاريع الاحترافية، يُعد تمريرًا ثانيًا على المقاطع المُعلَّم عليها بأعلى إعدادات الجودة ممارسة قياسية، ولا يضيف إلا قدرًا يسيرًا من وقت المعالجة الإضافي.
💡 الصوت النظيف هو العامل الأكبر منفردًا في جودة المخرج النهائية. فالضجيج والصدى وعيوب الضغط الثقيل تُضعف دقة اكتشاف الفونيمات قبل أن تبدأ مرحلة التركيب أصلًا. عالج صوتك مسبقًا بتمرير لإزالة الضجيج إذا كانت بيئة التسجيل غير مثالية.
أين لا تزال التقنية تتعثر
تحسّن تزامن الشفاه بالذكاء الاصطناعي بشكل كبير خلال العامين الماضيين، لكن سيناريوهات محددة ما زالت تكشف قيودًا حقيقية تستحق المعرفة قبل الالتزام بسير عمل معيّن.
زوايا الرأس المتطرفة لا تزال مشكلة لمعظم النماذج الحالية. فعندما يدير المتحدث رأسه أكثر من 40 إلى 45 درجة بعيدًا عن وضعية مواجهة الكاميرا، يتدهور رصد النقاط المرجعية للوجه، ولا تعود رقعة الفم المركّبة تتوافق بنظافة مع هندسة الخد والفك عند حواف الوجه. ويتفادى معظم المحتوى الاحترافي ذلك عبر اختيار اللقطات.
الكلام السريع يطرح تحديات زمنية، لأن المتحدثين السريعين ينتجون انتقالات فونيمية في أقل من 50 ملّي ثانية، وقد تقع هذه الانتقالات بين إطارات الفيديو عند 24 إطارًا في الثانية. قد يُتخطى بعض الفونيمات أو يُمَوَّه زمنيًا في المخرجات، مما ينتج أخطاء نطق طفيفة في أسرع المقاطع.
اللهجات غير المعتادة والنبرات الصوتية الخاصة تكشف فجوات في بيانات التدريب. فالنماذج المدرّبة في معظمها على الإنجليزية الأمريكية أو البريطانية القياسية ما زالت تُظهر تراجعًا في الجودة مع توزيعات الفونيمات الخاصة باللغات الأخرى واللهجات الإقليمية. وهذه الفجوة تضيق مع توسّع مجموعات بيانات التدريب عالميًا، لكنها تبقى فجوة جودة ملحوظة للكلام غير القياسي.
الحروف المتحركة الواسعة وظهور الأسنان تبقى مصدرًا شائعًا للعيوب. فعندما يُفتح الفم بأقصى انفتاح، يجب على الذكاء الاصطناعي أن يولّد في آنٍ واحد منظرًا مقنعًا للأسنان العلوية والسفلية، ووضعية اللسان، والتجويف الفموي بعمقه. وهذه منطقة عالية التباين لا تزال النماذج التوليدية تسيء تصييرها أحيانًا، فتُنتج أشكالًا للأسنان مختلفة قليلًا أو مواضع لسان غير طبيعية.
هل أنت مستعد لمزامنة أول فيديو لك؟
قد تكون آليات تزامن الشفاه بالذكاء الاصطناعي معقدة، لكن استخدام الأدوات المبنية عليها لا يجب أن يكون كذلك. يجرّد كل نموذج على PicassoIA خط التحليل الصوتي وتتبع النقاط المرجعية والتصيير العصبي في واجهة بسيطة من رفعين: فيديوك، وصوتك، وزر.
إذا كان لديك مادة مصوّرة تحتاج إلى دبلجة بلغة أخرى، أو أفاتار يحتاج إلى إلقاء نص، أو عرض تقديمي سُجّل صوته بشكل منفصل عن الفيديو، أو مقطع على وسائل التواصل الاجتماعي يحتاج إلى إعادة ترجمة لجمهور جديد، فهناك نموذج على PicassoIA مصمم لهذه الحالة بالتحديد.
ابدأ مع Sync Lipsync 2 Pro للحصول على أعلى جودة في النتائج على المادة المصوّرة الموجودة مع مسار صوتي منفصل. وجرّب ByteDance Omni Human 1.5 إذا أردت تحريك صورة فوتوغرافية واحدة لتصبح فيديو متحدثًا كاملًا دون أي مادة مصدر. واستخدم HeyGen Video Translate عندما يكون الهدف الدبلجة إلى لغة جديدة مع حركة فم متطابقة بدقة عبر 150 لغة مستهدفة أو أكثر.
فجوة الصوت والفم التي جعلت المحتوى المدبلج مزعجًا لعقود صارت الآن مشكلة قابلة للحل بالأدوات المناسبة. ارفع ملفاتك وشاهد مدى دقة محاذاة الاثنين.


