डब किए गए वीडियो में दशकों से सिंक्रनाइज़ेशन की समस्या रही है। मुँह चलता है, शब्द निकलते हैं, और किसी तरह दोनों कभी पूरी तरह मेल नहीं खाते। यह आपको विदेशी फ़िल्मों में, कॉर्पोरेट ट्रेनिंग वीडियो में, और उन सोशल मीडिया कंटेंट में दिखता है जिनमें शूटिंग के बाद ऑडियो बदल दिया गया था। होंठ एक कहानी कहते हैं, आवाज़ दूसरी, और आपका दिमाग यह अंतर तुरंत पकड़ लेता है, भले ही आप सटीक खामी का नाम न बता सकें।
AI लिपसिंक इस समस्या को पिक्सल के स्तर पर सुलझाता है, पोस्ट-प्रोडक्शन के अंदाज़े से नहीं। यह मिसमैच छिपाने के लिए क्लिप काटने या ऑडियो ऑफ़सेट को 200 मिलीसेकंड खिसकाने की बात नहीं है। यह इस बात को समझने की बात है कि व्यक्ति जो हर ध्वनि निकालता है, उस ध्वनि के लिए मुँह का सटीक आकार क्या होना चाहिए, और फिर मुँह का एक नया संस्करण इस तरह रेंडर करना कि वह ऑडियो के साथ फ़्रेम-दर-फ़्रेम चले और कोई दिखने वाली सिलाई न रहे।
यह ठीक-ठीक ऐसे काम करता है।
डब किए गए वीडियो गलत क्यों लगते हैं
मानव दिमाग़ आवाज़ और चेहरे के मिसमैच को बारीकी से पकड़ने के लिए विकसित हुआ है। ऑडियोविज़ुअल स्पीच पर्सेप्शन के शोध, जो McGurk Effect से जुड़े काम पर आधारित है, दिखाते हैं कि हम ध्वनि और होंठों की हरकत को अलग-अलग धाराओं की तरह नहीं, बल्कि एक साथ प्रोसेस करते हैं। जब ये केवल 80 से 100 मिलीसेकंड भी अलग हो जाते हैं, तो बिना सचेत ध्यान दिए भी मिसमैच "गड़बड़" के रूप में दर्ज हो जाता है।
पारंपरिक डबिंग वर्कफ़्लो संवाद का अनुवाद करते हैं, कलाकारों के साथ ऑडियो दोबारा रिकॉर्ड करते हैं, और फिर क्रिएटिव एडिटिंग के ज़रिए नए ऑडियो को मौजूदा मुँह की हरकत से मिलाने की कोशिश करते हैं। नतीजे पूरी तरह इस पर निर्भर करते हैं कि मूल कलाकार का मुँह उस समय क्या कर रहा था। फ़ुटेज को बदलने का कोई तरीका नहीं होता, इसलिए हर वह अक्षर जो फ़िट नहीं होता, कट या रिएक्शन शॉट से ढक दिया जाता है।
AI लिपसिंक इसका उल्टा करता है। यह ऑडियो को ग्राउंड ट्रुथ मानकर शुरू करता है और उससे मेल खाती नई मुँह की हरकत जनरेट करता है, चाहे मूल वक्ता कुछ भी कर रहा हो। वीडियो की पहचान बनी रहती है। संदर्भ बना रहता है। केवल मुँह बदलता है।
💡 खराब डब किए गए कंटेंट और प्रोफ़ेशनल तरीके से सिंक किए गए कंटेंट के बीच का फ़र्क तेज़ी से कम हो रहा है। जो काम पूरी स्टूडियो पोस्ट-प्रोडक्शन टीम को एक हफ़्ते में करना पड़ता था, वह सही टूल्स के साथ अब कुछ मिनटों में हो जाता है।
AI आपकी आवाज़ कैसे पढ़ता है
वेवफ़ॉर्म से फ़ोनीम तक: पहला चरण
मुँह चलने से पहले, AI को यह समझना होता है कि कौन-सी ध्वनियाँ निकल रही हैं। रॉ ऑडियो एक वेवफ़ॉर्म के रूप में आता है: हवा के दबाव में बदलावों का एक टाइम-सीरीज़ प्रतिनिधित्व, जो मानक ऑडियो में प्रति सेकंड 44,100 सैंपल पर कैप्चर होता है। यह वेवफ़ॉर्म लिपसिंक के लिए सीधे उपयोगी नहीं होता। एक ही एम्प्लिट्यूड पीक कोई भी ध्वनि हो सकता है।
सिस्टम वेवफ़ॉर्म को एक स्पीच रिकॉग्निशन पाइपलाइन से गुज़ारता है जो फ़ोनीम पहचानती है: किसी भाषा में ध्वनि की सबसे छोटी अलग इकाइयाँ। अंग्रेज़ी में लगभग 44 फ़ोनीम हैं। हर शब्द इनके क्रम में टूटता है। शब्द "mouth" में चार अलग फ़ोनीम हैं: /m/, /aʊ/, /θ/। हर फ़ोनीम का चेहरे पर एक भौतिक संबंध होता है, यानी होंठ, जीभ, दाँत और जबड़ा मिलकर उस खास ध्वनि के लिए जो आकार बनाते हैं।
ऑडियो को फ़ोनीम से मैप करने को फ़ोर्स्ड अलाइनमेंट कहा जाता है। आधुनिक सिस्टम ट्रांसफ़ॉर्मर-आधारित एकॉस्टिक मॉडल का उपयोग करते हैं, जो हज़ारों घंटे की ट्रांसक्राइब की गई स्पीच पर प्रशिक्षित होते हैं, ताकि यह फ़्रेम-स्तर की सटीकता के साथ हो। अक्सर यह 10 से 15 मिलीसेकंड के भीतर सटीक होता है।
मेल स्पेक्ट्रोग्राम और ऑडियो फ़िंगरप्रिंट
ज़्यादातर लिपसिंक मॉडल रॉ वेवफ़ॉर्म के साथ नहीं, बल्कि मेल स्पेक्ट्रोग्राम के साथ काम करते हैं: ऑडियो के 2D प्रतिनिधित्व, जिसमें क्षैतिज अक्ष समय है, ऊर्ध्वाधर अक्ष मेल स्केल पर आवृत्ति है (जो मानव सुनने की क्षमता का अनुमान लगाता है), और पिक्सल की चमक हर टाइम-फ़्रीक्वेंसी बिंदु पर ऊर्जा की तीव्रता दिखाती है।
मेल स्पेक्ट्रोग्राम न्यूरल नेटवर्क को ऑडियो सिग्नल का ज़्यादा समृद्ध और स्थानिक रूप से सुसंगत दृश्य देते हैं। नेटवर्क यह देखता है कि ध्वनियाँ कब होती हैं, और यह भी कि वे एक-दूसरे में कैसे बदलती हैं, जैसे एक फ़ोनीम दूसरे में जाते हुए फ़ॉर्मेंट कैसे खिसकते हैं, और पूरे क्लिप में बोलने की प्रोसोडी और लय कैसी दिखती है। यह एकॉस्टिक प्रतिनिधित्व पूरे सिंथेसिस के दौरान लिपसिंक मॉडल को उसके मुख्य कंडीशनिंग सिग्नल के रूप में दिया जाता है।
मुँह को फ़्रेम-दर-फ़्रेम पहचानना
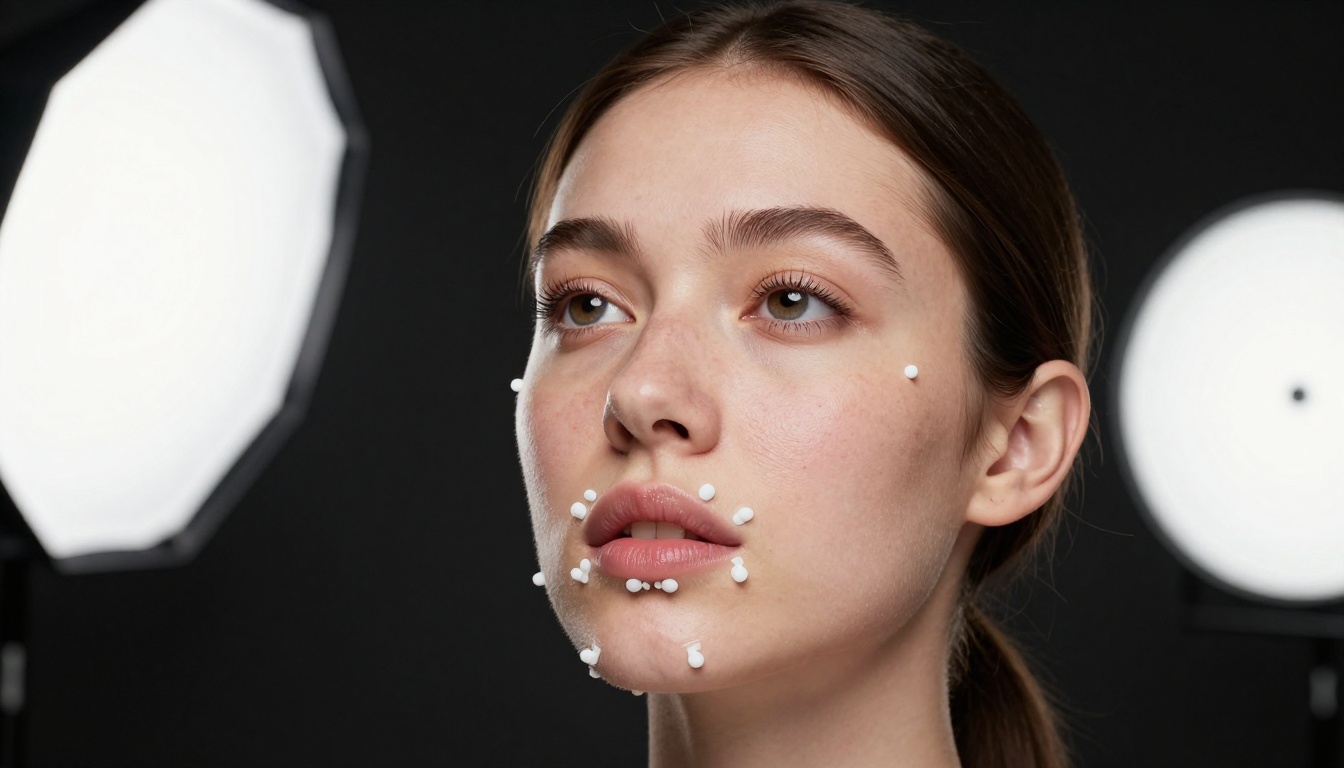
AI मुँह को बदलने से पहले उसे यह बिल्कुल जानना होता है कि वह हर फ़्रेम में कहाँ है और इस समय क्या कर रहा है। यह होंठों के क्षेत्र के चारों ओर केवल बाउंडिंग बॉक्स खींचने से कहीं आगे की बात है।
फ़ेशियल लैंडमार्क ग्रिड
अत्याधुनिक लिपसिंक सिस्टम फ़ेशियल लैंडमार्क डिटेक्टर का उपयोग करते हैं, जो मॉडल आर्किटेक्चर के आधार पर चेहरे पर 68 से 478 सटीक बिंदु पहचानते हैं। ये बिंदु मुँह के क्षेत्र में घनी तरह जमा होते हैं: होंठों के कोने, व्हर्मिलियन बॉर्डर, क्यूपिड्स बो, फ़िलट्रम, दाँतों के बीच की जगहें, और ठुड्डी की रेखा, इन सबको हर फ़्रेम पर अलग-अलग कोऑर्डिनेट ट्रैकिंग मिलती है।
ये लैंडमार्क बड़े एनोटेटेड चेहरे के डेटासेट पर प्रशिक्षित कन्वोल्यूशनल न्यूरल नेटवर्क का उपयोग करके हर फ़्रेम के लिए अनुमानित किए जाते हैं। परिणाम एक प्रति-फ़्रेम 3D मेश ओवरले है, जो व्यक्ति के थोड़ा मुड़ने, भाव बदलने या फ़्रेम में चलने पर भी चेहरे की ज्यामिति को उच्च सटीकता से मैप करता है। यह मेश स्पेशियल एंकर बनता है, जो सिंथेसिस स्टेज को हर पल बताता है कि नया मुँह चेहरे में ठीक कहाँ बैठना चाहिए।
जबड़ा, होंठ का कोना और दाँत ट्रैकिंग
लिपसिंक के लिए खासतौर पर मुँह के कई अलग-अलग हिस्सों की सटीक ट्रैकिंग चाहिए, जो स्वतंत्र रूप से चलते हैं:
- होंठों का खुलाव: हर फ़्रेम पर मुँह कितना खुला या बंद है, ऊर्ध्वाधर रूप से
- होंठ के कोने की स्थिति: मुँह बगल में खिंचा है या अंदर की ओर ढीला है
- ऊपर और नीचे के दाँतों की दृश्यता: /s/ और /f/ जैसे फ़्रिकेटिव और सिबिलेंट के लिए महत्वपूर्ण
- जबड़े का विस्थापन: होंठ के आकार से अलग, निचले जबड़े की ऊर्ध्वाधर गति
- जीभ की स्थिति: कम ही मॉडल की जाती है, लेकिन नए जनरेशन सिस्टम में तेज़ी से शामिल हो रही है
यह प्रति-फ़्रेम मोशन डेटा एक ज्यामितीय संदर्भ बनाता है, जिसे सिंथेसिस स्टेज नए मुँह को रेंडर करने के लिए शुरुआती ढाँचे के रूप में उपयोग करता है। इस ट्रैकिंग परत के बिना, सिंथेसाइज़ किए गए मुँह कुछ ही सेकंड में चेहरे से खिसक जाते हैं।
नई मुँह की हरकत को सिंथेसाइज़ करना
जब सिस्टम को लक्ष्य ध्वनियों और मौजूदा चेहरे की ज्यामिति दोनों का पता चल जाता है, तो उसे मुँह का एक नया क्षेत्र जनरेट करना होता है, जो हर फ़्रेम पर हर फ़ोनीम के लिए सही उच्चारण दिखाए और मूल व्यक्ति की दिखावट से मेल खाए।
वाइज़ीम मैपिंग
वाइज़ीम फ़ोनीम के दृश्य समकक्ष हैं। अंग्रेज़ी में 44 फ़ोनीम होते हैं, लेकिन वे जो दिखने वाले मुँह के आकार बनाते हैं, वे लगभग 14 से 21 अलग-अलग वाइज़ीम श्रेणियों में सिमट जाते हैं। कई फ़ोनीम जो ध्वनिक रूप से अलग हैं, सामने से देखने पर होंठों पर एक जैसे दिखते हैं। /p/, /b/ और /m/ सभी बंद होंठों वाला वाइज़ीम बनाते हैं, इसीलिए बिना ऑडियो के होंठ पढ़ते समय ये आसानी से भ्रमित होते हैं।
लिपसिंक AI की पहली पीढ़ी स्पष्ट वाइज़ीम लुकअप टेबल पर काम करती थी: फ़ोनीम पहचाना जाता था, संग्रहीत मुँह की संबंधित इमेज निकाली जाती थी, और उसे फ़्रेम में मिला दिया जाता था। नतीजे रोबोटिक थे, ट्रांज़िशन अप्राकृतिक थे, और उनमें वक्ता की पहचान या संदर्भ के अनुसार कोई अनुकूलन नहीं था।
आधुनिक सिस्टम उस टेबल की जगह लर्न्ड मैपिंग का उपयोग करते हैं: एक न्यूरल नेटवर्क जो लाखों सिंक्रनाइज़्ड ऑडियो-वीडियो जोड़ों पर प्रशिक्षित होता है और हर ध्वनि के लिए, हर संदर्भ, लहजे और वक्ता प्रोफ़ाइल में मुँह कैसे चलते हैं, इसका पूरा सांख्यिकीय वितरण आत्मसात कर चुका होता है।
न्यूरल रेंडरिंग और टेक्सचर मैचिंग
सिंथेसिस स्टेप एक जनरेटिव मॉडल (आमतौर पर GAN या डिफ़्यूज़न-आधारित आर्किटेक्चर) का उपयोग करता है, जो एक साथ तीन इनपुट लेता है:
- लक्ष्य ऑडियो फ़ीचर, जो समय के इस पल से मेल खाते मेल स्पेक्ट्रोग्राम स्लाइस से एन्कोड किए जाते हैं
- संदर्भ चेहरे की पहचान, जो इनपुट वीडियो से फ़ीचर एम्बेडिंग के रूप में निकाली जाती है
- मौजूदा फ़्रेम की चेहरे की ज्यामिति, जो लैंडमार्क ट्रैकर से मिलती है
आउटपुट एक नया मुँह का क्षेत्र है: वीडियो का एक सिंथेसाइज़ किया हुआ पैच, जो उस ऑडियो स्लाइस के लिए सही मुँह की हरकत दिखाता है, और मूल व्यक्ति की त्वचा की शैली और बनावट में, मूल फ़ुटेज की मूल रोशनी की स्थितियों के तहत रेंडर होता है।
मुख्य चुनौती टेक्सचर की एकरूपता है। सिंथेसाइज़ किया गया मुँह का पैच आसपास की त्वचा के रंग, मौजूदा रोशनी की दिशा और गुणवत्ता, त्वचा के दाने और रोमछिद्रों की बनावट, और मूल फ़्रेम में मौजूद किसी भी मोशन ब्लर से मेल खाना चाहिए। सबसे अच्छे मॉडल इसके लिए आइडेंटिटी एन्कोडर इस्तेमाल करते हैं, जो मूल चेहरे से हाई-डाइमेंशनल फ़ीचर एम्बेडिंग निकालते हैं और पूरे सिंथेसिस पास में रेंडरर को उसी पर कंडीशन करते हैं।
| घटक | कार्य | यह क्यों मायने रखता है |
|---|
| एकॉस्टिक एन्कोडर | ऑडियो स्लाइस को फ़ीचर वेक्टर में बदलता है | हर फ़्रेम के लिए सही मुँह का आकार तय करता है |
| आइडेंटिटी एन्कोडर | वक्ता की दृश्य दिखावट को कैप्चर करता है | व्यक्ति कैसा दिखता है, यह बनाए रखता है |
| लैंडमार्क ट्रैकर | हर फ़्रेम पर चेहरे की ज्यामिति मैप करता है | सिंथेसाइज़ किए गए मुँह को सही जगह पर टिकाता है |
| न्यूरल रेंडरर | नए मुँह के क्षेत्र को सिंथेसाइज़ करता है | फ़ोटोरियलिस्टिक आउटपुट बनाता है |
| टेम्पोरल स्मूदर | फ़्रेम-से-फ़्रेम झिलमिलाहट हटाता है | फ़्लिकरिंग और मोशन आर्टिफ़ैक्ट रोकता है |
टेम्पोरल एलाइनमेंट: सबसे कठिन हिस्सा
एक फ़्रेम को सही दिखाना हल करने योग्य समस्या है। 30 फ़्रेम प्रति सेकंड को सही दिखाना, स्मूथ मोशन में, बिना झिलमिलाहट या क्लिप की पूरी लंबाई में पहचान के बहाव के, वहीं है जहाँ ज़्यादातर लिपसिंक सिस्टम अपनी असली सीमाएँ दिखा देते हैं।
फ़्रेम रेट का मिसमैच
ऑडियो निरंतर समय में मौजूद होता है। वीडियो अलग-अलग फ़्रेम में मौजूद होता है। जब ऑडियो कहता है कि 1.033 सेकंड पर मुँह एक खास खुलाव की स्थिति में होना चाहिए, तो निकटतम वीडियो फ़्रेम 1.033 सेकंड (30fps) पर हो सकता है या 1.025 सेकंड (40fps) पर। यह छोटा अंतर लंबी क्लिप में जुड़ता जाता है और सूक्ष्म लेकिन दिखने वाला टाइमिंग ड्रिफ़्ट पैदा करता है।
उन्नत सिस्टम इसे सब-फ़्रेम इंटरपोलेशन से संभालते हैं: रेंडर किए गए फ़्रेम के बीच मध्यवर्ती मुँह की अवस्थाएँ जनरेट करते हैं और उन्हें उपयुक्त मोशन ब्लर के साथ कंपोज़ करते हैं, ताकि स्मूथ, भौतिक रूप से निरंतर गति का आभास हो जो फ़्रेम की सीमाओं पर अटके नहीं।
पहचान को बनाए रखना
आइडेंटिटी ड्रिफ़्ट एक सूक्ष्म लेकिन महत्वपूर्ण विफलता मोड है, जो लंबी क्लिप में दिखता है। न्यूरल-रेंडर किए गए मुँह के कुछ सेकंड के पैच के बाद, चेहरा मूल से हल्का अलग दिखने लगता है: त्वचा का रंग थोड़ा गर्म, दाँत थोड़े सफ़ेद, होंठ की रेखा थोड़ी बदली हुई। छोटी-छोटी फ़्रेम-स्तर की गलतियाँ समय के साथ जुड़कर दिखने वाला विचलन बन जाती हैं।
सबसे अच्छे मौजूदा मॉडल ट्रेनिंग के दौरान पर्सेप्चुअल आइडेंटिटी लॉस फ़ंक्शन लागू करते हैं, जो फ़्रेम के बैच में मूल पहचान से किसी भी विचलन को दंडित करता है। इनफ़रेंस के समय वे आवधिक रीअलाइनमेंट भी लागू करते हैं, जो हर रेंडर किए गए पैच की तुलना स्रोत आइडेंटिटी एम्बेडिंग से करता है और उसे मूल दिखावट की ओर धीरे से वापस ले जाता है।
💡 टेम्पोरल कंसिस्टेंसी ही कंज़्यूमर-ग्रेड लिपसिंक को प्रोफ़ेशनल नतीजों से अलग करती है। यह फ़र्क अक्सर एक स्थिर फ़्रेम में दिखता ही नहीं, लेकिन वीडियो पूरी स्पीड से चलते ही तुरंत साफ़ हो जाता है।
रियल-टाइम बनाम पोस्ट-प्रोडक्शन लिपसिंक
AI लिपसिंक के लिए दो अलग डिप्लॉयमेंट संदर्भ हैं, और इनमें क्वालिटी और स्पीड के बीच मौलिक रूप से अलग तकनीकी समझौते शामिल हैं।
रियल-टाइम लिपसिंक लाइव स्ट्रीम, वीडियो कॉल या इंटरैक्टिव सेशन के दौरान चलता है। इसे ऑडियो प्रोसेस करना और संशोधित वीडियो आउटपुट रेंडर करना होता है, वह भी 100 मिलीसेकंड से कम एंड-टू-एंड लेटेंसी में, अक्सर बिना समर्पित GPU संसाधनों के कंज़्यूमर-ग्रेड हार्डवेयर पर। इस बाधा को पूरा करने के लिए रियल-टाइम सिस्टम छोटे मॉडल आर्किटेक्चर, कम रिज़ॉल्यूशन वाले मुँह के क्षेत्र, और आक्रामक टेम्पोरल स्मूदिंग का उपयोग करते हैं, जो गति के बदले कुछ सटीकता की हानि स्वीकार करती है। मुख्य उपयोग लाइव वर्चुअल अवतार, इंटरैक्टिव गेम कैरेक्टर और वर्चुअल प्रेज़ेंटर पाइपलाइन हैं।
पोस्ट-प्रोडक्शन लिपसिंक पहले से रिकॉर्ड किए गए कंटेंट पर ऑफ़लाइन चलता है। लेटेंसी का कोई महत्व नहीं होता। सिस्टम कहीं बड़े मॉडल इस्तेमाल कर सकता है, किसी भी आर्टिफ़ैक्ट वाले सेगमेंट पर कई पास चला सकता है, पूरे रिज़ॉल्यूशन पर बार-बार रिफ़ाइनमेंट लागू कर सकता है, और सबसे अच्छा आउटपुट बनाने के लिए जितना ज़रूरी हो उतना समय ले सकता है। यह मोड प्रोफ़ेशनल फ़िल्म डबिंग, कॉर्पोरेट वीडियो लोकलाइज़ेशन और हाई-क्वालिटी सोशल कंटेंट बनाने में इस्तेमाल होता है।
PicassoIA पर उपलब्ध ज़्यादातर मॉडल पोस्ट-प्रोडक्शन मोड में चलते हैं, जिसका मतलब है कि उनकी क्वालिटी की सीमा उस स्तर से काफ़ी ऊँची है जो आपको कंज़्यूमर लाइव अवतार ऐप्स में मिलती है।
PicassoIA पर सबसे अच्छे लिपसिंक मॉडल
PicassoIA पर 12 लिपसिंक मॉडल उपलब्ध हैं, जो अलग-अलग प्रोवाइडर, क्वालिटी स्तर और खास उपयोग के मामलों को कवर करते हैं। हर परिदृश्य के लिए जानने लायक प्रमुख मॉडल यहाँ हैं।
Sync Lipsync 2 Pro
Sync Lipsync 2 Pro Sync का प्रीमियम ऑफ़र है, जो बाज़ार के सबसे तकनीकी रूप से केंद्रित लिपसिंक प्रोवाइडरों में से एक है। यह कठिन उच्चारण मामलों को संभालता है, जिनमें चौड़े खुले स्वरों पर दाँतों की दृश्यता, पार्श्व व्यंजन और तेज़ फ़ोनीम ट्रांज़िशन शामिल हैं, जो कम परिष्कृत मॉडलों को गड़बड़ा देते हैं। पूरे रिज़ॉल्यूशन पर आउटपुट क्वालिटी ब्रॉडकास्ट-रेडी है और टाइट क्लोज़-अप फ़ेस फ़ुटेज पर अच्छी तरह टिकती है, जहाँ कोई भी आर्टिफ़ैक्ट तुरंत दिख जाता है।
HeyGen Lipsync Precision
HeyGen Lipsync Precision सिंथेसिस शुरू होने से पहले इनपुट ऑडियो पर गहरा फ़ोनीम विश्लेषण चलाता है, जिससे पूरी क्लिप में टेम्पोरल एलाइनमेंट असामान्य रूप से कसा हुआ रहता है। यह वॉइसओवर-से-चेहरे सिंक के लिए खास तौर पर मज़बूत है, जहाँ बदला गया ऑडियो अलग से रिकॉर्ड किया गया था और मूल वीडियो से उसका कोई अंतर्निहित टाइमिंग संबंध नहीं है।
Kling Lip Sync
Kling Lip Sync Kwaivgi से है, और यह लिपसिंक को एक बड़े वीडियो समझ पाइपलाइन के हिस्से के रूप में लागू करता है, जो पूरे शरीर के संदर्भ को मॉडल करती है। यह केवल मुँह-क्षेत्र वाले सिस्टम की तुलना में सिर की हरकत और माहौल को बेहतर संभालता है, इसलिए उस फ़ुटेज के लिए सही विकल्प है जहाँ वक्ता डिलीवरी के दौरान सक्रिय रूप से चल रहा हो, न कि सीधे कैमरे से बात कर रहा हो।
ByteDance Omni Human 1.5
ByteDance Omni Human 1.5 केवल ऑडियो इनपुट का उपयोग करके एक स्थिर फ़ोटो को पूरे टॉकिंग वीडियो में एनिमेट करता है। यह मौजूदा फ़ुटेज को सिंक करने से कठिन समस्या है, क्योंकि मॉडल को बिना किसी मोशन रेफ़रेंस के शुरू से प्राकृतिक सिर की हरकत, पलक झपकना और माइक्रो-एक्सप्रेशन भी जनरेट करने होते हैं। फ़ोटो-से-वीडियो पाइपलाइन के लिए नतीजे असामान्य रूप से प्राकृतिक हैं और अवतार व प्रेज़ेंटर बनाने के वर्कफ़्लो में अच्छी तरह काम करते हैं।
प्लेटफ़ॉर्म पर उपलब्ध अन्य मज़बूत विकल्पों में शामिल हैं Sync Lipsync 2, जो Pro टियर से थोड़ा नीचे उच्च-गुणवत्ता वाले सिंक के लिए है, HeyGen Lipsync Speed, जब प्रोसेसिंग समय प्राथमिकता हो, Pixverse Lipsync, तुरंत ऑडियो-से-वीडियो सिंक के लिए, VEED Fabric 1.0, फ़ोटो को बोलने वाला बनाने के लिए, Sync React 1, मौजूदा फ़ुटेज में यथार्थवादी जोड़ के लिए, और HeyGen Video Translate, जब लक्ष्य 150 या उससे ज़्यादा भाषाओं में बहुभाषी डबिंग हो। स्थिर इमेज से शुरू होने वाले पूरी तरह एनिमेटेड टॉकिंग अवतार के लिए, P Video Avatar और ByteDance Omni Human इस संग्रह को पूरा करते हैं।
PicassoIA पर Lipsync 2 Pro कैसे इस्तेमाल करें
मौजूदा फ़ुटेज पर प्रोफ़ेशनल नतीजों के लिए Sync Lipsync 2 Pro सुझाया गया शुरुआती विकल्प है। शुरू से अंत तक इसे चलाने का सटीक तरीका यहाँ है।
चरण 1: अपनी फ़ाइलें तैयार करें। आपको दो फ़ाइलों की ज़रूरत है: उस व्यक्ति का वीडियो जिसका मुँह सिंक करना है, और लक्ष्य स्पीच वाली ऑडियो फ़ाइल। वीडियो कम से कम 720p का होना चाहिए, जिसमें वक्ता का साफ़ सामने का दृश्य हो। ऑडियो साफ़ होना चाहिए, जिसमें बैकग्राउंड नॉइज़, रीवर्ब या भारी डायनामिक कंप्रेशन कम से कम हो।
चरण 2: मॉडल खोलें। PicassoIA पर Sync Lipsync 2 Pro पर जाएँ और इंटरफ़ेस खोलने के लिए "Try Now" पर क्लिक करें।
चरण 3: वीडियो अपलोड करें। अपना सोर्स फ़ुटेज देने के लिए वीडियो अपलोड फ़ील्ड का उपयोग करें। मॉडल MP4, MOV और WebM फ़ॉर्मेट स्वीकार करता है। 3 मिनट से छोटी क्लिप पहले पास में सबसे तेज़ और सबसे भरोसेमंद तरीके से प्रोसेस होती हैं।
चरण 4: ऑडियो अपलोड करें। ऑडियो इनपुट फ़ील्ड में अपनी लक्ष्य स्पीच फ़ाइल दें। MP3, WAV और M4A तीनों काम करते हैं। सबसे साफ़ कंपोज़िट आउटपुट के लिए ऑडियो की अवधि लगभग वीडियो की लंबाई जितनी होनी चाहिए।
चरण 5: सिंक स्ट्रेंथ सेट करें। ज़्यादातर इंटरफ़ेस में सिंक स्ट्रेंथ या इंटेंसिटी पैरामीटर होता है। बेसलाइन के रूप में 0.8 से शुरू करें। ज़्यादा वैल्यू तंग सिंक देती है, लेकिन अत्यधिक मुँह के खुलाव पर कभी-कभी टेक्सचर आर्टिफ़ैक्ट ला सकती है। कम वैल्यू नतीजे में मूल मुँह की ज़्यादा हरकत मिला देती है, जो तब मदद करता है जब बदला गया ऑडियो मूल से काफ़ी मिलता-जुलता हो।
चरण 6: जनरेट करें और समीक्षा करें। क्लिप की लंबाई के हिसाब से प्रोसेसिंग में आमतौर पर 30 से 90 सेकंड लगते हैं। आउटपुट की समीक्षा करते समय पहले स्टॉप कंसोनेंट (/b/, /p/, /m/) और सिबिलेंट (/s/, /z/) पर ध्यान दें, क्योंकि ये सबसे अलग दिखने वाली फ़ोनीम श्रेणियाँ हैं और वे जगहें हैं जहाँ दर्शक को गलत एलाइनमेंट सबसे साफ़ दिखता है।
चरण 7: ज़रूरत हो तो दोहराएँ। अगर कुछ खास हिस्से गड़बड़ लगें, तो सटीक टाइमस्टैम्प नोट करें और सिंक स्ट्रेंथ को थोड़ा बदलकर दोबारा चलाएँ। प्रोफ़ेशनल प्रोजेक्ट्स के लिए, चिह्नित सेगमेंट पर अधिकतम क्वालिटी सेटिंग्स के साथ दूसरा पास लगाना आम तरीका है, और इसमें प्रोसेसिंग का समय बस थोड़ा और लगता है।
💡 अंतिम आउटपुट क्वालिटी का सबसे बड़ा अकेला कारक साफ़ ऑडियो है। शोर, रीवर्ब और भारी कंप्रेशन आर्टिफ़ैक्ट फ़ोनीम डिटेक्शन की सटीकता को सिंथेसिस स्टेज शुरू होने से पहले ही बिगाड़ देते हैं। अगर रिकॉर्डिंग का माहौल आदर्श नहीं था, तो ऑडियो को नॉइज़ रिडक्शन पास के साथ पहले से प्रोसेस करें।
जहाँ तकनीक अब भी संघर्ष करती है
पिछले दो सालों में AI लिपसिंक में नाटकीय सुधार हुआ है, लेकिन कुछ खास परिस्थितियाँ अब भी वास्तविक सीमाएँ उजागर करती हैं, जिन्हें किसी वर्कफ़्लो पर निर्भर होने से पहले जानना ज़रूरी है।
अत्यधिक सिर के कोण लगभग सभी मौजूदा मॉडलों के लिए समस्याग्रस्त बने हुए हैं। जब वक्ता कैमरे की ओर मुँह किए हुए स्थिति से 40 से 45 डिग्री से ज़्यादा मुड़ता है, तो फ़ेशियल लैंडमार्क डिटेक्शन कमज़ोर पड़ जाता है और सिंथेसाइज़ किया गया मुँह का पैच चेहरे के किनारों पर गाल और जबड़े की ज्यामिति से साफ़ तौर पर मेल नहीं खाता। ज़्यादातर प्रोफ़ेशनल कंटेंट शॉट के चुनाव से इससे बचता है।
हाई-स्पीड स्पीच टाइमिंग की चुनौतियाँ पेश करती है, क्योंकि तेज़ बोलने वाले फ़ोनीम ट्रांज़िशन 50 मिलीसेकंड से कम में करते हैं, जो 24fps पर वीडियो फ़्रेम के बीच गिर सकते हैं। कुछ फ़ोनीम आउटपुट में छूट जाते हैं या टेम्पोरली धुंधले हो जाते हैं, जिससे सबसे तेज़ अक्षरों पर सूक्ष्म उच्चारण त्रुटियाँ होती हैं।
असामान्य लहजे और स्वर की बनावट ट्रेनिंग डेटा की कमियाँ उजागर करते हैं। मुख्य रूप से स्टैंडर्ड अमेरिकन या ब्रिटिश अंग्रेज़ी पर प्रशिक्षित मॉडल अब भी दूसरी भाषाओं और क्षेत्रीय बोलियों के खास फ़ोनीम वितरण पर क्वालिटी में गिरावट दिखाते हैं। जैसे-जैसे ट्रेनिंग डेटासेट दुनियाभर में फैल रहे हैं, यह अंतर कम हो रहा है, लेकिन गैर-मानक स्पीच के लिए यह अब भी एक दिखने वाला क्वालिटी अंतर है।
चौड़े खुले स्वर और दाँतों की दृश्यता आर्टिफ़ैक्ट का आम स्रोत बने हुए हैं। जब मुँह पूरी तरह खुलता है, तो AI को एक साथ ऊपर और नीचे के दाँतों, जीभ की स्थिति और गहराई में मुँह की गुहा का विश्वसनीय दृश्य सिंथेसाइज़ करना होता है। यह उच्च-विविधता वाला क्षेत्र है, जहाँ जनरेटिव मॉडल अब भी कभी-कभी गलत रेंडर करते हैं, जिससे दाँतों के आकार थोड़े गलत या जीभ की स्थिति अप्राकृतिक हो जाती है।
अपना पहला वीडियो सिंक करने के लिए तैयार हैं?
AI लिपसिंक की तकनीक जटिल है, लेकिन उस पर बने टूल्स का उपयोग उतना जटिल होना ज़रूरी नहीं है। PicassoIA पर हर मॉडल ध्वनिक विश्लेषण, लैंडमार्क ट्रैकिंग और न्यूरल रेंडरिंग पाइपलाइन को एक सरल, दो-अपलोड इंटरफ़ेस में समेट देता है: आपका वीडियो, आपका ऑडियो, और एक बटन।
अगर आपके पास ऐसा फ़ुटेज है जिसे किसी दूसरी भाषा में डब करना है, एक अवतार है जिसे स्क्रिप्ट पढ़नी है, एक प्रेज़ेंटेशन है जिसका ऑडियो वीडियो से अलग रिकॉर्ड हुआ था, या एक सोशल मीडिया क्लिप है जिसे नई ऑडियंस के लिए दोबारा अनुवादित करना है, तो PicassoIA पर ऐसा मॉडल है जो ठीक उसी केस के लिए बना है।
मौजूदा फ़ुटेज पर, अलग ऑडियो ट्रैक के साथ, सबसे अच्छी क्वालिटी के लिए Sync Lipsync 2 Pro से शुरू करें। अगर आप बिना किसी सोर्स फ़ुटेज के एक ही फ़ोटो को पूरे टॉकिंग वीडियो में बदलना चाहते हैं, तो ByteDance Omni Human 1.5 आज़माएँ। जब लक्ष्य 150 या उससे ज़्यादा भाषाओं में डबिंग हो, जिसमें मुँह की हरकत सटीक मेल खाए, तब HeyGen Video Translate का उपयोग करें।
जो वॉइस-टू-माउथ गैप दशकों तक डब किए गए कंटेंट को निराशाजनक बनाता रहा, वह अब सही टूल्स के साथ सुलझाई जा सकने वाली समस्या है। अपनी फ़ाइलें अपलोड करें और देखें कि दोनों कितनी सटीकता से मेल खा सकते हैं।


