El doblaje de video lleva décadas teniendo un problema de sincronización. La boca se mueve, las palabras salen y, de algún modo, nunca terminan de coincidir. Lo ves en películas extranjeras, en videos de formación corporativa, en contenido de redes sociales donde el audio se cambió después de grabar. Los labios cuentan una historia, la voz cuenta otra, y tu cerebro detecta la diferencia de inmediato, aunque no sepas nombrar el defecto exacto.
El lipsync con IA resuelve eso a nivel de píxel, sin depender de adivinar en postproducción. No se trata de recortar clips para ocultar un desajuste ni de desplazar el audio 200 milisegundos. Se trata de entender cada sonido que produce una persona, predecir la forma exacta de la boca que ese sonido requiere y renderizar una nueva versión de la boca que siga el audio fotograma a fotograma, sin costuras visibles.
Así funciona, paso a paso.
Por qué los videos doblados se ven mal
El cerebro humano evolucionó para detectar con precisión las discordancias entre voz y rostro. La investigación en percepción audiovisual del habla, que se basa en trabajos relacionados con el efecto McGurk, demuestra que procesamos el sonido y el movimiento de los labios juntos, no como flujos separados. Cuando se desvían incluso entre 80 y 100 milisegundos, la discordancia se registra como "algo no encaja", aunque no prestes atención consciente.
Los flujos de trabajo de doblaje clásicos traducen el diálogo, regraban el audio con los actores y luego intentan ajustar el nuevo audio al movimiento de boca existente mediante edición creativa. Los resultados dependen por completo de lo que la boca del actor original estuviera haciendo. No hay forma de cambiar el material original, así que cada sílaba que no encaja se tapa con un corte o con un plano de reacción.
El lipsync con IA hace lo contrario. Parte del audio como verdad de referencia y genera un nuevo movimiento de boca para ajustarse a él, sin importar lo que hiciera la persona original. La identidad del video se mantiene. El contexto se mantiene. Solo cambia la boca.
💡 La diferencia entre un contenido mal doblado y uno con sincronización profesional se reduce deprisa. Lo que antes ocupaba a un equipo entero de postproducción durante una semana hoy lleva minutos con las herramientas adecuadas.
Cómo la IA lee tu voz
De la forma de onda al fonema: el primer paso
Antes de que se mueva cualquier boca, la IA tiene que entender qué sonidos se producen. El audio sin procesar llega como una forma de onda: una representación en el tiempo de los cambios de presión del aire, capturada a 44.100 muestras por segundo en audio estándar. Esa forma de onda no sirve directamente para el lipsync. Un solo pico de amplitud podría representar cualquier sonido.
El sistema pasa la forma de onda por un pipeline de reconocimiento de voz que identifica fonemas: las unidades de sonido más pequeñas y distintas de un idioma. El inglés tiene unos 44 fonemas. Cada palabra se descompone en una secuencia de ellos. La palabra "mouth" contiene cuatro fonemas distintos: /m/, /aʊ/, /θ/. Cada fonema tiene un correlato físico en el rostro, una forma que los labios, la lengua, los dientes y la mandíbula adoptan juntos para producir ese sonido concreto.
Asociar el audio a los fonemas se llama alineación forzada. Los sistemas modernos usan modelos acústicos basados en transformers entrenados con miles de horas de habla transcrita para hacerlo con precisión de fotograma, a menudo con un margen de 10 a 15 milisegundos.
Espectrogramas mel y huellas acústicas
La mayoría de los modelos de lipsync no trabajan con formas de onda sin procesar, sino con espectrogramas mel: representaciones 2D del audio donde el eje horizontal es el tiempo, el eje vertical es la frecuencia en escala mel (que aproxima la audición humana) y el brillo de cada píxel representa la intensidad de energía en cada punto de tiempo-frecuencia.
Los espectrogramas mel dan a la red neuronal una visión más rica y coherente espacialmente de la señal de audio. La red ve no solo cuándo ocurren los sonidos, sino cómo pasan de uno a otro, cómo cambian los formantes cuando un fonema se desliza hacia el siguiente y cómo se ven la prosodia y el ritmo generales del habla a lo largo de todo el clip. Esta representación acústica alimenta el núcleo del modelo de lipsync como su principal señal de condicionamiento durante toda la síntesis.
Detectar la boca, fotograma a fotograma
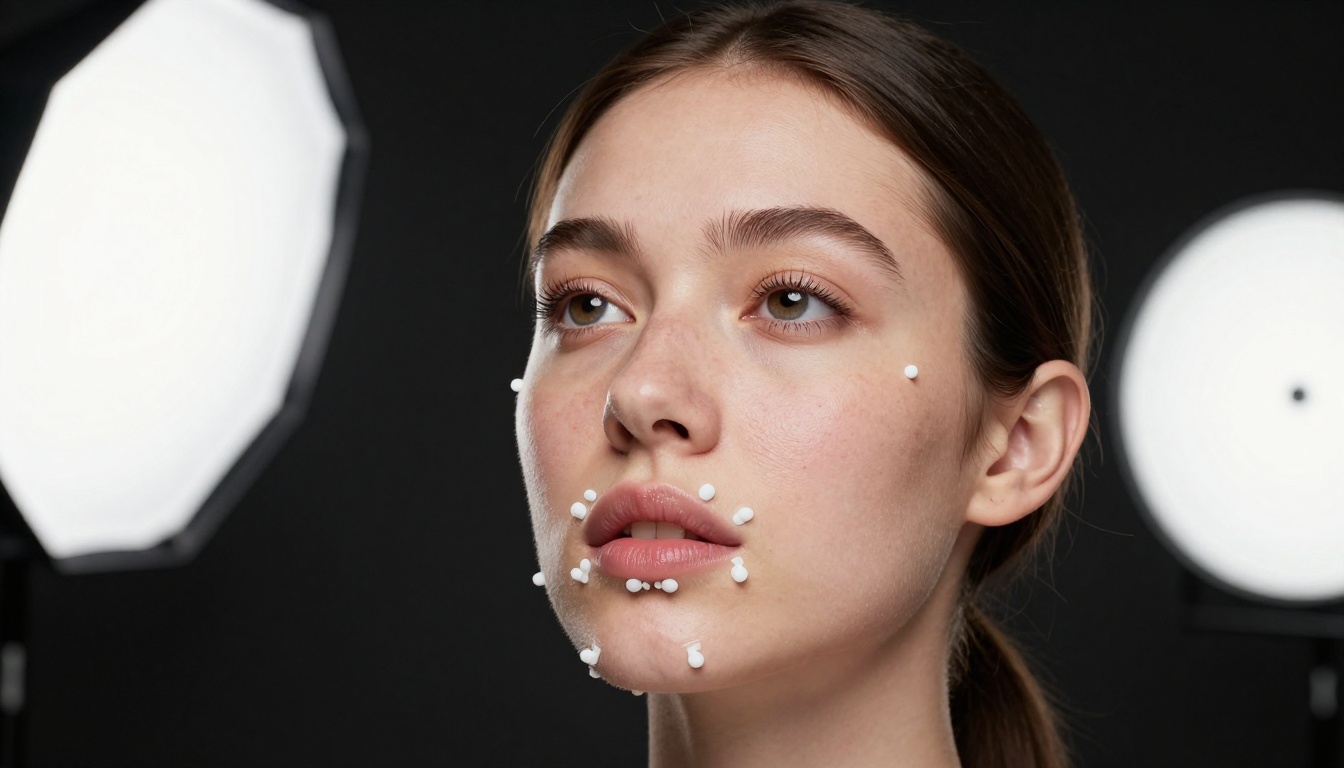
Antes de que la IA pueda modificar una boca, tiene que saber exactamente dónde está en cada fotograma y qué está haciendo en ese momento. Esto va mucho más allá de dibujar un recuadro alrededor de la zona de los labios.
Mallas de puntos faciales
Los sistemas de lipsync más avanzados usan detectores de puntos faciales que identifican entre 68 y 478 puntos precisos en el rostro, según la arquitectura del modelo. Los puntos se agrupan densamente alrededor de la boca: las comisuras de los labios, el borde bermellón, el arco de cupido, el filtrum, los espacios entre los dientes y la línea del mentón reciben cada uno un seguimiento de coordenadas individual en cada fotograma.
Estos puntos se predicen por fotograma con redes neuronales convolucionales entrenadas con grandes conjuntos de datos de rostros anotados. El resultado es una malla 3D por fotograma que mapea la geometría del rostro con gran precisión, incluso cuando la persona gira un poco, cambia de expresión o se mueve por el encuadre. Esta malla se convierte en el ancla espacial que indica a la etapa de síntesis exactamente dónde debe ir la nueva boca dentro del rostro en cada momento.
Seguimiento de mandíbula, comisuras y dientes
El lipsync necesita un seguimiento preciso de varios componentes distintos de la boca que se mueven de forma independiente:
- Apertura labial: lo abierta o cerrada que está la boca en vertical en cada fotograma
- Posición de las comisuras: si la boca está estirada hacia los lados o relajada hacia dentro
- Visibilidad de los dientes superiores e inferiores: fundamental para las fricativas y sibilantes como /s/ y /f/
- Desplazamiento de la mandíbula: el recorrido vertical de la mandíbula inferior, independiente de la forma de los labios
- Posición de la lengua: se modela con menos frecuencia, pero cada vez se incorpora más en los sistemas de generación más recientes
Estos datos de movimiento por fotograma crean una referencia geométrica que la etapa de síntesis usa como estructura de partida para renderizar la nueva boca. Sin esta capa de seguimiento, las bocas sintetizadas se desplazan fuera del rostro en cuestión de segundos.
Sintetizar un nuevo movimiento de boca
Cuando el sistema conoce los sonidos objetivo y la geometría actual del rostro, tiene que generar una nueva región de la boca que muestre la articulación correcta para cada fonema en cada fotograma, renderizada para que coincida con la apariencia de la persona original.
Mapeo de visemas
Los visemas son las contrapartidas visuales de los fonemas. Mientras el inglés tiene 44 fonemas, las formas visibles de la boca que producen se agrupan en unas 14 a 21 categorías distintas de visemas. Muchos fonemas que son acústicamente diferentes tienen el mismo aspecto en los labios vistos de frente. Los fonemas /p/, /b/ y /m/ producen todos un visema de labios cerrados, por eso se confunden con facilidad al leer los labios sin audio.
La primera generación de IA de lipsync funcionaba con tablas de búsqueda de visemas explícitas: identificar el fonema, recuperar la imagen de boca almacenada que le corresponde y mezclarla en el fotograma. Los resultados eran robóticos, con transiciones poco naturales y sin adaptación a la identidad del hablante ni al contexto.
Los sistemas modernos sustituyen esa tabla por un mapeo aprendido: una red neuronal entrenada con millones de pares de audio y video sincronizados que ha interiorizado la distribución estadística completa de cómo se mueven las bocas para cada sonido, en cada contexto, acento y perfil de hablante.
Renderizado neuronal y coincidencia de textura
El paso de síntesis usa un modelo generativo (normalmente una arquitectura GAN o basada en difusión) que recibe tres entradas a la vez:
- Las características del audio objetivo, codificadas a partir del corte del espectrograma mel que corresponde a este instante
- La identidad facial de referencia, extraída como un embedding de características del video de entrada
- La geometría facial del fotograma actual, proporcionada por el rastreador de puntos
La salida es una nueva región de la boca: un fragmento de video sintetizado que muestra el movimiento correcto de la boca para ese corte de audio, renderizado con el estilo visual y la textura de la piel de la persona original, bajo la iluminación original del material fuente.
El desafío central es la coherencia de textura. El fragmento de boca sintetizado debe coincidir con el tono de la piel de alrededor, con la dirección y calidad de la iluminación existente, con el grano y la estructura de poros de la piel y con cualquier desenfoque por movimiento presente en el fotograma original. Los mejores modelos lo resuelven con codificadores de identidad que extraen un embedding de características de alta dimensión del rostro de origen y condicionan el renderizador con él durante toda la pasada de síntesis.
| Componente | Función | Por qué importa |
|---|
| Codificador acústico | Convierte el corte de audio en vectores de características | Determina la forma correcta de la boca en cada fotograma |
| Codificador de identidad | Captura la apariencia visual del hablante | Conserva el parecido de la persona |
| Rastreador de puntos faciales | Mapea la geometría del rostro en cada fotograma | Ancla la boca sintetizada en la posición correcta |
| Renderizador neuronal | Sintetiza la nueva región de la boca | Produce un resultado fotorrealista |
| Suavizador temporal | Elimina el temblor entre fotogramas | Evita parpadeos y artefactos de movimiento |
Alineación temporal: la parte más difícil
Conseguir que un solo fotograma se vea bien es un problema abordable. Conseguir que 30 fotogramas por segundo se vean bien, con movimiento fluido y sin parpadeos ni deriva de identidad a lo largo de todo el clip, es el punto donde la mayoría de los sistemas de lipsync muestran sus limitaciones reales.
Desajustes de frecuencia de fotogramas
El audio existe en tiempo continuo. El video existe en fotogramas discretos. Cuando el audio indica que la boca debe estar en una apertura concreta en el segundo 1,033, el fotograma de video más cercano puede estar en 1,033 segundos (30 fps) o en 1,025 segundos (40 fps). Esta pequeña discrepancia se acumula en clips largos y produce una deriva temporal sutil pero visible.
Los sistemas avanzados lo resuelven con interpolación subfotograma: generan estados intermedios de la boca entre los fotogramas renderizados y los componen con un desenfoque por movimiento adecuado para crear la sensación de un movimiento suave y físicamente continuo, que no da saltos en los límites de los fotogramas.
Mantener intacta la identidad
La deriva de identidad es un fallo sutil pero significativo que aparece en clips más largos. Tras varios segundos de fragmentos de boca renderizados por red neuronal, el rostro puede empezar a verse ligeramente distinto del original: el tono de la piel un poco más cálido, los dientes un poco más blancos, el contorno de los labios remodelado de forma mínima. Los pequeños errores por fotograma se acumulan y se convierten en una divergencia visible con el tiempo.
Los mejores modelos actuales aplican durante el entrenamiento una función de pérdida perceptual de identidad que penaliza cualquier desviación respecto a la identidad de origen a lo largo de un lote de fotogramas. En la inferencia, además, aplican una realineación periódica que compara cada fragmento renderizado con el embedding de identidad de origen y lo devuelve poco a poco a la apariencia original.
💡 La coherencia temporal es lo que separa el lipsync de consumo de los resultados profesionales. La diferencia suele ser invisible en un solo fotograma fijo y se nota de inmediato en cuanto el video se reproduce a velocidad normal.
Lipsync en tiempo real frente a postproducción
Existen dos contextos de implementación distintos para el lipsync con IA, y cada uno implica contrapartidas técnicas fundamentalmente diferentes entre calidad y velocidad.
El lipsync en tiempo real se ejecuta durante transmisiones en directo, videollamadas o sesiones interactivas. Debe procesar el audio y renderizar la salida de video modificada con menos de 100 milisegundos de latencia de extremo a extremo, a menudo en equipos de consumo sin recursos de GPU dedicada. Para cumplir esta restricción, los sistemas en tiempo real usan arquitecturas de modelo más pequeñas, regiones de boca de menor resolución y un suavizado temporal agresivo que acepta cierta pérdida de precisión a cambio de velocidad. Sus aplicaciones principales incluyen avatares virtuales en directo, personajes interactivos de videojuegos y pipelines de presentadores virtuales.
El lipsync en postproducción se ejecuta sin conexión sobre contenido grabado. La latencia no importa. El sistema puede usar modelos mucho más grandes, hacer varias pasadas sobre cualquier segmento que muestre artefactos, aplicar un refinamiento iterativo a resolución completa y tardar todo lo necesario para producir el mejor resultado. Es el modo que se usa en el doblaje profesional de películas, la localización de video corporativo y la creación de contenido social de alta calidad.
La mayoría de los modelos disponibles en PicassoIA funcionan en modo postproducción, lo que significa que el techo de calidad es bastante más alto que el que encuentras en las aplicaciones de avatar en directo para consumidores.
Los mejores modelos de lipsync en PicassoIA
PicassoIA aloja 12 modelos de lipsync de distintos proveedores, niveles de calidad y casos de uso específicos. Estos son los destacados que conviene conocer para cada escenario.
Sync Lipsync 2 Pro
Sync Lipsync 2 Pro es la oferta premium de Sync, uno de los proveedores de lipsync más centrados en la técnica del mercado. Maneja casos de articulación difíciles, como la visibilidad de los dientes en vocales muy abiertas, las consonantes laterales y las transiciones rápidas entre fonemas que hacen tropezar a modelos menos sofisticados. La calidad a resolución completa está lista para emisión y aguanta bien en planos cerrados del rostro, donde cualquier artefacto se ve de inmediato.
HeyGen Lipsync Precision
HeyGen Lipsync Precision realiza un análisis profundo de fonemas del audio de entrada antes de que empiece la síntesis, lo que hace que la alineación temporal sea inusualmente ajustada en todo el clip. Es especialmente bueno para sincronizar una locución con un rostro cuando el audio de sustitución se grabó por separado y no tiene una relación temporal propia con el video original.
Kling Lip Sync
Kling Lip Sync de Kwaivgi aplica el lipsync como parte de un pipeline más amplio de comprensión de video que modela el contexto completo del cuerpo. Maneja mejor el movimiento de la cabeza y el entorno que los sistemas que solo trabajan en la zona de la boca, por lo que es la opción adecuada para material en el que la persona se mueve mientras habla en lugar de dirigirse directamente a cámara.
ByteDance Omni Human 1.5
ByteDance Omni Human 1.5 anima una fotografía fija convirtiéndola en un video parlante completo usando solo una entrada de audio. Es un problema más difícil que sincronizar material existente, porque el modelo también debe generar desde cero un movimiento natural de la cabeza, el parpadeo de los ojos y las microexpresiones, sin ninguna referencia de movimiento. Los resultados son inusualmente naturales para un pipeline de foto a video y funcionan bien en flujos de trabajo de creación de avatares y presentadores.
Otras opciones sólidas disponibles en la plataforma son Sync Lipsync 2 para una sincronización de alta calidad un escalón por debajo del nivel Pro, HeyGen Lipsync Speed cuando el tiempo de procesamiento es prioritario, Pixverse Lipsync para la sincronización instantánea de audio a video, VEED Fabric 1.0 para hacer que las fotos hablen, Sync React 1 para añadidos realistas en material existente, y HeyGen Video Translate cuando el objetivo es el doblaje multilingüe en 150 idiomas o más. Para avatares parlantes totalmente animados a partir de una imagen fija, P Video Avatar y ByteDance Omni Human completan la colección.
Cómo usar Lipsync 2 Pro en PicassoIA
Sync Lipsync 2 Pro es el punto de partida recomendado para obtener resultados profesionales sobre material existente. Así se usa, paso a paso, de principio a fin.
Paso 1: Prepara tus archivos. Necesitas dos archivos: un video de la persona cuya boca quieres sincronizar y un archivo de audio con el habla objetivo. El video debe tener al menos 720p y una vista frontal clara del hablante. El audio debe estar limpio, con poco ruido de fondo, reverberación o compresión dinámica intensa.
Paso 2: Abre el modelo. Ve a Sync Lipsync 2 Pro en PicassoIA y haz clic en "Try Now" para abrir la interfaz.
Paso 3: Sube el video. Usa el campo de carga de video para proporcionar tu material original. El modelo acepta los formatos MP4, MOV y WebM. Los clips de menos de 3 minutos se procesan más rápido y con más fiabilidad en una primera pasada.
Paso 4: Sube el audio. En el campo de entrada de audio, proporciona tu archivo de habla objetivo. Funcionan MP3, WAV y M4A. La duración del audio debe coincidir aproximadamente con la del video para lograr el resultado compuesto más limpio.
Paso 5: Ajusta la intensidad de la sincronización. La mayoría de las interfaces muestran un parámetro de intensidad o fuerza de sincronización. Empieza en 0,8 como línea base. Los valores más altos producen una sincronización más ajustada, pero pueden introducir algún artefacto de textura en aperturas extremas de la boca. Los valores más bajos mezclan más del movimiento de boca original en el resultado, lo que ayuda cuando el audio de sustitución está muy relacionado con el original.
Paso 6: Genera y revisa. El procesamiento suele tardar entre 30 y 90 segundos según la duración del clip. Al revisar el resultado, fíjate primero en las consonantes oclusivas (/b/, /p/, /m/) y en las sibilantes (/s/, /z/), ya que son las categorías de fonemas más distintas visualmente y los puntos donde un desajuste se hace más visible para el espectador.
Paso 7: Itera si hace falta. Si algunas secciones no encajan, anota las marcas de tiempo exactas y vuelve a ejecutar con una intensidad de sincronización ligeramente distinta. En proyectos profesionales, una segunda pasada sobre los segmentos marcados con la máxima calidad es una práctica habitual y añade solo un pequeño tiempo de procesamiento.
💡 El audio limpio es el factor más importante para la calidad final. El ruido, la reverberación y los artefactos de compresión intensa degradan la precisión de detección de fonemas antes incluso de que empiece la etapa de síntesis. Si el entorno de grabación no fue ideal, procesa tu audio con una pasada de reducción de ruido antes de subirlo.
Dónde la tecnología todavía tropieza
El lipsync con IA ha mejorado mucho en los últimos dos años, pero algunos escenarios concretos siguen dejando al descubierto limitaciones reales que conviene conocer antes de apostar por un flujo de trabajo.
Los ángulos extremos de la cabeza siguen siendo un problema para casi todos los modelos actuales. Cuando el hablante gira más de 40 a 45 grados respecto a una posición de frente a la cámara, la detección de puntos faciales se degrada y el fragmento de boca sintetizado deja de alinearse limpiamente con la geometría de la mejilla y la mandíbula en los bordes del rostro. La mayor parte del contenido profesional evita esto con la elección de los planos.
El habla a gran velocidad plantea desafíos de tiempo, porque las personas que hablan rápido producen transiciones de fonemas en menos de 50 milisegundos, que pueden caer entre los fotogramas de un video a 24 fps. Algunos fonemas se saltan o se emborronan en el tiempo en la salida, lo que produce errores sutiles de articulación en las sílabas más rápidas.
Los acentos poco habituales y las texturas vocales inusuales dejan al descubierto huecos en los datos de entrenamiento. Los modelos entrenados sobre todo con inglés estadounidense o británico estándar siguen mostrando una pérdida de calidad con las distribuciones de fonemas de otros idiomas y dialectos regionales. Esto se reduce a medida que los conjuntos de datos de entrenamiento se amplían a nivel global, pero sigue siendo una brecha de calidad visible para el habla no estándar.
Las vocales muy abiertas y la visibilidad de los dientes siguen siendo una fuente habitual de artefactos. Cuando la boca se abre por completo, la IA tiene que sintetizar a la vez una vista convincente de los dientes superiores e inferiores, la posición de la lengua y la cavidad oral en profundidad. Es una zona de mucha variación en la que los modelos generativos todavía a veces renderizan mal, produciendo formas de dientes ligeramente incorrectas o posiciones de lengua poco naturales.
¿Listo para sincronizar tu primer video?
La mecánica del lipsync con IA es compleja, pero usar las herramientas construidas sobre ella no tiene por qué serlo. Cada modelo de PicassoIA abstrae el análisis acústico, el seguimiento de puntos faciales y el pipeline de renderizado neuronal en una interfaz sencilla de dos subidas: tu video, tu audio y un botón.
Si tienes material que necesita doblarse a otro idioma, un avatar que tiene que leer un guion, una presentación cuyo audio se grabó aparte del video o un clip de redes sociales que necesita una nueva traducción para un público distinto, hay un modelo en PicassoIA creado para ese caso exacto.
Empieza con Sync Lipsync 2 Pro para obtener los resultados de mayor calidad sobre material existente con una pista de audio separada. Prueba ByteDance Omni Human 1.5 si quieres animar una sola fotografía hasta convertirla en un video parlante completo, sin material original. Usa HeyGen Video Translate cuando el objetivo sea doblar a un idioma nuevo con un movimiento de boca ajustado con precisión en 150 idiomas o más.
La brecha entre voz y boca que hizo frustrante el contenido doblado durante décadas es hoy un problema resoluble con las herramientas adecuadas. Sube tus archivos y comprueba con qué precisión pueden alinearse las dos cosas.


