Vídeos dublados têm um problema de sincronização há décadas. A boca se mexe, as palavras saem, e de alguma forma os dois nunca combinam direito. Isso aparece em filmes estrangeiros, em vídeos de treinamento corporativo, em conteúdos de redes sociais em que o áudio foi trocado depois da gravação. Os lábios contam uma história, a voz conta outra, e seu cérebro percebe a diferença na hora, mesmo sem conseguir apontar exatamente qual é o defeito.
O lipsync por IA resolve isso no nível do pixel, e não com suposições de pós-produção. Não se trata de cortar clipes para esconder um descompasso ou de ajustar o áudio em 200 milissegundos. Trata-se de entender cada som que uma pessoa emite, prever o formato exato da boca que esse som exige e renderizar uma nova versão da boca que acompanha o áudio quadro a quadro, sem nenhuma costura visível.
Veja exatamente como isso funciona.
Por que vídeos dublados parecem errados
O cérebro humano evoluiu para detectar incompatibilidades entre voz e rosto com precisão. Pesquisas em percepção audiovisual da fala, baseadas em trabalhos relacionados ao Efeito McGurk, mostram que processamos som e movimento dos lábios juntos, e não como fluxos separados. Quando eles divergem em apenas 80 a 100 milissegundos, a incompatibilidade é registrada como "estranha" mesmo sem atenção consciente.
Os fluxos de trabalho de dublagem clássicos traduzem o diálogo, regravam o áudio com os atores e depois tentam encaixar o novo áudio no movimento que já existe na boca, por meio de edição criativa. Os resultados dependem totalmente do que a boca do ator original estava fazendo. Não há como mudar a filmagem original, então cada sílaba que não encaixa é disfarçada com um corte ou um plano de reação.
O lipsync por IA faz o oposto. Ele parte do áudio como verdade de referência e gera novos movimentos da boca para combiná-lo, independentemente do que o falante original estava fazendo. A identidade do vídeo permanece intacta. O contexto permanece intacto. Só a boca muda.
💡 A diferença entre conteúdo mal dublado e conteúdo sincronizado profissionalmente está diminuindo rápido. O que levava uma semana inteira de uma equipe de pós-produção de estúdio agora leva minutos com as ferramentas certas.
Como a IA lê a sua voz
Da forma de onda ao fonema: o primeiro passo
Antes de qualquer movimento da boca, a IA precisa entender quais sons estão sendo produzidos. O áudio bruto chega como uma forma de onda: uma representação em série temporal das variações de pressão do ar, capturadas a 44.100 amostras por segundo no áudio padrão. Essa forma de onda não é diretamente útil para o lipsync. Um único pico de amplitude pode representar qualquer som.
O sistema passa a forma de onda por um pipeline de reconhecimento de fala que identifica fonemas: as menores unidades distintas de som de um idioma. O inglês tem cerca de 44 fonemas. Cada palavra se divide em uma sequência deles. A palavra "mouth" contém quatro fonemas distintos: /m/, /aʊ/, /θ/. Cada fonema tem um correlato físico no rosto, um formato que os lábios, a língua, os dentes e a mandíbula assumem juntos para produzir aquele som específico.
Associar o áudio aos fonemas é chamado de alinhamento forçado. Os sistemas modernos usam modelos acústicos baseados em transformers, treinados com milhares de horas de fala transcrita, para fazer isso com precisão de quadro, muitas vezes com margem de 10 a 15 milissegundos.
Espectrogramas de mel e impressões digitais de áudio
A maioria dos modelos de lipsync não trabalha com formas de onda brutas, e sim com espectrogramas de mel: representações 2D do áudio em que o eixo horizontal é o tempo, o eixo vertical é a frequência na escala mel (que se aproxima da audição humana) e o brilho de cada pixel representa a intensidade de energia em cada ponto de tempo-frequência.
Os espectrogramas de mel dão à rede neural uma visão mais rica e espacialmente coerente do sinal de áudio. A rede vê não apenas quando os sons ocorrem, mas como eles fazem transição entre si, como os formantes mudam quando um fonema desliza para o seguinte, e como é a prosódia e o ritmo geral da fala ao longo de todo o clipe. Essa representação acústica alimenta o núcleo do modelo de lipsync como seu principal sinal de condicionamento durante toda a síntese.
Detectando a boca, quadro a quadro
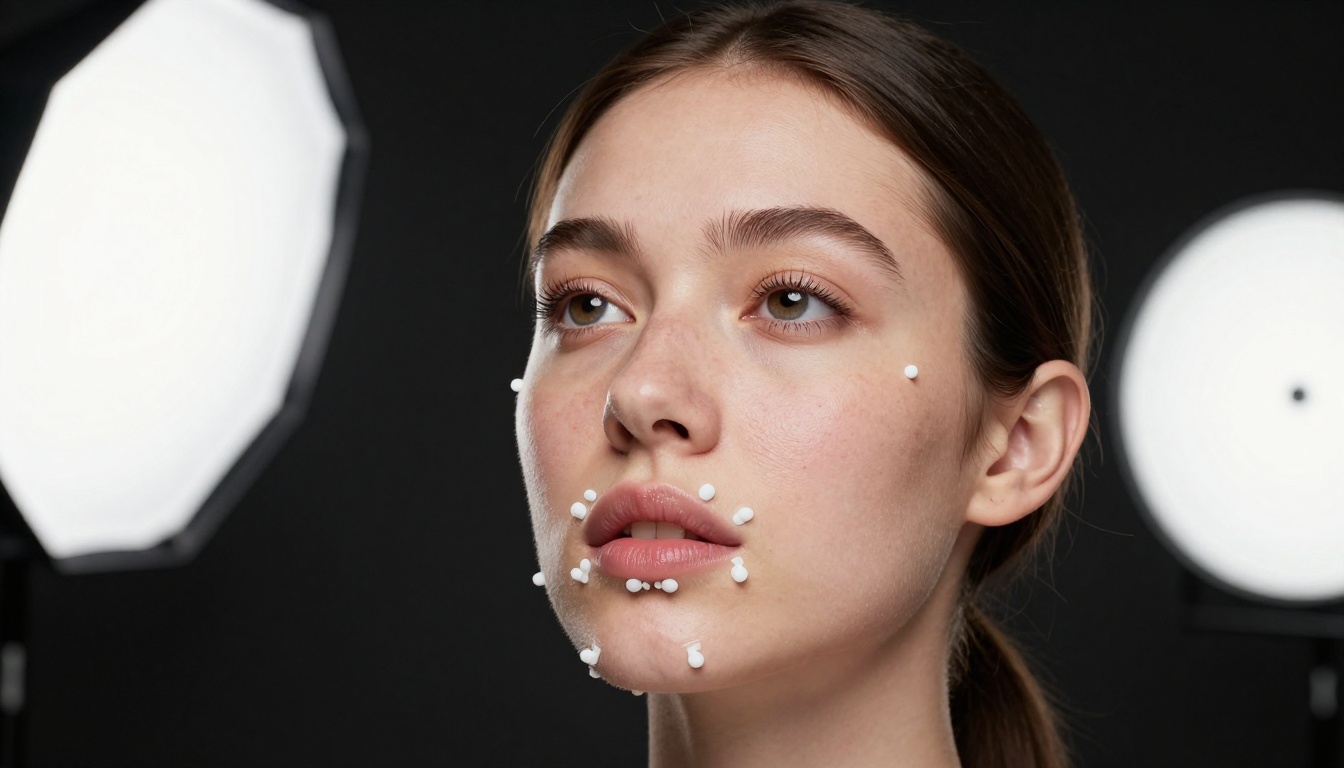
Antes que a IA possa alterar uma boca, ela precisa saber exatamente onde a boca está em cada quadro e o que ela está fazendo naquele momento. Isso vai muito além de desenhar uma caixa delimitadora em torno da região dos lábios.
Grades de pontos faciais
Os sistemas de lipsync de ponta usam detectores de pontos faciais que identificam de 68 a 478 pontos precisos no rosto, dependendo da arquitetura do modelo. Os pontos se concentram densamente na região da boca: os cantos dos lábios, a borda do vermelhão, o arco do cupido, o filtro (sulco entre o nariz e o lábio superior), os espaços entre os dentes e a linha do queixo recebem, cada um, rastreamento individual de coordenadas em cada quadro.
Esses pontos são previstos quadro a quadro por redes neurais convolucionais treinadas em grandes bases de dados de rostos anotados. O resultado é uma malha 3D sobreposta por quadro que mapeia a geometria do rosto com alta precisão, mesmo quando a pessoa vira ligeiramente, muda de expressão ou se move pelo quadro. Essa malha se torna a âncora espacial que indica à etapa de síntese exatamente onde a nova boca deve ficar dentro do rosto em cada momento.
Rastreamento da mandíbula, dos cantos dos lábios e dos dentes
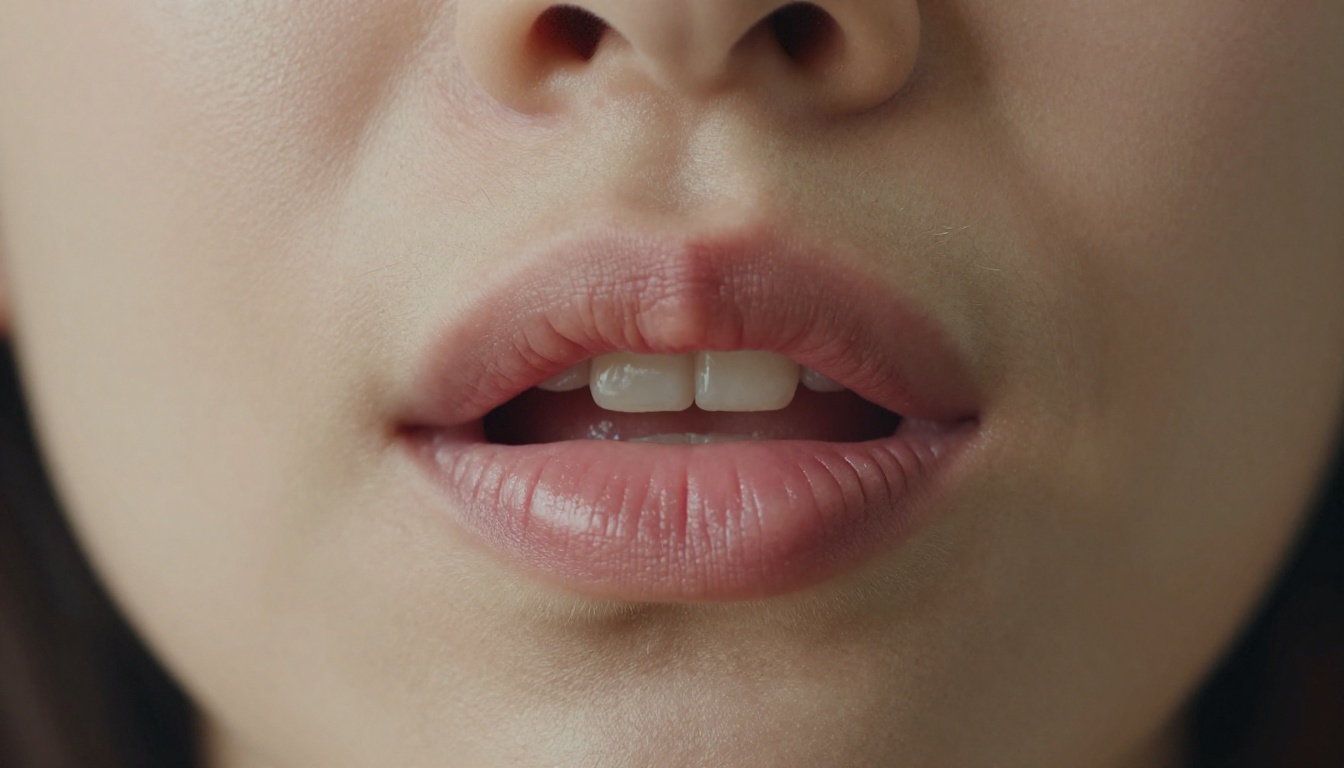
O lipsync precisa, especificamente, de rastreamento preciso de vários componentes distintos da boca que se movem de forma independente:
- Abertura dos lábios: quão aberta ou fechada a boca está verticalmente em cada quadro
- Posição dos cantos dos lábios: se a boca está esticada lateralmente ou relaxada para dentro
- Visibilidade dos dentes superiores e inferiores: essencial para fricativas e sibilantes como /s/ e /f/
- Deslocamento da mandíbula: o percurso vertical da mandíbula inferior, independente do formato dos lábios
- Posição da língua: menos modelada com frequência, mas cada vez mais incorporada nos sistemas de geração mais recentes
Esses dados de movimento quadro a quadro criam uma referência geométrica que a etapa de síntese usa como estrutura inicial para renderizar a nova boca. Sem essa camada de rastreamento, as bocas sintetizadas saem do rosto em poucos segundos.
Sintetizando novos movimentos da boca
Quando o sistema conhece os sons-alvo e a geometria atual do rosto, ele precisa gerar uma nova região da boca que mostre a articulação correta para cada fonema em cada quadro, renderizada para combinar com a aparência original da pessoa.
Mapeamento de visemas
Os visemas são os equivalentes visuais dos fonemas. Enquanto o inglês tem 44 fonemas, os formatos visíveis da boca que eles produzem se agrupam em cerca de 14 a 21 categorias distintas de visemas. Muitos fonemas que são acusticamente diferentes parecem idênticos nos lábios vistos de frente. Os fonemas /p/, /b/ e /m/ produzem todos um visema de lábios fechados, e é por isso que eles são famosamente confundidos na leitura labial sem áudio.
A primeira geração de IA de lipsync trabalhava com tabelas explícitas de consulta de visemas: identificava o fonema, buscava a imagem armazenada correspondente da boca e a misturava ao quadro. Os resultados eram robóticos, com transições não naturais e nenhuma adaptação à identidade do falante ou ao contexto.
Os sistemas modernos substituem essa tabela por um mapeamento aprendido: uma rede neural treinada com milhões de pares de áudio e vídeo sincronizados, que internalizou toda a distribuição estatística de como as bocas se movem para cada som, em cada contexto, sotaque e perfil de falante.
Renderização neural e correspondência de textura
A etapa de síntese usa um modelo generativo (tipicamente uma arquitetura GAN ou baseada em difusão) que recebe três entradas ao mesmo tempo:
- As características do áudio-alvo, codificadas a partir da fatia do espectrograma de mel correspondente a este momento no tempo
- A identidade do rosto de referência, extraída como um embedding de características do vídeo de entrada
- A geometria do rosto no quadro atual, fornecida pelo rastreador de pontos
A saída é uma nova região da boca: um trecho de vídeo sintetizado que mostra o movimento correto da boca para aquela fatia de áudio, renderizado no estilo visual e na textura da pele original da pessoa, sob a iluminação original da filmagem.
O desafio central é a consistência de textura. O trecho sintetizado da boca precisa combinar com o tom da pele ao redor, com a direção e a qualidade da iluminação existente, com a granulação e a estrutura dos poros da pele, e com qualquer desfoque de movimento presente no quadro original. Os melhores modelos resolvem isso com codificadores de identidade que extraem um embedding de características de alta dimensão do rosto de origem e condicionam o renderizador a ele durante toda a passagem de síntese.
| Componente | Função | Por que importa |
|---|
| Codificador acústico | Converte a fatia de áudio em vetores de características | Determina o formato correto da boca em cada quadro |
| Codificador de identidade | Captura a aparência visual do falante | Preserva a semelhança com a pessoa |
| Rastreador de pontos | Mapeia a geometria do rosto em cada quadro | Ancora a boca sintetizada na posição correta |
| Renderizador neural | Sintetiza a nova região da boca | Produz um resultado fotorrealista |
| Suavizador temporal | Remove a trepidação entre quadros | Evita cintilação e artefatos de movimento |
Alinhamento temporal: a parte mais difícil
Fazer um único quadro parecer correto é um problema tratável. Fazer 30 quadros por segundo parecerem corretos, com movimento suave, sem cintilação nem desvio de identidade ao longo de todo o clipe, é onde a maioria dos sistemas de lipsync revela suas limitações reais.
Incompatibilidades de taxa de quadros
O áudio existe em tempo contínuo. O vídeo existe em quadros discretos. Quando o áudio diz que a boca deve estar em uma determinada abertura em 1,033 segundo, o quadro de vídeo mais próximo pode estar em 1,033 segundo (30 fps) ou em 1,025 segundo (40 fps). Essa pequena discrepância se acumula em clipes longos, produzindo uma defasagem sutil, mas visível.
Sistemas avançados lidam com isso por meio de interpolação em sub-quadros: gerando estados intermediários da boca entre os quadros renderizados e compondo-os com desfoque de movimento apropriado, para criar a aparência de um movimento suave e fisicamente contínuo que não trava nas fronteiras dos quadros.
Mantendo a identidade intacta
O desvio de identidade é uma falha sutil, mas significativa, que aparece em clipes mais longos. Depois de vários segundos de trechos de boca renderizados por rede neural, o rosto pode começar a parecer levemente diferente do original: o tom da pele um pouco mais quente, os dentes um fio mais brancos, o contorno dos lábios minimamente remodelado. Pequenos erros por quadro se acumulam e geram uma divergência visível com o tempo.
Os melhores modelos atuais aplicam uma função de perda de identidade perceptual durante o treinamento, que penaliza qualquer desvio da identidade de origem em um lote de quadros. Na inferência, eles também aplicam realinhamentos periódicos, que comparam cada trecho renderizado com o embedding de identidade da origem e o empurram de volta para a aparência original.
💡 A consistência temporal é o que separa o lipsync de consumo dos resultados profissionais. A diferença muitas vezes é invisível em um único quadro parado, e se torna imediatamente óbvia no momento em que o vídeo roda em velocidade normal.
Lipsync em tempo real ou em pós-produção
Há dois contextos distintos de uso do lipsync por IA, e eles envolvem contrapartidas técnicas fundamentalmente diferentes entre qualidade e velocidade.
O lipsync em tempo real roda durante transmissões ao vivo, chamadas de vídeo ou sessões interativas. Ele precisa processar o áudio e renderizar a saída de vídeo modificada com menos de 100 milissegundos de latência de ponta a ponta, muitas vezes em hardware de consumo, sem recursos dedicados de GPU. Para atender a essa restrição, os sistemas em tempo real usam arquiteturas de modelo menores, regiões da boca em resolução mais baixa e suavização temporal agressiva, que aceita alguma perda de precisão em troca de velocidade. As principais aplicações incluem avatares virtuais ao vivo, personagens de jogos interativos e pipelines de apresentadores virtuais.
O lipsync em pós-produção roda offline, em conteúdo pré-gravado. A latência não tem relevância. O sistema pode usar modelos muito maiores, fazer várias passagens em qualquer trecho que mostre artefatos, aplicar refinamento iterativo em resolução total e levar o tempo que for necessário para produzir o melhor resultado. Esse é o modo usado para dublagem de filmes profissionais, localização de vídeos corporativos e criação de conteúdo de alta qualidade para redes sociais.
A maioria dos modelos disponíveis no PicassoIA opera no modo de pós-produção, o que significa que o teto de qualidade é substancialmente mais alto do que o que você encontra em aplicativos de avatar ao vivo para consumidores.
Os melhores modelos de lipsync no PicassoIA
O PicassoIA hospeda 12 modelos de lipsync que cobrem diferentes provedores, faixas de qualidade e casos de uso específicos. Estes são os destaques que vale conhecer para cada cenário.
Sync Lipsync 2 Pro
Sync Lipsync 2 Pro é a oferta premium da Sync, um dos provedores de lipsync mais focados em tecnologia do mercado. Ele lida com casos difíceis de articulação, incluindo a visibilidade dos dentes em vogais muito abertas, consoantes laterais e transições rápidas de fonemas que confundem modelos menos sofisticados. A qualidade de saída em resolução total é adequada para transmissão e se sustenta bem em filmagens de close fechado de rosto, em que qualquer artefato fica imediatamente visível.
HeyGen Lipsync Precision
HeyGen Lipsync Precision faz uma análise profunda de fonemas no áudio de entrada antes de iniciar a síntese, o que torna o alinhamento temporal incomumente preciso em todo o clipe. É especialmente forte para sincronizar narração com rosto, quando o áudio de substituição foi gravado separadamente e não tem nenhuma relação temporal inerente com o vídeo original.
Kling Lip Sync
Kling Lip Sync da Kwaivgi aplica o lipsync como parte de um pipeline mais amplo de compreensão de vídeo, que modela o contexto do corpo inteiro. Ele lida melhor com movimento da cabeça e com o ambiente do que sistemas que atuam apenas na região da boca, o que o torna a escolha certa para filmagens em que a pessoa está se movendo durante a fala, em vez de falar diretamente para a câmera.
ByteDance Omni Human 1.5
ByteDance Omni Human 1.5 anima uma fotografia estática e a transforma em um vídeo falante completo usando apenas uma entrada de áudio. Esse é um problema mais difícil do que sincronizar uma filmagem existente, porque o modelo também precisa gerar do zero movimentos naturais da cabeça, piscadas e microexpressões, sem nenhuma referência de movimento. Os resultados são incomumente naturais para um pipeline de foto para vídeo e funcionam bem em fluxos de trabalho de criação de avatares e apresentadores.
Outras boas opções disponíveis na plataforma incluem Sync Lipsync 2 para sincronização de alta qualidade um degrau abaixo da faixa Pro, HeyGen Lipsync Speed quando o tempo de processamento é prioridade, Pixverse Lipsync para sincronização instantânea de áudio e vídeo, VEED Fabric 1.0 para fazer fotos falarem, Sync React 1 para adições realistas em filmagens existentes, e HeyGen Video Translate quando o objetivo é a dublagem multilíngue em 150 ou mais idiomas. Para avatares falantes totalmente animados a partir de uma imagem parada, P Video Avatar e ByteDance Omni Human completam a coleção.
Como usar o Lipsync 2 Pro no PicassoIA
Sync Lipsync 2 Pro é o ponto de partida recomendado para resultados profissionais em filmagens existentes. Veja exatamente como executá-lo do início ao fim.
Passo 1: Prepare seus arquivos. Você precisa de dois arquivos: um vídeo da pessoa cuja boca você quer sincronizar e um arquivo de áudio com a fala-alvo. O vídeo deve ter pelo menos 720p, com uma visão clara e de frente do falante. O áudio deve estar limpo, com o mínimo possível de ruído de fundo, reverberação ou compressão dinâmica pesada.
Passo 2: Abra o modelo. Acesse Sync Lipsync 2 Pro no PicassoIA e clique em "Try Now" para abrir a interface.
Passo 3: Envie o vídeo. Use o campo de envio de vídeo para fornecer sua filmagem original. O modelo aceita os formatos MP4, MOV e WebM. Clipes com menos de 3 minutos são processados mais rápido e com mais confiabilidade na primeira passagem.
Passo 4: Envie o áudio. No campo de entrada de áudio, forneça seu arquivo de fala-alvo. MP3, WAV e M4A funcionam bem. A duração do áudio deve corresponder aproximadamente à duração do vídeo para obter a composição final mais limpa.
Passo 5: Defina a força de sincronização. A maioria das interfaces expõe um parâmetro de força ou intensidade da sincronização. Comece em 0,8 como base. Valores mais altos produzem uma sincronização mais precisa, mas podem introduzir artefatos ocasionais de textura em aberturas extremas da boca. Valores mais baixos mesclam mais do movimento original da boca ao resultado, o que ajuda quando o áudio de substituição é muito parecido com o original.
Passo 6: Gere e revise. O processamento normalmente leva de 30 a 90 segundos, dependendo da duração do clipe. Ao revisar a saída, concentre-se primeiro nas consoantes oclusivas (/b/, /p/, /m/) e nas sibilantes (/s/, /z/), já que são as categorias de fonemas mais distintas visualmente e os pontos em que um desalinhamento se torna mais visível para quem assiste.
Passo 7: Itere se necessário. Se trechos específicos parecerem errados, anote os timestamps exatos e execute novamente com a força de sincronização levemente ajustada. Em projetos profissionais, uma segunda passagem nos trechos sinalizados com as configurações de qualidade máxima é uma prática padrão e acrescenta apenas uma pequena quantidade de tempo de processamento.
💡 Áudio limpo é o fator isolado mais importante para a qualidade final. Ruído, reverberação e artefatos de compressão pesada degradam a precisão da detecção de fonemas antes mesmo de a etapa de síntese começar. Pré-processe seu áudio com uma passagem de redução de ruído se o ambiente de gravação não tiver sido o ideal.
Onde a tecnologia ainda tem dificuldades
O lipsync por IA melhorou muito nos últimos dois anos, mas cenários específicos ainda expõem limitações reais que vale conhecer antes de se comprometer com um fluxo de trabalho.
Ângulos extremos da cabeça continuam problemáticos para quase todos os modelos atuais. Quando o falante vira mais de 40 a 45 graus em relação a uma posição de frente para a câmera, a detecção de pontos faciais se degrada e o trecho de boca sintetizado deixa de se alinhar bem com a geometria da bochecha e da mandíbula nas bordas do rosto. A maioria dos conteúdos profissionais evita isso na escolha dos planos.
Fala em alta velocidade apresenta desafios de tempo, porque falantes rápidos produzem transições de fonemas em menos de 50 milissegundos, o que pode cair entre os quadros de vídeo a 24 fps. Alguns fonemas acabam sendo pulados ou borrados temporalmente na saída, produzindo erros sutis de articulação nas sílabas mais rápidas.
Sotaques incomuns e texturas vocais expõem lacunas nos dados de treinamento. Modelos treinados predominantemente com inglês americano ou britânico padrão ainda apresentam degradação de qualidade nas distribuições de fonemas específicas de outros idiomas e dialetos regionais. Isso vem diminuindo conforme as bases de treinamento se expandem globalmente, mas continua sendo uma lacuna de qualidade visível para falas não padronizadas.
Vogais muito abertas e visibilidade dos dentes continuam sendo uma fonte comum de artefatos. Quando a boca se abre em abertura total, a IA precisa sintetizar de forma convincente a visão simultânea dos dentes superiores e inferiores, a posição da língua e a cavidade oral em profundidade. Essa é uma área de grande variação em que os modelos generativos ainda erram de vez em quando, produzindo formatos de dentes levemente errados ou posições pouco naturais da língua.
Pronto para sincronizar seu primeiro vídeo?
A mecânica do lipsync por IA é complexa, mas usar as ferramentas construídas sobre ela não precisa ser. Cada modelo no PicassoIA abstrai a análise acústica, o rastreamento de pontos e o pipeline de renderização neural em uma interface simples de dois envios: seu vídeo, seu áudio e um botão.
Se você tem uma filmagem que precisa ser dublada para outro idioma, um avatar que precisa entregar um roteiro, uma apresentação em que o áudio foi gravado separadamente do vídeo, ou um clipe de redes sociais que precisa de nova tradução para um público diferente, existe um modelo no PicassoIA feito exatamente para esse caso.
Comece com o Sync Lipsync 2 Pro para os melhores resultados em filmagens existentes com uma faixa de áudio separada. Experimente o ByteDance Omni Human 1.5 se quiser animar uma única fotografia e transformá-la em um vídeo falante completo, sem nenhuma filmagem de origem. Use o HeyGen Video Translate quando o objetivo for a dublagem para um novo idioma, com movimento da boca precisamente combinado em 150 ou mais idiomas de destino.
A lacuna entre voz e boca que tornou o conteúdo dublado frustrante por décadas agora é um problema solucionável com as ferramentas certas. Envie seus arquivos e veja o quão precisamente os dois podem se alinhar.


