Le doublage vidéo souffre d’un problème de synchronisation depuis des décennies. La bouche bouge, les mots sortent, et pourtant les deux ne coïncident jamais tout à fait. On le remarque dans les films étrangers, les vidéos de formation en entreprise, les contenus des réseaux sociaux dont le son a été remplacé après le tournage. Les lèvres racontent une histoire, la voix en raconte une autre, et votre cerveau perçoit l’écart immédiatement, même si vous ne pouvez pas nommer le défaut précis.
Le lipsync par IA règle ce problème au niveau du pixel, sans recourir à des corrections de post-production approximatives. Il ne s’agit pas de couper des plans pour masquer un décalage ni de décaler l’audio de 200 millisecondes. Il s’agit de comprendre chaque son produit par une personne, de prédire la forme exacte que la bouche doit prendre pour produire ce son, puis de générer une nouvelle version de la bouche qui suit l’audio image par image, sans raccord visible.
Voici exactement comment cela fonctionne.
Pourquoi les vidéos doublées semblent fausses
Le cerveau humain a évolué pour détecter avec précision les décalages entre voix et visage. Les recherches sur la perception audiovisuelle de la parole, qui s’appuient notamment sur l’effet McGurk, montrent que nous traitons le son et le mouvement des lèvres ensemble, et non comme deux flux séparés. Lorsqu’ils divergent ne serait-ce que de 80 à 100 millisecondes, le décalage est perçu comme « faux », même sans attention consciente.
Les méthodes de doublage classiques traduisent les dialogues, réenregistrent l’audio avec les acteurs, puis tentent de faire correspondre le nouvel audio au mouvement de bouche existant grâce au montage créatif. Le résultat dépend entièrement de ce que faisait la bouche de l’acteur d’origine. Impossible de modifier les images sources : chaque syllabe qui ne colle pas est donc masquée par une coupe ou un plan de réaction.
Le lipsync par IA fait l’inverse. Il part de l’audio comme référence absolue et génère un nouveau mouvement de bouche pour y correspondre, quelle que soit l’action du locuteur d’origine. L’identité de la vidéo reste intacte. Le contexte reste intact. Seule la bouche change.
💡 La différence entre un contenu mal doublé et un contenu synchronisé de façon professionnelle se réduit rapidement. Ce qui demandait à une équipe complète de post-production de studio une semaine prend désormais quelques minutes avec les bons outils.
De la forme d’onde au phonème : la première étape
Avant que la bouche ne bouge, l’IA doit comprendre quels sons sont produits. L’audio brut arrive sous forme de forme d’onde : une représentation chronologique des variations de pression de l’air, captée à 44 100 échantillons par seconde pour un audio standard. Cette forme d’onde n’est pas directement utilisable pour le lipsync. Un seul pic d’amplitude peut correspondre à n’importe quel son.
Le système fait passer la forme d’onde dans un pipeline de reconnaissance vocale qui identifie les phonèmes : les plus petites unités sonores distinctes d’une langue. L’anglais compte environ 44 phonèmes. Chaque mot se décompose en une suite de ces phonèmes. Le mot « mouth » contient quatre phonèmes distincts : /m/, /aʊ/, /θ/. Chaque phonème a un correspondant physique sur le visage, une forme que les lèvres, la langue, les dents et la mâchoire adoptent ensemble pour produire ce son précis.
La mise en correspondance de l’audio avec les phonèmes s’appelle l’alignement forcé. Les systèmes modernes utilisent des modèles acoustiques à base de transformeurs, entraînés sur des milliers d’heures de parole transcrite, pour réaliser cette opération avec une précision au niveau de l’image, souvent avec une précision de 10 à 15 millisecondes.
Spectrogrammes de Mel et empreintes audio
La plupart des modèles de lipsync ne travaillent pas avec des formes d’onde brutes, mais avec des spectrogrammes de Mel : des représentations 2D de l’audio où l’axe horizontal représente le temps, l’axe vertical la fréquence sur l’échelle de Mel (qui approxime l’audition humaine), et où la luminosité de chaque pixel représente l’intensité énergétique à chaque point temps-fréquence.
Les spectrogrammes de Mel offrent au réseau de neurones une vision plus riche et plus cohérente spatialement du signal audio. Le réseau voit non seulement quand les sons surviennent, mais aussi comment ils passent de l’un à l’autre, comment les formants se déplacent lorsqu’un phonème glisse vers le suivant, et à quoi ressemblent la prosodie et le rythme général de la parole sur toute la durée du clip. Cette représentation acoustique alimente le cœur du modèle de lipsync comme signal de conditionnement principal tout au long de la synthèse.
Détecter la bouche, image par image
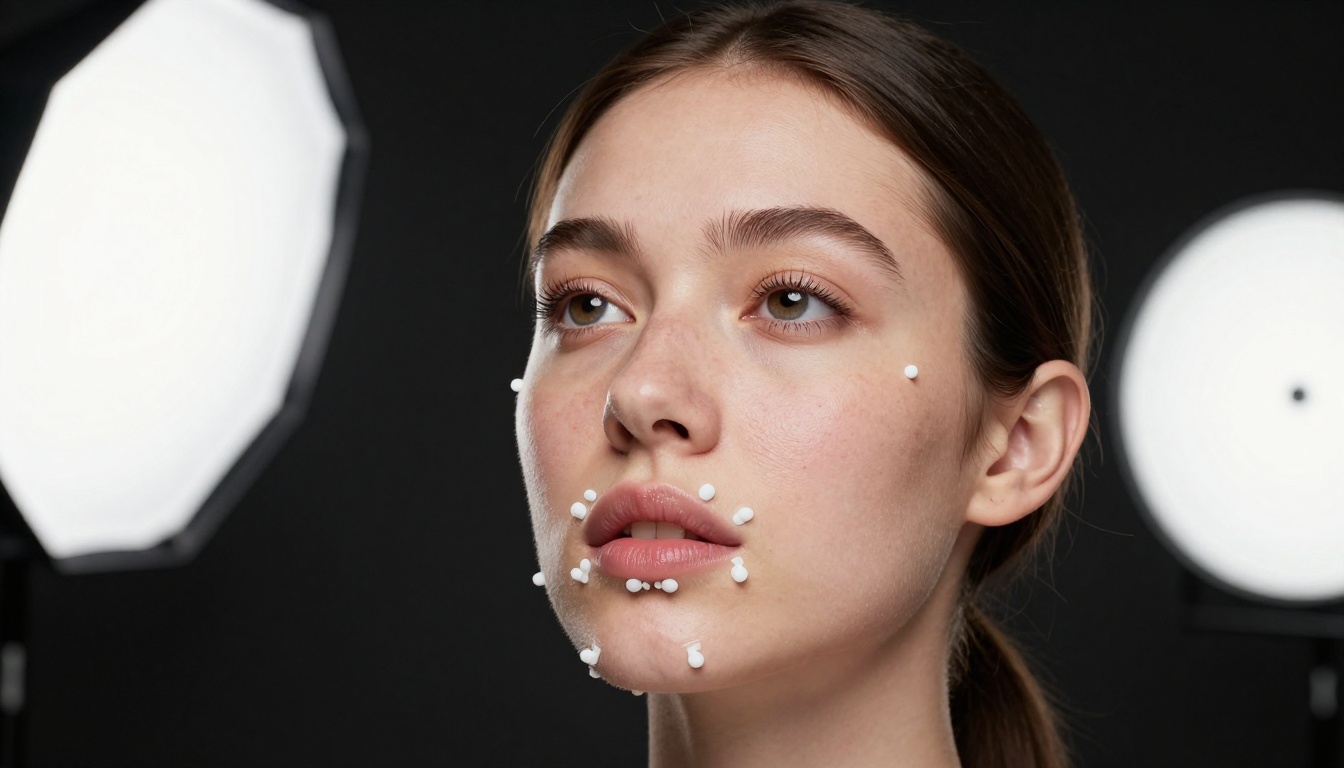
Avant que l’IA puisse modifier une bouche, elle doit savoir exactement où se trouve la bouche dans chaque image et ce qu’elle est en train de faire. Cela va bien au-delà du simple tracé d’un rectangle autour de la zone des lèvres.
Grilles de points de repère faciaux
Les systèmes de lipsync les plus avancés utilisent des détecteurs de points de repère faciaux qui identifient de 68 à 478 points précis sur le visage, selon l’architecture du modèle. Les points se concentrent densément autour de la bouche : les commissures des lèvres, la bordure du vermillon, l’arc de Cupidon, le philtrum, les espaces entre les dents et le contour du menton font tous l’objet d’un suivi de coordonnées individuel à chaque image.
Ces points de repère sont prédits image par image à l’aide de réseaux de neurones convolutifs entraînés sur de grands jeux de données de visages annotés. Le résultat est une superposition de maillage 3D par image qui cartographie la géométrie du visage avec une grande précision, même lorsque la personne tourne légèrement la tête, change d’expression ou se déplace dans le cadre. Ce maillage sert d’ancrage spatial : il indique à l’étape de synthèse l’emplacement exact où la nouvelle bouche doit se trouver sur le visage, à chaque instant.
Suivi de la mâchoire, des commissures et des dents
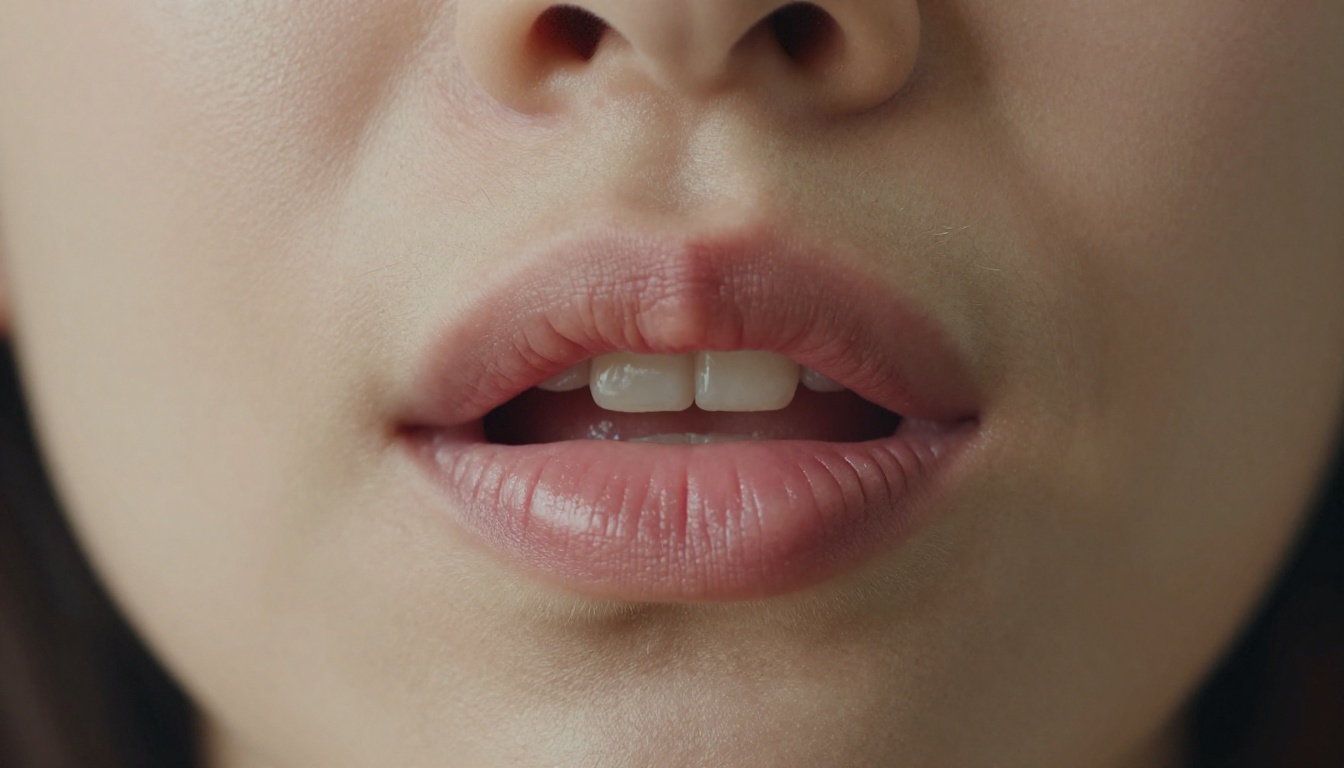
Le lipsync exige un suivi précis de plusieurs composantes distinctes de la bouche, qui bougent de façon indépendante :
- Ouverture des lèvres : à quel point la bouche est ouverte ou fermée verticalement à chaque image
- Position des commissures : si la bouche est étirée latéralement ou détendue vers l’intérieur
- Visibilité des dents supérieures et inférieures : essentielle pour les fricatives et les sifflantes comme /s/ et /f/
- Déplacement de la mâchoire : le déplacement vertical de la mâchoire inférieure, indépendamment de la forme des lèvres
- Position de la langue : rarement modélisée, mais de plus en plus intégrée aux systèmes de génération récents
Ces données de mouvement image par image créent une référence géométrique que l’étape de synthèse utilise comme structure de départ pour rendre la nouvelle bouche. Sans cette couche de suivi, les bouches synthétisées se décalent du visage en quelques secondes.
Synthétiser le nouveau mouvement de la bouche
Une fois que le système connaît les sons cibles et la géométrie actuelle du visage, il doit générer une nouvelle zone de bouche qui montre l’articulation correcte pour chaque phonème à chaque image, rendue pour correspondre à l’apparence de la personne d’origine.
Correspondance des visèmes
Les visèmes sont les équivalents visuels des phonèmes. Si l’anglais compte 44 phonèmes, les formes visibles de bouche qu’ils produisent se regroupent en environ 14 à 21 catégories distinctes de visèmes. Beaucoup de phonèmes acoustiquement différents se ressemblent sur les lèvres vues de face. Les phonèmes /p/, /b/ et /m/ produisent tous un visème à lèvres fermées, ce qui explique qu’ils se confondent facilement en lecture labiale sans son.
La première génération d’IA de lipsync fonctionnait à partir de tables de correspondance explicites entre visèmes : identifier le phonème, récupérer l’image de bouche stockée correspondante, puis la fondre dans l’image. Les résultats étaient robotiques, avec des transitions peu naturelles et aucune adaptation à l’identité du locuteur ni au contexte.
Les systèmes modernes remplacent cette table par une correspondance apprise : un réseau de neurones entraîné sur des millions de paires audio-vidéo synchronisées, qui a intégré la distribution statistique complète de la façon dont les bouches bougent pour chaque son, dans chaque contexte, chaque accent et chaque profil de locuteur.
Rendu neuronal et correspondance des textures
L’étape de synthèse utilise un modèle génératif (généralement une architecture GAN ou à base de diffusion) qui reçoit simultanément trois entrées :
- Les caractéristiques audio cibles, encodées à partir de la tranche du spectrogramme de Mel correspondant à cet instant
- L’identité faciale de référence, extraite sous forme d’embedding de caractéristiques à partir de la vidéo source
- La géométrie du visage de l’image en cours, fournie par le suivi des points de repère
Le résultat est une nouvelle zone de bouche : un fragment vidéo synthétisé qui montre le mouvement de bouche correct pour cette tranche audio, rendu dans le style visuel et la texture de la peau de la personne d’origine, dans les conditions d’éclairage d’origine des images sources.
Le principal défi est la cohérence de texture. Le fragment de bouche synthétisé doit correspondre au teint de la peau environnante, à la direction et à la qualité de l’éclairage existant, au grain et à la structure des pores de la peau, ainsi qu’au flou de bougé présent dans l’image d’origine. Les meilleurs modèles y parviennent grâce à des encodeurs d’identité qui extraient de la face source un embedding de caractéristiques de grande dimension, et conditionnent le moteur de rendu à cet embedding pendant toute la passe de synthèse.
| Composant | Fonction | Pourquoi c’est important |
|---|
| Encodeur acoustique | Convertit la tranche audio en vecteurs de caractéristiques | Détermine la forme correcte de la bouche à chaque image |
| Encodeur d’identité | Capture l’apparence visuelle du locuteur | Préserve la ressemblance avec la personne |
| Suivi des points de repère | Cartographie la géométrie du visage à chaque image | Ancre la bouche synthétisée à la bonne position |
| Moteur de rendu neuronal | Synthétise la nouvelle zone de bouche | Produit un résultat photoréaliste |
| Lissage temporel | Supprime les tremblements d’une image à l’autre | Évite le scintillement et les artefacts de mouvement |
Alignement temporel : la partie la plus difficile
Faire en sorte qu’une seule image paraisse juste est un problème maîtrisable. Faire en sorte que 30 images par seconde paraissent justes, avec un mouvement fluide, sans scintillement ni dérive d’identité sur toute la longueur d’un clip, c’est là que la plupart des systèmes de lipsync révèlent leurs véritables limites.
Décalages de fréquence d’images
L’audio existe en temps continu. La vidéo existe en images discrètes. Lorsque l’audio indique que la bouche doit être à une position d’ouverture précise à 1,033 seconde, l’image vidéo la plus proche peut se situer à 1,033 seconde (30 fps) ou à 1,025 seconde (40 fps). Ce petit écart s’accumule sur les longs clips et produit une dérive temporelle subtile mais visible.
Les systèmes avancés gèrent ce problème grâce à l’interpolation sous-image : ils génèrent des états intermédiaires de la bouche entre les images rendues et les composent avec un flou de bougé approprié, pour créer l’apparence d’un mouvement fluide et physiquement continu, sans saccades aux frontières des images.
Préserver l’identité
La dérive d’identité est un défaut subtil mais important, qui apparaît dans les clips plus longs. Après plusieurs secondes de fragments de bouche rendus par le réseau neuronal, le visage peut commencer à paraître légèrement différent de l’original : un teint un peu plus chaud, des dents un peu plus blanches, le contour des lèvres légèrement remodelé. De petites erreurs par image s’accumulent et deviennent une divergence visible avec le temps.
Les meilleurs modèles actuels appliquent une fonction de perte d’identité perceptuelle pendant l’entraînement, qui pénalise toute déviation par rapport à l’identité source sur un lot d’images. À l’inférence, ils appliquent aussi un réalignement périodique qui compare chaque fragment rendu à l’embedding d’identité source et le ramène vers l’apparence d’origine.
💡 La cohérence temporelle est ce qui distingue le lipsync grand public des résultats professionnels. La différence est souvent invisible sur une image fixe, et devient immédiatement évidente lorsque la vidéo est lue à vitesse normale.
Lipsync en temps réel ou en post-production
Il existe deux contextes de déploiement distincts pour le lipsync par IA, qui impliquent des compromis techniques fondamentalement différents entre qualité et vitesse.
Le lipsync en temps réel fonctionne pendant les diffusions en direct, les appels vidéo ou les sessions interactives. Il doit traiter l’audio et restituer une vidéo modifiée avec une latence de bout en bout inférieure à 100 millisecondes, souvent sur du matériel grand public sans ressources GPU dédiées. Pour respecter cette contrainte, les systèmes temps réel utilisent des architectures de modèles plus petites, des zones de bouche à plus basse résolution et un lissage temporel agressif qui accepte une certaine perte de précision en échange de la rapidité. Les principales applications sont les avatars virtuels en direct, les personnages interactifs de jeux vidéo et les pipelines de présentateurs virtuels.
Le lipsync en post-production fonctionne hors ligne, sur des contenus préenregistrés. La latence n’a aucune importance. Le système peut utiliser des modèles beaucoup plus volumineux, effectuer plusieurs passes sur tout segment présentant des artefacts, appliquer un raffinement itératif en pleine résolution et prendre le temps nécessaire pour produire le meilleur résultat possible. C’est le mode utilisé pour le doublage de films professionnels, la localisation de vidéos d’entreprise et la création de contenus sociaux de haute qualité.
La plupart des modèles disponibles sur PicassoIA fonctionnent en mode post-production, ce qui signifie que le plafond de qualité est nettement plus élevé que celui des applications grand public d’avatars en direct.
Les meilleurs modèles de lipsync sur PicassoIA
PicassoIA héberge 12 modèles de lipsync couvrant différents fournisseurs, niveaux de qualité et cas d’usage spécifiques. Voici les modèles les plus remarquables pour chaque scénario.
Sync Lipsync 2 Pro
Sync Lipsync 2 Pro est l’offre premium de Sync, l’un des fournisseurs de lipsync les plus axés sur la technique du marché. Il gère les cas d’articulation difficiles, notamment la visibilité des dents sur les voyelles très ouvertes, les consonnes latérales et les transitions rapides entre phonèmes qui mettent en difficulté les modèles moins sophistiqués. La qualité de sortie en pleine résolution est prête pour la diffusion et tient bien sur les gros plans serrés des visages, où le moindre artefact se voit immédiatement.
HeyGen Lipsync Precision
HeyGen Lipsync Precision effectue une analyse approfondie des phonèmes de l’audio d’entrée avant le début de la synthèse, ce qui rend l’alignement temporel exceptionnellement serré sur toute la durée du clip. Il est particulièrement efficace pour synchroniser une voix off sur un visage lorsque l’audio de remplacement a été enregistré séparément et n’a aucune relation temporelle inhérente avec la vidéo d’origine.
Kling Lip Sync
Kling Lip Sync de Kwaivgi applique le lipsync dans le cadre d’un pipeline plus large de compréhension vidéo qui modélise le contexte complet du corps. Il gère mieux les mouvements de tête et l’environnement que les systèmes qui se limitent à la zone de la bouche, ce qui en fait le bon choix pour les images où le locuteur bouge activement pendant son intervention plutôt que de parler directement face à la caméra.
ByteDance Omni Human 1.5
ByteDance Omni Human 1.5 anime une photographie statique pour en faire une vidéo complète de personne qui parle, à partir d’une seule entrée audio. C’est un problème plus difficile que la synchronisation d’images existantes, car le modèle doit aussi générer de toutes pièces les mouvements naturels de la tête, le clignement des yeux et les micro-expressions, sans aucune référence de mouvement. Les résultats sont étonnamment naturels pour un pipeline photo vers vidéo et conviennent bien à la création d’avatars et de présentateurs.
Parmi les autres options intéressantes disponibles sur la plateforme, on trouve Sync Lipsync 2 pour une synchronisation de haute qualité, légèrement en dessous du niveau Pro, HeyGen Lipsync Speed lorsque le temps de traitement est une priorité, Pixverse Lipsync pour une synchronisation audio-vidéo instantanée, VEED Fabric 1.0 pour faire parler des photos, Sync React 1 pour des ajouts réalistes sur des séquences existantes, et HeyGen Video Translate lorsque l’objectif est un doublage multilingue dans 150 langues ou plus. Pour des avatars parlants entièrement animés à partir d’une image fixe, P Video Avatar et ByteDance Omni Human complètent la sélection.
Sync Lipsync 2 Pro est le point de départ recommandé pour obtenir des résultats professionnels sur des images existantes. Voici exactement comment le lancer, du début à la fin.
Étape 1 : préparez vos fichiers. Il vous faut deux fichiers : une vidéo de la personne dont vous voulez synchroniser la bouche, et un fichier audio contenant la parole cible. La vidéo doit avoir au moins 720p et montrer clairement le locuteur de face. L’audio doit être propre, avec un minimum de bruit de fond, de réverbération ou de compression dynamique excessive.
Étape 2 : ouvrez le modèle. Rendez-vous sur Sync Lipsync 2 Pro sur PicassoIA et cliquez sur « Try Now » pour ouvrir l’interface.
Étape 3 : importez la vidéo. Utilisez le champ d’import vidéo pour fournir vos images sources. Le modèle accepte les formats MP4, MOV et WebM. Les clips de moins de 3 minutes sont traités le plus rapidement et de la manière la plus fiable lors d’une première passe.
Étape 4 : importez l’audio. Dans le champ d’entrée audio, fournissez votre fichier de parole cible. Les formats MP3, WAV et M4A fonctionnent tous. La durée de l’audio doit correspondre à peu près à la durée de la vidéo pour obtenir le rendu composite le plus propre.
Étape 5 : réglez l’intensité de la synchronisation. La plupart des interfaces proposent un paramètre d’intensité ou de force de synchronisation. Commencez à 0,8 comme valeur de référence. Des valeurs plus élevées donnent une synchronisation plus serrée, mais peuvent introduire quelques artefacts de texture aux ouvertures extrêmes de la bouche. Des valeurs plus basses mélangent davantage le mouvement d’origine de la bouche au résultat, ce qui est utile lorsque l’audio de remplacement est très proche de l’original.
Étape 6 : générez et vérifiez. Le traitement prend généralement de 30 à 90 secondes selon la durée du clip. Lors de la vérification du résultat, concentrez-vous d’abord sur les consonnes occlusives (/b/, /p/, /m/) et les sifflantes (/s/, /z/), car ce sont les catégories de phonèmes les plus distinctes visuellement, et les endroits où un décalage est le plus visible pour le spectateur.
Étape 7 : itérez si nécessaire. Si certaines sections paraissent décalées, notez les horodatages exacts et relancez avec une intensité de synchronisation légèrement ajustée. Pour les projets professionnels, une seconde passe sur les segments signalés, avec les réglages de qualité maximale, est une pratique courante et n’ajoute qu’un temps de traitement minime.
💡 Un audio propre est le facteur le plus déterminant de la qualité finale. Le bruit, la réverbération et les artefacts de compression excessive dégradent la précision de détection des phonèmes avant même que l’étape de synthèse ne commence. Appliquez une passe de réduction de bruit à votre audio si les conditions d’enregistrement n’étaient pas idéales.
Là où la technologie peine encore
Le lipsync par IA a fait des progrès spectaculaires au cours des deux dernières années, mais certains scénarios mettent encore en évidence de réelles limites qu’il vaut la peine de connaître avant de vous engager dans un flux de travail.
Les angles de tête extrêmes posent encore problème pour presque tous les modèles actuels. Lorsqu’un locuteur tourne la tête de plus de 40 à 45 degrés par rapport à une position face à la caméra, la détection des points de repère faciaux se dégrade, et le fragment de bouche synthétisé ne s’aligne plus proprement avec la géométrie de la joue et de la mâchoire aux bords du visage. La plupart des contenus professionnels évitent ce problème grâce au choix des plans.
La parole rapide pose des problèmes de timing, car les locuteurs rapides produisent des transitions de phonèmes en moins de 50 millisecondes, ce qui peut tomber entre les images vidéo à 24 fps. Certains phonèmes sont sautés ou étirés temporellement dans le résultat, ce qui produit des erreurs d’articulation subtiles sur les syllabes les plus rapides.
Les accents inhabituels et les timbres vocaux particuliers révèlent des lacunes dans les données d’entraînement. Les modèles entraînés principalement sur l’anglais américain ou britannique standard présentent encore une dégradation de qualité sur les distributions de phonèmes propres à d’autres langues et à des dialectes régionaux. Cet écart se réduit à mesure que les jeux de données d’entraînement s’élargissent à l’échelle mondiale, mais il reste un écart de qualité visible pour la parole non standard.
Les voyelles très ouvertes et la visibilité des dents restent une source fréquente d’artefacts. Lorsque la bouche s’ouvre en grand, l’IA doit synthétiser simultanément une vue convaincante des dents supérieures et inférieures, de la position de la langue et de la cavité buccale en profondeur. C’est une zone à forte variabilité, où les modèles génératifs produisent encore parfois des formes de dents légèrement fausses ou des positions de langue peu naturelles.
Prêt à synchroniser votre première vidéo ?
Les mécanismes du lipsync par IA sont complexes, mais utiliser les outils qui en découlent n’a pas à l’être. Chaque modèle de PicassoIA masque l’analyse acoustique, le suivi des points de repère et le pipeline de rendu neuronal dans une interface simple à deux imports : votre vidéo, votre audio et un bouton.
Si vous avez des images à doubler dans une autre langue, un avatar qui doit délivrer un script, une présentation dont l’audio a été enregistré séparément de la vidéo, ou un clip pour les réseaux sociaux qui doit être retraduit pour un nouveau public, il existe sur PicassoIA un modèle conçu précisément pour ce cas.
Commencez par Sync Lipsync 2 Pro pour obtenir les résultats de meilleure qualité sur des images existantes avec une piste audio séparée. Essayez ByteDance Omni Human 1.5 si vous voulez animer une seule photographie en vidéo complète de personne qui parle, sans aucune image source. Utilisez HeyGen Video Translate lorsque l’objectif est un doublage dans une nouvelle langue, avec un mouvement de bouche parfaitement synchronisé dans 150 langues cibles ou plus.
L’écart entre la voix et la bouche qui a rendu le contenu doublé frustrant pendant des décennies est aujourd’hui un problème solvable grâce aux bons outils. Importez vos fichiers et voyez avec quelle précision les deux peuvent s’aligner.


