لسنوات، كان لمولّدات الصور بالذكاء الاصطناعي ضعف واضح تعلّم المصمّمون وصنّاع المحتوى والمسوّقون الالتفاف عليه: لم تكن قادرة على تصيير نص مقروء. كان كل شعار يتحوّل إلى دوامة من أشباه الحروف. وكانت كل لافتة في واجهة متجر مولّدة تبدو وكأنها تنتمي إلى حلم بالكاد نتذكره. عانت اللوحات الإعلانية والتغليف والقوائم وتصاميم وسائل التواصل الاجتماعي المصغّرة من المصير نفسه، فما إن تحتاج إلى كلمات حقيقية داخل صورة اصطناعية حتى تنهار النتيجة.
يتبنّى GPT Image 2.0، المدمج في مجموعة GPT-4o من OpenAI، نهجًا مختلفًا من الناحية البنيوية لهذه المشكلة. النتائج ليست مثالية، لكنها أفضل بشكل ملحوظ من أي شيء أنتجته حقبة نماذج الانتشار.
لماذا كان النص يتعطّل دائمًا في صور الذكاء الاصطناعي
كان السبب الجذري بنيويًا. فنماذج الانتشار التقليدية مثل Stable Diffusion وSDXL وMidjourney في مراحله الأولى دُرّبت على أزواج من الصور والتعليقات النصية، فتعلّم النموذج الأنماط البصرية إحصائيًا. وكانت الحروف، من منظور النموذج، مجرد نسيج بصري آخر لا يختلف عن الفرو أو لحاء الشجر أو نسيج القماش.
لم "يعرف" النموذج قط أن حرف "A" هو "A". بل كان يعرف أن بكسلات مرتبة في تشكيل مثلثي معيّن تميل إلى الظهور بجوار بكسلات تشبه عارضة أفقية. وقد نجحت هذه المحاكاة الإحصائية بما يكفي للأغراض الزخرفية، لكنها انهارت حين صارت المقروئية مطلوبة.
كانت أنماط الفشل الثلاثة متكررة تقريبًا في كل مولّد:
- تشويه الحروف: تندمج الحروف أو تنقسم أو تُستبدل بأشكال تبدو معقولة لكنها ليست حروفًا فعلية.
- انزياح الإملاء: حتى حين تبدو الحروف الفردية صحيحة، تتراكم الأخطاء في الكلمة على امتداد طولها، فتتحول "COFFEE" إلى "COFFE3" أو "COFFFE".
- خط أساس غير متّسق: تطفو الحروف على ارتفاعات مختلفة، فيبدو النص مكتوبًا يدويًا بأسوأ معنى ممكن.
💡 لم تكن هذه مشكلة في بيانات التدريب، بل كانت مشكلة في التمثيل. لم يكن لدى النماذج أي مفهوم داخلي لـ"الكلمة" بوصفها وحدة منفصلة.
ما الذي غيّره GPT Image 2.0
لا يعمل GPT Image 2.0 كنموذج انتشار خالص. فهو مدمج مع قدرات فهم اللغة في GPT-4o، ما يعني أن النظام الذي يولّد الصورة يمتلك فهمًا صريحًا على مستوى التوكن للنص الذي يحاول تصييره.
عندما تطلب منه "لافتة مقهى مكتوب عليها OPEN"، يحلّل مكوّن النموذج اللغوي كلمة "OPEN" بوصفها أربعة حروف محددة بتسلسل معيّن، ثم يوجّه عملية توليد الصورة لإنتاج هذه الحروف بذلك الترتيب. ويخضع التوليد البصري للمواصفة اللغوية بطريقة لم تحاول أي منظومة سابقة تطبيقها.
يُوصف هذا أحيانًا بأنه بنية هجينة: جزء نموذج لغوي وجزء مولّد صور، حيث يؤدي النموذج اللغوي دورًا توجيهيًا وليس مجرد دور في ترميز الأمر النصي.
ما الذي يتيحه ذلك:
| القدرة | النماذج السابقة | GPT Image 2.0 |
|---|
| كلمات قصيرة مفردة | نجاح عرضي | متّسق |
| عبارات من عدة كلمات | نادر | موثوق |
| أسماء العلامات التجارية والشعارات | شبه معدوم | دقيق في أغلب الأحيان |
| جمل طويلة | فشل | نجاح جزئي |
| الأرقام والرموز | غير متّسق | صحيح في الغالب |
| اللغات المختلطة | ضعيف | يتحسّن |
كيف يقرأ الحروف فعليًا
تعتمد آلية تصيير النصوص في GPT Image 2.0 على تعامل النموذج مع النص بوصفه نية دلالية لا نمطًا بصريًا. وإليك ما يعنيه ذلك عمليًا:
عندما يعالج النظام أمرًا يطلب نصًا مرئيًا، فإنه:
- يحدّد سلسلة النص بوصفها عنصرًا منفصلًا له تركيب حروف محدد.
- يخطط للتخطيط الطباعي، أي سماكة الخط وحجمه نسبةً إلى الصورة وموضعه ومحاذاة خط الأساس، بوصفه مواصفة مكانية.
- يوجّه توليد الصورة لإنتاج بكسلات تحقق في الوقت نفسه الجمالية البصرية للمشهد ومتطلبات دقة الحروف.
- يجري فحصًا ضمنيًا أثناء التوليد للحدّ من انزياح الحروف عبر التسلسلات الأطول.
وهذا يختلف اختلافًا ملحوظًا عن أن تطلب من نموذج انتشار "التنبؤ بشكل النص" وتأمل أن يُنتج المتوسط الإحصائي لملايين الصور ما هو مقروء.
💡 فكّر في الأمر هكذا: كانت النماذج السابقة "تحلم" بالنص. أما GPT Image 2.0 فيكتبه أولًا ثم يرسم النتيجة.
يستفيد النموذج أيضًا من قدراته في اتباع التعليمات. فيمكنه الاستجابة لأوامر مثل "استخدم خطًا بارزًا بلا زوائد" أو "يجب أن يكون النص أبيض على خلفية داكنة"، والالتزام بهذه التعليمات الأسلوبية بدقة معقولة.
مشكلة حدّ الطول
تتراجع الدقة مع الطول. وهذا أحد أوضح الأنماط في سلوك GPT Image 2.0 عند تصيير النصوص.
تُصيَّر السلاسل القصيرة، من 1 إلى 6 أحرف، بدقة عالية في معظم الحالات. فاسم منتج مثل "NOVA" أو ملصق مثل "SALE" سيظهر بشكل صحيح في الغالبية العظمى من التوليدات.
تنجح السلاسل المتوسطة، من 7 إلى 15 حرفًا، في كثير من الأحيان، مع استبدالات حروف أو اختلالات في المسافات بين وقت وآخر. وتعمل "FRAGILE" و"HAND MADE" جيدًا. أما "SATISFACTION" فتفقد أحيانًا حرفًا.
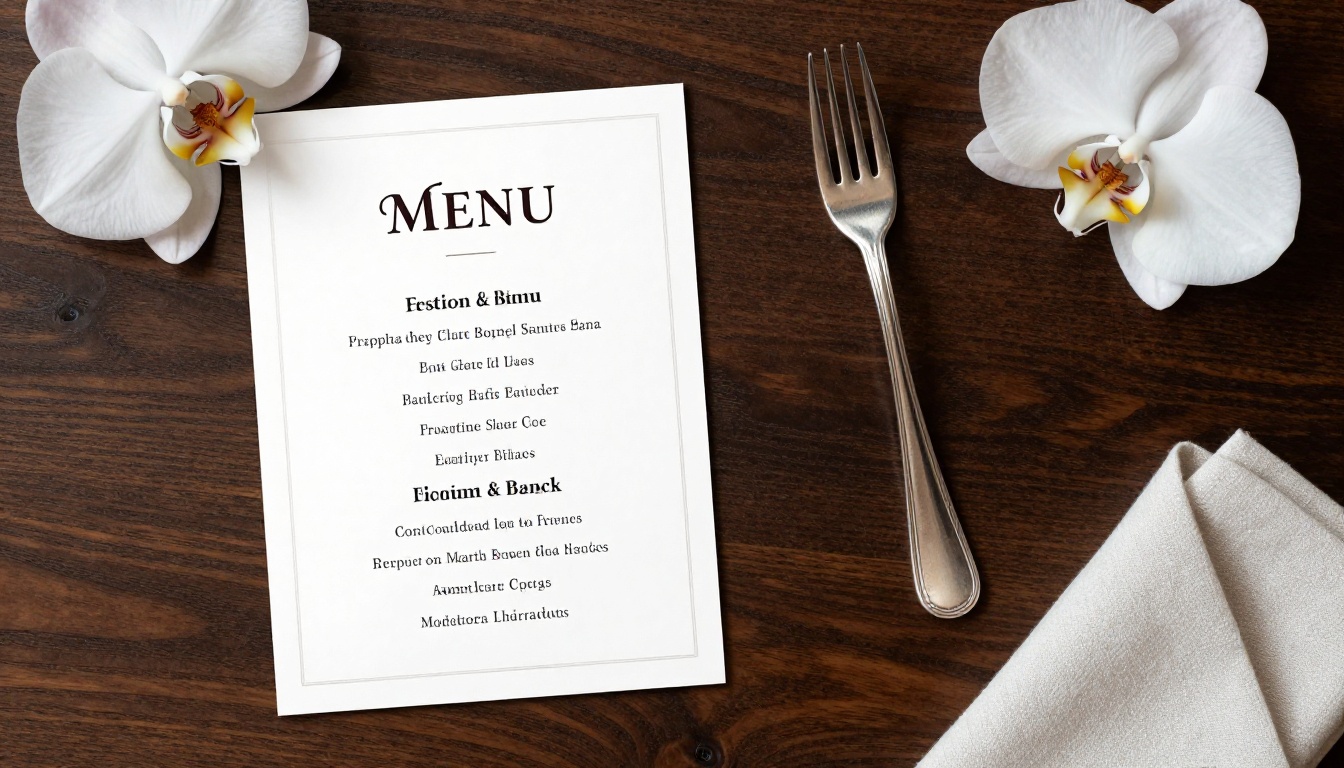
تكون السلاسل الطويلة، أكثر من 20 حرفًا، حيث تصبح الأمور غير متوقعة. تميل الجمل الكاملة داخل الصورة إلى تراكم الأخطاء كلما تقدمت عملية التوليد. غالبًا ما تكون بداية الجملة دقيقة، بينما قد تنحرف نهايتها.
قواعد عملية للعمل مع النموذج:
- احرص على أن يكون النص داخل الصورة كلمات قصيرة ذات تأثير قوي حين تكون الدقة مهمة.
- بالنسبة للنصوص الأطول، فكّر في توليد الصورة بلا نص، ثم إضافته لاحقًا باستخدام أداة تصميم.
- استخدم النموذج للنصوص متوسطة الطول في النماذج التجريبية (mockups) التي لا تكون فيها الدقة الحرفية بكسل بكسل هي المخرج النهائي.
أين ما زال يتعثر
معرفة حالات الفشل مفيدة بقدر معرفة نقاط القوة. فتصيير النصوص في GPT Image 2.0 مبهر مقارنةً بما سبقه، لكن له نقاط ضعف ثابتة:
الخطوط الخطية والخطوط اليدوية: يجد النموذج صعوبة مع الأساليب المتصلة والخطوط الخطية. تخلق أشكال الحروف المتشابكة غموضًا حول مكان انتهاء حرف وبداية آخر، ولا يتعامل نهج النموذج الذي يعالج الحروف واحدًا تلو الآخر مع الروابط (ligatures) بسلاسة.
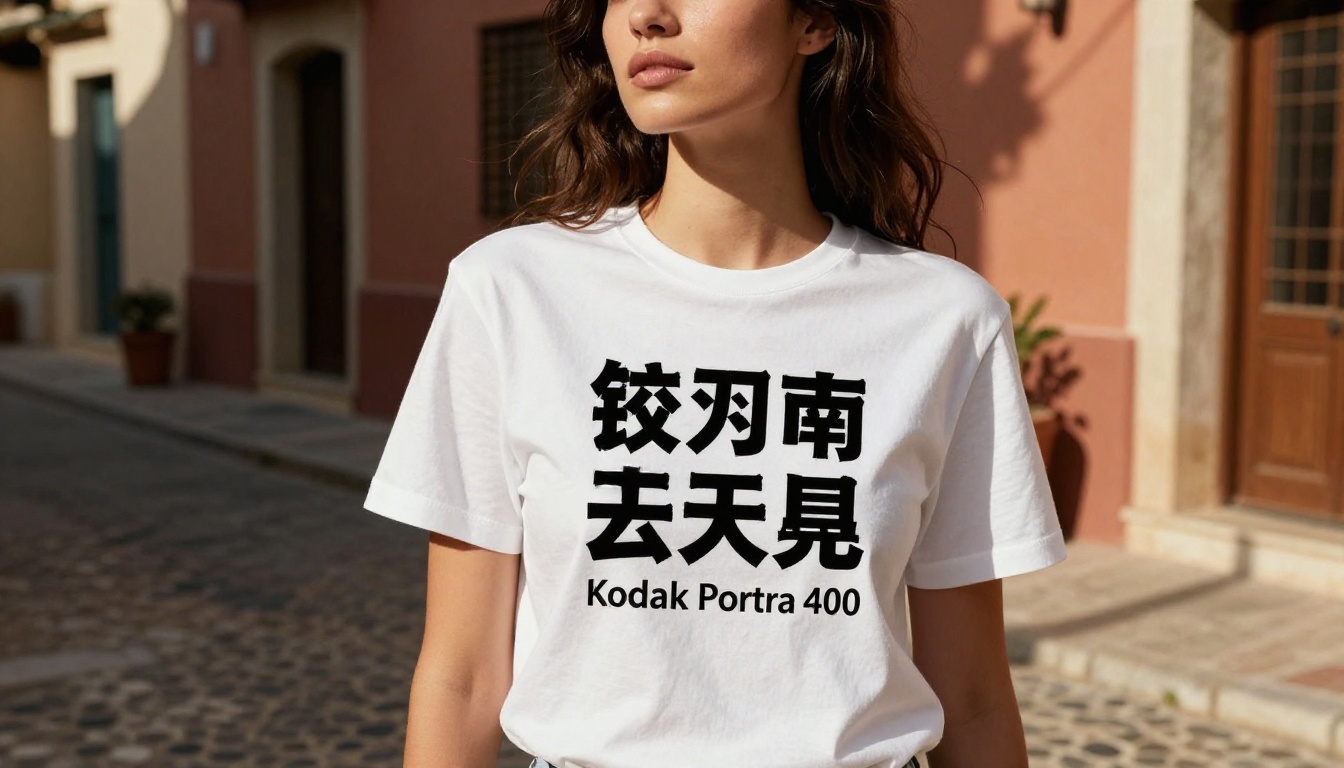
الكتابات غير اللاتينية: العربية والصينية واليابانية والكورية وأنظمة كتابة معقدة أخرى أصعب بكثير. يستطيع النموذج إنتاج نص يبدو معقولًا من مسافة بصرية، لكنه يحتوي على أخطاء في الحروف تكون واضحة فورًا لقارئ من أهلها.
المبالغة الأسلوبية: النصوص المشوّهة بشدة، أو الواقعة بزوايا غير معتادة، أو المدمجة في أنماط معقدة، يصبح تصييرها بدقة أصعب. ويبدو أن توجيه الحروف لدى النموذج يضعف حين تكون التعقيدات البصرية في محيط الصورة عالية.
النص الصغير جدًا: النص الذي يشغل جزءًا صغيرًا من الصورة، مثل الخط الدقيق على ملصق، يتحول في كثير من الأحيان إلى ضوضاء عند الدقة العادية.
💡 في العمل الاحترافي، تعامل مع GPT Image 2.0 بوصفه المسودة الأولى، لا المخرج النهائي. إنه يوصلك إلى 80% من الطريق أسرع من أي أداة سابقة.
حالات استخدام حقيقية تعمل الآن
تستحق التطبيقات العملية التي أصبحت موثوقة أن تُذكر بالتحديد، لأن هنا يغيّر GPT Image 2.0 سير العمل فعلًا:
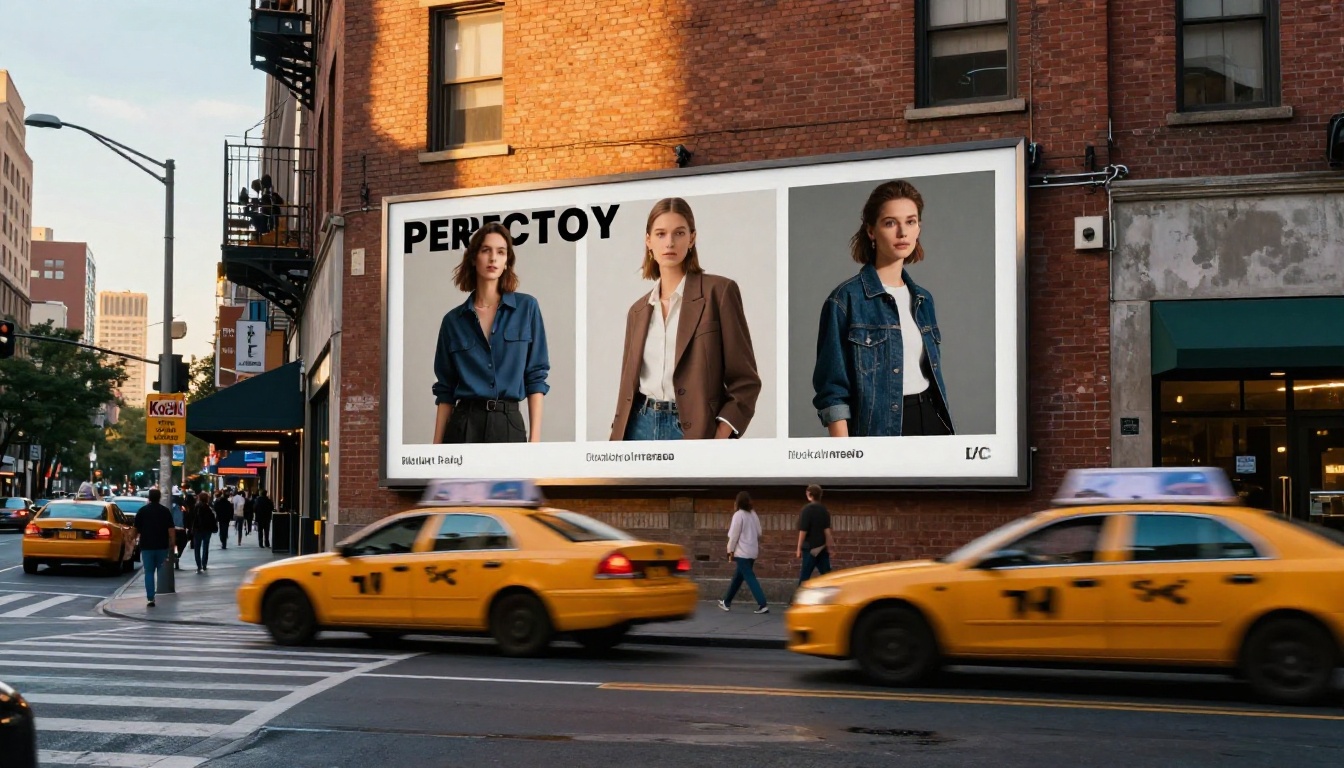
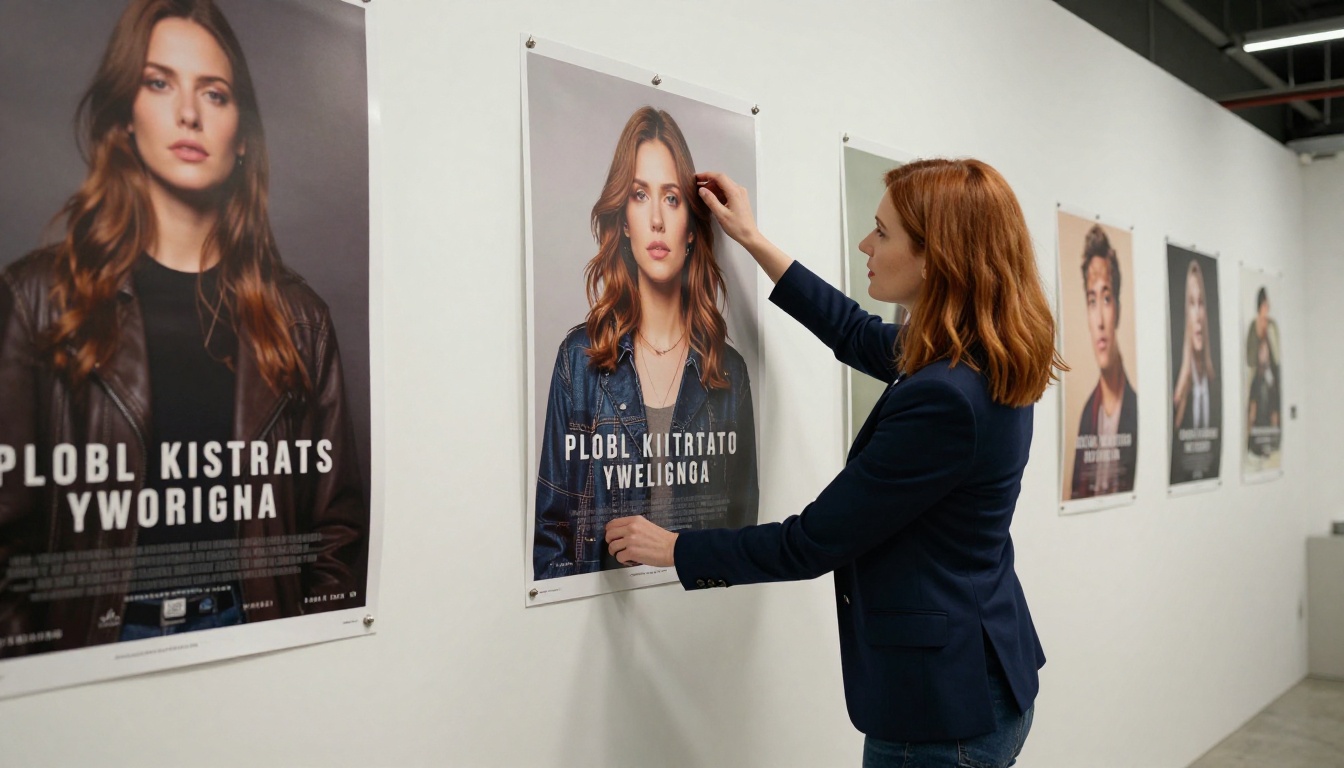
مسوّدات العرض التسويقية: توليد صور إعلانية تجريبية بعناوين رئيسية مقروءة لعروض العملاء. كان هذا يتطلب سابقًا أن يدمج المصمم النص في Photoshop بعد التوليد. أما الآن فكثيرًا ما تخرج المسودة الأولى جاهزة للعرض.
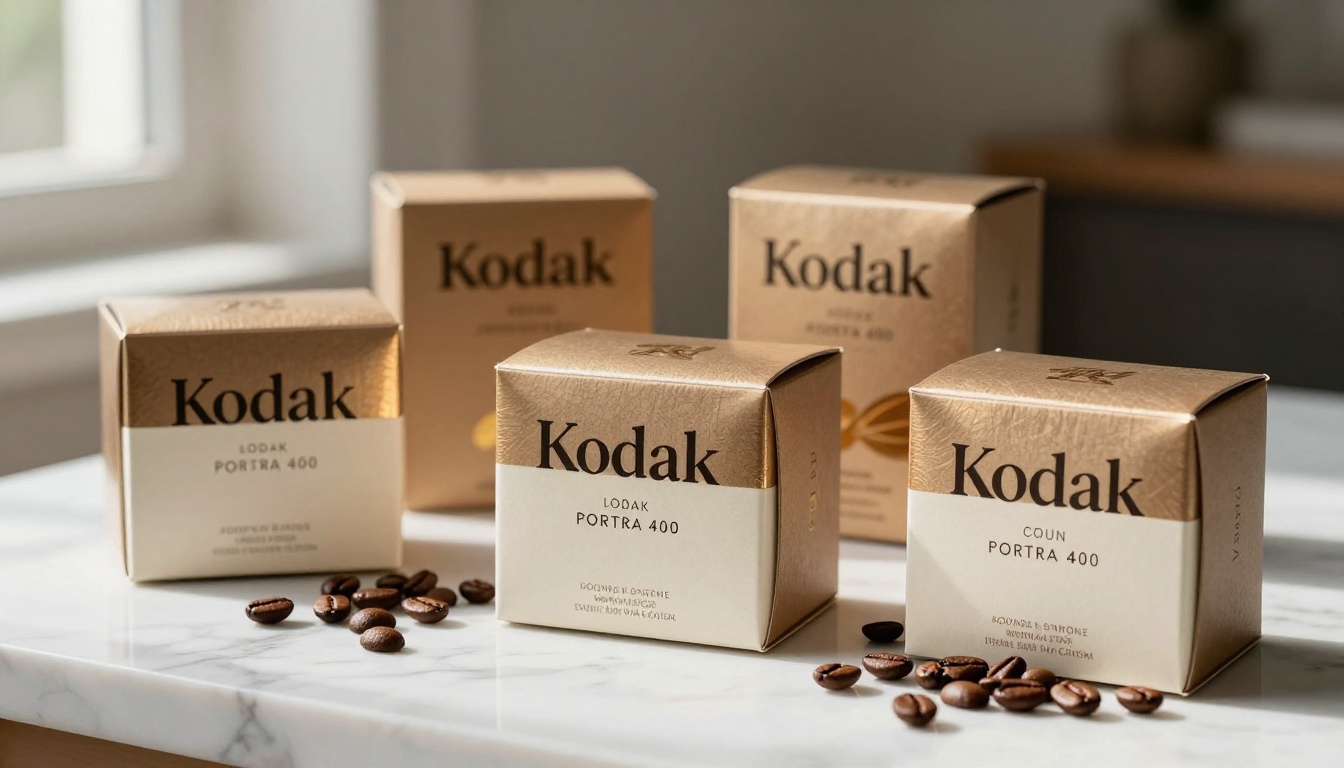
مفاهيم تغليف المنتجات: تُصيَّر أسماء العلامات القصيرة وملصقات الوزن أو الحجم على صور التغليف بدقة كافية لإيصال المفهوم بوضوح في مراجعات التصميم المبكرة.
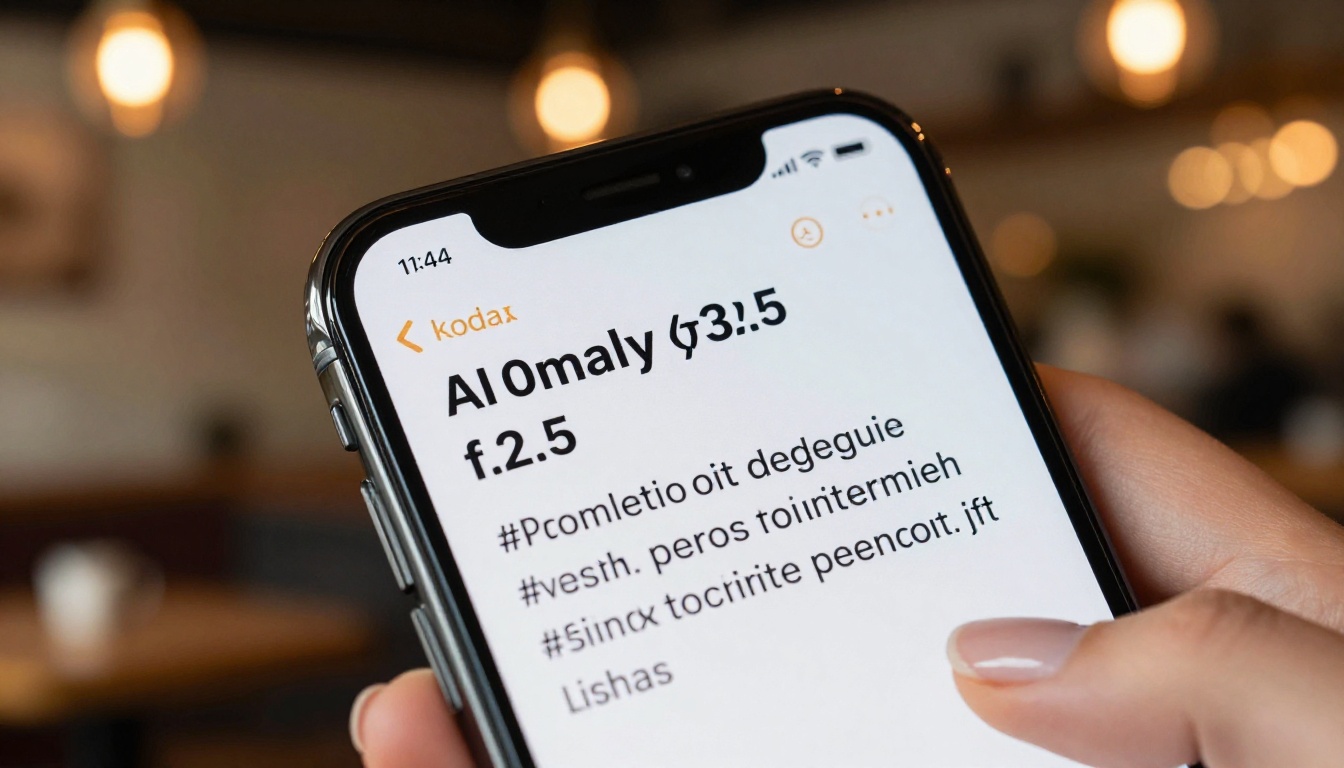
محتوى وسائل التواصل الاجتماعي: مسوّدات المنشورات مع تراكبات نصية من 3 إلى 5 كلمات، أو وسوم، أو تعليقات قصيرة موثوقة للغاية. ويمكن لفرق المحتوى إنتاج عشرات المتغيرات البصرية بسرعة.
اللافتات وإرشاد الاتجاهات: توليد مشاهد داخلية أو خارجية واقعية بلافتات موسومة مثل "EXIT" و"RECEPTION" و"LEVEL 2" يعمل بثبات في التصوير المعماري والعروض التقديمية.
أغلفة الكتب والمجلات: العناوين من 1 إلى 4 كلمات الموضوعة بشكل بارز على صورة مولّدة تخرج الآن بشكل صحيح في معظم التوليدات، ما يجعلها اختصارًا حقيقيًا للمصممين الذين ينتجون مفاهيم الأغلفة.
المواد الخاصة بالفعاليات: أصبحت النشرات والملصقات التي تحمل أسماء الفعاليات والتواريخ والمواقع نقاط بداية قابلة للاستخدام حين يكون النص موجزًا.
كيف تكتب أمرًا نصيًا للحصول على نص دقيق
تؤثر طريقة كتابة الأمر النصي تأثيرًا مباشرًا في دقة تصيير النص. وهذه الاستراتيجيات تعمل باستمرار:
ضع النص بين علامتي اقتباس في أمرك النصي. هذا يشير إلى النموذج بأن السلسلة الموجودة بداخله مقصودة كنص مرئي حرفي. يعطي "واجهة متجر بلافتة مكتوب عليها "BARISTA"" نتائج أفضل من "واجهة متجر بلافتة BARISTA".
حدّد السياق الطباعي. صف سماكة الخط واللون والموضع. عبارة مثل "حروف عريضة بالأحرف الكبيرة باللون الأبيض" تمنح النموذج قيودًا أكثر ليعمل ضمنها، وتميل إلى إنتاج مخرج أنظف.
افصل وصف الصورة عن محتوى النص. الأوامر التي تميّز بوضوح بين "شكل المشهد" و"النص الظاهر فيه" تميل إلى إنتاج أخطاء أقل من الأوامر التي يمتزج فيها النص بالوصف البصري.
اطلب كلمات أقل لكل عنصر نصي. إذا كنت تحتاج إلى ملصق يضم عدة كتل نصية، فغالبًا ما يكون من الأفضل توليد صور منفصلة للأقسام المختلفة ثم دمجها، بدلًا من طلب تخطيط متعدد الأسطر معقد في توليد واحد.
كرّر المحاولة باستخدام قيم البذرة. عندما تجد توليدًا يكون فيه النص صحيحًا في معظمه، استخدم قيمة البذرة نفسها لإعادة التوليد بجودة أعلى أو مع تعديلات طفيفة على الأمر النصي. ومن الأرجح أن تحافظ على دقة النص إذا بقيت قيمة البذرة العشوائية ثابتة.
💡 فكّر في كتابة الأوامر النصية بوصفها تعليمات تنضيد طباعي لا وصفًا بصريًا. فالتحديد يصنع الدقة.
GPT Image 2.0 مقابل المولّدات الأخرى القادرة على كتابة النصوص
شهد المشهد التنافسي لتصيير النصوص في صور الذكاء الاصطناعي تغيرًا سريعًا. وإليك موقع GPT Image 2.0 مقارنةً بالأدوات الأخرى التي يستخدمها الناس عادةً:
| النموذج | النص القصير | النص الطويل | غير اللاتينية | التحكم في الأسلوب |
|---|
| GPT Image 2.0 | ممتاز | متوسط | جزئي | جيد |
| Midjourney v6 | جيد | ضعيف | ضعيف | جيد |
| Adobe Firefly | جيد | متوسط | محدود | ممتاز |
| FLUX.1 Dev | متوسط | ضعيف | ضعيف | جيد |
| Ideogram 2.0 | ممتاز | جيد | متوسط | متوسط |
بنى Ideogram سمعته تحديدًا على دقة النص، ويظل بديلًا قويًا للحالات التي تتطلب تصييرًا متّسقًا للنصوص الطويلة. ويقدّم Adobe Firefly أكثر التكاملات موثوقية مع أدوات التصميم الاحترافية. أما ميزة GPT Image 2.0 فتكمن في الجمع بين دقة النص والالتزام بالتعليمات في المشاهد المعقدة الموصوفة بتفصيل.
كيف تستخدم PicassoIA لتوليد الصور الغنية بالنصوص
يمنحك PicassoIA وصولًا إلى نماذج قوية لتحويل النص إلى صورة، يمكنك استخدامها الآن لتجربة تصيير النصوص في مشاريعك الخاصة. وقد صُمّم مولّد PicassoIA Image لهذا النوع تحديدًا من العمل الإبداعي، ويتيح لك P Image Trainer أن تذهب أبعد من ذلك عبر تدريب أنماط مخصصة فوق النموذج الأساسي.
الخطوة 1: افتح نموذج PicassoIA Image وابدأ بوصف واضح للمشهد.
الخطوة 2: أضف مواصفة النص بين علامتي اقتباس داخل الأمر النصي. على سبيل المثال: "ملصق منتج لعلامة عناية بالبشرة مكتوب عليه "LUMINA"، تغليف أبيض بسيط، إضاءة استوديو ناعمة، واقعي كالصور الفوتوغرافية."
الخطوة 3: اضبط نسبة العرض إلى الارتفاع على 16:9 للمسوّدات الإعلانية، أو 1:1 لمحتوى وسائل التواصل الاجتماعي.
الخطوة 4: ولّد من 4 إلى 8 تنويعات، واختر التنويع الذي يحقق أدق تصيير للنص.
الخطوة 5: للحصول على تنويعات متّسقة في الأسلوب لأفضل نتيجة لديك، جرّب Flux Redux Dev على PicassoIA. يبني النموذج على مراجع بصرية موجودة مع الحفاظ على تماسك التكوين، وهذا مفيد حين تحتاج إلى نص في مشهد يتطابق مع هوية بصرية راسخة.
ما الذي يعنيه ذلك للمصممين وفرق المحتوى
لا يعني الأثر العملي لقدرات GPT Image 2.0 النصية أن المصممين لم يعودوا مطلوبين. بل يعني أن مرحلة المسودة الأولى في إنشاء المحتوى المرئي قد تغيّرت جذريًا.
كان توليد مجموعة من 20 تنويعًا لمسوّدات تسويقية لعرض على عميل يستغرق ساعات من العمل: إنشاء المشاهد، وجلب الصور من المكتبات، ودمج النص لاحقًا. ومع تصيير موثوق للنصوص في توليد الذكاء الاصطناعي، تتقلص مرحلة المسودة الأولى بشكل كبير.
يبدو سير العمل الجديد هكذا:
- استخدم توليد الصور بالذكاء الاصطناعي مع الأوامر النصية لإنتاج من 15 إلى 20 تنويعًا تجريبيًا خامًا في أقل من ساعة.
- اختر أقوى 3 إلى 5 مفاهيم بناءً على التكوين والنبرة ودقة النص.
- طوّر النتيجة في أداة تصميم، مع تصحيح أي أخطاء في النص، وضبط التنضيد الطباعي، وإضافة خطوط خاصة بالعلامة التجارية عند الحاجة.
- اعرض نسخًا مصقولة بُنيت على أسس مولّدة بالذكاء الاصطناعي.
لا يتعلق الأمر باستبدال مرحلة التصميم، بل بضغط مرحلة الاستكشاف حتى تقضي فرق الإبداع وقتًا أطول في تطوير الأفكار القوية، ووقتًا أقل في إنتاج التنويعات الأولية من الصفر.
تجعل تحسينات الدقة في GPT Image 2.0 تلك المرحلة الأولى المضغوطة مفيدة فعلًا، لا مجرد تقريب بصري. فحين يكون النص في نموذجك صحيحًا بالفعل، يمكنك عرضه على صاحب مصلحة دون أي تحفّظ.
جرّبه بنفسك على PicassoIA
إذا أردت أن تجرّب ذلك بنفسك، فإن PicassoIA يمنحك وصولًا مباشرًا إلى الأدوات التي تجعل ذلك ممكنًا. ابدأ مع نموذج PicassoIA Image، واكتب أمرًا نصيًا يتضمن كلمة أو عبارة محددة تريد أن تظهر في الصورة. استخدم تقنية الاقتباس الموضحة أعلاه. ولّد بضع اختلافات وشاهد كيف يظهر النص.
وللحصول على مخرجات أكثر تجريبية أو أسلوبًا، يتيح نموذج Flux Redux Dev البناء على مراجع بصرية موجودة مع الحفاظ على تماسك التكوين، وهذا مفيد حين تحتاج إلى نص في مشهد يتطابق مع هوية بصرية راسخة.
تتحرك التقنية بسرعة. ما كان يتطلب ساعات من عمل ما بعد الإنتاج قبل عامين يخرج الآن من أمر نصي واحد خلال ثوانٍ. وتمنحك الأدوات المتاحة على PicassoIA اليوم الوصول إلى طليعة هذا التحول، دون الحاجة إلى إعداد وصول API، أو إدارة النقاط، أو تثبيت أي شيء على جهازك.
افتح المتصفح، واكتب أمرًا نصيًا، وشاهد ما سيخرج. قد يكون النص مقروءًا فعلًا.


