Durante anos, os geradores de imagem por IA tiveram uma fraqueza evidente que designers, profissionais de marketing e criadores de conteúdo aprenderam a contornar: não conseguiam renderizar texto legível. Cada logotipo virava um redemoinho de pseudoletras. Cada placa em uma vitrine gerada parecia saída de um sonho meio esquecido. Outdoors, embalagens, cardápios e mockups de redes sociais sofriam o mesmo destino: no momento em que você precisava de palavras reais dentro de uma imagem sintética, o resultado desmoronava.
O GPT Image 2.0, integrado à suíte GPT-4o da OpenAI, adota uma abordagem estruturalmente diferente para esse problema. Os resultados não são perfeitos, mas são significativamente melhores do que qualquer coisa produzida na era dos modelos de difusão.
Por que o texto sempre falhava nas imagens de IA
A causa raiz era arquitetural. Modelos de difusão tradicionais como Stable Diffusion, SDXL e o Midjourney das primeiras versões foram treinados com pares de imagem e legenda, nos quais o modelo aprendia padrões visuais de forma estatística. Os caracteres de texto, do ponto de vista do modelo, eram apenas mais uma textura visual, nada diferente de pelo, casca de árvore ou trama de tecido.
O modelo nunca "soube" de fato que um "A" era um "A". Ele sabia que pixels dispostos em certa formação triangular tendem a aparecer ao lado de pixels que parecem uma barra transversal. Essa imitação estatística funcionava bem o bastante para fins decorativos, mas entrava em colapso no momento em que a legibilidade era exigida.
Os três modos de falha foram consistentes em quase todos os geradores:
- Caracteres embaralhados: Letras se fundiam, se partiam ou eram substituídas por formas plausíveis que não eram caracteres de fato.
- Desvio ortográfico: Mesmo quando cada caractere individual parecia correto, as palavras acumulavam erros ao longo do comprimento. "COFFEE" virava "COFFE3" ou "COFFFE".
- Linha de base inconsistente: As letras flutuavam em alturas diferentes, criando um texto que parecia feito à mão da pior maneira possível.
💡 Este não era um problema dos dados de treinamento. Era um problema de representação. Os modelos não tinham um conceito interno de "uma palavra" como unidade discreta.
O que o GPT Image 2.0 mudou
O GPT Image 2.0 não opera apenas como um modelo de difusão. Ele é integrado às capacidades de compreensão de linguagem do GPT-4o, o que significa que o sistema que gera a imagem tem uma compreensão explícita, em nível de token, do texto que está tentando renderizar.
Quando você pede "uma placa de cafeteria que diz OPEN", o componente de modelo de linguagem analisa "OPEN" como quatro caracteres específicos em uma sequência específica, e então instrui o processo de síntese de imagem a produzir esses caracteres nessa ordem. A geração visual é limitada pela especificação linguística de uma forma que os pipelines anteriores nunca tentaram.
Isso às vezes é descrito como uma arquitetura híbrida: parte modelo de linguagem, parte sintetizador de imagem, com o modelo de linguagem desempenhando um papel diretivo, e não apenas sendo usado na etapa de codificação do prompt.
O que isso possibilita:
| Capacidade | Modelos anteriores | GPT Image 2.0 |
|---|
| Palavras curtas isoladas | Sucesso ocasional | Consistente |
| Frases de várias palavras | Raro | Confiável |
| Nomes de marcas e logotipos | Quase nunca | Frequentemente preciso |
| Frases longas | Falhou | Sucesso parcial |
| Números e símbolos | Inconsistente | Quase sempre correto |
| Idiomas misturados | Ruim | Melhorando |
Como ele realmente lê os caracteres
O mecanismo por trás da renderização de texto do GPT Image 2.0 envolve o modelo tratando o texto como uma intenção semântica, e não como um padrão visual. Veja o que isso significa na prática:
Quando o sistema processa um prompt que pede texto visível, ele:
- Identifica a string de texto como um elemento discreto com composição específica de caracteres.
- Planeja o layout tipográfico, incluindo peso da fonte, tamanho em relação à imagem, posicionamento e alinhamento da linha de base, como uma especificação espacial.
- Orienta a síntese da imagem para produzir pixels que atendam tanto à estética visual da cena quanto aos requisitos de precisão dos caracteres.
- Realiza verificação implícita durante a geração para reduzir o desvio de caracteres em sequências mais longas.
Isso é significativamente diferente de pedir a um modelo de difusão que "preveja como o texto parece" e torcer para que a média estatística de milhões de imagens de treinamento produza algo legível.
💡 Pense assim: os modelos anteriores sonhavam o texto. O GPT Image 2.0 o escreve e depois o desenha.
O modelo também se beneficia de suas capacidades de seguir instruções. Ele pode responder a prompts como "use fonte sans-serif em negrito" ou "o texto deve ser branco sobre um fundo escuro" e, de fato, respeitar essas instruções de estilo com razoável precisão.
O problema do limite de caracteres
A precisão diminui com o tamanho. Este é um dos padrões mais claros no comportamento de renderização de texto do GPT Image 2.0.
Strings curtas, de 1 a 6 caracteres, são renderizadas com alta fidelidade na maioria dos casos. Um nome de produto como "NOVA" ou um rótulo como "SALE" aparecerá corretamente na grande maioria das gerações.
Strings médias, de 7 a 15 caracteres, têm sucesso com frequência, mas com ocasionais substituições de letras ou irregularidades de espaçamento. "FRAGILE" e "HAND MADE" funcionam bem. "SATISFACTION" às vezes perde uma letra.
Strings longas, com mais de 20 caracteres, são onde as coisas se tornam imprevisíveis. Frases completas em uma imagem tendem a acumular erros conforme o processo de geração avança. O começo de uma frase costuma ser preciso; o final pode desviar.
Regras práticas para trabalhar com o modelo:
- Mantenha o texto na imagem em palavras curtas e de alto impacto quando a precisão for importante.
- Para textos mais longos, considere gerar a imagem sem texto e adicioná-lo depois, em uma ferramenta de design.
- Use o modelo para textos de tamanho médio em mockups em que a precisão pixel a pixel não seja o entregável final.
Onde ainda desmorona
Conhecer os casos de falha é tão útil quanto conhecer os pontos fortes. A renderização de texto do GPT Image 2.0 é impressionante em comparação com o que existia antes, mas tem pontos fracos consistentes:
Fontes de script e de caligrafia: O modelo tem dificuldade com estilos cursivos e caligráficos. As formas de letras interligadas criam ambiguidade sobre onde um caractere termina e outro começa, e a abordagem de caractere por caractere do modelo não lida bem com ligaduras.
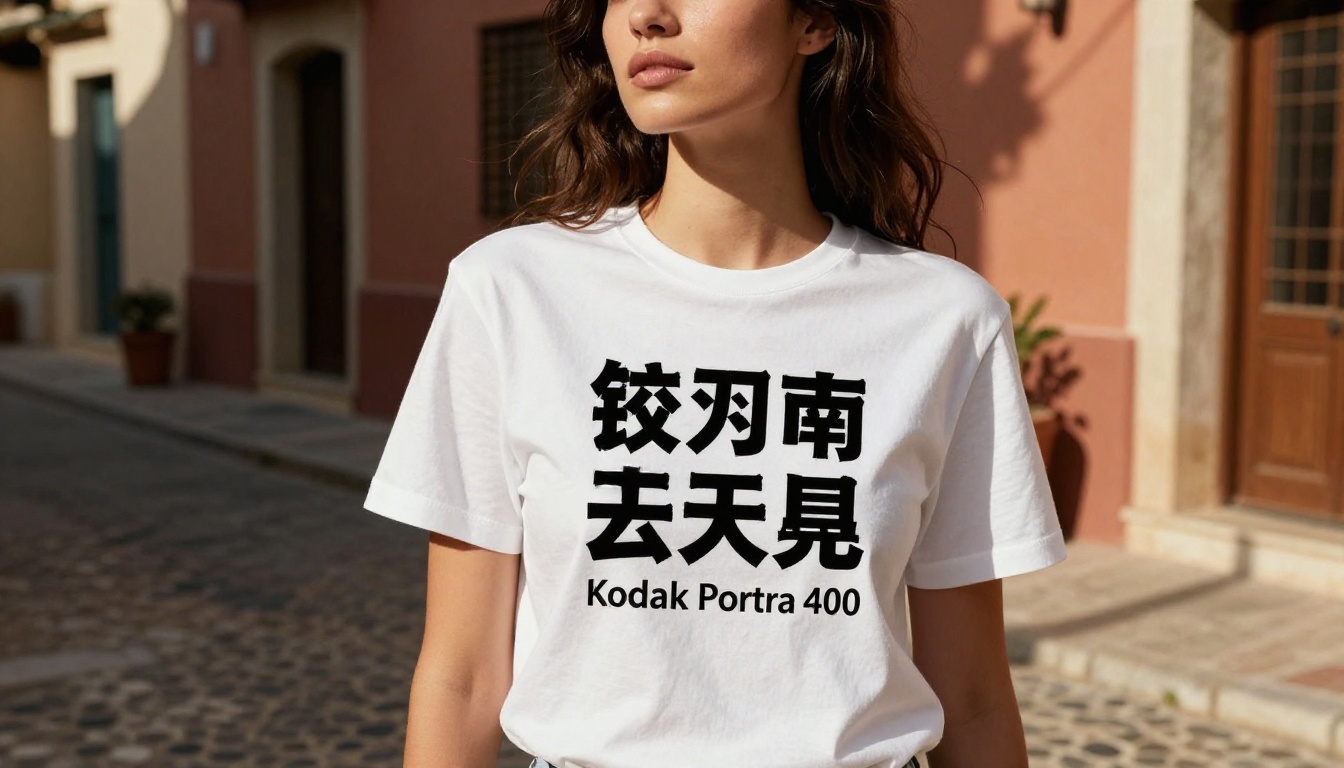
Escritas não latinas: Árabe, chinês, japonês, coreano e outros sistemas de escrita complexos são significativamente mais difíceis. O modelo pode produzir textos que parecem plausíveis à distância, mas contêm erros de caracteres que seriam imediatamente óbvios para um leitor nativo.
Estilização extrema: Textos muito distorcidos, em ângulos incomuns ou integrados a padrões complexos ficam mais difíceis de renderizar com precisão. A orientação de caracteres do modelo parece enfraquecer quando a complexidade visual da imagem ao redor é alta.
Texto pequeno: Textos que ocupam uma pequena parte da imagem, como letras miúdas em um rótulo, muitas vezes se degradam em ruído na resolução normal.
💡 Para trabalho profissional, trate o GPT Image 2.0 como seu primeiro rascunho, e não como o resultado final. Ele leva você 80% do caminho mais rápido do que qualquer ferramenta anterior.
Casos de uso reais que funcionam hoje
As aplicações práticas que se tornaram confiáveis merecem ser citadas especificamente, porque é aqui que o GPT Image 2.0 realmente muda os fluxos de trabalho:
Mockups de marketing: Gerar imagens de anúncio provisórias com títulos legíveis para apresentações a clientes. Antes, isso exigia que um designer compusesse o texto no Photoshop depois da geração. Agora, o primeiro rascunho costuma sair pronto para apresentação.
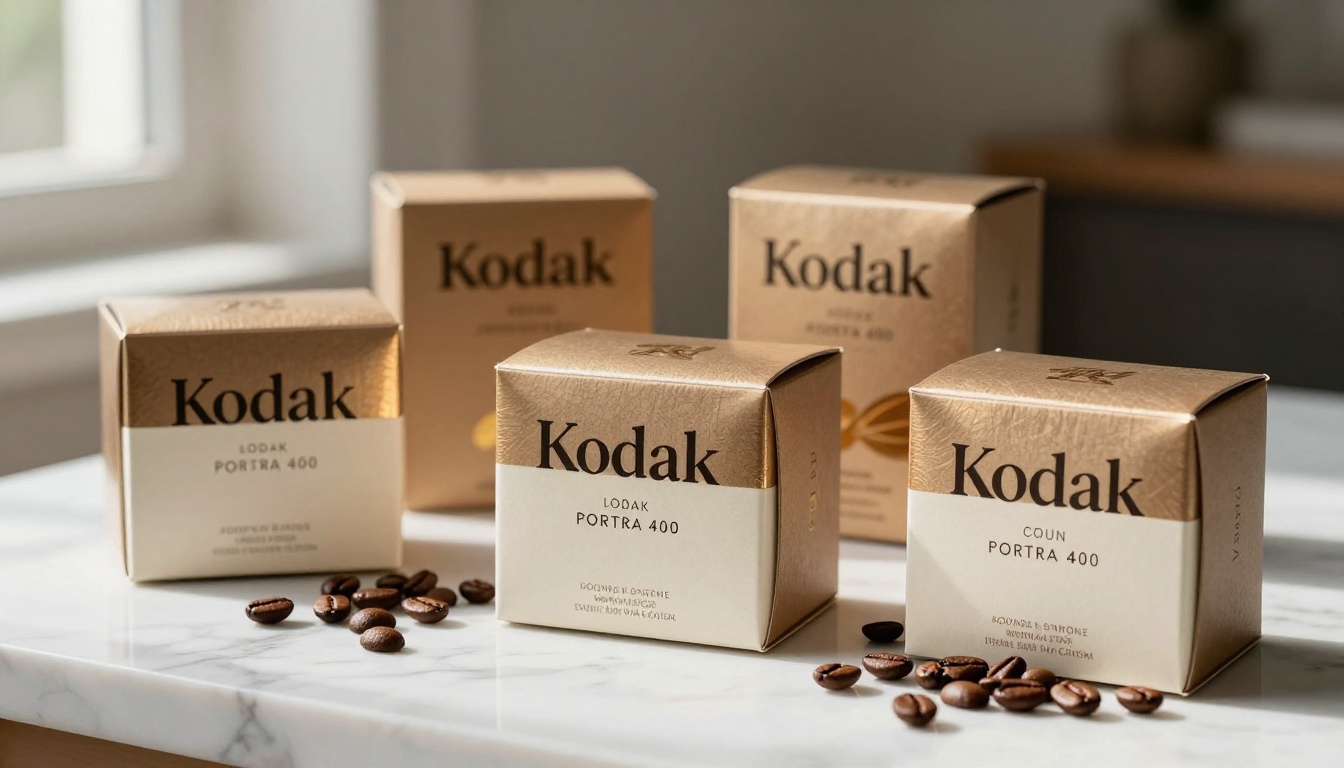
Conceitos de embalagem de produto: Nomes curtos de marcas e rótulos de peso ou volume em imagens de embalagens são renderizados com precisão suficiente para comunicar o conceito com clareza em revisões de design em estágio inicial.
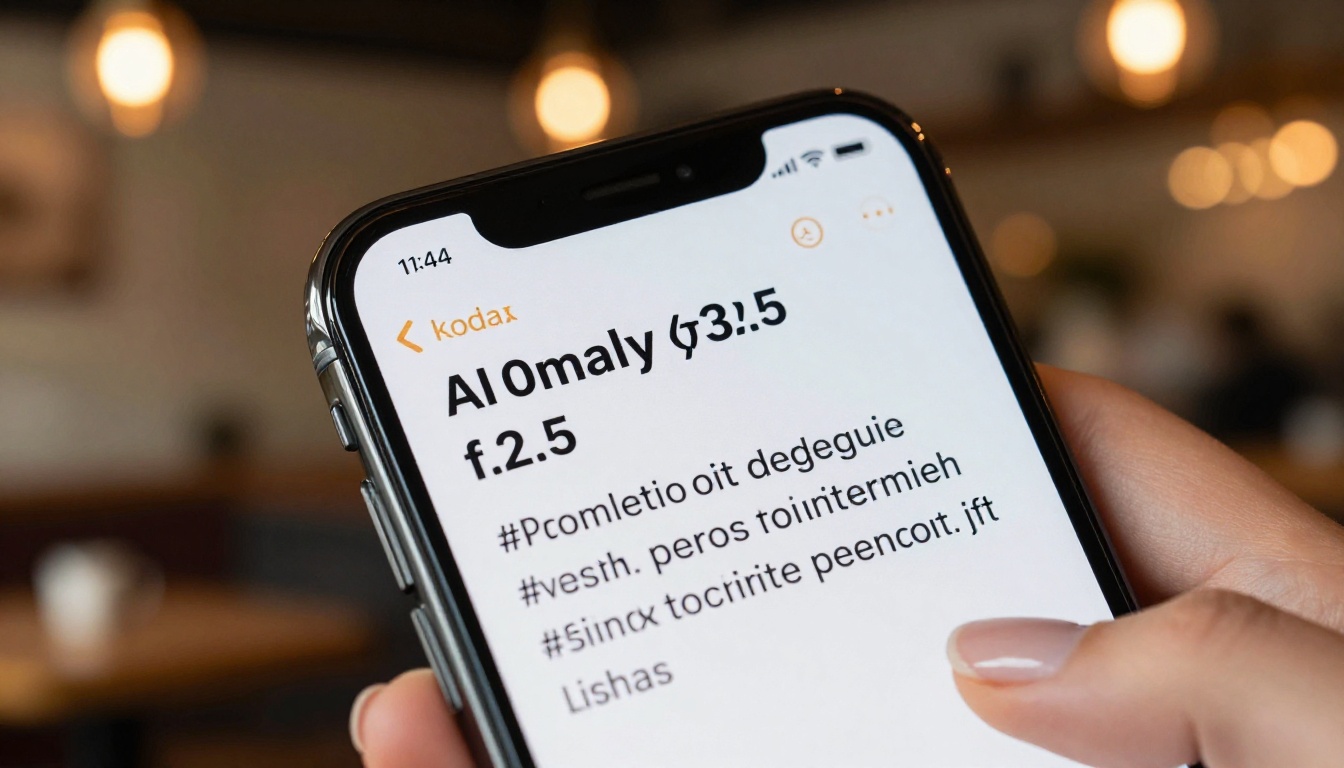
Conteúdo para redes sociais: Mockups de publicações com sobreposições de texto de 3 a 5 palavras, hashtags ou legendas curtas são altamente confiáveis. Equipes de conteúdo conseguem produzir dezenas de variantes visuais rapidamente.
Sinalização e orientação: Gerar cenas internas ou externas realistas com placas rotuladas, como "EXIT", "RECEPTION" e "LEVEL 2", funciona de forma consistente para visualização arquitetônica e apresentações.
Capas de livros e revistas: Títulos de 1 a 4 palavras posicionados em destaque sobre uma imagem gerada agora saem corretamente na maioria das gerações, o que representa um atalho genuíno para designers que produzem conceitos de capa.
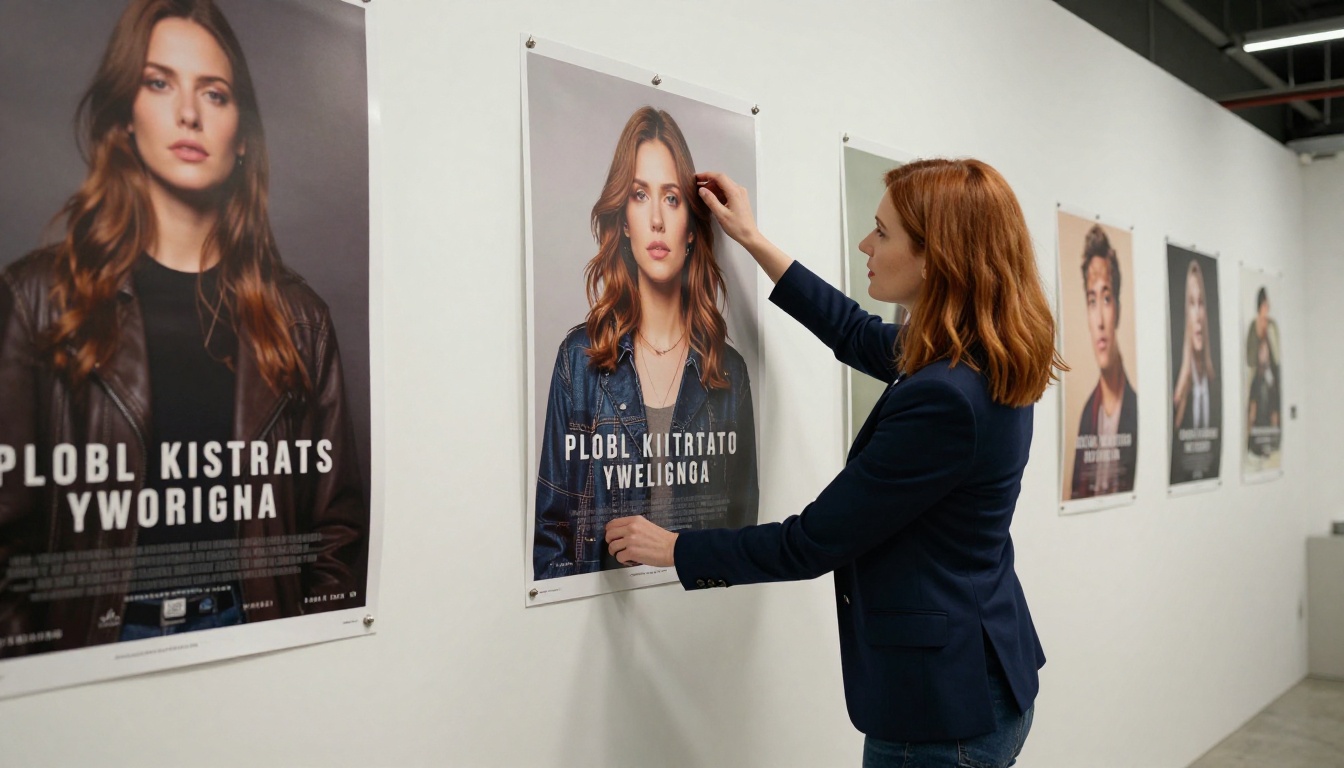
Materiais de evento: Panfletos e pôsteres com nomes de eventos, datas e locais tornaram-se pontos de partida viáveis quando o texto é mantido conciso.
Como fazer prompts para obter texto preciso
A forma como você escreve o prompt tem impacto direto na precisão com que o texto é renderizado. Estas estratégias funcionam de forma consistente:
Coloque o texto entre aspas no seu prompt. Isso sinaliza ao modelo que a string dentro dele é destinada a ser texto visual literal. "Uma vitrine com uma placa que diz "BARISTA"" tem melhor desempenho do que "uma vitrine com uma placa BARISTA".
Especifique o contexto tipográfico. Descreva peso da fonte, cor e posicionamento. "Letras maiúsculas brancas e em negrito" dá ao modelo mais restrições com que trabalhar e tende a produzir um resultado mais limpo.
Separe a descrição da imagem do conteúdo do texto. Prompts que distinguem claramente "como a cena se parece" de "qual texto aparece na cena" tendem a produzir menos erros do que prompts em que o texto se mistura à descrição visual.
Peça menos palavras por elemento de texto. Se você precisa de um pôster com vários blocos de texto, muitas vezes é melhor gerar imagens separadas para seções diferentes e compô-las, em vez de pedir um layout complexo com várias linhas em uma única geração.
Itere com seeds. Quando encontrar uma geração em que o texto está quase todo certo, use a mesma seed para gerar de novo com qualidade maior ou com pequenos ajustes no prompt. Você tem mais chances de preservar a precisão do texto se mantiver a seed aleatória constante.
💡 Pense no prompt de texto como uma instrução de composição tipográfica, e não como uma descrição visual. A especificidade gera precisão.
GPT Image 2.0 ou outros geradores com capacidade de texto
O cenário competitivo para renderização de texto em imagens de IA mudou rapidamente. Veja como o GPT Image 2.0 se posiciona em relação a outras ferramentas que as pessoas costumam usar:
| Modelo | Texto curto | Texto longo | Não latino | Controle de estilo |
|---|
| GPT Image 2.0 | Excelente | Moderado | Parcial | Bom |
| Midjourney v6 | Bom | Fraco | Ruim | Bom |
| Adobe Firefly | Bom | Moderado | Limitado | Excelente |
| FLUX.1 Dev | Moderado | Fraco | Ruim | Bom |
| Ideogram 2.0 | Excelente | Bom | Moderado | Moderado |
O Ideogram construiu sua reputação justamente com base na precisão de texto e continua sendo uma alternativa forte para casos de uso que exigem renderização consistente de textos longos. O Adobe Firefly oferece a integração mais confiável com ferramentas profissionais de design. A vantagem do GPT Image 2.0 é a combinação de precisão de texto com seguimento de instruções para cenas complexas e ricamente descritas.
Como usar o PicassoIA para geração de imagens com muito texto
O PicassoIA oferece acesso a modelos poderosos de texto para imagem que você pode usar agora mesmo para testar a renderização de texto em seus próprios projetos. O gerador PicassoIA Image foi feito exatamente para esse tipo de trabalho criativo, e o P Image Trainer permite ir além, treinando estilos personalizados sobre o modelo base.
Passo 1: Abra o modelo PicassoIA Image e comece com uma descrição clara da cena.
Passo 2: Adicione sua especificação de texto entre aspas dentro do prompt. Por exemplo: "Um rótulo de produto para uma marca de cuidados com a pele que diz "LUMINA", embalagem branca minimalista, iluminação suave de estúdio, fotorrealista."
Passo 3: Defina a proporção como 16:9 para mockups de anúncios, ou 1:1 para conteúdo de redes sociais.
Passo 4: Gere de 4 a 8 variações e selecione a que tiver a renderização de texto mais precisa.
Passo 5: Para variações com estilo consistente do seu melhor resultado, experimente o Flux Redux Dev no PicassoIA. Ele se baseia em referências visuais existentes mantendo a coerência de composição, o que é útil quando você precisa de texto em uma cena que combine com uma identidade visual já estabelecida.
O que isso significa para designers e equipes de conteúdo
A implicação prática das capacidades de texto do GPT Image 2.0 não é que os designers não são mais necessários. É que a fase de primeiro rascunho da criação de conteúdo visual mudou de forma fundamental.
Gerar um conjunto de 20 variantes de mockup de marketing para uma apresentação a um cliente costumava significar horas de trabalho: criar cenas, buscar imagens de banco, compor o texto depois. Com renderização de texto confiável na geração por IA, essa fase de primeiro rascunho se comprime drasticamente.
O novo fluxo de trabalho fica assim:
- Use a geração de imagens por IA com prompts de texto para produzir de 15 a 20 rascunhos conceituais em menos de uma hora.
- Selecione os 3 a 5 conceitos mais fortes com base em composição, tom e precisão do texto.
- Refine em uma ferramenta de design: corrija eventuais erros de texto, ajuste a tipografia e adicione fontes da marca, se necessário.
- Apresente versões finalizadas construídas sobre fundações geradas por IA.
Não se trata de substituir a etapa de design. Trata-se de comprimir a fase de exploração para que as equipes criativas gastem mais tempo refinando ideias fortes e menos tempo produzindo variações iniciais do zero.
As melhorias de precisão do GPT Image 2.0 tornam essa primeira fase comprimida genuinamente útil, e não apenas visualmente aproximada. Quando o texto do seu mockup realmente se lê corretamente, você pode mostrá-lo a um stakeholder sem ressalvas.
Experimente você mesmo no PicassoIA
Se você quiser experimentar isso na prática, o PicassoIA dá acesso direto às ferramentas que tornam isso possível. Comece com o modelo PicassoIA Image e escreva um prompt que inclua uma palavra ou frase específica que você quer ver na imagem. Use a técnica de aspas descrita acima. Gere algumas variações e veja como o texto aparece.
Para resultados mais experimentais ou estilizados, o modelo Flux Redux Dev permite construir sobre referências visuais existentes mantendo a coerência de composição, o que é útil quando você precisa de texto em uma cena que combine com uma identidade visual já estabelecida.
A tecnologia está avançando rápido. O que exigia horas de pós-produção há dois anos agora sai de um único prompt em segundos. As ferramentas disponíveis no PicassoIA hoje dão acesso à vanguarda dessa mudança, sem precisar configurar acesso à API, gerenciar créditos ou instalar nada localmente.
Abra um navegador, escreva um prompt e veja o que sai. O texto pode muito bem ser legível.


