Durante años, los generadores de imágenes con IA tuvieron una debilidad evidente que diseñadores, equipos de marketing y creadores de contenido aprendieron a sortear: no sabían generar texto legible. Cada logotipo se convertía en un remolino de pseudoletras. Cada cartel de un escaparate generado parecía sacado de un sueño que apenas se recordaba. Las vallas publicitarias, los envases, los menús y las maquetas de redes sociales sufrían todos el mismo destino: en cuanto necesitabas palabras reales dentro de una imagen sintética, el resultado se desmoronaba.
GPT Image 2.0, integrado en la suite GPT-4o de OpenAI, aborda este problema con un enfoque estructuralmente distinto. Los resultados no son perfectos, pero son notablemente mejores que todo lo que produjo la era de los modelos de difusión.
Por qué el texto siempre fallaba en las imágenes de IA
La causa raíz era arquitectónica. Los modelos de difusión tradicionales, como Stable Diffusion, SDXL y los primeros Midjourney, se entrenaron con pares de imagen y descripción en los que el modelo aprendía patrones visuales de forma estadística. Los caracteres de texto, desde la perspectiva del modelo, eran solo otra textura visual, sin diferencia con el pelaje, la corteza de un árbol o el tejido de una tela.
El modelo nunca llegó a "saber" que una "A" era una "A". Sabía que los píxeles dispuestos en cierta formación triangular tienden a aparecer junto a píxeles que parecen una barra horizontal. Esta imitación estadística funcionaba lo bastante bien con fines decorativos, pero se venía abajo en cuanto se necesitaba legibilidad.
Los tres modos de fallo fueron comunes en casi todos los generadores:
- Caracteres deformados: las letras se fusionaban, se partían o se sustituían por formas plausibles que no eran caracteres reales.
- Desvío ortográfico: aunque cada carácter individual pareciera correcto, las palabras acumulaban errores a lo largo de su longitud. "COFFEE" se convertía en "COFFE3" o "COFFFE".
- Línea de base irregular: las letras flotaban a alturas distintas, lo que daba un texto con aspecto artesanal en el peor sentido.
💡 Este no era un problema de datos de entrenamiento. Era un problema de representación. Los modelos no tenían ningún concepto interno de "una palabra" como unidad discreta.
Qué cambió con GPT Image 2.0
GPT Image 2.0 no funciona únicamente como un modelo de difusión. Está integrado con las capacidades de comprensión del lenguaje de GPT-4o, lo que significa que el sistema que genera la imagen tiene una comprensión explícita, a nivel de token, del texto que intenta representar.
Cuando le pides "un cartel de cafetería que diga OPEN", el componente de modelo de lenguaje interpreta "OPEN" como cuatro caracteres concretos en una secuencia específica y luego indica al proceso de síntesis de imagen que produzca esos caracteres en ese orden. La generación visual está restringida por la especificación lingüística de una forma que los pipelines anteriores nunca intentaron.
A veces se describe como una arquitectura híbrida: en parte modelo de lenguaje y en parte sintetizador de imágenes, donde el modelo de lenguaje cumple una función directiva y no se limita a intervenir en la fase de codificación del prompt.
Lo que esto permite:
| Capacidad | Modelos anteriores | GPT Image 2.0 |
|---|
| Palabras cortas sueltas | Éxito ocasional | Constante |
| Frases de varias palabras | Raro | Fiable |
| Marcas y logotipos | Casi nunca | Con frecuencia precisos |
| Frases largas | Fallaban | Éxito parcial |
| Números y símbolos | Irregular | En su mayoría correctos |
| Idiomas mezclados | Deficiente | Mejorando |
Cómo lee los caracteres en realidad
El mecanismo detrás de la generación de texto de GPT Image 2.0 consiste en tratar el texto como una intención semántica y no como un patrón visual. Esto es lo que significa en la práctica:
Cuando el sistema procesa un prompt que pide texto visible, hace lo siguiente:
- Identifica la cadena de texto como un elemento discreto con una composición de caracteres específica.
- Planifica la disposición tipográfica: grosor de la fuente, tamaño respecto a la imagen, posición y alineación de la línea de base, como una especificación espacial.
- Guía la síntesis de la imagen para producir píxeles que cumplan tanto la estética visual de la escena como los requisitos de precisión de los caracteres.
- Realiza una comprobación implícita durante la generación para reducir el desvío de caracteres en secuencias más largas.
Esto es notablemente distinto de pedirle a un modelo de difusión que "prediga cómo se ve el texto" y esperar que el promedio estadístico de millones de imágenes de entrenamiento produzca algo legible.
💡 Piénsalo así: los modelos anteriores soñaban el texto. GPT Image 2.0 lo escribe y después lo dibuja.
El modelo también se beneficia de sus capacidades de seguimiento de instrucciones. Puede responder a prompts como "usa una tipografía sans-serif en negrita" o "el texto debe ser blanco sobre un fondo oscuro" y cumplir esas indicaciones de estilo con razonable precisión.
El problema del límite de caracteres
La precisión disminuye con la longitud. Este es uno de los patrones más claros en el comportamiento de GPT Image 2.0 con el texto.
Las cadenas cortas, de 1 a 6 caracteres, se representan con alta fidelidad en la mayoría de los casos. Un nombre de producto como "NOVA" o una etiqueta como "SALE" aparecerán correctamente en la gran mayoría de las generaciones.
Las cadenas medias, de 7 a 15 caracteres, funcionan con frecuencia, pero con alguna que otra sustitución de letras o irregularidad en el espaciado. "FRAGILE" y "HAND MADE" salen bien. "SATISFACTION" a veces pierde una letra.
Las cadenas largas, de más de 20 caracteres, son las más impredecibles. Las frases completas en una imagen tienden a acumular errores a medida que avanza el proceso de generación. El principio de la frase suele ser exacto; el final puede desviarse.
Reglas prácticas para trabajar con el modelo:
- Limita el texto de la imagen a palabras cortas y de gran impacto cuando la precisión importa.
- Para textos más largos, considera generar la imagen sin texto y añadirlo después con una herramienta de diseño.
- Usa el modelo para textos de longitud media en maquetas en las que la precisión píxel a píxel no sea el entregable final.
Dónde sigue fallando
Conocer los casos de fallo es tan útil como conocer los puntos fuertes. La generación de texto de GPT Image 2.0 es impresionante en comparación con lo que había antes, pero tiene puntos débiles recurrentes:
Tipografías de script y manuscritas: el modelo tiene dificultades con los estilos cursivos y caligráficos. Las formas de letra conectadas generan ambigüedad sobre dónde termina un carácter y empieza otro, y el enfoque carácter a carácter del modelo no gestiona bien las ligaduras.
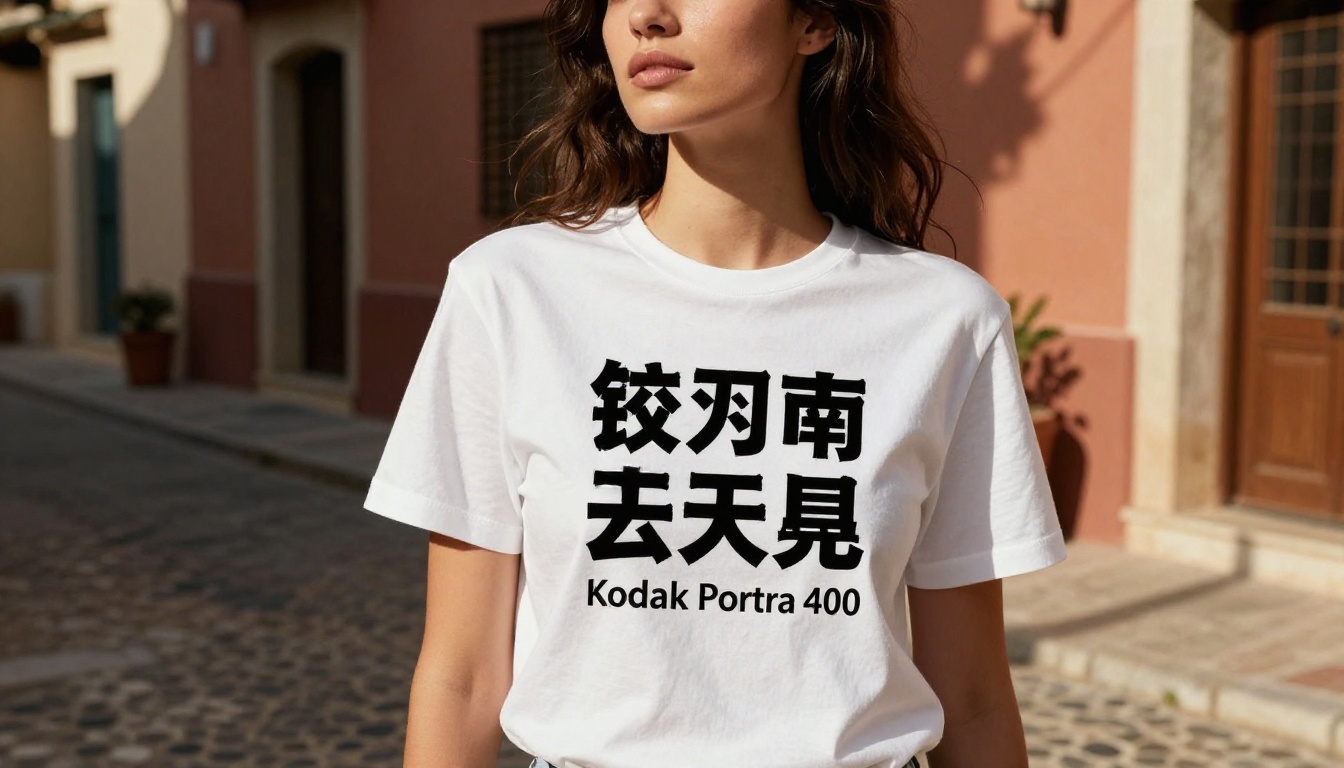
Escrituras no latinas: el árabe, el chino, el japonés, el coreano y otros sistemas de escritura complejos son bastante más difíciles. El modelo puede producir texto que parece plausible a distancia visual, pero que contiene errores de caracteres evidentes para un lector nativo.
Estilización extrema: el texto muy distorsionado, en ángulos inusuales o integrado en patrones complejos es más difícil de representar con precisión. La guía de caracteres del modelo parece debilitarse cuando la complejidad visual de la imagen que lo rodea es alta.
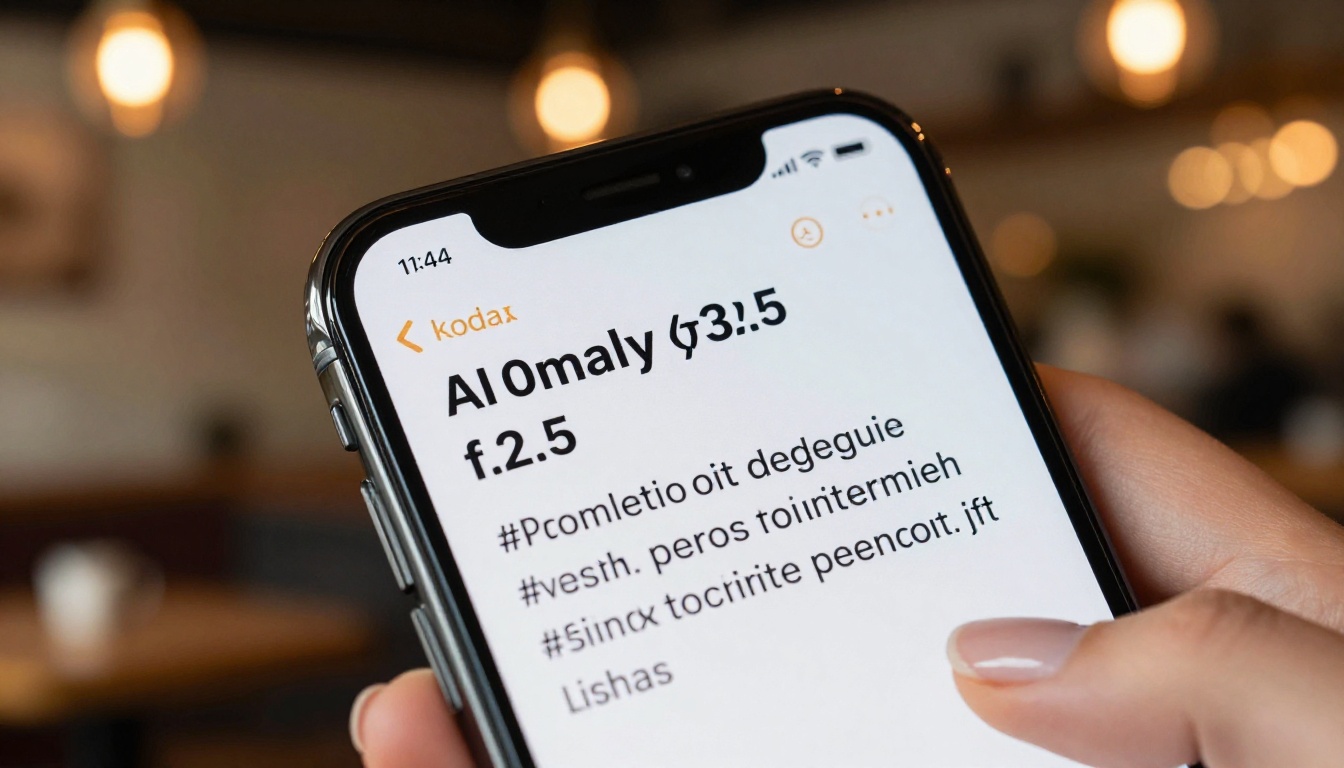
Texto diminuto: el texto que ocupa una parte pequeña de la imagen, como la letra fina de una etiqueta, a menudo se degrada hasta convertirse en ruido con una resolución normal.
💡 Para trabajos profesionales, trata GPT Image 2.0 como tu primer borrador, no como el resultado final. Te lleva el 80% del camino más rápido que cualquier herramienta anterior.
Casos de uso reales que ya funcionan
Merece la pena nombrar con precisión las aplicaciones prácticas que se han vuelto fiables, porque aquí es donde GPT Image 2.0 realmente cambia los flujos de trabajo:
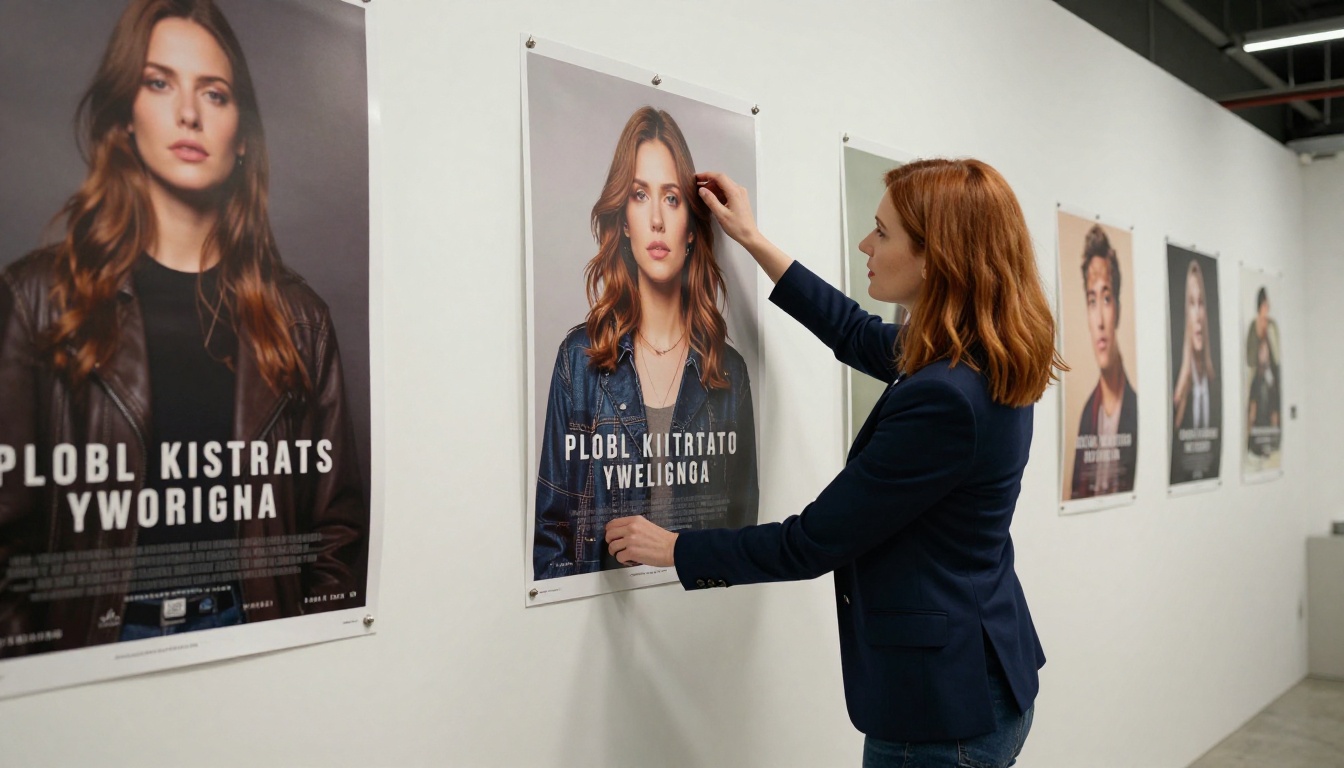
Maquetas de marketing: generar imágenes publicitarias de referencia con titulares legibles para presentaciones a clientes. Antes, un diseñador tenía que componer el texto en Photoshop después de generar la imagen. Ahora, el primer borrador a menudo sale listo para presentar.
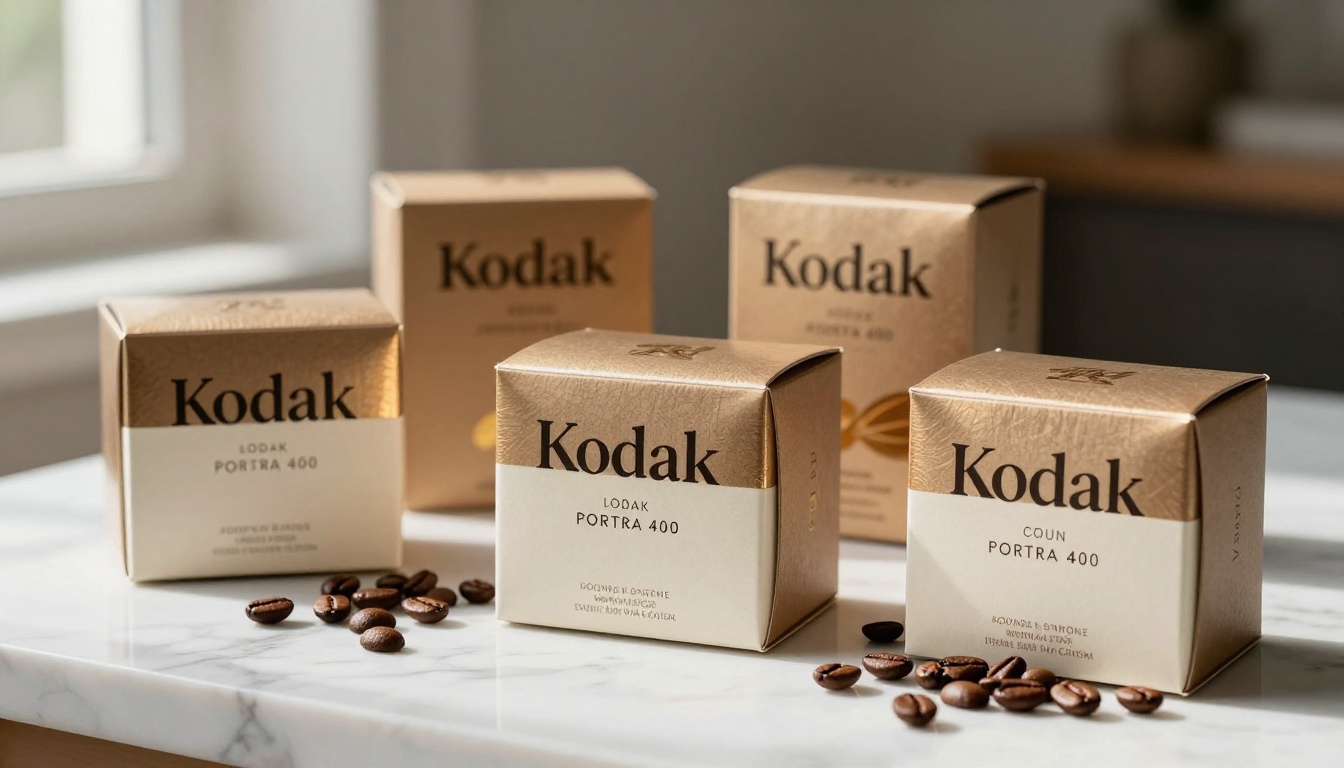
Conceptos de envases de producto: los nombres de marca cortos y las etiquetas de peso o volumen en las imágenes de envases se representan con la precisión suficiente para comunicar el concepto con claridad en las revisiones de diseño en fases tempranas.
Contenido para redes sociales: las maquetas de publicaciones con superposiciones de texto de 3 a 5 palabras, hashtags o pies de foto cortos son muy fiables. Los equipos de contenido pueden producir decenas de variantes visuales con rapidez.
Señalización y orientación: generar escenas realistas de interiores o exteriores con señalización como "EXIT", "RECEPTION" o "LEVEL 2" funciona de forma constante para la visualización arquitectónica y las presentaciones.
Portadas de libros y revistas: los títulos de 1 a 4 palabras colocados de forma destacada sobre una imagen generada salen ahora correctamente en la mayoría de las generaciones, lo que supone un atajo real para los diseñadores que preparan propuestas de portada.
Material para eventos: los folletos y los carteles con nombres de eventos, fechas y lugares se han convertido en puntos de partida viables cuando el texto es conciso.
Cómo pedir texto preciso en el prompt
La forma en que escribes el prompt influye directamente en la precisión con la que se representa el texto. Estas estrategias funcionan de forma constante:
Pon el texto entre comillas en tu prompt. Esto indica al modelo que la cadena que va dentro está pensada como texto visual literal. "Un escaparate con un cartel que diga "BARISTA"" funciona mejor que "un escaparate con un cartel BARISTA".
Especifica el contexto tipográfico. Describe el grosor de la fuente, el color y la colocación. "Letras mayúsculas blancas en negrita" le da al modelo más restricciones con las que trabajar y tiende a producir un resultado más limpio.
Separa la descripción de la imagen del contenido del texto. Los prompts que distinguen claramente entre "cómo es la escena" y "qué texto aparece en la escena" tienden a producir menos errores que los prompts en los que el texto se mezcla con la descripción visual.
Pide menos palabras por elemento de texto. Si necesitas un cartel con varios bloques de texto, a menudo es mejor generar imágenes separadas para cada sección y componerlas, en lugar de pedir un diseño complejo de varias líneas en una sola generación.
Itera con semillas. Cuando encuentres una generación en la que el texto es casi correcto, usa la misma semilla para regenerarla con mayor calidad o con pequeños ajustes en el prompt. Es más probable que conserves la precisión del texto si la semilla aleatoria se mantiene constante.
💡 Piensa en el prompting de texto como si dieras una instrucción de composición tipográfica, no una descripción visual. La especificidad produce precisión.
GPT Image 2.0 frente a otros generadores capaces de generar texto
El panorama competitivo de la generación de texto en imágenes con IA ha cambiado muy rápido. Así se sitúa GPT Image 2.0 frente a otras herramientas que la gente usa habitualmente:
| Modelo | Texto corto | Texto largo | No latino | Control de estilo |
|---|
| GPT Image 2.0 | Excelente | Moderado | Parcial | Bueno |
| Midjourney v6 | Bueno | Deficiente | Malo | Bueno |
| Adobe Firefly | Bueno | Moderado | Limitado | Excelente |
| FLUX.1 Dev | Moderado | Deficiente | Malo | Bueno |
| Ideogram 2.0 | Excelente | Bueno | Moderado | Moderado |
Ideogram se ganó su reputación precisamente gracias a la precisión del texto y sigue siendo una alternativa sólida para los casos de uso que requieren una generación de texto largo constante. Adobe Firefly ofrece la integración más fiable con las herramientas de diseño profesional. La ventaja de GPT Image 2.0 es la combinación de precisión en el texto con el seguimiento de instrucciones para escenas complejas y muy descritas.
Cómo usar PicassoIA para generar imágenes con mucho texto
PicassoIA te da acceso a potentes modelos de texto a imagen que puedes usar ya mismo para probar la generación de texto en tus propios proyectos. El generador PicassoIA Image está pensado justo para este tipo de trabajo creativo, y el P Image Trainer te permite ir más allá entrenando estilos propios sobre el modelo base.
Paso 1: abre el modelo PicassoIA Image y empieza con una descripción clara de la escena.
Paso 2: añade tu especificación de texto entre comillas dentro del prompt. Por ejemplo: "Una etiqueta de producto para una marca de cuidado de la piel que diga "LUMINA", envase blanco minimalista, iluminación suave de estudio, fotorrealista."
Paso 3: fija la relación de aspecto en 16:9 para maquetas publicitarias, o en 1:1 para contenido de redes sociales.
Paso 4: genera de 4 a 8 variaciones y selecciona la que tenga la generación de texto más precisa.
Paso 5: para variaciones con un estilo coherente a partir de tu mejor resultado, prueba Flux Redux Dev en PicassoIA. Parte de referencias visuales existentes y mantiene la coherencia compositiva, lo que resulta útil cuando necesitas texto en una escena que encaje con una identidad visual ya establecida.
Qué significa esto para diseñadores y equipos de contenido
La implicación práctica de las capacidades de texto de GPT Image 2.0 no es que los diseñadores ya no hagan falta. Es que la fase de primer borrador de la creación de contenido visual ha cambiado por completo.
Generar un conjunto de 20 variantes de maquetas de marketing para una presentación a un cliente solía suponer horas de trabajo: crear escenas, buscar imágenes de stock, componer el texto en la postproducción. Con una generación de texto fiable en la IA, esa fase de primer borrador se comprime de forma drástica.
El nuevo flujo de trabajo es así:
- Usa la generación de imágenes con IA y prompts de texto para producir de 15 a 20 conceptos aproximados en menos de una hora.
- Selecciona los 3 a 5 conceptos más sólidos según la composición, el tono y la precisión del texto.
- Refina en una herramienta de diseño: corrige los errores de texto, ajusta la tipografía y añade fuentes específicas de la marca si hace falta.
- Presenta versiones pulidas que se construyeron sobre bases generadas con IA.
No se trata de sustituir la fase de diseño. Se trata de comprimir la fase de exploración para que los equipos creativos dediquen más tiempo a refinar las ideas fuertes y menos a producir variaciones iniciales desde cero.
Las mejoras de precisión de GPT Image 2.0 hacen que esa primera fase comprimida sea realmente útil y no solo visualmente aproximada. Cuando el texto de tu maqueta se lee correctamente, puedes enseñársela a un interesado sin ninguna advertencia.
Pruébalo tú mismo en PicassoIA
Si quieres probarlo tú mismo, PicassoIA te da acceso directo a las herramientas que hacen posible esto. Empieza con el modelo PicassoIA Image y escribe un prompt que incluya una palabra o frase concreta que quieras que aparezca en la imagen. Usa la técnica de las comillas descrita antes. Genera algunas variaciones y comprueba cómo sale el texto.
Para resultados más experimentales o estilizados, el modelo Flux Redux Dev te permite partir de referencias visuales existentes y mantener la coherencia compositiva, lo que resulta útil cuando necesitas texto en una escena que encaje con una identidad visual ya establecida.
La tecnología avanza rápido. Lo que hace dos años requería horas de postproducción ahora sale de un solo prompt en segundos. Las herramientas disponibles hoy en PicassoIA te dan acceso a la vanguardia de ese cambio sin necesidad de configurar la API, gestionar créditos ni instalar nada en tu equipo.
Abre un navegador, escribe un prompt y mira lo que sale. El texto podría incluso ser legible.


