Pendant des années, les générateurs d’images par IA ont souffert d’une faiblesse flagrante que les designers, les spécialistes du marketing et les créateurs de contenu ont appris à contourner : ils étaient incapables de rendre un texte lisible. Chaque logo se transformait en tourbillon de pseudo-lettres. Chaque enseigne d’une vitrine générée ressemblait à un rêve à moitié oublié. Les panneaux publicitaires, les emballages, les menus et les maquettes de réseaux sociaux subissaient tous le même sort : dès qu’il fallait de vrais mots dans une image de synthèse, le résultat s’effondrait.
GPT Image 2.0, intégré à la suite GPT-4o d’OpenAI, adopte une approche structurellement différente pour résoudre ce problème. Les résultats ne sont pas parfaits, mais ils sont nettement meilleurs que tout ce que l’ère des modèles de diffusion a produit.
Pourquoi le texte échouait toujours dans les images par IA
La cause profonde était architecturale. Les modèles de diffusion traditionnels comme Stable Diffusion, SDXL et les premières versions de Midjourney ont été entraînés sur des paires image-légende, où le modèle apprenait les motifs visuels de manière statistique. Les caractères du texte, du point de vue du modèle, n’étaient qu’une texture visuelle parmi d’autres, sans différence avec la fourrure, l’écorce ou le tissage d’un tissu.
Le modèle ne « savait » jamais réellement qu’un « A » était un « A ». Il savait que des pixels disposés selon une certaine formation triangulaire tendent à apparaître à côté de pixels ressemblant à une barre transversale. Cette imitation statistique fonctionnait assez bien à des fins décoratives, mais s’effondrait dès que la lisibilité était requise.
Les trois modes de défaillance étaient constants chez presque tous les générateurs :
- Lettres déformées : des lettres fusionnaient, se scindaient ou étaient remplacées par des formes plausibles qui n’étaient pas de vrais caractères.
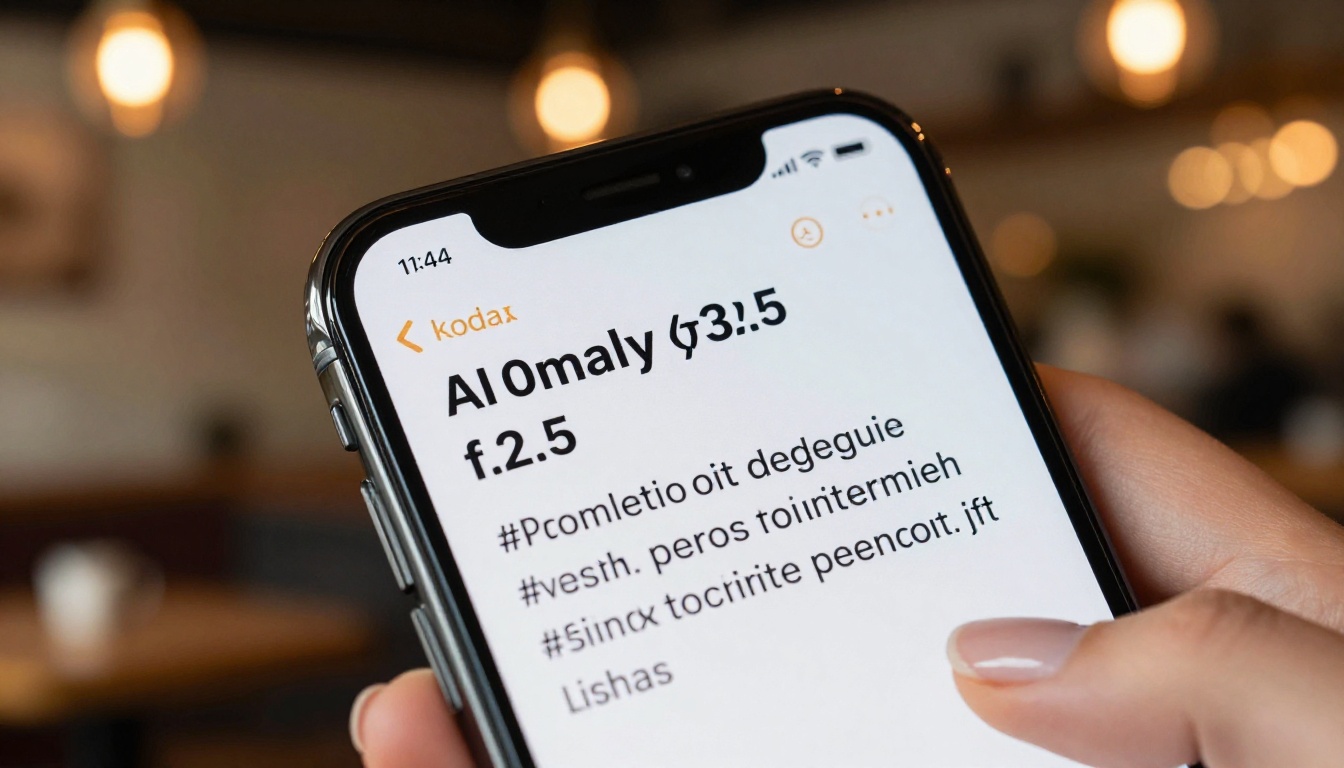
- Dérive orthographique : même lorsque les caractères individuels paraissaient corrects, les erreurs s’accumulaient sur la longueur des mots. « COFFEE » devenait « COFFE3 » ou « COFFFE ».
- Ligne de base instable : les lettres flottaient à des hauteurs différentes, produisant un texte qui avait l’air fait à la main de la pire des manières.
💡 Ce n’était pas un problème de données d’entraînement. C’était un problème de représentation. Les modèles n’avaient aucune notion interne de « mot » en tant qu’unité discrète.
Ce que GPT Image 2.0 a changé
GPT Image 2.0 ne fonctionne pas uniquement comme un modèle de diffusion. Il est intégré aux capacités de compréhension du langage de GPT-4o, ce qui signifie que le système qui génère l’image dispose d’une compréhension explicite, au niveau du token, du texte qu’il cherche à rendre.
Lorsque vous lui demandez « une enseigne de café qui affiche OPEN », le composant de modèle de langage analyse « OPEN » comme quatre caractères précis dans un ordre précis, puis demande au processus de synthèse d’image de produire ces caractères dans cet ordre. La génération visuelle est contrainte par la spécification linguistique d’une manière que les pipelines précédents n’avaient jamais tentée.
On décrit parfois cela comme une architecture hybride : en partie modèle de langage, en partie synthétiseur d’image, le modèle de langage jouant un rôle directeur plutôt que d’être simplement utilisé à l’étape d’encodage du prompt.
Ce que cela permet :
| Capacité | Modèles précédents | GPT Image 2.0 |
|---|
| Mots courts isolés | Réussite occasionnelle | Constante |
| Expressions de plusieurs mots | Rare | Fiable |
| Noms de marques et logos | Presque jamais | Souvent exact |
| Phrases longues | Échec | Réussite partielle |
| Chiffres et symboles | Inconstant | Globalement correct |
| Langues mélangées | Médiocre | En progrès |
Le mécanisme du rendu de texte de GPT Image 2.0 repose sur le fait que le modèle traite le texte comme une intention sémantique plutôt que comme un motif visuel. Voici ce que cela signifie concrètement :
Lorsque le système traite un prompt demandant du texte visible, il :
- Identifie la chaîne de texte comme un élément discret à la composition de caractères précise.
- Planifie la mise en page typographique (graisse de la police, taille par rapport à l’image, positionnement et alignement de la ligne de base) sous forme de spécification spatiale.
- Guide la synthèse de l’image pour produire des pixels qui satisfont à la fois l’esthétique visuelle de la scène et les exigences d’exactitude des caractères.
- Effectue une vérification implicite pendant la génération afin de réduire la dérive des caractères sur les séquences plus longues.
Cela diffère nettement de la démarche consistant à demander à un modèle de diffusion de « prédire à quoi ressemble le texte » en espérant que la moyenne statistique de millions d’images d’entraînement produise quelque chose de lisible.
💡 Voyez-le ainsi : les modèles précédents rêvaient le texte. GPT Image 2.0 l’écrit, puis dessine le résultat.
Le modèle bénéficie aussi de ses capacités de suivi d’instructions. Il peut répondre à des prompts comme « utilise une police sans empattement en gras » ou « le texte doit être blanc sur fond sombre », et respecter ces consignes de style avec une précision raisonnable.
Le problème de la limite de caractères
La précision se dégrade avec la longueur. C’est l’un des schémas les plus nets du comportement de GPT Image 2.0 pour le rendu de texte.
Les chaînes courtes, de 1 à 6 caractères, sont rendues avec une grande fidélité dans la plupart des cas. Un nom de produit comme « NOVA » ou une étiquette comme « SALE » apparaîtra correctement dans la grande majorité des générations.
Les chaînes moyennes, de 7 à 15 caractères, réussissent souvent, mais avec parfois des substitutions de lettres ou des irrégularités d’espacement. « FRAGILE » et « HAND MADE » fonctionnent bien. « SATISFACTION » perd parfois une lettre.
Les chaînes longues, de plus de 20 caractères, sont le domaine de l’imprévisible. Les phrases complètes dans une image ont tendance à accumuler les erreurs au fil du processus de génération. Le début d’une phrase est généralement exact ; la fin peut dériver.
Règles pratiques pour travailler avec le modèle :
- Limitez le texte dans l’image à des mots courts et percutants lorsque la précision compte.
- Pour un texte plus long, envisagez de générer l’image sans texte, puis d’ajouter celui-ci en post-production à l’aide d’un outil de design.
- Utilisez le modèle pour des textes de longueur moyenne dans des maquettes où la précision au pixel près n’est pas le livrable final.
Là où ça échoue encore
Connaître les cas d’échec est aussi utile que connaître les points forts. Le rendu de texte de GPT Image 2.0 est impressionnant par rapport à ce qui existait auparavant, mais il présente des faiblesses constantes :
Polices scriptes et manuscrites : le modèle peine avec les styles cursifs et calligraphiques. Les formes de lettres liées créent une ambiguïté sur l’endroit où un caractère se termine et où le suivant commence, et l’approche caractère par caractère du modèle ne gère pas bien les ligatures.
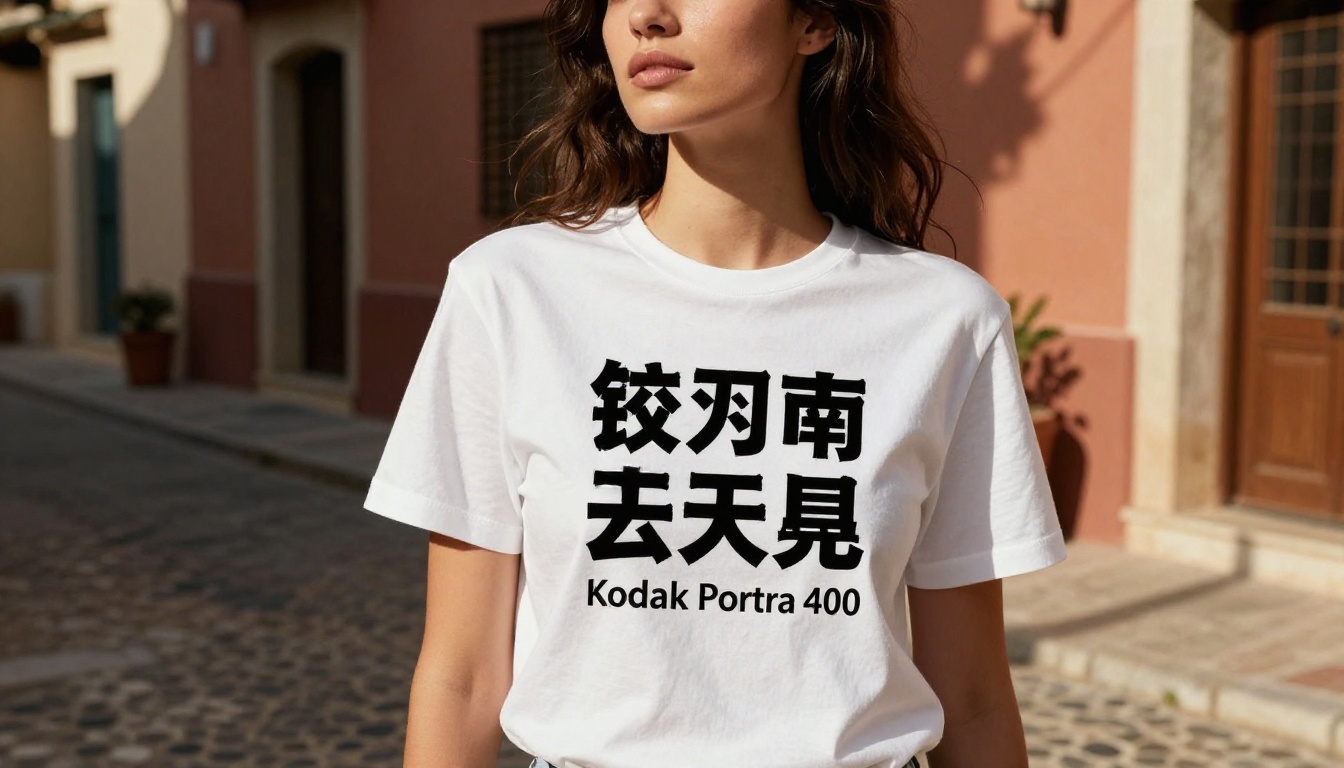
Écritures non latines : l’arabe, le chinois, le japonais, le coréen et d’autres systèmes d’écriture complexes sont nettement plus difficiles. Le modèle peut produire un texte qui paraît plausible de loin, mais qui contient des erreurs de caractères immédiatement évidentes pour un lecteur natif.
Stylisation extrême : un texte fortement déformé, sous des angles inhabituels ou intégré à des motifs complexes devient plus difficile à rendre avec exactitude. La guidance des caractères du modèle semble faiblir lorsque la complexité visuelle de l’image environnante est élevée.
Texte minuscule : un texte qui occupe une petite partie de l’image, comme les petits caractères d’une étiquette, se dégrade souvent en bruit à résolution normale.
💡 Pour un travail professionnel, considérez GPT Image 2.0 comme votre premier jet, et non comme votre résultat final. Il vous amène à 80 % du chemin plus vite que n’importe quel outil précédent.
Cas d’usage réels qui fonctionnent désormais
Les applications pratiques devenues fiables méritent d’être citées précisément, car c’est là que GPT Image 2.0 transforme réellement les flux de travail :
Maquettes marketing : générer des visuels publicitaires provisoires avec des titres lisibles pour des présentations client. Auparavant, un designer devait incruster le texte dans Photoshop après la génération. Aujourd’hui, le premier jet est souvent prêt à être présenté.
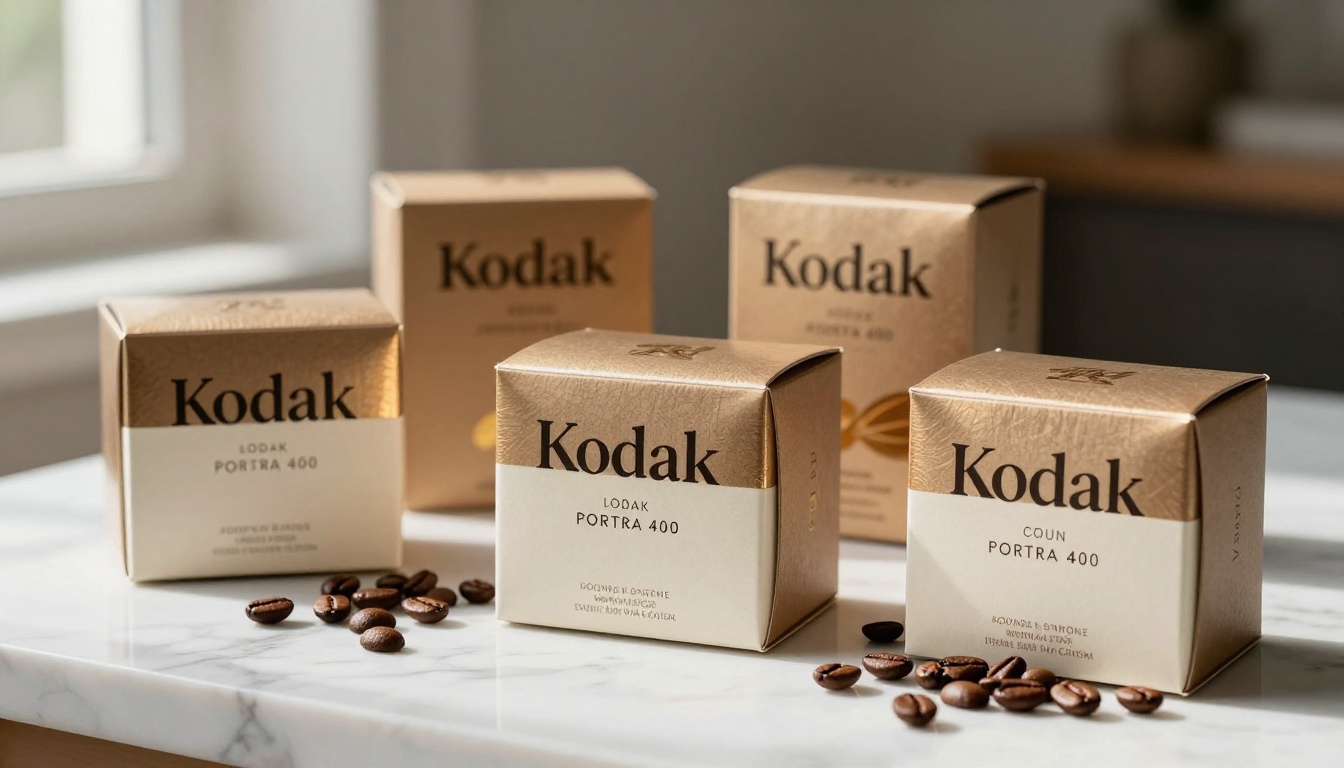
Concepts d’emballages : les noms de marque courts et les mentions de poids ou de volume sur les images d’emballages sont rendus avec suffisamment de précision pour communiquer clairement le concept lors des premières revues de design.
Contenus pour les réseaux sociaux : les maquettes de publications avec des textes superposés de 3 à 5 mots, des hashtags ou de courtes légendes sont très fiables. Les équipes de contenu peuvent produire rapidement des dizaines de variantes visuelles.
Signalétique et orientation : générer des scènes intérieures ou extérieures réalistes avec une signalétique étiquetée, comme « EXIT », « RECEPTION » ou « LEVEL 2 », fonctionne de manière constante pour la visualisation architecturale et les présentations.
Couvertures de livres et de magazines : les titres de 1 à 4 mots placés en évidence sur une image générée sortent désormais correctement dans la plupart des générations, ce qui constitue un véritable raccourci pour les designers qui produisent des concepts de couverture.
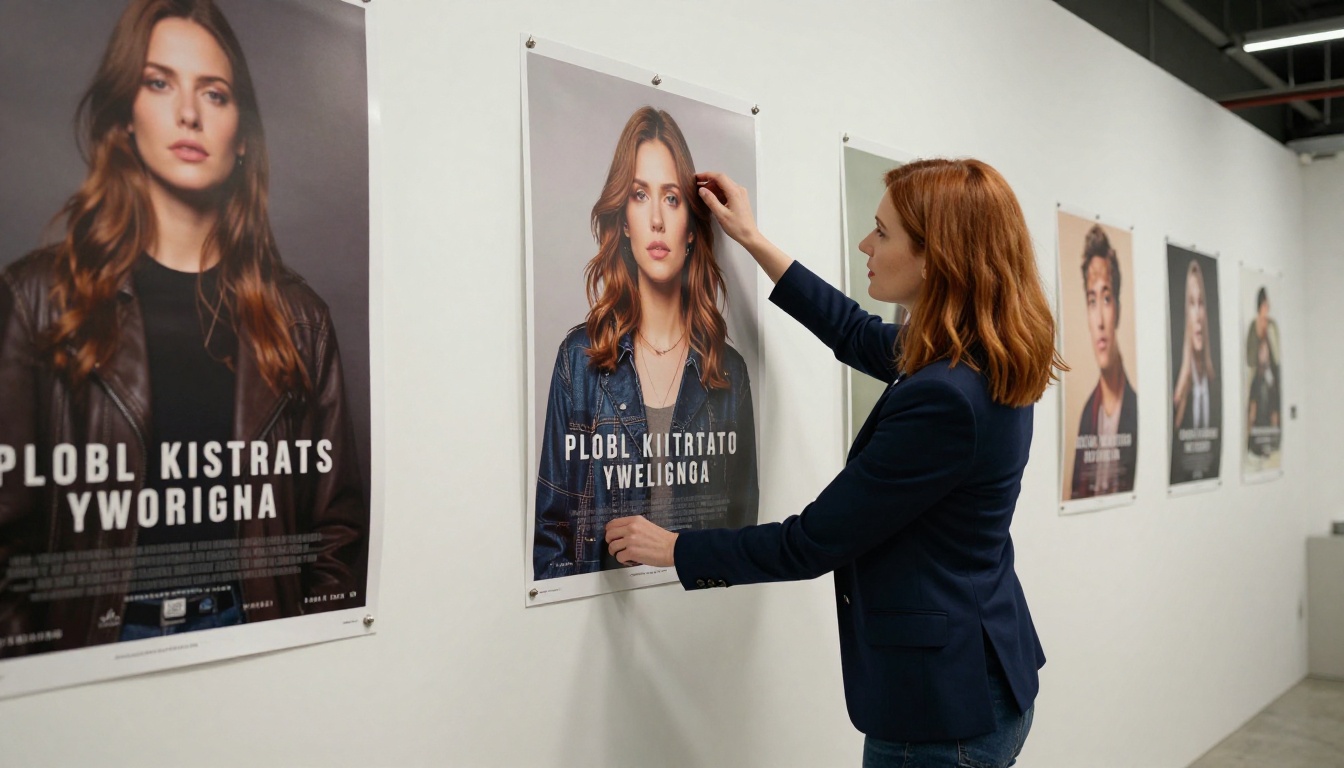
Supports d’événements : les flyers et affiches avec noms d’événements, dates et lieux sont devenus des points de départ viables lorsque le texte reste concis.
La façon dont vous rédigez le prompt a un impact direct sur la précision du rendu du texte. Ces stratégies fonctionnent de manière constante :
Mettez le texte entre guillemets dans votre prompt. Cela indique au modèle que la chaîne qui s’y trouve doit être traitée comme du texte visuel littéral. « Une vitrine avec une enseigne qui indique “BARISTA” » donne de meilleurs résultats que « une vitrine avec une enseigne BARISTA ».
Précisez le contexte typographique. Décrivez la graisse de la police, la couleur et le placement. « Lettres blanches en gras et en majuscules » donne au modèle davantage de contraintes à respecter et produit généralement un résultat plus net.
Séparez la description de l’image du contenu textuel. Les prompts qui distinguent clairement « à quoi ressemble la scène » de « quel texte apparaît dans la scène » tendent à produire moins d’erreurs que les prompts où le texte est mêlé à la description visuelle.
Demandez moins de mots par élément textuel. Si vous avez besoin d’une affiche avec plusieurs blocs de texte, il est souvent préférable de générer des images séparées pour différentes sections et de les assembler, plutôt que de demander une mise en page complexe sur plusieurs lignes en une seule génération.
Itérez avec les seeds. Une fois que vous obtenez une génération où le texte est presque correct, utilisez la même seed pour régénérer l’image en qualité supérieure ou avec de légers ajustements du prompt. Vous avez plus de chances de préserver l’exactitude du texte si la seed aléatoire reste constante.
💡 Considérez la rédaction de texte dans un prompt comme une consigne de composition typographique, et non comme une description visuelle. La précision produit l’exactitude.
GPT Image 2.0 ou autres générateurs capables de rendre du texte
Le paysage concurrentiel du rendu de texte dans les images par IA a évolué rapidement. Voici la position de GPT Image 2.0 par rapport aux autres outils que les gens utilisent couramment :
| Modèle | Texte court | Texte long | Non latin | Contrôle du style |
|---|
| GPT Image 2.0 | Excellent | Modéré | Partiel | Bon |
| Midjourney v6 | Bon | Faible | Médiocre | Bon |
| Adobe Firefly | Bon | Modéré | Limité | Excellent |
| FLUX.1 Dev | Modéré | Faible | Médiocre | Bon |
| Ideogram 2.0 | Excellent | Bon | Modéré | Modéré |
Ideogram a bâti sa réputation sur la précision du texte et reste une solution de remplacement solide pour les cas d’usage exigeant un rendu cohérent de textes longs. Adobe Firefly offre l’intégration la plus fiable avec les outils de design professionnels. L’avantage de GPT Image 2.0 réside dans la combinaison de la précision du texte et du suivi d’instructions pour des scènes complexes et richement décrites.
PicassoIA vous donne accès à des modèles puissants de texte vers image que vous pouvez utiliser dès maintenant pour expérimenter le rendu de texte dans vos propres projets. Le générateur PicassoIA Image est conçu pour ce type de travail créatif, et le P Image Trainer vous permet d’aller plus loin en entraînant des styles personnalisés à partir du modèle de base.
Étape 1 : ouvrez le modèle PicassoIA Image et commencez par une description claire de la scène.
Étape 2 : ajoutez votre spécification de texte entre guillemets dans le prompt. Par exemple : « Une étiquette de produit pour une marque de soins de la peau qui indique "LUMINA", emballage blanc minimaliste, éclairage de studio doux, photoréaliste. »
Étape 3 : réglez le format sur 16:9 pour les maquettes publicitaires, ou sur 1:1 pour les contenus destinés aux réseaux sociaux.
Étape 4 : générez 4 à 8 variations et sélectionnez celle dont le rendu du texte est le plus exact.
Étape 5 : pour des variations cohérentes en style à partir de votre meilleur résultat, essayez Flux Redux Dev sur PicassoIA. Il s’appuie sur des références visuelles existantes tout en conservant la cohérence de la composition, ce qui est utile lorsque vous avez besoin de texte dans une scène qui correspond à une identité visuelle établie.
Ce que cela change pour les designers et les équipes de contenu
La conséquence pratique des capacités de GPT Image 2.0 en matière de texte n’est pas que les designers ne sont plus nécessaires. C’est que la phase de premier jet de la création de contenu visuel a fondamentalement changé.
Produire un ensemble de 20 variantes de maquettes marketing pour une présentation client demandait auparavant des heures de travail : créer les scènes, trouver des photos de banques d’images, incruster le texte en post-production. Avec un rendu de texte fiable dans la génération par IA, cette phase de premier jet se réduit considérablement.
Le nouveau flux de travail ressemble à ceci :
- Utilisez la génération d’images par IA avec des prompts textuels pour produire 15 à 20 variantes brutes de concepts en moins d’une heure.
- Sélectionnez les 3 à 5 concepts les plus forts en fonction de la composition, du ton et de l’exactitude du texte.
- Affinez dans un outil de design : corrigez les erreurs de texte, ajustez la typographie, ajoutez des polices propres à la marque si nécessaire.
- Présentez des versions abouties, construites sur des fondations générées par IA.
Il ne s’agit pas de remplacer l’étape de design. Il s’agit de compresser la phase d’exploration afin que les équipes créatives passent plus de temps à affiner les bonnes idées et moins de temps à produire les variations initiales à partir de zéro.
Les améliorations de précision de GPT Image 2.0 rendent cette première phase compressée réellement utile, et pas seulement visuellement approximative. Lorsque le texte de votre maquette se lit correctement, vous pouvez la montrer à un décideur sans réserve.
Essayez par vous-même sur PicassoIA
Si vous voulez en faire l’expérience directement, PicassoIA vous donne un accès direct aux outils qui rendent cela possible. Commencez avec le modèle PicassoIA Image et rédigez un prompt qui inclut un mot ou une expression précise que vous voulez voir apparaître dans l’image. Utilisez la technique des guillemets décrite plus haut. Générez quelques variantes et observez comment le texte ressort.
Pour une sortie plus expérimentale ou stylisée, le modèle Flux Redux Dev vous permet de vous appuyer sur des références visuelles existantes tout en conservant la cohérence de la composition, ce qui est utile lorsque vous avez besoin de texte dans une scène qui correspond à une identité visuelle établie.
La technologie évolue vite. Ce qui exigeait des heures de post-production il y a deux ans sort aujourd’hui d’un seul prompt, en quelques secondes. Les outils disponibles sur PicassoIA aujourd’hui vous donnent accès à la pointe de cette évolution, sans avoir à configurer un accès API, gérer des crédits ou installer quoi que ce soit en local.
Ouvrez un navigateur, rédigez un prompt et découvrez ce qui en sort. Le texte pourrait bien être lisible.


