كيف يتعامل Kling v3 Omni Video مع أنواع مدخلات متعددة
يعالج Kling v3 Omni Video الأوامر النصية والصور الثابتة ومقاطع الفيديو المرجعية عبر البنية نفسها للنموذج. يشرح هذا المقال كيف يعمل كل وضع إدخال، وما الذي يتحكم فيه في المخرجات، وكيفية الجمع بين المدخلات للحصول على نتائج سينمائية بدقة 1080p.
لا يطلب منك Kling v3 Omni Video أن تختار مسارًا واحدًا. يمكنك أن تزوّده بجملة، أو صورة فوتوغرافية، أو مقطع فيديو موجود، أو بمزيج من الثلاثة، وسيقدّم في كل مرة نتيجة سينمائية متماسكة. هذه المرونة ليست ميزة ثانوية. فهي تغيّر سير العمل الإنتاجي بالكامل للمبدعين الذين يعملون بوسائط متعددة، وتجعل Kling v3 Omni Video من أكثر أدوات توليد الفيديو تنوعًا في الوقت الحالي. يشرح هذا المقال بالتفصيل كيف تتم معالجة كل نوع من أنواع الإدخال، وماذا يفعل النموذج به، وما معنى ذلك لنتائجك الإبداعية.
ما هو Kling v3 Omni فعلًا
Kling v3 Omni Video هو الإصدار متعدد الوسائط من جيل Kling v3 التابع لشركة Kuaishou. تشير تسمية "Omni" إلى أمر محدد: بنية نموذج موحدة تقبل مدخلات متباينة دون الحاجة إلى مسارات تشغيل منفصلة لكل وضع. تتخصص معظم نماذج توليد الفيديو في مهمة واحدة. يتعامل نموذج تحويل النص إلى فيديو مع تحويل واحد، ويتعامل نموذج تحويل الصورة إلى فيديو مع تحويل آخر. يعالج Kling v3 Omni كل هذه الأنماط داخل بنية المحوّل الانتشاري نفسها، مما ينتج مخرجات تبدو متسقة ومقصودة، لا مجمّعة من أنظمة منفصلة.
بنية واحدة، مدخلات كثيرة
تستخدم البنية الأساسية محوّلًا انتشاريًا يعالج التمثيلات المرمّزة لكل نوع من المدخلات عبر طبقات الانتباه المشتركة. يتحول النص إلى تضمينات توكنات. وتتحول الصورة إلى توكنات رقعية. ويتحول مرجع الفيديو إلى تسلسلات رقعية زمنية. ولأن كل هذه التمثيلات تمر عبر البنية نفسها، يستطيع النموذج أن يمزجها سياقيًا، فتحدد صورة مرجعية التكوين فيما يتحكم الأمر النصي في سلوك الحركة. وهذه المعالجة المشتركة هي سبب إنتاج التكييف متعدد المدخلات لنتائج أكثر إحكامًا وقصدية من ربط نموذجين منفصلين على التوالي.
لماذا يهم هذا في الإنتاج الفعلي
معظم المبدعين لا يبدؤون من أوامر نصية فارغة. إنهم يبدؤون من أصول: صور للعلامة التجارية، ولقطات منتجات، وتصوير لمواقع، وإطارات لوحات القصة المصورة. النموذج الذي يقبل النص وحده يجبرهم على ترجمة هذه الأصول البصرية إلى لغة أولًا، فيفقدون دقة في كل خطوة ترجمة. يقبل Kling v3 Omni Video الأصل مباشرة، فيحفظ الهوية البصرية دون طبقة الترجمة هذه. والنتيجة حلقة ملاحظات أضيق بين ما تقصده وما يُولَّد، وهذا يتراكم بشكل ملحوظ عبر سير العمل الإنتاجي الكبير.
💡 انطباع سريع: إذا كانت لديك صورة مرجعية قوية، فاستخدمها. فهي تتفوق باستمرار على الأوامر النصية فقط عندما يكون الحفاظ على هوية بصرية محددة أمرًا مهمًا.
إدخال النص: طبقة الأوامر
النص هو أسرع أنواع المدخلات وأكثرها شيوعًا كنقطة بداية. يتعامل Kling v3 Omni Video مع النص بوصفه وصفًا للحركة، وبنية للمشهد، وتوجيهًا عاطفيًا في الوقت نفسه. لا يكتفي الأمر النصي بإخبار النموذج بما يُعرض، بل يخبره كيف تتحرك الأشياء، وكيف يتصرف الضوء، وماذا تفعل الكاميرا عبر كل إطار في المخرجات.
كيف يقرأ النموذج اللغة
يعالج النموذج النص عبر مرمِّز لغوي مدرَّب مسبقًا، مع ضبط دقيق إضافي لمفردات خاصة بالحركة. والمخرج مجموعة من متجهات التكييف التي تؤثر في إزالة التشويش عند كل خطوة انتشارية. والنتيجة العملية: اللغة العامة تُنتج حركة متوسطة، واللغة المحددة تُنتج حركة محددة. هذه هي الفئات الدلالية التي يستجيب لها النموذج بقوة أكبر في الأمر النصي:
عنصر الأمر
ما الذي يتحكم فيه
وصف الموضوع
هوية الأشياء ومظهرها البصري
أفعال الحركة
اتجاه الحركة الأساسي وسرعتها
سياق البيئة
توليد الخلفية وعمق المشهد
مصطلحات الكاميرا ("slow dolly"، "aerial pan")
مسار الكاميرا عبر كل الإطارات
أوصاف الإضاءة
محاكاة الإضاءة وتدرج الألوان
كلمات الزمن ("gradually"، "suddenly")
توقيت الحركة ومنحنى التسارع
تشريح الأمر النصي الذي يحقق النتائج
الفرق بين مخرجات ضعيفة وأخرى قوية يعود دائمًا تقريبًا إلى التحديد في وصف الحركة. إليك مقارنة مباشرة:
ضعيف: "A woman walking in a city at night"
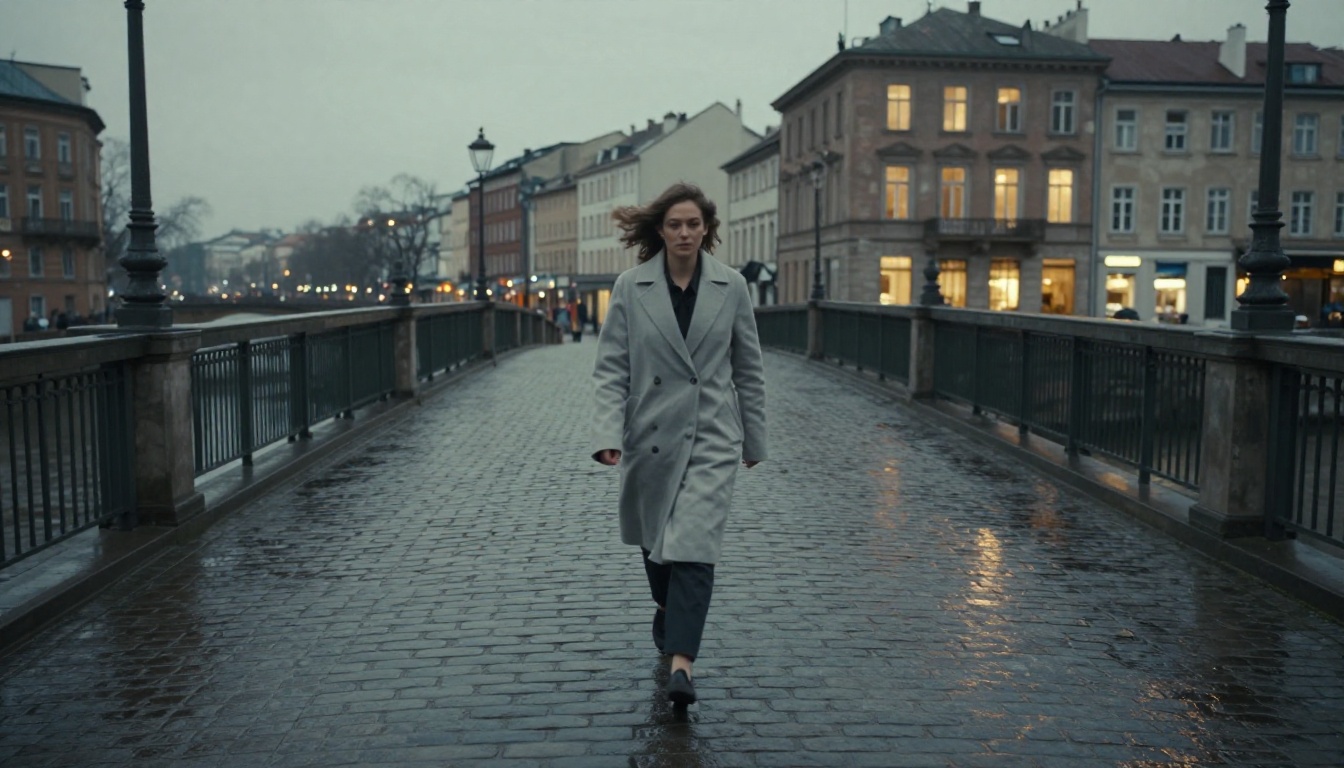
قوي: "A woman in a dark grey wool coat walking slowly across a wet cobblestone square at dusk, camera following at shoulder height with a gentle forward drift, city lights reflecting in rain puddles on the ground, slight motion blur on her coat hem from the cold wind"
يمنح الأمر الثاني النموذج إشارة كافية لاتخاذ قرارات متسقة عبر جميع الإطارات البالغ عددها 24 في الثانية. كل عنصر، من موضع الكاميرا إلى فيزياء القماش، مرتبط بتعليمات واضحة. ويملأ النموذج الفراغات بتوليف مقصود بدلًا من الضوضاء.
ما لا تحتاجه في الأوامر النصية
لا يحتاج Kling v3 Omni Video إلى أوصاف أسلوبية عامة مثل "cinematic" أو "photorealistic" في بداية كل أمر. يعتمد النموذج على التصيير الواقعي بدقة 1080p افتراضيًا. إضافة هذه الوسوم لا تضر، لكنها لا تغيّر المخرجات بشكل كبير. ما يغيّر الجودة فعلًا هو تحديد الحركة ووضوح تعليمات الكاميرا. اكتب تعليمة دقيقة للكاميرا، وستأتي الجودة السينمائية تلقائيًا من قدرة النموذج الأساسية على التصيير.
الصور الثابتة كبذور للفيديو
يُظهر تحويل الصورة إلى فيديو أكبر ميزة لنموذج Kling v3 Omni Video مقارنةً بالمنافسين. عندما تزوده بصورة ثابتة، يستخدمها النموذج كالإطار الأول الفعلي للفيديو الناتج، ثم يولّد حركة معقولة إلى الأمام انطلاقًا من هذا الإطار. لا يُستبدل أي عنصر من الصورة ولا يتغير بشكل كبير في الإطارات الأولى. ما يتغير هو الزمن: يضيف النموذج الحركة، ويحاكي الفيزياء، ويولّد حركة الكاميرا، ويمدّ المشهد إلى تسلسل زمني متماسك.
من إطار جامد إلى مشهد حي
تتضمن العملية عمليتين تحدثان بالتوازي. أولًا، يرمّز النموذج صورتك إلى تمثيل ميزات كثيف يعمل كمرساة بصرية طوال عملية إزالة التشويش. كل إطار مولَّد يُجذب نحو الاتساق مع تلك المرساة، ولهذا تبقى الهوية البصرية ثابتة طوال مدة المقطع. ثانيًا، يحدد الأمر النصي (إن قُدّم مع الصورة) اتجاه الحركة فوق تلك المرساة. تحدد الصورة كيف يبدو الشيء، ويحدد النص كيف يتحرك. تُعالَج هاتان الإشارتان في وقت واحد لا بالتتابع.
ما الذي يؤثر فيه التكوين والدقة
لجودة صورة الإدخال أثر مباشر وقابل للقياس في جودة المخرجات. هذه هي العوامل الأكثر أهمية عمليًا:
عامل الصورة
الأثر في المخرجات
الشخص في منتصف الإطار
يولّد النموذج حركة كاميرا متماثلة
الشخص خارج المركز
يميل النموذج إلى التحرك نحو الشخص
عمق ميدان واسع (صورة مسطحة)
حركة اختلاف منظور محاكاة أقل عمقًا
عمق ميدان ضيق (خلفية ضبابية)
فصل أقوى للعمق واختلاف منظور أوضح
دقة أعلى من 720p
تفاصيل أنظف محفوظة في الإطارات الناتجة
صور داكنة أو مكشوفة بشدة
تدهور الاتساق الزمني عبر الإطارات
💡 نصيحة: للحصول على أفضل نتائج تحويل الصورة إلى فيديو، استخدم صورًا ذات فصل واضح للموضوع وإضاءة محيطية طبيعية. الصور عالية التباين والمضاءة صناعيًا قد تُنتج أحيانًا تشوهات وومضًا في الإطارات الوسطى من المخرجات.
إرشادات عملية لمدخلات الصور
نسبة العرض إلى الارتفاع أهم مما يدركه معظم المبدعين. يضبط Kling v3 Omni Video الفيديو الناتج افتراضيًا ليطابق نسبة العرض إلى الارتفاع للصورة المدخلة. إذا أردت مخرجات بنسبة 16:9، فابدأ بصورة بنسبة 16:9. فالقص بعد التوليد يضعف الجودة عند الحواف. وتوفير النسبة الصحيحة من البداية يتجنب تمامًا تشوهات إعادة التأطير.
يلعب مستوى ضغط الصورة دورًا أيضًا. تُدخل ملفات JPEG المضغوطة بشدة تشوهات كتلية يعيد النموذج أحيانًا إنتاجها في الحركة. أما ملفات PNG أو ملفات JPEG عالية الجودة بمستوى جودة ضغط أعلى من 90% فتُنتج مخرجات أنظف باستمرار عبر كامل مدة الفيديو.
مقاطع الفيديو كمدخل مرجعي
نوع مدخل الفيديو المرجعي هو الأقل وضوحًا، لكنه ربما الأقوى. فبدلًا من استخدام الفيديو كمصدر محتوى، تستخدمه كمصدر لمفردات الحركة والأسلوب. تزوده بمقطع مرجعي قصير مع أمر نصي (واختياريًا صورة مرجعية)، فيستخلص النموذج خصائص الحركة وإيقاع الزمن والأنماط الأسلوبية من المقطع، ثم يطبقها على محتوى جديد تمامًا.
ما الذي يستخلصه النموذج من اللقطات المرجعية
لا ينسخ النموذج الحركة من المقطع المرجعي. بل يبني تمثيلًا كامنًا لأنماط زمنية: مدى سرعة تغير الأشياء بين الإطارات، واتجاه الحركة السائد، وهل الكاميرا ثابتة أم متحركة، وما هو الإيقاع العام الذي يشعر به المشهد. تصبح هذه الأنماط إشارات تكييف إضافية في عملية إزالة التشويش، موضوعة فوق إشارات النص والصورة.
هذا يختلف عن نقل الأسلوب في الفيديو. فنقل الأسلوب يغيّر شكل المخرجات، أما مدخل الفيديو المرجعي فيغيّر طريقة حركة المخرجات. يمكنك أخذ لقطات مرجعية من وثائقي طبيعة بحركة بطيئة، واستخلاص إيقاعه الزمني، وتطبيقه على موضوع مختلف تمامًا في مكان مختلف تمامًا. لا ينتقل المحتوى الأصلي، بل تنتقل مفردات الحركة فقط، وهذا يمنحك تحكمًا دقيقًا في الإيقاع دون الحاجة إلى وصفه بالكلام.
حالات الاستخدام الإبداعية لمدخل الفيديو المرجعي
مطابقة محتوى العلامة التجارية: إذا كانت لديك فيديوهات منتجات حالية بأسلوب كاميرا محدد، فاستخدم مقطعًا من أرشيفك كمرجع. تتطابق التوليدات الجديدة تلقائيًا مع بصمة الحركة دون الحاجة إلى وصفها صراحة.
إنتاج سلسلة متسقة: عند توليد عدة فيديوهات لحملة، استخدم توليدًا مبكرًا كمرجع للحركة في التوليدات اللاحقة. يخلق ذلك اتساقًا زمنيًا عبر الدفعة دون مطابقة يدوية للمعاملات.
توليد بأسلوب الوثائقيات: تنقل اللقطات المرجعية المصوّرة يدويًا حركة كاميرا عضوية إلى المشاهد المولَّدة التي قد تبدو وإلا ناعمة واصطناعية أكثر من اللازم.
تحكم في الإيقاع: استخدم مقطعًا بحركة بطيئة كمرجع لتطبيق ذلك الإيقاع الزمني المحسوب على موضوع جديد دون أي معاملات توقيت صريحة في الأمر النصي.
💡 طول المقطع المرجعي: المقاطع القصيرة بين 2 و5 ثوانٍ تعمل بشكل أفضل من الطويلة. يلتقط النموذج نسيج الحركة، لا سلسلة من الأفعال المحددة. المرجع بطول 10 ثوانٍ لا يمنحك تحكمًا أكبر من مقطع بطول 4 ثوانٍ.
الجمع بين أنواع المدخلات
تظهر القدرة الكاملة لنموذج Kling v3 Omni Video عندما تجمع بين أنواع المدخلات. النموذج مبني للتكييف متعدد الإشارات، والمخرجات الناتجة عن المدخلات المجمّعة أقوى باستمرار من توليدات المدخل الواحد تقريبًا في كل فئة من فئات الموضوعات.
النص مع الصورة: سير العمل القياسي القوي
هذا هو المزيج الأكثر شيوعًا والأكثر قابلية للتوقع. تحدد الصورة الهوية البصرية، ويحدد النص الحركة. معًا يزيلان أكبر مصدرين لعدم اليقين في توليد الفيديو: "هل سيبدو صحيحًا؟" (تجيب عنه الصورة) و"هل سيتحرك بشكل صحيح؟" (يجيب عنه الأمر النصي).
صيغة تُنتج نتائج موثوقة عبر أنواع مختلفة من الموضوعات:
[Visual subject from image] + [Motion instruction in text] + [Camera instruction in text] + [Environment context in text]
مثال: صورة بداية لامرأة ترتدي سترة حمراء تقف في حقل. أمر نصي: "ترفع ببطء كلتا يديها نحو السماء الغائمة، وتتراجع الكاميرا برفق لتكشف اتساع المرج خلفها، مع ضوء بعد الظهر الدافئ القادم من اليسار."
تضمن الصورة بقاء السترة الحمراء والوجه وبيئة الحقل كما تظهر في الصورة تمامًا. ويضمن النص أن الحركة وسلوك الكاميرا يتبعان توجيهك الإبداعي بدقة. ولا تتعارض أي من الإشارتين مع الأخرى عندما تكون متمايزة بوضوح كهذا.
عندما يغيّر الفيديو المرجعي كل شيء
إضافة مقطع فيديو مرجعي إلى سير عمل النص مع الصورة تُدخل طبقة ثالثة من التحكم: إيقاع الزمن وأسلوب الحركة. وهذا الوضع الثلاثي مناسب تحديدًا للأعمال عالية القيمة الإنتاجية التي يهم فيها الاتساق عبر قطع متعددة. وعندما تخلق ثلاث إشارات تكييف متنافسة توترًا في المخرجات، فإن تخفيض وزن مدخل المقطع المرجعي (المتاح كشريط منزلق في معظم الواجهات) يحل التعارض دون فقدان ميزة مفردات الحركة.
يتطلب سير العمل ثلاثي المدخلات تحضيرًا أكبر قليلًا من التوليد بمدخل واحد، لكن سقف جودة المخرجات أعلى بشكل قابل للقياس. وبالنسبة للمحتوى المرتبط بالعلامات التجارية وعروض المنتجات وإنتاج السلاسل التي يهم فيها الاتساق البصري عبر قطع كثيرة، فإن الاستثمار في الإعداد يؤتي ثماره بسرعة.
استخدام Kling v3 Omni على PicassoIA
Kling v3 Omni Video متاح مباشرة على PicassoIA دون إعداد، ودون رموز API، ودون أي عتاد محلي. يعمل سير العمل بالكامل داخل المتصفح.
الخطوة 1: افتح صفحة النموذج
انتقل إلى Kling v3 Omni Video على PicassoIA. تحمّل الواجهة ثلاث مناطق إدخال ظاهرة: الأمر النصي، ورفع الصورة، ومقطع الفيديو المرجعي الاختياري. الثلاث جميعها اختيارية بشكل مستقل، لكن خانة الأمر النصي تستحق الملء دائمًا حتى في وضع تحويل الصورة إلى فيديو.
الخطوة 2: اختر استراتيجية الإدخال
قرر أي مزيج يناسب مشروعك قبل كتابة أي شيء:
سير العمل
الأنسب لاستخدام
النص وحده
مشاهد جديدة دون أصول بصرية موجودة
صورة مع نص
تحريك الصور الفوتوغرافية أو لقطات المنتجات
فيديو مرجعي مع نص
مطابقة أسلوب حركة موجود
الثلاثة معًا
سلاسل محتوى العلامات التجارية عالية الاتساق
الخطوة 3: اكتب أمرًا حركيًا محددًا
حتى في وضع تحويل الصورة إلى فيديو، اكتب دائمًا أمرًا حركيًا. تتولى الصورة الهوية البصرية، ويتولى الأمر الحركة. يمنح أمر بسيط مثل "camera holds still, subject breathes naturally" النموذج اتجاهًا حركيًا واضحًا، مما يقلل الضوضاء الزمنية في المخرجات بشكل ملحوظ. وحدد دائمًا حركة الكاميرا إن كانت لديك تفضيلات، لأن سلوك الكاميرا الافتراضي للنموذج يختلف حسب تكوين المشهد.
الخطوة 4: اضبط الإخراج على 1080p
تتيح PicassoIA اختيار الدقة وقت التوليد. ينتج Kling v3 Omni بدقة 1080p أصلًا. وبالنسبة للمحتوى الاجتماعي والتسليم على الويب، فهذا هو الإعداد الصحيح. وإذا كنت تخطط لمعالجة الفيديو لاحقًا في مرحلة ما بعد الإنتاج، فإن التوليد بأعلى دقة يمنحك مرونة أكبر دون إدخال تشوهات إعادة أخذ العينات أثناء المونتاج.
الخطوة 5: قيّم وكرر
التوليد الأول نقطة مرجعية، لا منتج نهائي. قيّمه وفق ثلاثة معايير: جودة الحركة، والاتساق البصري مع صورتك المرجعية إن استخدمتها، والاتساق الزمني عبر كامل مدة المقطع. إذا كانت الحركة قوية لكن الهوية البصرية انحرفت، فارفع وزن تكييف الصورة. وإذا بدت الحركة عامة، فأضف مزيدًا من التحديد إلى أفعال الحركة في الأمر النصي.
إلى جانب Kling v3 Omni Video، تقدم PicassoIA أيضًا هذه النماذج ذات الصلة لاحتياجات إنتاجية مختلفة:
Kling v3 Video: تحويل النص إلى فيديو القياسي من Kling v3 لسير العمل القائم على الأوامر النصية فقط
Kling v3 Motion Control: تحكم دقيق في مسار الكاميرا لأعمال التصوير السينمائي المكتوبة مسبقًا
Kling v2.6: الجيل السابق لأحمال العمل الأخف ودورات التكرار الأسرع
Kling v2.5 Turbo Pro: توليد محسّن للسرعة عندما يكون تكرار المحاولات أهم من أقصى جودة للمخرجات
جودة المخرجات في الممارسة
تعمل المخرجات من Kling v3 Omni Video بدقة 1080p و24 إطارًا في الثانية، مع اتساق زمني أصلي مدمج في البنية. الاتساق الزمني هو المقياس الذي يفصل الفيديو الجاهز للإنتاج عن المخرجات التجريبية. يقيس ما إذا كانت الأشياء والوجوه والأسطح تبقى مستقرة بصريًا عبر الإطارات، بدلًا من أن تومض أو تنجرف أو تتشوه بشكل غير متوقع في منتصف المقطع.
مقاييس جودة على مستوى الإطار
بُعد الجودة
أداء Kling v3 Omni
الدقة المكانية
مخرجات أصلية بدقة 1080p
معدل الإطارات
24 إطارًا في الثانية مع استيفاء سلس
الاتساق الزمني
قوي، خاصة مع مدخل صورة مرساة
فيزياء الأجسام
واقعية للأجسام الصلبة والرخوة على حد سواء
ثبات الوجه
اتساق عالٍ للموضوعات البشرية عبر الإطارات
سلاسة حركة الكاميرا
ممتازة مع توجيه صريح للكاميرا
كيف يقارن بالبدائل
بالنسبة لمخرجات تحويل النص إلى فيديو الخالصة، تُعد نماذج مثل Seedance 2.5 وRay 3.2 بدائل تنافسية تستحق التجربة، خاصة للمشاهد الجوية والطبيعية الغنية بالمناظر حيث تكون هوية الموضوع أقل أهمية. أما لتحويل الصورة إلى فيديو تحديدًا، فيقدم Wan 2.7 I2V نتائج قوية بحركة سلسة بشكل ملحوظ في بيئات الطبيعة.
ما يتفوق فيه Kling v3 Omni Video على معظم البدائل هو المزيج الكامل: الحفاظ على هوية بصرية محددة من صورة مرجعية، وفي الوقت نفسه توجيه الحركة بدقة عبر النص، وفي الوقت نفسه مطابقة أسلوب حركة مرجعي من مقطع موجود. لا يوجد نموذج أحادي الوضع يكرر سير عمل الإدخال الثلاثي هذا.
تمتد قدرة النموذج على المؤثرات البصرية إلى ما هو أبعد بكثير من الحركة الخطية الأساسية:
فيزياء القماش والشعر: انسدال واقعي وتفاعل مع الرياح يبقى متسقًا عبر كل الإطارات
محاكاة السوائل: سلوك مقنع للماء والبخار والضباب طوال مدة المقطع
الإضاءة الديناميكية: تحولات في الإضاءة تتطور بشكل طبيعي عبر الخط الزمني للفيديو
اختلاف المنظور العمقي: حركة طبقية طبيعية في المشاهد ذات الفصل الواضح بين المقدمة والخلفية
حركة الإنسان: المشي والإيماء والتحولات في الوضعية بمعقولية بيوميكانيكية بدلًا من التكرار الآلي
💡 للعمل على المؤثرات البصرية: امزج صورة مرجعية قوية مع لغة اتجاهية محددة للتأثير الذي تحتاجه. "Fabric rippling in wind from the left" تُعالَج بدقة أكبر من وصف عام للرياح. يستجيب النموذج بقوة للتحديد الفيزيائي والاتجاهي في لغة الحركة.
ابدأ الإبداع الآن
كل سير عمل موصوف في هذا المقال متاح على PicassoIA الآن، دون الحاجة إلى اشتراك للبدء. يُعد مسار النص فقط أسرع نقطة انطلاق إذا أردت رؤية ما ينتجه Kling v3 Omni Video قبل تحضير أصول مرجعية. اكتب أمرًا حركيًا محددًا، وشغّل توليدًا واحدًا، واستخدم النتيجة لمعايرة تكرارك التالي.
إذا كانت لديك صورة فوتوغرافية تريد تحريكها، فارفعها مباشرة مع أمر حركي. هذا المزيج ينتج في معظم الحالات مخرجات قوية بما يكفي لمشاريع إبداعية حقيقية من المحاولة الأولى أو الثانية، دون أي إعداد إضافي أو ضبط للمعاملات.
بالنسبة للمبدعين الذين يريدون الذهاب أبعد، يوفر كتالوج PicassoIA الكامل المرونة لاختيار الأداة المناسبة لكل مهمة محددة. يتعامل النموذج Kling v2.6 Motion Control مع الأعمال الدقيقة لمسار الكاميرا. ويقدم P Video حلقة تكرار سريعة للنماذج الأولية السريعة. ولتوليد نسخ فيديو متعددة على نطاق واسع، تدعم واجهة PicassoIA سير عمل الدفعات التي تجعل الإنتاج عالي الحجم عمليًا دون بنية تحتية إضافية.
تزيل مرونة المدخلات في Kling v3 Omni Video أكبر نقطة احتكاك في إنتاج الفيديو بالذكاء الاصطناعي: عدم التطابق بين الأصول التي تملكها والمدخلات التي يقبلها النموذج. أحضر ما لديك، وصف ما تريده، ودع النموذج يتولى الباقي. تصفح كل ما هو متاح على picassoia.com/en/all-models.