Cómo Kling v3 Omni Video procesa varios tipos de entrada
Kling v3 Omni Video procesa prompts de texto, imágenes estáticas y clips de video de referencia a través del mismo núcleo del modelo. Este artículo explica cómo funciona cada modo de entrada, qué controla en el resultado y cómo combinar entradas para obtener resultados cinematográficos en 1080p.
Kling v3 Omni Video no te obliga a elegir un solo camino. Puedes darle una frase, una fotografía, un clip de video existente o una combinación de las tres cosas, y siempre produce un resultado cinematográfico coherente. Esa flexibilidad no es un detalle menor. Cambia todo el flujo de trabajo de producción de quienes trabajan con medios mixtos, y hace de Kling v3 Omni Video una de las herramientas de generación de video más versátiles que hay ahora mismo. Este artículo explica con detalle cómo procesa cada tipo de entrada, qué hace el modelo con ella y qué significa todo eso para tu resultado creativo.
Qué es realmente Kling v3 Omni
Kling v3 Omni Video es la variante multimodal de la generación Kling v3 de Kuaishou. La etiqueta "Omni" indica algo concreto: un núcleo de modelo unificado que acepta entradas heterogéneas sin necesitar pipelines de inferencia separados para cada modo. La mayoría de los modelos de generación de video se especializan. Un modelo de texto a video resuelve una correspondencia; un modelo de imagen a video resuelve otra. Kling v3 Omni procesa todas dentro de la misma arquitectura de transformador de difusión, lo que produce resultados que parecen coherentes y deliberados, en lugar de piezas unidas de sistemas distintos.
Un núcleo, muchas entradas
La arquitectura central usa un transformador de difusión que procesa representaciones tokenizadas de cada tipo de entrada a través de capas de atención compartidas. El texto se convierte en embeddings de tokens. Una imagen se convierte en tokens de parches. Una referencia de video se convierte en secuencias temporales de parches. Como todas estas representaciones fluyen por la misma arquitectura, el modelo puede mezclarlas en contexto: una imagen de referencia puede condicionar la composición mientras un prompt de texto controla el comportamiento del movimiento. Este procesamiento compartido es la razón por la que el condicionamiento con varias entradas produce resultados más ajustados e intencionados que encadenar dos modelos separados en secuencia.
Por qué esto importa en la producción real
La mayoría de los creadores no empiezan desde prompts de texto en blanco. Empiezan desde activos: fotografías de marca, imágenes de producto, metraje de localizaciones, fotogramas de storyboard. Un modelo que solo acepta texto les obliga a traducir esos activos visuales al lenguaje primero, perdiendo fidelidad en cada paso de traducción. Kling v3 Omni Video acepta el activo directamente, preservando la identidad visual sin esa capa de traducción. El resultado es un ciclo de retroalimentación más ajustado entre lo que pretendes y lo que se genera, algo que se acumula de forma significativa en flujos de producción más grandes.
💡 Resumen rápido: Si tienes una imagen de referencia sólida, úsala. Supera siempre a los prompts solo de texto cuando lo que importa es preservar una identidad visual concreta.
Entrada de texto: la capa del prompt
El texto es el tipo de entrada más rápido y el punto de partida más común. Kling v3 Omni Video trata el texto como una descripción de movimiento, una arquitectura de escena y una indicación emocional al mismo tiempo. Un prompt no solo le dice al modelo qué mostrar. Le dice cómo se mueven las cosas, cómo se comporta la luz y qué hace la cámara a lo largo de cada fotograma del resultado.
Cómo lee el modelo el lenguaje
El modelo procesa el texto mediante un codificador de lenguaje preentrenado con un ajuste fino adicional de vocabulario específico de movimiento. El resultado es un conjunto de vectores de condicionamiento que influyen en la eliminación de ruido en cada paso de difusión. La implicación práctica: un lenguaje vago produce un movimiento promedio. Un lenguaje específico produce un movimiento específico. Estas son las categorías semánticas a las que el modelo responde con más fuerza en un prompt de texto:
Elemento del prompt
Qué controla
Descripción del sujeto
Identidad y aspecto visual del objeto
Verbos de acción
Dirección y velocidad principales del movimiento
Contexto del entorno
Generación del fondo y profundidad de la escena
Términos de cámara ("dolly lento", "paneo aéreo")
Trayectoria de la cámara a lo largo de todos los fotogramas
Descriptores de iluminación
Simulación de la iluminación y tono de color
Palabras temporales ("gradualmente", "de repente")
Temporización del movimiento y curva de aceleración
Anatomía de un prompt que da resultados
La diferencia entre un resultado débil y uno sólido casi siempre depende de la precisión en la descripción del movimiento. Aquí tienes una comparación directa:
Débil: "Una mujer caminando por una ciudad de noche"
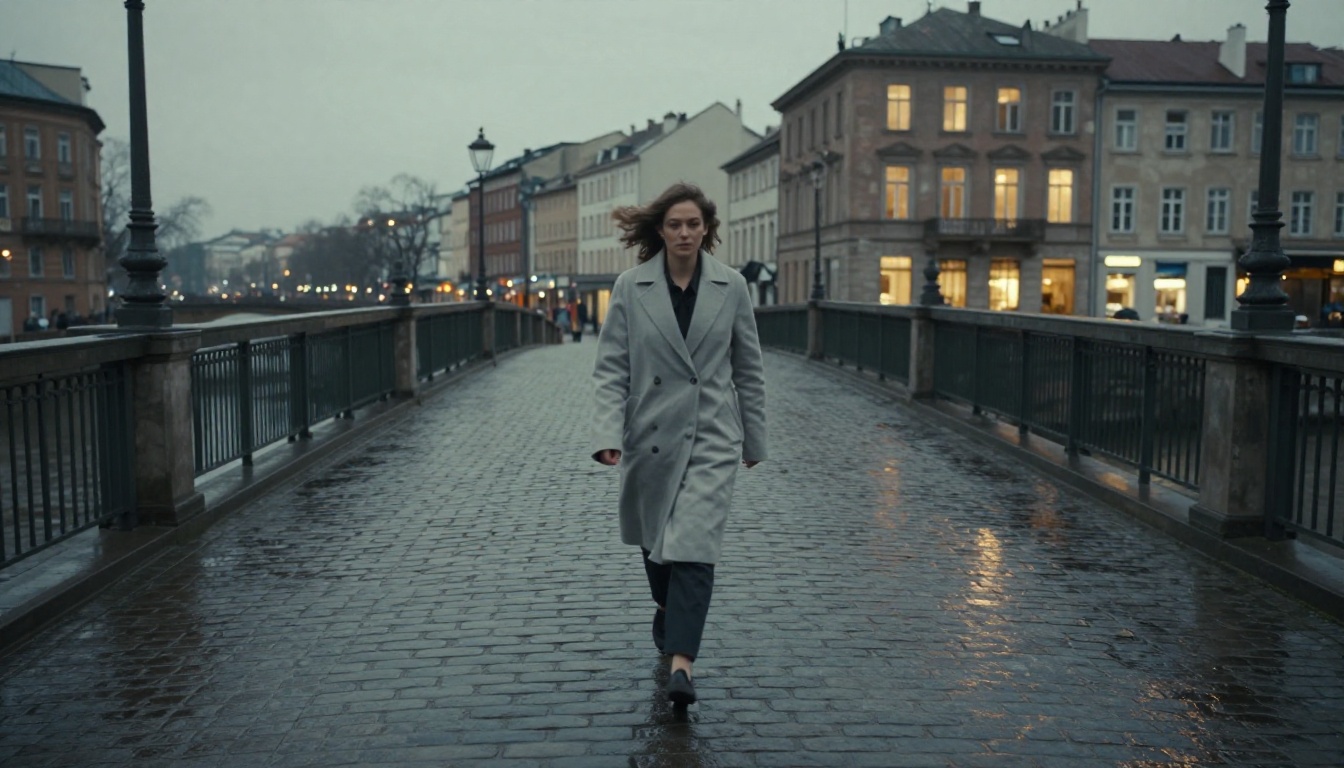
Sólido: "Una mujer con un abrigo de lana gris oscuro camina despacio por una plaza empedrada y mojada al atardecer, la cámara la sigue a la altura del hombro con un suave avance hacia delante, las luces de la ciudad se reflejan en los charcos de lluvia del suelo, y un leve desenfoque por movimiento en el bajo del abrigo provocado por el viento frío"
El segundo prompt da al modelo suficiente señal para tomar decisiones coherentes en los 24 fotogramas por segundo. Cada elemento, desde la posición de la cámara hasta la física de la tela, tiene una instrucción clara asociada. El modelo rellena menos con ruido y más con síntesis intencionada.
Lo que no necesitas en los prompts de texto
Kling v3 Omni Video no necesita calificativos de estilo genéricos como "cinematográfico" o "fotorrealista" al principio de cada prompt. El modelo usa por defecto un render fotorrealista en 1080p. Añadir esas etiquetas no perjudica, pero tampoco cambian mucho el resultado. Lo que sí cambia la calidad es la precisión del movimiento y la claridad de la instrucción de cámara. Escribe una instrucción de cámara precisa y la calidad cinematográfica llega de forma natural desde la capacidad de render base del modelo.
Imágenes estáticas como semillas de video
La conversión de imagen a video es donde Kling v3 Omni Video muestra su ventaja más clara frente a la competencia. Cuando proporcionas una imagen fija, el modelo la usa como primer fotograma exacto del video resultante y luego sintetiza un movimiento plausible a partir de ese fotograma. Ningún elemento de la imagen se reemplaza ni se altera de forma significativa en los primeros fotogramas. Lo que cambia es el tiempo: el modelo añade movimiento, simula la física, genera movimiento de cámara y extiende la escena en una secuencia temporal coherente.
De un fotograma congelado a una escena viva
El proceso implica dos operaciones que ocurren en paralelo. Primero, el modelo codifica tu imagen en una representación de características densa que actúa como ancla visual durante todo el proceso de eliminación de ruido. Cada fotograma generado se acerca a la coherencia con ese ancla, por eso la identidad visual se mantiene intacta durante toda la duración del clip. Segundo, el prompt de texto (si se proporciona junto a la imagen) condiciona la dirección del movimiento sobre ese ancla. La imagen controla cómo se ve. El texto controla cómo se mueve. Estas dos señales se procesan al mismo tiempo, no en secuencia.
Qué afectan la composición y la resolución
La calidad de la imagen de entrada tiene un impacto directo y medible en la calidad del resultado. Estos son los factores que más importan en la práctica:
Factor de la imagen
Efecto en el resultado
Sujeto centrado en el encuadre
El modelo genera un movimiento de cámara simétrico
Sujeto descentrado
El modelo tiende a hacer un paneo hacia el sujeto
Gran profundidad de campo (imagen plana)
Paralaje simulado de movimiento más superficial
Poca profundidad de campo (fondo desenfocado)
Mayor separación de planos y paralaje más marcado
Resolución superior a 720p
Detalle más limpio conservado en los fotogramas del resultado
Imágenes oscuras o muy sobreexpuestas
Coherencia temporal reducida entre fotogramas
💡 Consejo: Para obtener los mejores resultados de imagen a video, usa imágenes con una separación clara del sujeto y una iluminación ambiental natural. Las imágenes muy contrastadas con luz artificial a veces crean artefactos de parpadeo en los fotogramas centrales del resultado.
Pautas prácticas para las imágenes de entrada
La relación de aspecto importa más de lo que la mayoría de los creadores imaginan. Kling v3 Omni Video usa por defecto la relación de aspecto de la imagen de entrada en el video resultante. Si quieres un resultado en 16:9, empieza con una imagen en 16:9. Recortar después de generar degrada la calidad en los bordes. Proporcionar la relación correcta desde el principio evita por completo los artefactos de recuadre.
El nivel de compresión de la imagen también influye. Los archivos JPEG con mucha compresión introducen artefactos de bloques que el modelo a veces perpetúa en el movimiento. Los archivos PNG o los JPEG de alta calidad con una calidad de compresión superior al 90 % producen resultados siempre más limpios en toda la duración del video.
Clips de video como entrada de referencia
El tipo de entrada de video de referencia es el menos evidente, pero quizá el modo más potente. En lugar de usar un video como fuente de contenido, lo usas como vocabulario de movimiento y de estilo. Proporcionas un clip de referencia corto junto a un prompt de texto (y, opcionalmente, una imagen de referencia), y el modelo extrae las características del movimiento, el ritmo temporal y los patrones estilísticos del clip, y luego los aplica a un contenido completamente nuevo.
Lo que el modelo extrae del metraje de referencia
El modelo no copia y pega el movimiento del clip de referencia. Construye una representación latente de los patrones temporales: con qué rapidez cambian las cosas entre fotogramas, cuál es la dirección dominante del movimiento, si la cámara está fija o en movimiento, y qué ritmo general parece tener la escena. Estos patrones se convierten en señales de condicionamiento adicionales en el proceso de denoising, que se suman a las señales de texto e imagen.
Esto es distinto de la transferencia de estilo de video. La transferencia de estilo cambia cómo se ve el resultado. La entrada de video de referencia cambia cómo se mueve el resultado. Puedes tomar metraje de un documental de naturaleza en cámara lenta, extraer su ritmo temporal y aplicarlo a un sujeto completamente distinto en un escenario diferente. El contenido original no se transfiere. Solo se transfiere el vocabulario de movimiento, lo que te da un control preciso del ritmo sin tener que describirlo con palabras.
Casos de uso creativos para el video de referencia
Contenido de marca que encaja: si tienes videos de producto existentes con un estilo de cámara concreto, usa un clip de tu archivo como referencia. Las nuevas generaciones igualan automáticamente la firma de movimiento sin que tengas que describirla de forma explícita.
Producción de series coherente: cuando generes varios videos para una campaña, usa una de las primeras generaciones como referencia de movimiento para las siguientes. Así se crea coherencia temporal en todo el lote sin ajustar parámetros a mano.
Generación al estilo documental: el metraje grabado a mano transfiere a las escenas generadas un movimiento de cámara orgánico, en escenas que, de otro modo, parecerían demasiado suaves y artificiales.
Ritmo controlado: usa como referencia un clip en cámara lenta para aplicar ese ritmo temporal medido a un nuevo sujeto, sin parámetros de tiempo explícitos en el prompt de texto.
💡 Duración del clip de referencia: los clips cortos de 2 a 5 segundos funcionan mejor que los largos. El modelo capta la textura del movimiento, no una secuencia de acciones concretas. Una referencia de 10 segundos no te da más control que un clip de 4 segundos.
Combinar tipos de entrada
La capacidad completa de Kling v3 Omni Video aparece cuando combinas tipos de entrada. El modelo está diseñado para el condicionamiento con varias señales, y los resultados de entradas combinadas son siempre más sólidos que las generaciones con una sola entrada en prácticamente todas las categorías de sujeto.
Texto más imagen: el flujo de trabajo potente estándar
Es la combinación más común y la más previsible. La imagen define la identidad visual. El texto define el movimiento. Juntos eliminan las dos incertidumbres más grandes de la generación de video: "¿Se verá bien?" (lo responde la imagen) y "¿Se moverá bien?" (lo responde el prompt de texto).
Una fórmula que da resultados fiables con distintos tipos de sujeto:
[Visual subject from image] + [Motion instruction in text] + [Camera instruction in text] + [Environment context in text]
Ejemplo: imagen inicial de una mujer con una chaqueta roja de pie en un campo. Prompt de texto: "Ella levanta despacio las dos manos hacia el cielo nublado, la cámara retrocede suavemente para revelar la extensión del prado detrás de ella, con luz cálida de la tarde desde la izquierda."
La imagen asegura que la chaqueta roja, el rostro y el entorno del campo se mantengan exactamente como aparecen en la fotografía. El texto asegura que el movimiento y el comportamiento de la cámara sigan tu dirección creativa con precisión. Ninguno de los dos elementos compite con el otro cuando las señales están bien separadas, como en este caso.
Cuando el video de referencia lo cambia todo
Añadir un clip de video de referencia a un flujo de trabajo de texto más imagen introduce una tercera capa de control: el ritmo temporal y el estilo de movimiento. Este modo de tres entradas es ideal para trabajos de gran valor de producción en los que la coherencia entre varias piezas importa. Cuando tres señales de condicionamiento compiten y generan tensión en el resultado, reducir el peso del clip de referencia (disponible como control deslizante en la mayoría de interfaces) resuelve el conflicto sin perder el beneficio del vocabulario de movimiento.
El flujo de trabajo de tres entradas requiere algo más de preparación que la generación con una sola entrada, pero el techo de calidad del resultado es medible y claramente más alto. Para contenido de marca, presentaciones de producto y series de producción en las que la coherencia visual importa en muchas piezas, la inversión en preparación se amortiza rápido.
Usar Kling v3 Omni en PicassoIA
Kling v3 Omni Video está disponible directamente en PicassoIA sin configuración, sin tokens de API y sin hardware local. Todo el flujo de trabajo se ejecuta en el navegador.
Paso 1: abre la página del modelo
Ve a Kling v3 Omni Video en PicassoIA. La interfaz carga con tres zonas de entrada visibles: prompt de texto, subida de imagen y clip de video de referencia opcional. Las tres son opcionales de forma independiente, pero el campo del prompt de texto siempre merece la pena rellenarlo, incluso en el modo de imagen a video.
Paso 2: elige tu estrategia de entrada
Decide qué combinación encaja con tu proyecto antes de escribir nada:
Flujo de trabajo
Ideal para
Solo texto
Escenas nuevas sin recursos visuales previos
Imagen y texto
Animar fotos o imágenes de producto
Video de referencia y texto
Igualar un estilo de movimiento existente
Las tres combinadas
Series de contenido de marca de alta coherencia
Paso 3: escribe un prompt de movimiento específico
Incluso en el modo de imagen a video, escribe siempre un prompt de movimiento. La imagen se encarga de la identidad visual. El prompt se encarga del movimiento. Un prompt mínimo como "la cámara permanece quieta, el sujeto respira con naturalidad" ya da al modelo una dirección de movimiento clara, lo que reduce mucho el ruido temporal del resultado. Especifica siempre el movimiento de cámara si tienes una preferencia, ya que el comportamiento por defecto de la cámara varía según la composición de la escena.
Paso 4: configura la salida en 1080p
PicassoIA permite elegir la resolución en el momento de generar. Kling v3 Omni genera de forma nativa en 1080p. Para contenido en redes sociales y para publicación web, este es el ajuste correcto. Si piensas procesar el video después en postproducción, generar en la máxima resolución te da más flexibilidad sin introducir artefactos de remuestreo durante la edición.
Paso 5: evalúa e itera
La primera generación es un punto de referencia, no un producto final. Evalúala según tres criterios: la calidad del movimiento, la coherencia visual con tu imagen de referencia si la usaste, y la coherencia temporal a lo largo de toda la duración del clip. Si el movimiento es bueno pero la identidad visual se ha desviado, aumenta el peso del condicionamiento de la imagen. Si el movimiento parece genérico, añade más precisión a los verbos de movimiento del prompt de texto.
Junto a Kling v3 Omni Video, PicassoIA también ofrece estos modelos relacionados para distintas necesidades de producción:
Kling v3 Video: Kling v3 estándar de texto a video para flujos de trabajo solo con prompt
Kling v3 Motion Control: control preciso de la trayectoria de cámara para trabajos de cinematografía guionizada
Kling v2.6: generación anterior para cargas de trabajo más ligeras y ciclos de iteración más rápidos
Kling v2.5 Turbo Pro: generación optimizada en velocidad cuando la frecuencia de iteración importa más que la calidad máxima del resultado
La calidad del resultado en la práctica
El resultado de Kling v3 Omni Video sale a 1080p y 24 fps, con coherencia temporal nativa integrada en su arquitectura. La coherencia temporal es la métrica que separa el video listo para producción del resultado experimental. Mide si los objetos, los rostros y las superficies se mantienen visualmente estables a lo largo de los fotogramas, en lugar de parpadear, desplazarse o deformarse de forma inesperada a mitad del clip.
Métricas de calidad por fotograma
Dimensión de calidad
Rendimiento de Kling v3 Omni
Resolución espacial
Salida nativa de 1080p
Fotogramas por segundo
24 fps con interpolación suave
Coherencia temporal
Fuerte, sobre todo con una imagen de anclaje como entrada
Física de objetos
Realista tanto para objetos rígidos como blandos
Estabilidad facial
Alta coherencia en sujetos humanos a lo largo de los fotogramas
Suavidad del movimiento de cámara
Excelente con indicaciones explícitas de cámara
Cómo se compara con las alternativas
Para resultados de texto a video puro, modelos como Seedance 2.5 y Ray 3.2 son alternativas competitivas que vale la pena probar, sobre todo en escenas atmosféricas y con mucho paisaje, donde la identidad del sujeto es menos crítica. Para la conversión de imagen a video en concreto, Wan 2.7 I2V ofrece resultados sólidos con un movimiento notablemente fluido en entornos naturales.
Lo que Kling v3 Omni Video hace mejor que la mayoría de las alternativas es la combinación completa: conservar una identidad visual concreta de una imagen de referencia, y dirigir el movimiento con precisión mediante texto, y igualar un estilo de movimiento de referencia de un clip existente. Ningún modelo de un solo modo replica ese flujo de tres entradas.
La capacidad de efectos visuales del modelo va mucho más allá del movimiento lineal básico:
Física de tela y cabello: caída realista e interacción con el viento que se mantiene coherente en todos los fotogramas
Simulación de líquidos: comportamiento convincente del agua, el vapor y la niebla durante toda la duración del clip
Iluminación dinámica: cambios de luz que evolucionan de forma natural a lo largo de la línea de tiempo del video
Paralaje de profundidad: movimiento natural por capas en escenas con una separación clara entre primer plano y fondo
Movimiento humano: caminar, gesticular y cambios de postura con plausibilidad biomecánica, en lugar de repeticiones robóticas
💡 Para trabajos de efectos visuales: combina una imagen de referencia sólida con un lenguaje de dirección específico para el efecto que necesitas. "La tela ondeando con el viento desde la izquierda" se procesa con más precisión que una descripción genérica del viento. El modelo responde con fuerza a la precisión física y direccional en el lenguaje del movimiento.
Empieza a crear ahora mismo
Cada flujo de trabajo descrito en este artículo está disponible en PicassoIA ahora mismo, sin necesidad de suscripción para empezar. La vía de solo texto es el punto de partida más rápido si quieres ver lo que produce Kling v3 Omni Video antes de preparar activos de referencia. Escribe un prompt de movimiento específico, haz una generación y usa el resultado para calibrar la siguiente iteración.
Si ya tienes una fotografía que quieras animar, súbela directamente junto a un prompt de movimiento. Esa combinación produce, en la mayoría de los casos, un resultado lo bastante sólido para proyectos creativos reales ya en el primer o segundo intento, sin configuración adicional ni ajuste de parámetros.
Para los creadores que quieran ir más allá, el catálogo completo de PicassoIA te permite elegir la herramienta adecuada para cada trabajo concreto. El modelo Kling v2.6 Motion Control se encarga de los trabajos que requieren precisión en la trayectoria de cámara. P Video ofrece un ciclo de iteración rápido para el prototipado veloz. Y para generar varias variaciones de video a gran escala, la interfaz de PicassoIA admite flujos de trabajo por lotes que hacen práctica la producción de alto volumen sin infraestructura adicional.
La flexibilidad de entrada de Kling v3 Omni Video elimina el mayor obstáculo de la producción de video con IA: el desajuste entre los activos que tienes y las entradas que acepta un modelo. Aporta lo que tengas, describe lo que quieres y deja que el modelo haga el resto. Consulta todo lo disponible en picassoia.com/en/all-models.