Kling v3 Omni Video कैसे एक से ज़्यादा इनपुट टाइप संभालता है
Kling v3 Omni Video टेक्स्ट प्रॉम्प्ट, स्टैटिक इमेज और वीडियो रेफ़रेंस क्लिप, तीनों को एक ही मॉडल बैकबोन से प्रोसेस करता है। यह लेख बताता है कि हर इनपुट मोड कैसे काम करता है, वह आउटपुट में क्या नियंत्रित करता है, और सिनेमैटिक 1080p नतीजों के लिए इनपुट को कैसे मिलाएँ।
Kling v3 Omni Video आपसे कोई एक रास्ता चुनने को नहीं कहता। आप इसे एक वाक्य, एक फ़ोटो, एक मौजूदा वीडियो क्लिप, या तीनों का मेल दे सकते हैं, और यह हर बार एक सुसंगत सिनेमैटिक नतीजा तैयार करता है। यह लचीलापन कोई छोटी सुविधा नहीं है। यह मिक्स्ड मीडिया पर काम करने वाले क्रिएटर्स के पूरे प्रोडक्शन वर्कफ़्लो को बदल देता है, और इसी वजह से Kling v3 Omni Video इस समय उपलब्ध सबसे बहुमुखी वीडियो जनरेशन टूल्स में से एक है। यह लेख विस्तार से बताता है कि हर इनपुट टाइप को कैसे प्रोसेस किया जाता है, मॉडल उसके साथ क्या करता है, और आपके क्रिएटिव आउटपुट के लिए इसका क्या मतलब है।
Kling v3 Omni असल में क्या है
Kling v3 Omni Video Kuaishou के Kling v3 जनरेशन का मल्टीमोडल वर्ज़न है। "Omni" लेबल एक खास बात बताता है: एक ऐसा एकीकृत मॉडल बैकबोन जो हर मोड के लिए अलग इनफ़रेंस पाइपलाइन की ज़रूरत के बिना अलग-अलग तरह के इनपुट स्वीकार करता है। ज़्यादातर वीडियो जनरेशन मॉडल किसी एक काम में माहिर होते हैं। एक टेक्स्ट-टू-वीडियो मॉडल एक तरह की मैपिंग संभालता है, और एक इमेज-टू-वीडियो मॉडल दूसरी। Kling v3 Omni इन सबको एक ही diffusion transformer आर्किटेक्चर के भीतर प्रोसेस करता है, जिससे आउटपुट अलग-अलग सिस्टम से जोड़े हुए नहीं, बल्कि सुसंगत और सोचे-समझे लगते हैं।
एक बैकबोन, कई इनपुट
इस मॉडल का मूल आर्किटेक्चर एक diffusion transformer है, जो हर इनपुट टाइप के टोकनाइज़्ड रूप को साझा अटेंशन लेयर्स से गुज़ारता है। टेक्स्ट टोकन एम्बेडिंग बनता है। इमेज पैच टोकन बनती है। वीडियो रेफ़रेंस टेम्पोरल पैच सीक्वेंस बनता है। क्योंकि ये सभी रिप्रेज़ेंटेशन एक ही आर्किटेक्चर से गुज़रते हैं, मॉडल उन्हें संदर्भ के हिसाब से मिला सकता है, यानी रेफ़रेंस इमेज कंपोज़िशन को बाँधे रख सकती है, जबकि टेक्स्ट प्रॉम्प्ट मोशन के व्यवहार को नियंत्रित करता है। यही साझा प्रोसेसिंग मल्टी-इनपुट कंडीशनिंग को दो अलग मॉडलों को एक के बाद एक जोड़ने की तुलना में ज़्यादा कसे हुए और सोचे-समझे नतीजे देती है।
असली प्रोडक्शन के लिए यह क्यों मायने रखता है
ज़्यादातर क्रिएटर्स खाली टेक्स्ट प्रॉम्प्ट से शुरू नहीं करते। वे एसेट्स से शुरू करते हैं: ब्रांड की फ़ोटो, प्रोडक्ट शॉट, लोकेशन फ़ुटेज, स्टोरीबोर्ड फ़्रेम। जो मॉडल सिर्फ़ टेक्स्ट लेता है, वह उन्हें पहले उन विज़ुअल एसेट्स को भाषा में बदलने पर मजबूर करता है, और हर अनुवाद चरण में फ़िडेलिटी खोती है। Kling v3 Omni Video एसेट को सीधे स्वीकार करता है, और उस अनुवाद परत के बिना विज़ुअल पहचान बनाए रखता है। नतीजा यह होता है कि आप जो चाहते हैं और जो जनरेट होता है, उनके बीच फ़ीडबैक लूप ज़्यादा कसा हुआ हो जाता है, और बड़े प्रोडक्शन वर्कफ़्लो में यह फ़ायदा काफ़ी बढ़ता है।
💡 त्वरित सलाह: अगर आपके पास एक मज़बूत रेफ़रेंस इमेज है, तो उसका इस्तेमाल करें। जब किसी खास विज़ुअल पहचान को बनाए रखना ज़रूरी हो, तो यह सिर्फ़ टेक्स्ट वाले प्रॉम्प्ट से लगातार बेहतर प्रदर्शन करता है।
टेक्स्ट इनपुट: प्रॉम्प्ट परत
टेक्स्ट सबसे तेज़ इनपुट टाइप है और सबसे आम शुरुआती बिंदु भी। Kling v3 Omni Video टेक्स्ट को एक साथ मोशन का विवरण, सीन की बनावट और भावनात्मक निर्देश, तीनों की तरह देखता है। प्रॉम्प्ट मॉडल को सिर्फ़ यह नहीं बताता कि क्या दिखाना है। वह यह भी बताता है कि चीज़ें कैसे चलती हैं, रोशनी कैसे बर्ताव करती है, और कैमरा आउटपुट के हर फ़्रेम में क्या करता है।
मॉडल भाषा कैसे पढ़ता है
मॉडल टेक्स्ट को एक प्री-ट्रेन्ड लैंग्वेज एन्कोडर से प्रोसेस करता है, जिसमें मोशन-विशिष्ट शब्दावली पर अतिरिक्त फ़ाइन-ट्यूनिंग होती है। आउटपुट कंडीशनिंग वेक्टर्स का एक सेट होता है, जो हर diffusion स्टेप पर denoising को प्रभावित करता है। व्यावहारिक मतलब: अस्पष्ट भाषा औसत मोशन देती है, और साफ़-साफ़ भाषा खास मोशन देती है। ये वे सिमेंटिक श्रेणियाँ हैं जिन पर मॉडल टेक्स्ट प्रॉम्प्ट में सबसे मज़बूती से प्रतिक्रिया देता है:
प्रॉम्प्ट एलिमेंट
यह क्या नियंत्रित करता है
सब्जेक्ट का विवरण
ऑब्जेक्ट की पहचान और विज़ुअल दिखावट
एक्शन वर्ब
मुख्य मोशन की दिशा और गति
एनवायरनमेंट संदर्भ
बैकग्राउंड जनरेशन और सीन की गहराई
कैमरा शब्द ("slow dolly", "aerial pan")
सभी फ़्रेम में कैमरे का पथ
लाइटिंग डिस्क्रिप्टर
रोशनी की सिमुलेशन और रंग का टोन
टेम्पोरल शब्द ("gradually", "suddenly")
मोशन का समय और त्वरण का वक्र
नतीजे देने वाले प्रॉम्प्ट की बनावट
कमज़ोर और मज़बूत आउटपुट के बीच का फ़र्क लगभग हमेशा मोशन के विवरण की स्पष्टता पर आता है। यहाँ एक सीधी तुलना है:
कमज़ोर: "रात को शहर में चलती एक महिला"
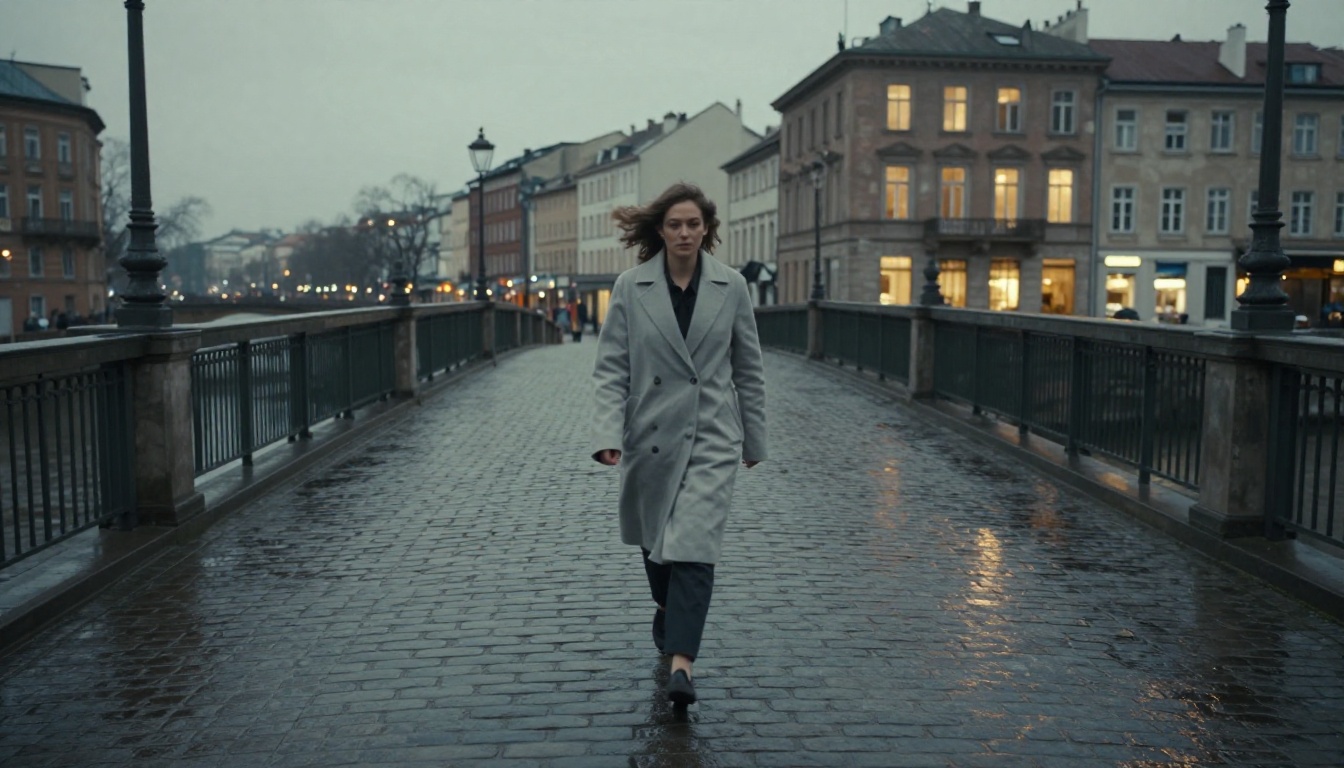
मज़बूत: "गहरे भूरे ऊनी कोट में एक महिला, शाम के समय एक गीले कोबलस्टोन चौक पर धीरे-धीरे चलती हुई, कैमरा कंधे की ऊँचाई पर उसका पीछा करता हुआ और हल्का आगे की ओर खिसकता हुआ, ज़मीन के गड्ढों में बारिश के पानी पर शहर की रोशनी झिलमिलाती हुई, ठंडी हवा से उसके कोट के किनारे पर हल्का मोशन ब्लर"
दूसरा प्रॉम्प्ट मॉडल को इतना संकेत देता है कि वह हर सेकंड के 24 फ़्रेम में सुसंगत फ़ैसले ले सके। कैमरा पोज़िशन से लेकर कपड़े की भौतिकी तक, हर एलिमेंट के साथ एक साफ़ निर्देश जुड़ा है। मॉडल शोर से कम और सोचे-समझे संश्लेषण से ज़्यादा भरता है।
टेक्स्ट प्रॉम्प्ट में आपको क्या नहीं चाहिए
Kling v3 Omni Video को हर प्रॉम्प्ट की शुरुआत में "cinematic" या "photorealistic" जैसे सामान्य स्टाइल क्वालिफ़ायर की ज़रूरत नहीं है। मॉडल 1080p पर फोटोरियलिस्टिक रेंडरिंग को डिफ़ॉल्ट रूप से अपनाता है। ये टैग जोड़ने से नुकसान नहीं होता, पर इनसे आउटपुट में कोई खास बदलाव भी नहीं आता। असल में गुणवत्ता मोशन की स्पष्टता और कैमरा निर्देश की साफ़गोई से बदलती है। एक सटीक कैमरा निर्देश लिखें, तो सिनेमैटिक गुणवत्ता मॉडल की बुनियादी रेंडरिंग क्षमता से अपने आप आ जाती है।
स्टैटिक इमेज वीडियो के सीड के रूप में
इमेज-टू-वीडियो वह जगह है जहाँ Kling v3 Omni Video प्रतिस्पर्धियों के मुकाबले अपनी सबसे मज़बूत बढ़त दिखाता है। जब आप एक स्थिर इमेज देते हैं, तो मॉडल उसे आउटपुट वीडियो के ठीक पहले फ़्रेम की तरह इस्तेमाल करता है, और फिर उस फ़्रेम से आगे विश्वसनीय मोशन बनाता है। शुरुआती फ़्रेम में इमेज का कोई हिस्सा बदला नहीं जाता या उल्लेखनीय रूप से नहीं बदला जाता। जो बदलता है वह समय है: मॉडल मूवमेंट जोड़ता है, फ़िज़िक्स सिमुलेट करता है, कैमरा मोशन बनाता है, और सीन को एक सुसंगत टेम्पोरल सीक्वेंस में फैलाता है।
जमे हुए फ़्रेम से जीवंत सीन तक
इस प्रक्रिया में दो काम एक साथ चलते हैं। पहला, मॉडल आपकी इमेज को एक घने फ़ीचर रिप्रेज़ेंटेशन में एन्कोड करता है, जो पूरे denoising प्रोसेस में एक विज़ुअल एंकर का काम करता है। हर जेनरेट होता फ़्रेम उसी एंकर की ओर खिंचता है, इसलिए क्लिप की पूरी अवधि में विज़ुअल पहचान बनी रहती है। दूसरा, टेक्स्ट प्रॉम्प्ट (अगर इमेज के साथ दिया गया हो) उस एंकर के ऊपर मोशन की दिशा तय करता है। इमेज बताती है कि चीज़ कैसी दिखती है। टेक्स्ट बताता है कि वह कैसे चलती है। ये दोनों संकेत एक के बाद एक नहीं, बल्कि एक साथ प्रोसेस होते हैं।
कंपोज़िशन और रिज़ॉल्यूशन पर असर
आपकी इनपुट इमेज की गुणवत्ता का आउटपुट की गुणवत्ता पर सीधा और मापने योग्य असर होता है। व्यवहार में ये कारक सबसे ज़्यादा मायने रखते हैं:
इमेज फ़ैक्टर
आउटपुट पर असर
फ़्रेम के बीच में सब्जेक्ट
मॉडल सममित कैमरा मोशन बनाता है
सब्जेक्ट किनारे पर
मॉडल आमतौर पर सब्जेक्ट की ओर पैन करता है
ज़्यादा डेप्थ ऑफ़ फ़ील्ड (सपाट इमेज)
सिमुलेटेड मोशन पैरलैक्स कम गहरा
कम डेप्थ ऑफ़ फ़ील्ड (धुंधला बैकग्राउंड)
गहराई का ज़्यादा अलगाव और पैरलैक्स
720p से ऊपर का रिज़ॉल्यूशन
आउटपुट फ़्रेम में साफ़ डिटेल बचती है
बहुत अंधेरी या ज़्यादा ओवरएक्सपोज़्ड इमेज
फ़्रेम के बीच टेम्पोरल सुसंगति बिगड़ती है
💡 टिप: इमेज-टू-वीडियो के सबसे अच्छे नतीजों के लिए ऐसी इमेज इस्तेमाल करें जिसमें सब्जेक्ट साफ़ अलग दिखे और रोशनी प्राकृतिक हो। बहुत ज़्यादा कंट्रास्ट वाली कृत्रिम रोशनी की इमेज कभी-कभी आउटपुट के बीच के फ़्रेम में फ़्लिकरिंग आर्टिफ़ैक्ट बना देती है।
इमेज इनपुट के लिए व्यावहारिक दिशानिर्देश
आस्पेक्ट रेशियो ज़्यादातर क्रिएटर्स की सोच से कहीं ज़्यादा मायने रखता है। Kling v3 Omni Video डिफ़ॉल्ट रूप से आउटपुट वीडियो का आस्पेक्ट रेशियो इनपुट इमेज से मिलाता है। अगर आपको 16:9 आउटपुट चाहिए, तो 16:9 इमेज से शुरू करें। जनरेशन के बाद क्रॉप करने से किनारों की गुणवत्ता घटती है। शुरू से सही रेशियो देने से रीफ़्रेमिंग आर्टिफ़ैक्ट पूरी तरह टल जाते हैं।
इमेज कंप्रेशन का स्तर भी भूमिका निभाता है। भारी कंप्रेशन वाली JPEG फ़ाइलों में ब्लॉकिंग आर्टिफ़ैक्ट आते हैं, जिन्हें मॉडल कभी-कभी मोशन में आगे भी ले जाता है। PNG फ़ाइलें या 90% से ऊपर कंप्रेशन क्वालिटी वाली हाई-क्वालिटी JPEG पूरी वीडियो अवधि में लगातार ज़्यादा साफ़ आउटपुट देती हैं।
रेफ़रेंस इनपुट के रूप में वीडियो क्लिप
रेफ़रेंस वीडियो इनपुट टाइप सबसे कम स्पष्ट है, पर शायद सबसे शक्तिशाली मोड भी है। वीडियो को कंटेंट के स्रोत की तरह इस्तेमाल करने के बजाय, आप उसे मोशन और स्टाइल की शब्दावली के स्रोत की तरह इस्तेमाल करते हैं। आप टेक्स्ट प्रॉम्प्ट के साथ एक छोटी रेफ़रेंस क्लिप देते हैं (और चाहें तो रेफ़रेंस इमेज भी), और मॉडल क्लिप से मोशन की विशेषताएँ, टेम्पोरल लय और स्टाइल पैटर्न निकालता है, फिर उन्हें बिल्कुल नए कंटेंट पर लागू करता है।
रेफ़रेंस फ़ुटेज से मॉडल क्या निकालता है
मॉडल रेफ़रेंस क्लिप से मोशन को कॉपी-पेस्ट नहीं करता। वह टेम्पोरल पैटर्न का एक लेटेंट रिप्रेज़ेंटेशन बनाता है: फ़्रेम के बीच चीज़ें कितनी तेज़ी से बदलती हैं, प्रमुख मोशन की दिशा क्या है, कैमरा स्थिर है या चलता है, और सीन की सामान्य गति कैसी लगती है। ये पैटर्न denoising प्रोसेस में अतिरिक्त कंडीशनिंग संकेत बन जाते हैं, जो टेक्स्ट और इमेज संकेतों के साथ परतों में लगाए जाते हैं।
यह वीडियो स्टाइल ट्रांसफ़र से अलग है। स्टाइल ट्रांसफ़र बदलता है कि आउटपुट कैसा दिखता है। रेफ़रेंस वीडियो इनपुट बदलता है कि आउटपुट कैसे चलता है। आप स्लो-मोशन नेचर डॉक्यूमेंट्री का फ़ुटेज लेकर उसकी टेम्पोरल गति निकाल सकते हैं और उसे बिल्कुल अलग सब्जेक्ट पर, बिल्कुल अलग सेटिंग में लागू कर सकते हैं। स्रोत का कंटेंट ट्रांसफ़र नहीं होता। सिर्फ़ मोशन की शब्दावली ट्रांसफ़र होती है, जिससे आपको गति को भाषा में बताए बिना उस पर सटीक नियंत्रण मिलता है।
रेफ़रेंस वीडियो इनपुट के रचनात्मक उपयोग
ब्रांड कंटेंट से मिलान: अगर आपके पास किसी खास कैमरा स्टाइल वाले मौजूदा प्रोडक्ट वीडियो हैं, तो अपने आर्काइव की एक क्लिप को रेफ़रेंस बनाएँ। नई जनरेशन आपके बिना उसे साफ़-साफ़ बताए उसी मोशन सिग्नेचर से मेल खाएँगी।
सुसंगत सीरीज़ प्रोडक्शन: किसी कैंपेन के लिए कई वीडियो बनाते समय, पहली जनरेशन को बाद वाली जनरेशन के लिए मोशन रेफ़रेंस बनाएँ। इससे मैन्युअल पैरामीटर मिलाए बिना बैच में टेम्पोरल सुसंगति आती है।
डॉक्यूमेंट्री-स्टाइल जनरेशन: हैंडहेल्ड शूटिंग के रेफ़रेंस फ़ुटेज से जैविक कैमरा मूवमेंट जनरेट किए गए उन सीन में आता है जो अन्यथा बहुत चिकने और कृत्रिम लगते।
नियंत्रित गति: टेक्स्ट प्रॉम्प्ट में कोई स्पष्ट टाइमिंग पैरामीटर दिए बिना, एक नए सब्जेक्ट पर उस मापी हुई टेम्पोरल गति को लागू करने के लिए स्लो-मोशन क्लिप को रेफ़रेंस बनाएँ।
💡 रेफ़रेंस क्लिप की लंबाई: 2-5 सेकंड की छोटी क्लिप लंबी क्लिप से बेहतर काम करती हैं। मॉडल मोशन की बनावट पकड़ता है, खास एक्शन के क्रम को नहीं। 10 सेकंड का रेफ़रेंस 4 सेकंड की क्लिप से ज़्यादा नियंत्रण नहीं देता।
इनपुट टाइप को मिलाना
Kling v3 Omni Video की पूरी क्षमता तब सामने आती है जब आप इनपुट टाइप को मिलाते हैं। मॉडल मल्टी-सिग्नल कंडीशनिंग के लिए बना है, और मिलाए गए इनपुट से मिलने वाले आउटपुट लगभग हर सब्जेक्ट श्रेणी में सिंगल-इनपुट जनरेशन से लगातार बेहतर होते हैं।
टेक्स्ट और इमेज: मानक शक्तिशाली वर्कफ़्लो
यह सबसे आम संयोजन है और काम करने में सबसे अनुमानित भी। इमेज विज़ुअल पहचान तय करती है। टेक्स्ट मोशन तय करता है। साथ मिलकर वे वीडियो जनरेशन की दो सबसे बड़ी अनिश्चितताएँ खत्म करते हैं: "क्या यह सही दिखेगा?" (इसका जवाब इमेज देती है) और "क्या यह सही चलेगा?" (इसका जवाब टेक्स्ट प्रॉम्प्ट देता है)।
एक फ़ॉर्मूला जो अलग-अलग सब्जेक्ट प्रकारों में भरोसेमंद नतीजे देता है:
[Visual subject from image] + [Motion instruction in text] + [Camera instruction in text] + [Environment context in text]
उदाहरण: लाल जैकेट पहने एक महिला के खेत में खड़े होने की शुरुआती इमेज। टेक्स्ट प्रॉम्प्ट: "वह धीरे-धीरे दोनों हाथ बादल भरे आसमान की ओर उठाती है, कैमरा धीरे-धीरे पीछे खिसकता है ताकि उसके पीछे घास के मैदान का फैलाव दिखे, बाईं ओर से गर्म दोपहर की रोशनी।"
इमेज सुनिश्चित करती है कि लाल जैकेट, चेहरा और खेत का माहौल ठीक वैसे ही रहें जैसे फ़ोटो में हैं। टेक्स्ट सुनिश्चित करता है कि मोशन और कैमरा का व्यवहार आपके क्रिएटिव निर्देश के अनुसार चले। जब संकेत इस तरह अच्छी तरह अलग हों, तो दोनों में से कोई एक दूसरे से नहीं लड़ता।
जब रेफ़रेंस वीडियो सब कुछ बदल देता है
टेक्स्ट-और-इमेज वर्कफ़्लो में रेफ़रेंस वीडियो क्लिप जोड़ने से नियंत्रण की तीसरी परत आती है: टेम्पोरल पेसिंग और मोशन स्टाइल। यह ट्रिपल-इनपुट मोड उस हाई-प्रोडक्शन-वैल्यू काम के लिए सबसे उपयुक्त है जहाँ कई टुकड़ों में सुसंगति मायने रखती है। जब तीन प्रतिस्पर्धी कंडीशनिंग संकेत आउटपुट में तनाव पैदा करते हैं, तो रेफ़रेंस क्लिप इनपुट का वज़न घटाने से (ज़्यादातर इंटरफ़ेस में यह एक स्लाइडर के रूप में होता है) मोशन शब्दावली का फ़ायदा खोए बिना टकराव सुलझ जाता है।
ट्रिपल-इनपुट वर्कफ़्लो में सिंगल-इनपुट जनरेशन से थोड़ी ज़्यादा तैयारी लगती है, पर आउटपुट की गुणवत्ता की सीमा मापी जाने लायक ऊँची होती है। ब्रांडेड कंटेंट, प्रोडक्ट शोकेस और सीरीज़ प्रोडक्शन के लिए, जहाँ कई टुकड़ों में विज़ुअल सुसंगति मायने रखती है, सेटअप में लगाया समय जल्दी वसूल हो जाता है।
PicassoIA पर Kling v3 Omni का उपयोग
Kling v3 Omni Video PicassoIA पर सीधे उपलब्ध है, इसके लिए कोई सेटअप, कोई API टोकन और कोई लोकल हार्डवेयर नहीं चाहिए। पूरा वर्कफ़्लो ब्राउज़र में चलता है।
चरण 1: मॉडल पेज खोलें
PicassoIA पर Kling v3 Omni Video पर जाएँ। इंटरफ़ेस में तीन इनपुट ज़ोन दिखते हैं: टेक्स्ट प्रॉम्प्ट, इमेज अपलोड और वैकल्पिक रेफ़रेंस वीडियो। तीनों अलग-अलग वैकल्पिक हैं, पर इमेज-टू-वीडियो मोड में भी टेक्स्ट प्रॉम्प्ट वाला खाना भरना हमेशा फ़ायदेमंद है।
चरण 2: अपनी इनपुट रणनीति चुनें
कुछ लिखने से पहले तय करें कि आपके प्रोजेक्ट के लिए कौन-सा संयोजन सही है:
वर्कफ़्लो
सबसे उपयुक्त
सिर्फ़ टेक्स्ट
बिना मौजूदा विज़ुअल एसेट्स वाले नए सीन
इमेज और टेक्स्ट
फ़ोटो या प्रोडक्ट शॉट को एनिमेट करना
रेफ़रेंस वीडियो और टेक्स्ट
मौजूदा मोशन स्टाइल से मिलान
तीनों मिलाकर
हाई-सुसंगति वाली ब्रांडेड कंटेंट सीरीज़
चरण 3: एक विशिष्ट मोशन प्रॉम्प्ट लिखें
इमेज-टू-वीडियो मोड में भी हमेशा एक मोशन प्रॉम्प्ट लिखें। इमेज विज़ुअल पहचान संभालती है। प्रॉम्प्ट मूवमेंट संभालता है। "camera holds still, subject breathes naturally" जैसा छोटा प्रॉम्प्ट भी मॉडल को साफ़ मोशन दिशा देता है, जिससे आउटपुट में टेम्पोरल नॉइज़ काफ़ी घटता है। अगर आपकी कोई पसंद है तो हमेशा कैमरा मूवमेंट बताएँ, क्योंकि मॉडल का डिफ़ॉल्ट कैमरा व्यवहार सीन की कंपोज़िशन के अनुसार बदलता है।
चरण 4: आउटपुट 1080p पर सेट करें
PicassoIA जनरेशन के समय रिज़ॉल्यूशन चुनने देता है। Kling v3 Omni मूल रूप से 1080p में आउटपुट देता है। सोशल कंटेंट और वेब डिलीवरी के लिए यही सही सेटिंग है। अगर आप वीडियो को पोस्ट-प्रोडक्शन में आगे प्रोसेस करने की योजना बना रहे हैं, तो अधिकतम रिज़ॉल्यूशन पर जनरेट करने से एडिटिंग के दौरान रीसैंपलिंग आर्टिफ़ैक्ट आए बिना ज़्यादा लचीलापन मिलता है।
चरण 5: आकलन करें और दोहराएँ
पहली जनरेशन एक संदर्भ बिंदु है, अंतिम उत्पाद नहीं। इसे तीन मानदंडों पर परखें: मोशन की गुणवत्ता, अगर इस्तेमाल की हो तो रेफ़रेंस इमेज के साथ विज़ुअल सुसंगति, और पूरी क्लिप अवधि में टेम्पोरल कोहेरेंस। अगर मोशन अच्छा है पर विज़ुअल पहचान बदल गई है, तो इमेज कंडीशनिंग का वज़न बढ़ाएँ। अगर मोशन सामान्य लगता है, तो टेक्स्ट प्रॉम्प्ट में मोशन वर्ब्स को और विशिष्ट बनाएँ।
Kling v3 Omni Video के साथ, PicassoIA अलग प्रोडक्शन ज़रूरतों के लिए ये संबंधित मॉडल भी देता है:
Kling v3 Video: प्रॉम्प्ट-ओनली वर्कफ़्लो के लिए मानक Kling v3 टेक्स्ट-टू-वीडियो
Kling v2.6: हल्के वर्कलोड और तेज़ इटरेशन चक्रों के लिए पिछला वर्ज़न
Kling v2.5 Turbo Pro: गति-अनुकूलित जनरेशन, जब इटरेशन की संख्या अधिकतम आउटपुट गुणवत्ता से ज़्यादा मायने रखती है
व्यवहार में आउटपुट की गुणवत्ता
Kling v3 Omni Video का आउटपुट 1080p और 24fps का होता है, जिसमें आर्किटेक्चर में ही मूल टेम्पोरल सुसंगति बनी है। टेम्पोरल सुसंगति वह मापदंड है जो प्रोडक्शन-रेडी वीडियो को प्रायोगिक आउटपुट से अलग करता है। यह मापता है कि ऑब्जेक्ट, चेहरे और सतहें फ़्रेम-दर-फ़्रेम विज़ुअली स्थिर रहती हैं या नहीं, और क्लिप के बीच में झिलमिलाते, खिसकते या अचानक बदलते नहीं।
फ़्रेम-स्तरीय गुणवत्ता मापदंड
गुणवत्ता आयाम
Kling v3 Omni का प्रदर्शन
स्पेशियल रिज़ॉल्यूशन
1080p मूल आउटपुट
फ़्रेम रेट
स्मूद इंटरपोलेशन के साथ 24fps
टेम्पोरल सुसंगति
मज़बूत, खासकर इमेज एंकर इनपुट के साथ
ऑब्जेक्ट फ़िज़िक्स
कठोर और नरम दोनों तरह की वस्तुओं के लिए यथार्थवादी
चेहरे की स्थिरता
फ़्रेम में मानव सब्जेक्ट पर उच्च सुसंगति
कैमरा मोशन की चिकनाई
स्पष्ट कैमरा प्रॉम्प्टिंग के साथ उत्कृष्ट
दूसरे विकल्पों से तुलना
सिर्फ़ टेक्स्ट-टू-वीडियो आउटपुट के लिए, Seedance 2.5 और Ray 3.2 जैसे मॉडल प्रतिस्पर्धी विकल्प हैं जिन्हें आज़माना चाहिए, खासकर वातावरण और लैंडस्केप-प्रधान सीन में जहाँ सब्जेक्ट की पहचान उतनी अहम नहीं। खास तौर पर इमेज-टू-वीडियो के लिए, Wan 2.7 I2V प्राकृतिक माहौल वाले सेटिंग में उल्लेखनीय रूप से सहज मोशन के साथ मज़बूत नतीजे देता है।
Kling v3 Omni Video ज़्यादातर विकल्पों से जिस चीज़ में बेहतर है, वह है पूरा संयोजन: रेफ़रेंस इमेज से एक खास विज़ुअल पहचान बनाए रखना और टेक्स्ट से मोशन को सटीक दिशा देना और किसी मौजूदा क्लिप से रेफ़रेंस मोशन स्टाइल का मिलान करना। कोई भी सिंगल-मोड मॉडल इस ट्राई-इनपुट वर्कफ़्लो को नहीं दोहरा सकता।
मॉडल की विज़ुअल इफ़ेक्ट क्षमता बुनियादी लीनियर मोशन से कहीं आगे जाती है:
कपड़े और बालों की फ़िज़िक्स: यथार्थवादी ड्रेपिंग और हवा के साथ इंटरैक्शन, जो सभी फ़्रेम में सुसंगत रहता है
तरल सिमुलेशन: पूरी क्लिप अवधि में विश्वसनीय पानी, भाप और कोहरे का व्यवहार
डायनामिक लाइटिंग: वीडियो टाइमलाइन पर स्वाभाविक रूप से बदलती रोशनी
डेप्थ पैरलैक्स: साफ़ फ़ोरग्राउंड और बैकग्राउंड अलगाव वाले सीन में प्राकृतिक परतदार मोशन
मानव मोशन: चलना, इशारे और शरीर की मुद्रा में बदलाव, बायोमैकेनिकल विश्वसनीयता के साथ, रोबोटिक दोहराव के बिना
💡 विज़ुअल इफ़ेक्ट के काम के लिए: जिस इफ़ेक्ट की ज़रूरत है उसके लिए मज़बूत रेफ़रेंस इमेज को विशिष्ट दिशात्मक भाषा के साथ मिलाएँ। "बाईं ओर से हवा में लहराता कपड़ा" एक सामान्य हवा के विवरण से ज़्यादा सटीक तरीके से प्रोसेस होता है। मॉडल मोशन की भाषा में भौतिक और दिशात्मक स्पष्टता पर मज़बूत प्रतिक्रिया देता है।
अभी बनाना शुरू करें
इस लेख में बताया गया हर वर्कफ़्लो अभी PicassoIA पर उपलब्ध है, शुरू करने के लिए किसी सब्सक्रिप्शन की ज़रूरत नहीं। अगर आप रेफ़रेंस एसेट तैयार करने से पहले देखना चाहते हैं कि Kling v3 Omni Video क्या बनाता है, तो सिर्फ़ टेक्स्ट वाला रास्ता सबसे तेज़ शुरुआत है। एक विशिष्ट मोशन प्रॉम्प्ट लिखें, एक जनरेशन चलाएँ, और नतीजे का इस्तेमाल अगले इटरेशन को कैलिब्रेट करने में करें।
अगर आपके पास पहले से कोई फ़ोटो है जिसे आप एनिमेट करना चाहते हैं, तो उसे मोशन प्रॉम्प्ट के साथ सीधे अपलोड करें। ज़्यादातर मामलों में यह संयोजन पहले या दूसरे प्रयास में असली क्रिएटिव प्रोजेक्ट के लिए काफ़ी मज़बूत आउटपुट देता है, और इसके लिए किसी अतिरिक्त सेटअप या पैरामीटर ट्यूनिंग की ज़रूरत नहीं होती।
जो क्रिएटर्स इससे आगे जाना चाहते हैं, उनके लिए PicassoIA का पूरा कैटलॉग हर खास काम के लिए सही टूल चुनने की आज़ादी देता है। Kling v2.6 Motion Control मॉडल कैमरा-पथ की सटीकता वाले काम संभालता है। P Video रैपिड प्रोटोटाइपिंग के लिए तेज़ इटरेशन लूप देता है। और कई वीडियो वेरिएशन बड़े पैमाने पर जनरेट करने के लिए PicassoIA का इंटरफ़ेस बैच वर्कफ़्लो सपोर्ट करता है, जिससे अतिरिक्त इंफ़्रास्ट्रक्चर के बिना हाई-वॉल्यूम प्रोडक्शन व्यावहारिक बनता है।
Kling v3 Omni Video की इनपुट लचीलापन AI वीडियो प्रोडक्शन की सबसे बड़ी रुकावट को हटा देती है: आपके पास जो एसेट्स हैं और जो इनपुट मॉडल स्वीकार करता है, उनके बीच का बेमेल। जो आपके पास है वह लाइए, जो चाहते हैं वह बताइए, और बाकी काम मॉडल पर छोड़ दीजिए। उपलब्ध सब कुछ picassoia.com/en/all-models पर देखें।