Como o Kling v3 Omni Video trabalha com vários tipos de entrada
O Kling v3 Omni Video processa prompts de texto, imagens estáticas e clipes de vídeo de referência pelo mesmo núcleo do modelo. Este artigo explica como cada modo de entrada funciona, o que ele controla no resultado e como combinar entradas para obter resultados cinematográficos em 1080p.
O Kling v3 Omni Video não pede que você escolha um único caminho. Você pode alimentá-lo com uma frase, uma fotografia, um videoclipe existente ou uma combinação dos três, e ele produz um resultado cinematográfico coeso todas as vezes. Essa flexibilidade não é um recurso menor. Ela muda todo o fluxo de trabalho de produção para criadores que trabalham com mídias mistas e faz do Kling v3 Omni Video uma das ferramentas de geração de vídeo mais versáteis disponíveis hoje. Este artigo explica em detalhes como cada tipo de entrada é processado, o que o modelo faz com ela e o que isso significa para o seu resultado criativo.
O que é de fato o Kling v3 Omni
O Kling v3 Omni Video é a variante multimodal da geração Kling v3, da Kuaishou. O rótulo "Omni" sinaliza algo específico: um núcleo de modelo unificado que aceita entradas heterogêneas sem precisar de pipelines de inferência separados para cada modo. A maioria dos modelos de geração de vídeo é especializada. Um modelo de texto para vídeo faz um tipo de mapeamento. Um modelo de imagem para vídeo faz outro. O Kling v3 Omni processa todos eles dentro da mesma arquitetura de transformer de difusão, o que gera resultados que parecem consistentes e intencionais, e não costurados a partir de sistemas diferentes.
Um núcleo, muitas entradas
A arquitetura central usa um transformer de difusão que processa representações tokenizadas de cada tipo de entrada por meio de camadas de atenção compartilhadas. O texto vira embeddings de token. Uma imagem vira tokens de patch. Um vídeo de referência vira sequências de patches temporais. Como todas essas representações passam pela mesma arquitetura, o modelo consegue misturá-las contextualmente: uma imagem de referência pode limitar a composição enquanto um prompt de texto controla o comportamento do movimento. Esse processamento compartilhado é o motivo pelo qual o condicionamento com várias entradas produz resultados mais precisos e intencionais do que encadear dois modelos separados em sequência.
Por que isso importa na produção real
A maioria dos criadores não começa de prompts de texto em branco. Eles começam de ativos: fotografias de marca, imagens de produtos, filmagens de locações, quadros de storyboard. Um modelo que aceita apenas texto obriga essas pessoas a traduzir os ativos visuais para a linguagem antes, perdendo fidelidade a cada etapa dessa tradução. O Kling v3 Omni Video aceita o ativo diretamente, preservando a identidade visual sem essa camada de tradução. O resultado é um ciclo de retorno mais apertado entre o que você pretende e o que é gerado, o que se acumula de forma significativa em fluxos de produção maiores.
💡 Resumo rápido: se você tem uma imagem de referência forte, use-a. Ela supera de forma consistente o prompt apenas de texto quando preservar uma identidade visual específica é importante.
Entrada de texto: a camada do prompt
O texto é o tipo de entrada mais rápido e o ponto de partida mais comum. O Kling v3 Omni Video trata o texto como uma descrição de movimento, uma arquitetura de cena e uma diretriz emocional ao mesmo tempo. Um prompt não diz apenas o que mostrar ao modelo. Ele diz como as coisas se movem, como a luz se comporta e o que a câmera faz em cada quadro do resultado.
Como o modelo lê a linguagem
O modelo processa o texto por meio de um codificador de linguagem pré-treinado, com fine-tuning adicional em vocabulário específico de movimento. O resultado é um conjunto de vetores de condicionamento que influenciam a remoção de ruído em cada etapa da difusão. Na prática, linguagem vaga produz movimento médio. Linguagem específica produz movimento específico. Estas são as categorias semânticas às quais o modelo responde com mais força em um prompt de texto:
Elemento do prompt
O que controla
Descrição do sujeito
Identidade e aparência visual do objeto
Verbos de ação
Direção e velocidade principais do movimento
Contexto do ambiente
Geração do fundo e profundidade da cena
Termos de câmera ("dolly lento", "panorâmica aérea")
Trajetória da câmera em todos os quadros
Descritores de iluminação
Simulação de iluminação e tom de cor
Palavras temporais ("gradualmente", "de repente")
Tempo do movimento e curva de aceleração
Anatomia de um prompt que dá resultado
A diferença entre um resultado fraco e um forte quase sempre se resume à especificidade na descrição do movimento. Aqui está uma comparação direta:
Fraco: "Uma mulher caminhando em uma cidade à noite"
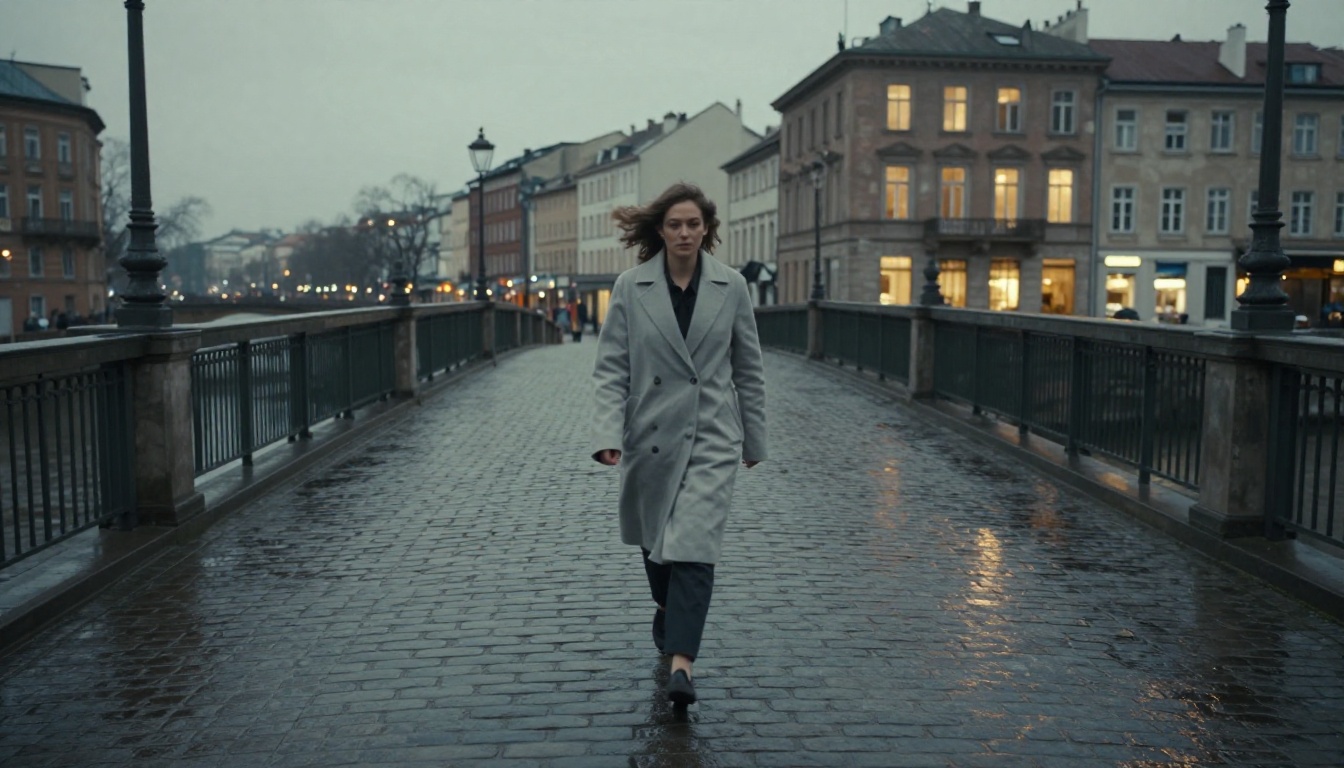
Forte: "Uma mulher com um casaco de lã cinza-escuro caminhando devagar por uma praça de paralelepípedos molhada no crepúsculo, câmera acompanhando na altura do ombro com uma leve deriva para frente, luzes da cidade refletindo em poças de chuva no chão, leve desfoque de movimento na barra do casaco por causa do vento frio"
O segundo prompt dá ao modelo sinal suficiente para tomar decisões consistentes em todos os 24 quadros por segundo. Cada elemento, da posição da câmera à física do tecido, tem uma instrução clara associada. O modelo preenche as lacunas menos com ruído e mais com síntese intencional.
O que você não precisa nos prompts de texto
O Kling v3 Omni Video não precisa de qualificadores genéricos de estilo como "cinematográfico" ou "fotorrealista" no início de cada prompt. O modelo usa por padrão a renderização fotorrealista em 1080p. Incluir essas tags não atrapalha, mas também não muda muito o resultado. O que de fato altera a qualidade é a especificidade do movimento e a clareza da instrução de câmera. Escreva uma instrução precisa de câmera e a qualidade cinematográfica segue naturalmente da capacidade de renderização base do modelo.
Imagens estáticas como sementes de vídeo
A imagem para vídeo é onde o Kling v3 Omni Video demonstra sua maior vantagem sobre os concorrentes. Quando você fornece uma imagem fixa, o modelo a usa como o primeiro quadro exato do vídeo e depois sintetiza um movimento plausível a partir desse quadro. Nenhum elemento da imagem é substituído ou significativamente alterado nos quadros iniciais. O que muda é o tempo: o modelo adiciona movimento, simula física, gera movimento de câmera e estende a cena em uma sequência temporal coerente.
De um quadro congelado a uma cena viva
O processo envolve duas operações acontecendo em paralelo. Primeiro, o modelo codifica sua imagem em uma representação de características densa que funciona como âncora visual durante todo o processo de remoção de ruído. Cada quadro gerado é puxado para a consistência com essa âncora, e é por isso que a identidade visual se mantém intacta por toda a duração do clipe. Segundo, o prompt de texto (se fornecido junto com a imagem) condiciona a direção do movimento sobre essa âncora. A imagem controla como ela parece. O texto controla como ela se move. Esses dois sinais são processados simultaneamente, e não em sequência.
O que a composição e a resolução afetam
A qualidade da imagem de entrada tem um impacto direto e mensurável na qualidade do resultado. Estes são os fatores que mais importam na prática:
Fator da imagem
Efeito no resultado
Sujeito centralizado no quadro
O modelo gera movimento de câmera simétrico
Sujeito posicionado fora do centro
O modelo tende a fazer panorâmica em direção ao sujeito
Alta profundidade de campo (imagem plana)
Paralaxe de movimento simulada mais rasa
Baixa profundidade de campo (fundo desfocado)
Separação de profundidade e paralaxe mais fortes
Resolução acima de 720p
Mais detalhes preservados nos quadros do resultado
Imagens escuras ou muito superexpostas
Consistência temporal degradada entre os quadros
💡 Dica: para melhores resultados de imagem para vídeo, use imagens com separação clara do sujeito e iluminação ambiente natural. Imagens com alto contraste e iluminação artificial às vezes criam artefatos de cintilação nos quadros do meio do resultado.
Diretrizes práticas para imagens de entrada
A proporção da imagem importa mais do que a maioria dos criadores imagina. O Kling v3 Omni Video usa por padrão a proporção da imagem de entrada no vídeo gerado. Se você quer um resultado em 16:9, comece com uma imagem em 16:9. Recortar depois da geração degrada a qualidade nas bordas. Fornecer a proporção correta desde o início evita por completo os artefatos de reenquadramento.
O nível de compressão da imagem também tem seu papel. Arquivos JPEG com compressão forte introduzem artefatos de bloco que o modelo às vezes perpetua no movimento. Arquivos PNG ou JPEG de alta qualidade acima de 90% de qualidade de compressão produzem resultados consistentemente mais limpos em toda a duração do vídeo.
Clipes de vídeo como entrada de referência
O tipo de entrada de vídeo de referência é o menos óbvio, e talvez o mais poderoso. Em vez de usar um vídeo como fonte de conteúdo, você o usa como fonte de vocabulário de movimento e estilo. Você fornece um clipe curto de referência junto com um prompt de texto (e, opcionalmente, uma imagem de referência), e o modelo extrai as características de movimento, o ritmo temporal e os padrões estilísticos do clipe, então os aplica a conteúdo totalmente novo.
O que o modelo extrai da filmagem de referência
O modelo não copia e cola o movimento do clipe de referência. Ele constrói uma representação latente de padrões temporais: com que rapidez as coisas mudam entre os quadros, qual é a direção dominante do movimento, se a câmera está parada ou em movimento e qual é o ritmo geral da cena. Esses padrões se tornam sinais de condicionamento adicionais no processo de remoção de ruído, sobrepostos aos sinais de texto e imagem.
Isso é diferente da transferência de estilo de vídeo. A transferência de estilo muda como o resultado parece. A entrada de vídeo de referência muda como o resultado se move. Você pode pegar uma filmagem de um documentário de natureza em câmera lenta, extrair seu ritmo temporal e aplicá-lo a um sujeito totalmente diferente em um cenário completamente diferente. O conteúdo de origem não é transferido. Apenas o vocabulário de movimento é, o que dá controle preciso sobre o ritmo sem precisar descrevê-lo em linguagem.
Casos de uso criativos para entrada de vídeo de referência
Conteúdo alinhado à marca: se você tem vídeos de produto existentes com um estilo específico de câmera, use um clipe do seu arquivo como referência. As novas gerações passam a seguir automaticamente a assinatura de movimento, sem que você precise descrevê-la explicitamente.
Produção de séries consistentes: ao gerar vários vídeos para uma campanha, use uma geração inicial como referência de movimento para as seguintes. Isso cria consistência temporal no lote sem ajuste manual de parâmetros.
Geração em estilo documental: filmagens de referência feitas com câmera na mão transferem movimento orgânico de câmera para cenas geradas que, de outra forma, pareceriam lisas e artificiais demais.
Ritmo controlado: use como referência um clipe em câmera lenta para aplicar esse ritmo temporal medido a um novo sujeito, sem nenhum parâmetro de tempo explícito no prompt de texto.
💡 Duração do clipe de referência: clipes curtos de 2 a 5 segundos funcionam melhor do que os longos. O modelo captura a textura do movimento, e não uma sequência de ações específicas. Uma referência de 10 segundos não oferece mais controle do que um clipe de 4 segundos.
Combinando tipos de entrada
A capacidade completa do Kling v3 Omni Video aparece quando você combina tipos de entrada. O modelo foi criado para condicionamento com múltiplos sinais, e os resultados de entradas combinadas são consistentemente mais fortes do que gerações com uma única entrada, em praticamente todas as categorias de sujeito.
Texto mais imagem: o fluxo de trabalho padrão mais potente
Esta é a combinação mais comum e a mais previsível de usar. A imagem define a identidade visual. O texto define o movimento. Juntos, eliminam as duas maiores incertezas na geração de vídeo: "Vai ficar com a aparência certa?" (respondida pela imagem) e "Vai se mover do jeito certo?" (respondida pelo prompt de texto).
Uma fórmula que produz resultados confiáveis em diferentes tipos de sujeito:
[Visual subject from image] + [Motion instruction in text] + [Camera instruction in text] + [Environment context in text]
Exemplo: imagem inicial de uma mulher com jaqueta vermelha em pé em um campo. Prompt de texto: "Ela levanta lentamente as duas mãos em direção ao céu nublado, câmera recuando suavemente para revelar a extensão do prado atrás dela, luz quente da tarde vindo da esquerda."
A imagem garante que a jaqueta vermelha, o rosto e o ambiente do campo permaneçam exatamente como aparecem na fotografia. O texto garante que o movimento e o comportamento da câmera sigam sua direção criativa com precisão. Nenhum dos elementos briga com o outro quando os sinais estão bem separados, como neste caso.
Quando o vídeo de referência muda tudo
Adicionar um clipe de vídeo de referência a um fluxo de texto mais imagem introduz uma terceira camada de controle: ritmo temporal e estilo de movimento. Este modo de três entradas é mais indicado para trabalhos de alta produção, em que a consistência entre várias peças é importante. Quando três sinais de condicionamento concorrentes criam tensão no resultado, reduzir o peso da entrada do clipe de referência (disponível como controle deslizante na maioria das interfaces) resolve o conflito sem perder o benefício do vocabulário de movimento.
O fluxo com três entradas exige um pouco mais de preparação do que a geração com uma entrada só, mas o teto de qualidade do resultado é mensuravelmente mais alto. Para conteúdo de marca, vitrines de produtos e produção de séries em que a coerência visual importa entre muitas peças, o investimento na preparação se paga rapidamente.
Usando o Kling v3 Omni no PicassoIA
O Kling v3 Omni Video está disponível diretamente no PicassoIA, sem configuração, sem tokens de API e sem necessidade de hardware local. Todo o fluxo roda no navegador.
Passo 1: abra a página do modelo
Acesse o Kling v3 Omni Video no PicassoIA. A interface carrega com três áreas de entrada visíveis: prompt de texto, upload de imagem e vídeo de referência opcional. As três são opcionais de forma independente, mas o campo do prompt de texto sempre vale a pena ser preenchido, mesmo no modo de imagem para vídeo.
Passo 2: escolha sua estratégia de entrada
Decida qual combinação se encaixa no seu projeto antes de escrever qualquer coisa:
Fluxo
Mais indicado para
Somente texto
Cenas novas sem ativos visuais existentes
Imagem mais texto
Animar fotos ou imagens de produtos
Vídeo de referência mais texto
Seguir um estilo de movimento existente
As três combinadas
Séries de conteúdo de marca com alta consistência
Passo 3: escreva um prompt de movimento específico
Mesmo no modo de imagem para vídeo, sempre escreva um prompt de movimento. A imagem cuida da identidade visual. O prompt cuida do movimento. Um prompt mínimo como "câmera parada, sujeito respirando naturalmente" ainda dá ao modelo uma direção de movimento clara, o que reduz bastante o ruído temporal no resultado. Sempre especifique o movimento de câmera se tiver preferência, já que o comportamento padrão da câmera varia conforme a composição da cena.
Passo 4: defina a saída em 1080p
O PicassoIA permite escolher a resolução no momento da geração. O Kling v3 Omni gera nativamente em 1080p. Para conteúdo de redes sociais e entrega na web, esta é a configuração correta. Se você planeja processar o vídeo depois na pós-produção, gerar na resolução máxima oferece mais flexibilidade sem introduzir artefatos de reamostragem durante a edição.
Passo 5: avalie e itere
A primeira geração é um ponto de referência, não um produto final. Avalie-a em três critérios: qualidade do movimento, consistência visual com a imagem de referência, se usada, e coerência temporal em toda a duração do clipe. Se o movimento está forte, mas a identidade visual se afastou, aumente o peso do condicionamento pela imagem. Se o movimento parece genérico, acrescente mais especificidade aos verbos de movimento no prompt de texto.
Além do Kling v3 Omni Video, o PicassoIA também oferece estes modelos relacionados para diferentes necessidades de produção:
Kling v3 Video: texto para vídeo padrão do Kling v3 para fluxos somente com prompt
Kling v3 Motion Control: controle preciso da trajetória da câmera para trabalhos de cinematografia roteirizada
Kling v2.6: geração anterior para cargas de trabalho mais leves e ciclos de iteração mais rápidos
Kling v2.5 Turbo Pro: geração otimizada para velocidade, quando a frequência de iteração importa mais do que a qualidade máxima do resultado
Qualidade do resultado na prática
O resultado do Kling v3 Omni Video é gerado em 1080p, 24 fps, com consistência temporal nativa incorporada à arquitetura. A consistência temporal é a métrica que separa um vídeo pronto para produção de um resultado experimental. Ela mede se objetos, rostos e superfícies permanecem visualmente estáveis entre os quadros, em vez de cintilar, deslizar ou se deformar de forma inesperada no meio do clipe.
Métricas de qualidade por quadro
Dimensão de qualidade
Desempenho do Kling v3 Omni
Resolução espacial
Saída nativa em 1080p
Taxa de quadros
24 fps com interpolação suave
Consistência temporal
Forte, especialmente com uma entrada de imagem como âncora
Física dos objetos
Realista para objetos rígidos e de corpo mole
Estabilidade do rosto
Alta consistência em sujeitos humanos entre os quadros
Suavidade do movimento de câmera
Excelente com prompts explícitos de câmera
Como ele se compara às alternativas
Para resultados de texto para vídeo puro, modelos como o Seedance 2.5 e o Ray 3.2 são alternativas competitivas que valem a pena testar, especialmente para cenas atmosféricas e com muita paisagem, em que a identidade do sujeito importa menos. Para imagem para vídeo especificamente, o Wan 2.7 I2V entrega resultados fortes, com movimento notavelmente fluido em ambientes naturais.
O que o Kling v3 Omni Video faz melhor do que a maioria das alternativas é a combinação completa: preservar uma identidade visual específica de uma imagem de referência e direcionar o movimento com precisão pelo texto e seguir um estilo de movimento de referência a partir de um clipe existente. Nenhum modelo de entrada única replica esse fluxo com três entradas.
A capacidade de efeitos visuais do modelo vai muito além do movimento linear básico:
Física de tecidos e cabelos: caimento realista e interação com o vento que se mantém consistente em todos os quadros
Simulação de líquidos: comportamento convincente de água, vapor e névoa durante toda a duração do clipe
Iluminação dinâmica: mudanças de iluminação que evoluem de forma natural ao longo da linha do tempo do vídeo
Paralaxe de profundidade: movimento natural em camadas em cenas com separação clara entre primeiro plano e fundo
Movimento humano: caminhar, gesticular e mudar de postura com plausibilidade biomecânica, e não com repetição robótica
💡 Para trabalhos de efeitos visuais: combine uma imagem de referência forte com linguagem direcional específica para o efeito que você precisa. "Tecido ondulando com o vento vindo da esquerda" é processado com mais precisão do que uma descrição genérica de vento. O modelo responde com força à especificidade física e direcional na linguagem de movimento.
Comece a criar agora mesmo
Todo fluxo descrito neste artigo está disponível agora no PicassoIA, sem necessidade de assinatura para começar. O caminho somente com texto é o ponto de partida mais rápido se você quiser ver o que o Kling v3 Omni Video produz antes de preparar ativos de referência. Escreva um prompt de movimento específico, faça uma geração e use o resultado para calibrar a próxima iteração.
Se você já tem uma fotografia que quer animar, envie-a diretamente junto com um prompt de movimento. Essa combinação produz um resultado forte o bastante para projetos criativos reais na primeira ou segunda tentativa, na maioria dos casos, sem nenhuma configuração adicional ou ajuste de parâmetros.
Para criadores que querem ir além, o catálogo completo do PicassoIA oferece a flexibilidade de escolher a ferramenta certa para cada trabalho específico. O modelo Kling v2.6 Motion Control lida com trabalhos de trajetória de câmera precisa. O P Video oferece um ciclo de iteração rápido para prototipagem ágil. E, para gerar várias variações de vídeo em escala, a interface do PicassoIA suporta fluxos em lote que tornam a produção em alto volume prática, sem infraestrutura extra.
A flexibilidade de entrada do Kling v3 Omni Video elimina o maior ponto de atrito na produção de vídeo com IA: o descompasso entre os ativos que você tem e as entradas que um modelo aceita. Traga o que você tem, descreva o que quer e deixe o modelo fazer o resto. Veja tudo o que está disponível em picassoia.com/en/all-models.