Comment Kling v3 Omni Video gère plusieurs types d’entrées
Kling v3 Omni Video traite les prompts texte, les images fixes et les clips vidéo de référence grâce au même socle de modèle. Cet article détaille le fonctionnement de chaque mode d’entrée, ce qu’il contrôle dans le résultat, et comment combiner les entrées pour obtenir des rendus cinématographiques en 1080p.
Kling v3 Omni Video ne vous oblige pas à vous limiter à un seul mode. Vous pouvez lui fournir une phrase, une photographie, un clip vidéo existant, ou une combinaison des trois, et il produit à chaque fois un résultat cinématographique cohérent. Cette flexibilité n’est pas une fonctionnalité mineure. Elle change tout le flux de travail de production pour les créateurs qui travaillent avec des médias mixtes, et elle fait de Kling v3 Omni Video l’un des outils de génération de vidéos les plus polyvalents disponibles actuellement. Cet article détaille précisément comment chaque type d’entrée est traité, ce que le modèle en fait, et ce que cela signifie pour votre création.
Ce qu’est réellement Kling v3 Omni
Kling v3 Omni Video est la variante multimodale de la génération Kling v3 de Kuaishou. Le label « Omni » désigne quelque chose de précis : un socle de modèle unifié qui accepte des entrées hétérogènes sans nécessiter de pipelines d’inférence distincts pour chaque mode. La plupart des modèles de génération vidéo sont spécialisés. Un modèle texte vers vidéo gère une correspondance, un modèle image vers vidéo en gère une autre. Kling v3 Omni traite toutes ces correspondances au sein de la même architecture de transformeur de diffusion, ce qui produit des résultats qui paraissent cohérents et délibérés, plutôt qu’assemblés à partir de systèmes séparés.
Un seul socle, plusieurs entrées
L’architecture centrale repose sur un transformeur de diffusion qui traite des représentations tokenisées de chaque type d’entrée à travers des couches d’attention partagées. Le texte devient des embeddings de tokens. Une image devient des tokens de patchs. Une vidéo de référence devient des séquences de patchs temporels. Comme toutes ces représentations transitent par la même architecture, le modèle peut les combiner contextuellement, une image de référence contraignant la composition pendant qu’un prompt texte contrôle le comportement du mouvement. Ce traitement partagé explique pourquoi le conditionnement multi-entrées produit des résultats plus rigoureux et plus intentionnels qu’un enchaînement de deux modèles distincts.
Pourquoi cela compte en production réelle
La plupart des créateurs ne partent pas de prompts texte vierges. Ils partent de ressources : photographies de marque, prises de vue de produits, images de lieux, planches de storyboard. Un modèle qui n’accepte que le texte les oblige à traduire d’abord ces ressources visuelles en langage, en perdant de la fidélité à chaque étape de traduction. Kling v3 Omni Video accepte directement la ressource, en préservant l’identité visuelle sans cette couche de traduction. Il en résulte une boucle de rétroaction plus serrée entre ce que vous voulez et ce qui est généré, un gain qui s’accumule nettement dans les flux de production plus importants.
💡 En bref : si vous disposez d’une image de référence solide, utilisez-la. Elle est systématiquement plus performante qu’un prompt uniquement textuel lorsqu’il est important de préserver une identité visuelle précise.
L’entrée texte : la couche du prompt
Le texte est le type d’entrée le plus rapide et le point d’accès le plus courant. Kling v3 Omni Video traite le texte à la fois comme une description de mouvement, une architecture de scène et une directive émotionnelle. Un prompt ne dit pas seulement au modèle ce qu’il doit montrer. Il lui dit comment les choses bougent, comment la lumière se comporte et ce que fait la caméra à chaque image du résultat.
Comment le modèle lit le langage
Le modèle traite le texte à travers un encodeur de langage pré-entraîné, complété par un fine-tuning sur un vocabulaire spécifique au mouvement. Le résultat est un ensemble de vecteurs de conditionnement qui influencent le débruitage à chaque étape de diffusion. Conséquence pratique : un langage vague produit un mouvement moyen. Un langage précis produit un mouvement précis. Voici les catégories sémantiques auxquelles le modèle répond le plus fortement dans un prompt texte :
Élément du prompt
Ce qu’il contrôle
Description du sujet
Identité de l’objet et apparence visuelle
Verbes d’action
Direction et vitesse principales du mouvement
Contexte de l’environnement
Génération de l’arrière-plan et profondeur de la scène
Simulation de l’illumination et tonalité des couleurs
Mots temporels (« progressivement », « soudainement »)
Timing du mouvement et courbe d’accélération
L’anatomie d’un prompt qui donne des résultats
La différence entre un résultat faible et un résultat fort tient presque toujours à la précision de la description du mouvement. Voici une comparaison directe :
Faible : « Une femme qui marche dans une ville la nuit »
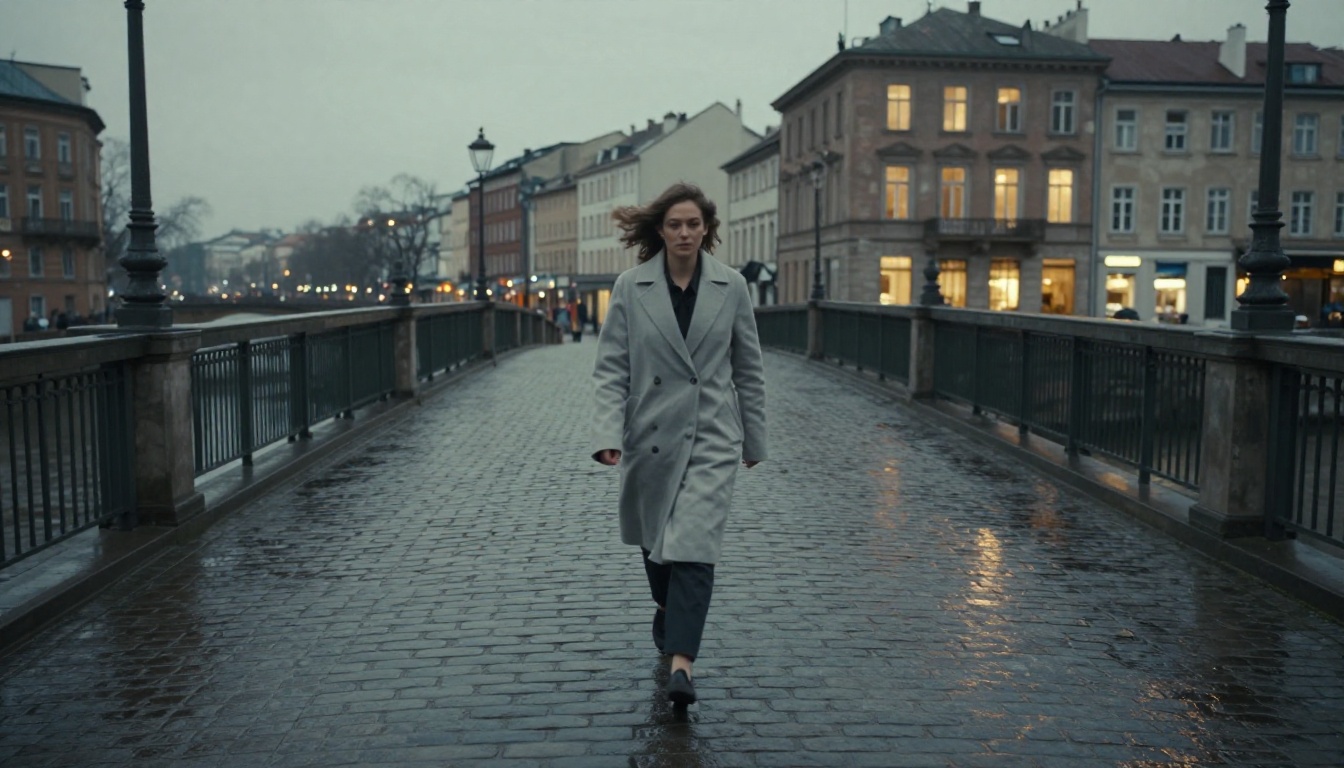
Fort : « Une femme en manteau de laine gris foncé qui marche lentement sur une place pavée mouillée au crépuscule, la caméra la suivant à hauteur d’épaule avec une légère dérive vers l’avant, les lumières de la ville se reflétant dans les flaques de pluie au sol, un léger flou de mouvement sur l’ourlet de son manteau sous le vent froid »
Le second prompt donne au modèle assez de signal pour prendre des décisions cohérentes sur les 24 images par seconde. Chaque élément, de la position de la caméra à la physique du tissu, reçoit une instruction claire. Le modèle comble moins de vide par du bruit et davantage par une synthèse intentionnelle.
Ce dont vous n’avez pas besoin dans un prompt texte
Kling v3 Omni Video n’a pas besoin de qualificatifs de style génériques comme « cinématographique » ou « photoréaliste » en début de chaque prompt. Le modèle utilise par défaut un rendu photoréaliste en 1080p. Ajouter ces mots-clés ne nuit pas, mais ils ne modifient pas non plus beaucoup le résultat. Ce qui change réellement la qualité, c’est la précision du mouvement et la clarté des instructions de caméra. Rédigez une instruction de caméra précise, et la qualité cinématographique découle naturellement de la capacité de rendu de base du modèle.
Les images fixes comme germes de vidéo
Le mode image vers vidéo est le domaine où Kling v3 Omni Video démontre son avantage le plus marqué face à la concurrence. Lorsque vous fournissez une image fixe, le modèle l’utilise comme première image exacte de la vidéo, puis synthétise un mouvement plausible à partir de cette image. Aucun élément de l’image n’est remplacé ni modifié de façon notable dans les premières images. Ce qui change, c’est le temps : le modèle ajoute du mouvement, simule la physique, génère un mouvement de caméra et prolonge la scène en une séquence temporelle cohérente.
D’une image figée à une scène vivante
Le processus implique deux opérations menées en parallèle. D’abord, le modèle encode votre image en une représentation de caractéristiques dense qui sert d’ancre visuelle tout au long du débruitage. Chaque image générée est ramenée vers la cohérence avec cette ancre, ce qui explique pourquoi l’identité visuelle reste intacte sur toute la durée du clip. Ensuite, le prompt texte (s’il est fourni avec l’image) conditionne la direction du mouvement par-dessus cette ancre. L’image contrôle à quoi la scène ressemble. Le texte contrôle comment elle bouge. Ces deux signaux sont traités simultanément et non en séquence.
Ce que la composition et la résolution affectent
La qualité de votre image d’entrée a un impact direct et mesurable sur la qualité du résultat. Voici les facteurs qui comptent le plus en pratique :
Facteur de l’image
Effet sur le résultat
Sujet centré dans le cadre
Le modèle génère un mouvement de caméra symétrique
Sujet positionné hors centre
Le modèle a tendance à faire un panoramique vers le sujet
Profondeur de champ élevée (image plate)
Parallaxe simulée moins prononcée
Faible profondeur de champ (arrière-plan flou)
Séparation de profondeur et parallaxe plus marquées
Résolution supérieure à 720p
Détails plus nets conservés dans les images du résultat
Images sombres ou fortement surexposées
Cohérence temporelle dégradée entre les images
💡 Astuce : pour de meilleurs résultats en image vers vidéo, utilisez des images avec une séparation claire du sujet et un éclairage ambiant naturel. Les images très contrastées à l’éclairage artificiel provoquent parfois des artefacts de scintillement dans les images intermédiaires du résultat.
Recommandations pratiques pour les images d’entrée
Le format compte davantage que ce que la plupart des créateurs imaginent. Kling v3 Omni Video adopte par défaut le format de l’image d’entrée pour la vidéo de sortie. Si vous voulez une sortie en 16:9, partez d’une image en 16:9. Recadrer après la génération dégrade la qualité sur les bords. Fournir le bon format dès le départ évite complètement les artefacts de recadrage.
Le niveau de compression de l’image joue aussi un rôle. Les fichiers JPEG très compressés introduisent des artefacts de blocs que le modèle reproduit parfois dans le mouvement. Les fichiers PNG ou les JPEG de haute qualité au-delà de 90 % de qualité de compression produisent un résultat constamment plus net sur toute la durée de la vidéo.
Les clips vidéo comme entrée de référence
Le type d’entrée vidéo de référence est le moins évident, mais sans doute le mode le plus puissant. Au lieu d’utiliser une vidéo comme source de contenu, vous l’utilisez comme source de vocabulaire de mouvement et de style. Vous fournissez un court clip de référence avec un prompt texte (et éventuellement une image de référence), et le modèle extrait du clip les caractéristiques de mouvement, le rythme temporel et les motifs stylistiques, puis les applique à un contenu entièrement nouveau.
Ce que le modèle extrait des séquences de référence
Le modèle ne copie pas le mouvement du clip de référence. Il construit une représentation latente des motifs temporels : la vitesse à laquelle les choses changent d’une image à l’autre, la direction dominante du mouvement, la caméra fixe ou mobile, et le rythme général de la scène. Ces motifs deviennent des signaux de conditionnement supplémentaires dans le processus de débruitage, superposés aux signaux du texte et de l’image.
Ce n’est pas la même chose que le transfert de style vidéo. Le transfert de style modifie à quoi ressemble le résultat. L’entrée vidéo de référence modifie comment le résultat bouge. Vous pouvez prendre une séquence d’un documentaire animalier en ralenti, en extraire le rythme temporel et l’appliquer à un sujet entièrement différent dans un décor tout autre. Le contenu source ne se transfère pas. Seul le vocabulaire de mouvement se transfère, ce qui vous donne un contrôle précis du rythme sans avoir à le décrire en langage naturel.
Cas d’usage créatifs pour l’entrée vidéo de référence
Contenu de marque cohérent : si vous disposez de vidéos produit existantes avec un style de caméra spécifique, utilisez un clip de votre archive comme référence. Les nouvelles générations reprennent automatiquement la signature de mouvement sans que vous ayez besoin de la décrire explicitement.
Production de séries cohérentes : lorsque vous générez plusieurs vidéos pour une campagne, utilisez une génération précoce comme référence de mouvement pour les suivantes. Cela crée une cohérence temporelle à travers le lot sans ajustement manuel des paramètres.
Génération de style documentaire : les séquences tournées à l’épaule transmettent un mouvement de caméra organique aux scènes générées, qui paraîtraient sinon trop lisses et artificielles.
Rythme maîtrisé : prenez un clip au ralenti comme référence pour appliquer ce rythme mesuré à un nouveau sujet, sans aucun paramètre temporel explicite dans le prompt texte.
💡 Durée du clip de référence : les courts clips de 2 à 5 secondes donnent de meilleurs résultats que les longs. Le modèle capte la texture du mouvement, pas une suite d’actions précises. Une référence de 10 secondes ne vous donne pas plus de contrôle qu’un clip de 4 secondes.
Combiner les types d’entrées
Tout le potentiel de Kling v3 Omni Video apparaît lorsque vous combinez les types d’entrées. Le modèle est conçu pour un conditionnement multi-signaux, et les résultats issus d’entrées combinées sont systématiquement plus solides que les générations à entrée unique, quelle que soit la catégorie de sujet.
Texte et image : le flux standard et efficace
C’est la combinaison la plus courante et la plus prévisible. L’image fixe l’identité visuelle. Le texte fixe le mouvement. Ensemble, ils éliminent les deux incertitudes les plus fortes de la génération vidéo : « Est-ce que ça aura le bon aspect ? » (réglée par l’image) et « Est-ce que ça bougera correctement ? » (réglée par le prompt texte).
Une formule qui donne des résultats fiables pour différents types de sujets :
[Visual subject from image] + [Motion instruction in text] + [Camera instruction in text] + [Environment context in text]
Exemple : image de départ d’une femme en veste rouge debout dans un champ. Prompt texte : « Elle lève lentement les deux mains vers le ciel couvert, la caméra reculant doucement pour révéler l’étendue de la prairie derrière elle, une lumière chaude de début d’après-midi venant de la gauche. »
L’image garantit que la veste rouge, le visage et l’environnement du champ restent exactement tels qu’ils apparaissent sur la photographie. Le texte garantit que le mouvement et le comportement de la caméra suivent précisément votre intention créative. Aucun des deux éléments ne contrarie l’autre lorsque les signaux sont bien séparés comme ici.
Quand la vidéo de référence change tout
Ajouter un clip vidéo de référence à un flux texte et image introduit une troisième couche de contrôle : le rythme temporel et le style de mouvement. Ce mode à trois entrées convient surtout aux travaux à forte valeur de production, où la cohérence entre plusieurs pièces compte. Lorsque trois signaux de conditionnement concurrents créent une tension dans le résultat, réduire le poids de l’entrée de clip de référence (disponible sous forme de curseur dans la plupart des interfaces) résout le conflit sans perdre l’avantage du vocabulaire de mouvement.
Le flux à trois entrées demande un peu plus de préparation qu’une génération à entrée unique, mais le plafond de qualité du résultat est nettement plus élevé. Pour les contenus de marque, les présentations de produits et les séries de production où la cohérence visuelle compte sur de nombreuses pièces, l’investissement de préparation se rentabilise vite.
Utiliser Kling v3 Omni sur PicassoIA
Kling v3 Omni Video est disponible directement sur PicassoIA, sans installation, sans jetons API et sans matériel local. Tout le flux de travail se déroule dans un navigateur.
Étape 1 : ouvrez la page du modèle
Rendez-vous sur Kling v3 Omni Video sur PicassoIA. L’interface s’ouvre avec trois zones d’entrée visibles : prompt texte, import d’image et clip vidéo de référence facultatif. Ces trois entrées sont facultatives indépendamment les unes des autres, mais remplir le champ du prompt texte vaut toujours la peine, même en mode image vers vidéo.
Étape 2 : choisissez votre stratégie d’entrée
Décidez quelle combinaison convient à votre projet avant d’écrire quoi que ce soit :
Flux de travail
Idéal pour
Texte seul
Nouvelles scènes sans ressources visuelles existantes
Image et texte
Animer des photos ou des prises de vue de produits
Vidéo de référence et texte
Reproduire un style de mouvement existant
Les trois combinés
Séries de contenus de marque à forte cohérence
Étape 3 : rédigez un prompt de mouvement précis
Même en mode image vers vidéo, rédigez toujours un prompt de mouvement. L’image gère l’identité visuelle. Le prompt gère le mouvement. Un prompt minimal comme « la caméra reste immobile, le sujet respire naturellement » donne tout de même au modèle une direction de mouvement claire, ce qui réduit nettement le bruit temporel dans le résultat. Précisez toujours le mouvement de caméra si vous avez une préférence, car le comportement de caméra par défaut du modèle varie selon la composition de la scène.
Étape 4 : réglez la sortie en 1080p
PicassoIA permet de choisir la résolution au moment de la génération. Kling v3 Omni produit nativement du 1080p. Pour les contenus destinés aux réseaux sociaux et à la diffusion web, c’est le réglage approprié. Si vous comptez retravailler la vidéo en post-production, générer à la résolution maximale vous laisse davantage de souplesse sans introduire d’artefacts de rééchantillonnage pendant le montage.
Étape 5 : évaluez et itérez
La première génération sert de point de repère, pas de produit final. Évaluez-la selon trois critères : la qualité du mouvement, la cohérence visuelle avec votre image de référence si vous en avez utilisé une, et la cohérence temporelle sur toute la durée du clip. Si le mouvement est bon mais que l’identité visuelle a dérivé, augmentez le poids du conditionnement par l’image. Si le mouvement paraît générique, ajoutez de la précision aux verbes de mouvement dans le prompt texte.
En complément de Kling v3 Omni Video, PicassoIA propose aussi ces modèles associés pour différents besoins de production :
Kling v3 Video : Kling v3 standard en texte vers vidéo, pour les flux basés uniquement sur le prompt
Kling v3 Motion Control : contrôle précis de la trajectoire de caméra pour les travaux de cinématographie scénarisés
Kling v2.6 : génération précédente pour des charges plus légères et des cycles d’itération plus rapides
Kling v2.5 Turbo Pro : génération optimisée en vitesse, lorsque la fréquence d’itération compte davantage que la qualité maximale du résultat
La qualité du résultat en pratique
Le résultat de Kling v3 Omni Video est produit en 1080p, à 24 images par seconde, avec une cohérence temporelle native intégrée à l’architecture. La cohérence temporelle est le critère qui distingue une vidéo prête pour la production d’un résultat expérimental. Elle mesure si les objets, les visages et les surfaces restent visuellement stables d’une image à l’autre, plutôt que de scintiller, de dériver ou de se déformer de façon inattendue au cours du clip.
Indicateurs de qualité par image
Dimension de qualité
Performance de Kling v3 Omni
Résolution spatiale
Sortie native en 1080p
Fréquence d’images
24 fps avec interpolation fluide
Cohérence temporelle
Solide, surtout avec une image d’ancrage en entrée
Physique des objets
Réaliste pour les objets rigides comme pour les objets mous
Stabilité du visage
Forte cohérence sur les sujets humains d’une image à l’autre
Fluidité du mouvement de caméra
Excellente avec une instruction de caméra explicite
Comparaison avec les alternatives
Pour une génération purement texte vers vidéo, des modèles comme Seedance 2.5 et Ray 3.2 sont des alternatives sérieuses qui méritent d’être testées, en particulier pour les scènes atmosphériques et les paysages, où l’identité du sujet est moins critique. Pour la conversion d’image en vidéo en particulier, Wan 2.7 I2V donne de bons résultats avec un mouvement remarquablement fluide dans les environnements naturels.
Ce que Kling v3 Omni Video fait mieux que la plupart des alternatives, c’est la combinaison complète : préserver une identité visuelle précise à partir d’une image de référence, et diriger le mouvement avec précision par le texte, et reprendre un style de mouvement de référence issu d’un clip existant. Aucun modèle à mode unique ne reproduit ce flux à trois entrées.
La capacité d’effets visuels du modèle va bien au-delà du mouvement linéaire de base :
Physique des tissus et des cheveux : drapé réaliste et interaction avec le vent, cohérents sur toutes les images
Simulation des liquides : comportement convaincant de l’eau, de la vapeur et du brouillard pendant toute la durée du clip
Éclairage dynamique : variations de lumière qui évoluent naturellement sur la chronologie de la vidéo
Parallaxe de profondeur : mouvement en couches naturel dans les scènes à séparation nette entre premier plan et arrière-plan
Mouvement humain : marche, gestes et changements de posture avec une plausibilité biomécanique, plutôt qu’une répétition robotique
💡 Pour les travaux d’effets visuels : combinez une image de référence solide avec un langage directionnel précis pour l’effet souhaité. « Tissu ondulant sous le vent venant de la gauche » est traité plus précisément qu’une description générique du vent. Le modèle répond fortement à la précision physique et directionnelle dans le langage de mouvement.
Commencez à créer dès maintenant
Chaque flux de travail décrit dans cet article est disponible sur PicassoIA dès maintenant, sans abonnement requis pour commencer. Le parcours texte seul est le point de départ le plus rapide si vous voulez voir ce que produit Kling v3 Omni Video avant de préparer des ressources de référence. Rédigez un prompt de mouvement précis, lancez une génération, et utilisez le résultat pour calibrer votre itération suivante.
Si vous avez déjà une photographie que vous voulez animer, importez-la directement avec un prompt de mouvement. Cette combinaison produit, dans la plupart des cas, un résultat assez solide pour des projets créatifs réels dès la première ou la deuxième tentative, sans aucune configuration supplémentaire ni réglage de paramètres.
Pour les créateurs qui veulent aller plus loin, le catalogue complet de PicassoIA vous permet de choisir l’outil adapté à chaque tâche précise. Le modèle Kling v2.6 Motion Control gère les travaux à trajectoire de caméra précise. P Video offre une boucle d’itération rapide pour le prototypage rapide. Et pour générer plusieurs variantes vidéo à grande échelle, l’interface de PicassoIA prend en charge les flux de traitement par lots, ce qui rend la production en volume praticable sans infrastructure supplémentaire.
La souplesse des entrées de Kling v3 Omni Video supprime le principal point de friction de la production vidéo par IA : le décalage entre les ressources dont vous disposez et les entrées qu’un modèle accepte. Apportez ce que vous avez, décrivez ce que vous voulez, et laissez le modèle faire le reste. Découvrez tout ce qui est disponible sur picassoia.com/en/all-models.