تكتب بضع كلمات، وتضغط على توليد، وخلال ثوانٍ تظهر صورة واقعية كالصور الفوتوغرافية. تبدو العملية سهلة من الخارج، لكن خلف كل نموذج لتحويل النص إلى صورة أشهر من الحوسبة، ومليارات أمثلة التدريب، وسلسلة دقيقة بشكل لافت من قرارات تعلم الآلة. يكشف هذا المقال عن كيفية تدريب نماذج تحويل النص إلى صورة، بدءًا من المكونات الخام وصولًا إلى النظام النهائي المنشور الذي تتفاعل معه.
مشكلة البيانات تأتي أولًا
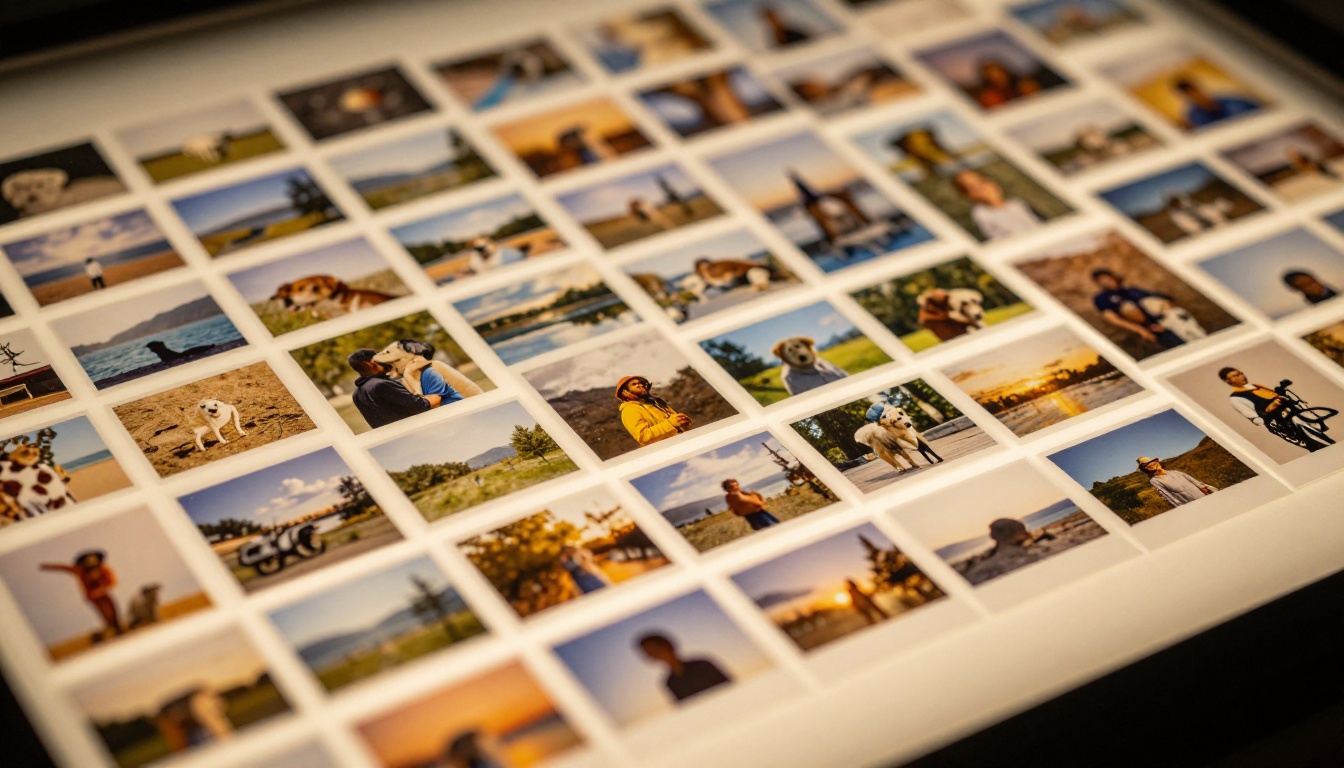
قبل أن تدرّب أي شبكة عصبية وزنًا واحدًا، لا بد من حل مشكلة البيانات. تحتاج نماذج تحويل النص إلى صورة إلى مجموعات ضخمة من أزواج الصورة والوصف، أي أن كل صورة فوتوغرافية أو رسم توضيحي يجب أن يأتي مرفقًا بوصف مكتوب دقيق لما تُظهره.
الحجم هنا ليس متواضعًا. نماذج مثل Stable Diffusion دُرّبت على مجموعات فرعية من مجموعة بيانات LAION-5B، التي تحتوي على نحو خمسة مليارات زوج من الصور والنصوص جُمعت من صفحات ويب متاحة للعموم. أما الأنظمة الأحدث، ومنها Flux Redux Dev من Black Forest Labs، فتعتمد على مجموعات بيانات منتقاة ومصقولة من حيث الجودة أكثر من الكم الخام.
من أين تأتي الصور
يأتي معظم صور التدريب من جمع البيانات من الويب على نطاق واسع. تزور الزواحف الآلية مليارات صفحات الويب، وتنزّل كل صورة تجدها مع نص HTML المحيط بها، وسمات alt، والتسميات التوضيحية. ثم تمرّ هذه الحصيلة الخام بعدة مراحل تصفية.
تزيل المرشحات الشائعة:
- الصور التي تقل عن حد أدنى من الدقة (عادةً 512x512 بكسل)
- الصور شبه المكررة التي قد تدفع النموذج نحو محتوى بعينه
- الصور ذات التسميات غير المتطابقة أو الفارغة
- المحتوى الذي تُعلّمه مصنّفات السلامة
ما يتبقى يظل عينة غير مثالية ومنحازة بقوة من الإنترنت، ولهذا أصبح تنسيق البيانات وتنقيحها من أهم القرارات التي تتخذها أي مختبر نماذج.
كيف تُقرن أوصاف النصوص بالصور
ليست كل صورة على الويب تأتي بوصف مفيد. قد تحمل صورة منتج وسم alt باسم مثل "img_4782.jpg"، بينما لا يحمل منشور اجتماعي أي تسمية على الإطلاق. للتعامل مع ذلك، تفعل مختبرات النماذج أحد أمرين:
- استخدام التسميات الموجودة من مصادر موثوقة (ويكيبيديا، وقواعد صور المخزون، وأرشيفات الأخبار) حيث تتوفر أوصاف مكتوبة بيد بشرية
- توليد تسميات اصطناعية باستخدام نموذج لغوي بصري يصف محتوى الصورة تلقائيًا
أصبح الخيار الثاني معيارًا متبعًا. تُستخدم أنظمة مثل LLaVA أو Flamingo لتوليد أوصاف مفصّلة لملايين الصور التي تفتقر إلى أزواج نصية صالحة للاستخدام. والنتيجة تسمية أغنى تصف لا الموضوع وحده، بل الإضاءة والتكوين والمزاج أيضًا.
لماذا تغيّر جودة البيانات كل شيء
النموذج الذي يُدرَّب على تسميات غير متطابقة بشكل سيئ سيواجه صعوبة في اتباع الأوامر النصية بدقة. إذا وُصفت صورة غروب الشمس بعبارة "صورة جميلة" بدلًا من "غروب شمس ذهبي فوق أمواج المحيط مع سماء برتقالية وأرجوانية"، فإن النموذج لا يتعلم تقريبًا شيئًا من هذا المثال عن كيف يجب أن يبدو "غروب الشمس".
لهذا تستثمر مختبرات مثل Bytedance (وراء Seedream 4.5) وStability AI (وراء Stable Diffusion 3) بكثافة في خطوط معالجة البيانات، لا في الحوسبة وحدها. فالبيانات الأفضل كثيرًا ما تتفوق على الحوسبة الأكبر.
💡 عجلة البيانات الدوّارة: يمكن للشركات ذات قواعد المستخدمين الكبيرة أن تستخدم الأوامر النصية الحقيقية وتقييمات المستخدمين لتحسين جودة البيانات باستمرار، ما يمنح المنصات الراسخة ميزة متنامية على الوافدين الجدد.
البنية التي تتولى التعلم
بعد أن تتوفر مجموعة بيانات نظيفة، تحدد بنية النموذج الطريقة التي يعالج بها النظام تلك البيانات. هناك نهجان سائدان يشغّلان معظم نماذج تحويل النص إلى صورة الحديثة: نماذج الانتشار (diffusion) والنماذج الانحدارية الذاتية (autoregressive). ونماذج الانتشار هي الخيار الأكثر شيوعًا بفارق كبير.
شرح مبسّط لنماذج الانتشار
يولّد نموذج الانتشار الصور عبر عكس عملية تدمير. أثناء التدريب، يأخذ النظام صورًا حقيقية ويضيف تدريجيًا ضوضاء غاوسية على مدى مئات الخطوات حتى تصبح الصورة غير قابلة للتمييز عن الضجيج العشوائي الخالص. ثم يتدرب النموذج على التنبؤ بتلك الضوضاء وإزالتها خطوةً خطوة، بالعمل إلى الخلف من الفوضى نحو صورة متماسكة.
عند التشغيل، يبدأ النموذج بضوضاء خالصة ويزيلها تكراريًا، موجَّهًا بأمر نصي، إلى أن تظهر صورة يمكن التعرف عليها. وهذا الشرط النصي هو ما يوجّه إزالة الضوضاء في اتجاه محدد.
تجري هذه العملية فيما يسمى الفضاء الكامن (latent space) بدلًا من فضاء البكسل. تضغط شبكة منفصلة تسمى المشفّر التلقائي المتغير (VAE) الصور كاملة الدقة إلى تمثيل مضغوط ذي أبعاد أقل قبل أن تبدأ عملية الانتشار. وهذا يخفض تكلفة الحوسبة للتدريب والتشغيل بشكل كبير.
دور CLIP في التدريب
لكي يولّد النموذج صورًا من النص، يحتاج إلى فضاء تمثيل مشترك يمكن فيه مقارنة النص والصور بمعنى. وقد أتاح CLIP (Contrastive Language-Image Pretraining) من OpenAI الاختراق الذي جعل ذلك ممكنًا.
دُرّب CLIP على 400 مليون زوج من الصور والنصوص لينتج تضمينات تقع فيها الصور والتسميات المتطابقة قريبة من بعضها في الفضاء الاتجاهي، بينما تُدفع الأزواج غير المتطابقة بعيدًا. يعني هذا النهج التعلمي التباينيّ أن عبارة "سيارة رياضية حمراء على طريق جبلي" تنتج تضمينًا قريبًا هندسيًا من الصور الفعلية للسيارات الرياضية الحمراء على الطرق الجبلية.
تستخدم معظم نماذج الانتشار CLIP أو خلفًا له (مثل مشفّر النصوص T5 المستخدم في Stable Diffusion 3) لتحويل الأوامر النصية المدخلة إلى متجهات شرطية. تُحقن هذه المتجهات بعد ذلك في شبكة إزالة الضوضاء عبر طبقات الانتباه المتقاطع، فتخبر النموذج بالمفاهيم البصرية التي يجب أن يركّز عليها في كل خطوة من خطوات إزالة الضوضاء.
الفضاء الكامن: لماذا يهم
مفهوم الفضاء الكامن محوري في طريقة عمل مولّدات الصور الحديثة، وهو يفسّر لماذا تحظى هندسة الأوامر النصية بهذه الأهمية. كل نقطة في الفضاء الكامن تقابل صورة محتملة. وتتجمع الصور ذات الخصائص البصرية المتشابهة قرب بعضها. عندما تكتب أمرًا نصيًا، يربط مشفّر النص كلماتك بمنطقة في هذا الفضاء، ويجد مُزيل الضوضاء صورة معقولة داخل تلك المنطقة.
لهذا قد تُنتج التغييرات الصغيرة في الأمر النصي مخرجات مختلفة تمامًا. فالتحرك قليلًا في الفضاء الكامن قد يعبر إلى عنقود بصري آخر. وقد صُمّمت نماذج مثل Recraft 20B و GPT Image 2 خصيصًا بحيث تحترم فضاءاتها الكامنة تعليمات الأوامر الدقيقة على نحو أفضل.
كيف يبدو التدريب فعلًا
فهم البنية شيء، ورؤية ما يتضمنه التدريب فعلًا شيء آخر. إنه حلقة تحسين ممتدة ومكلفة حوسبيًا تعمل بلا انقطاع لأسابيع أو أشهر.
دوال الخسارة والتدرجات
أثناء التدريب، يعالج النموذج دفعة من أزواج الصور والنصوص. وبالنسبة لكل زوج، يضيف ضوضاء إلى الصورة ثم يحاول التنبؤ بما أُضيف. الفرق بين الضوضاء المتوقعة والضوضاء الفعلية هو الخسارة، وتسمى تحديدًا خسارة مطابقة نقاط إزالة الضوضاء (denoising score matching loss).
ثم يحسب المُحسِّن (عادةً Adam أو AdamW) تدرجات هذه الخسارة بالنسبة لكل معامل في النموذج، ويدفع تلك المعاملات في الاتجاه الذي يقلل الخطأ. يتكرر ذلك عبر مليارات أزواج الصور والنصوص على مدى أيام أو أسابيع.
مع تقدم التدريب، ينخفض منحنى الخسارة. في البداية، يولّد النموذج ضوضاء غير متماسكة بأشكال غامضة. وبعد ملايين الخطوات تظهر بنى واضحة. وبعد عشرات الملايين من الخطوات تصبح النتائج الواقعية كالصور الفوتوغرافية، مع التزام دقيق بالأوامر النصية، ممكنة.
كم يستغرق التدريب فعلًا
الأرقام هنا مذهلة:
| حجم النموذج | زمن التدريب التقريبي | وحدات GPU المطلوبة |
|---|
| صغير (300 مليون معامل) | 2-5 أيام | 8-32 من A100 |
| متوسط (1 مليار معامل) | 1-3 أسابيع | 64-256 من A100 |
| كبير (3 مليارات معامل فأكثر) | 4-12 أسبوعًا | 512-2048 من H100 |
| كبير جدًا (10 مليارات معامل فأكثر) | 3-6 أشهر | أكثر من 4000 من H100 |
يقع نموذجا Wan 2.7 Image Pro وHunyuan Image 2.1 ضمن فئة الكبير إلى الكبير جدًا، وهما يحتاجان إلى عناقيد لن تمتلكها معظم المؤسسات بالكامل أبدًا.
واقع الأجهزة
وحدات GPU هي العمود الفقري لتدريب النماذج، لكن البنية التحتية المحيطة بها لا تقل أهمية. تُعد الروابط عالية السرعة (NVLink وInfiniBand) ضرورية لمزامنة التدرجات عبر مئات وحدات GPU في آن واحد. ويجب أن تقدّم أنظمة التخزين بيانات التدريب بسرعة كافية لإبقاء وحدات GPU مشغولة دون اختناقات. وتصبح الطاقة والتبريد على نطاق واسع تحديات هندسية حقيقية.
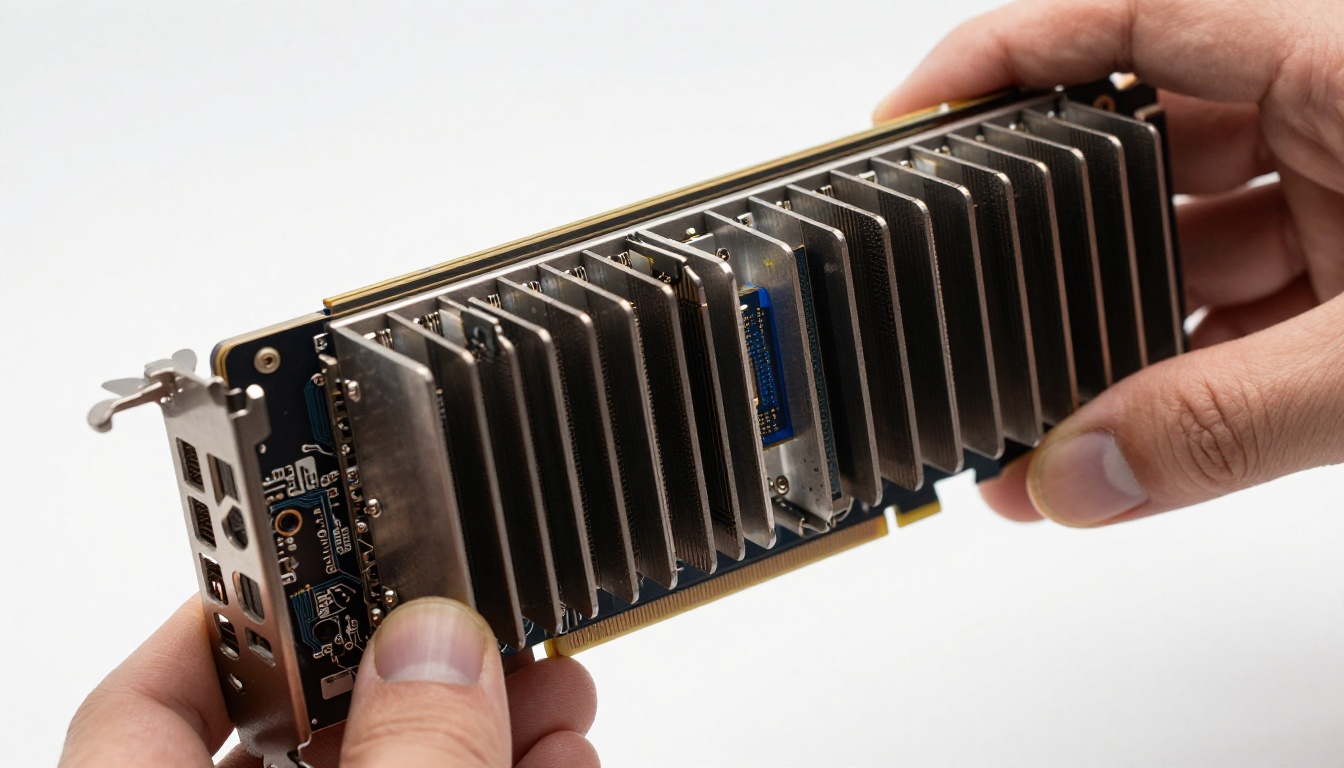
تبلغ تكلفة تدريب نموذج تحويل نص إلى صورة رائد من الصفر ملايين الدولارات. ولهذا قلّة من المؤسسات تدرّب النماذج الأساسية من الصفر، بينما يركز كثيرون أكثر على الضبط الدقيق للنماذج القائمة.
الضبط الدقيق بعد التدريب الأولي
يمنح التدريب المسبق لنموذج على مليارات الأمثلة قدرات عامة واسعة. ثم يتولى الضبط الدقيق تخصيصه لأساليب أو موضوعات أو سلوكيات محددة دون تكرار عملية التدريب الكاملة.
LoRA: أساليب مخصصة دون إعادة تدريب كامل
أصبح LoRA (Low-Rank Adaptation) طريقة الضبط الدقيق الأكثر شيوعًا في مجال تحويل النص إلى صورة. فبدلًا من تحديث كل المليارات من معاملات النموذج، يضيف LoRA مصفوفات صغيرة منخفضة الرتبة إلى جانب مصفوفات الأوزان الموجودة. ولا يُدرَّب إلا هذه الإضافات على مجموعة البيانات المخصصة.
النتيجة العملية: قد تحتاج جولة تدريب LoRA على أسلوب تصوير أو شخصية أو منتج محدد إلى 20-100 صورة فقط، ووحدة GPU من فئة المستهلك، وبضع ساعات من التدريب، بدلًا من الأشهر والملايين اللازمة لنموذج أساسي كامل.
هذا تحديدًا ما يقدمه P Image Trainer على PicassoIA. فهو يتيح لأي شخص تدريب LoRA مخصص على صوره الخاصة، ثم استخدام المحوّل المدرَّب لتوليد صور جديدة بالأسلوب نفسه أو بالموضوع نفسه.
ما الذي يتطلبه الضبط الدقيق
تحتاج جلسة ضبط دقيق ناجحة باستخدام LoRA إلى:
- حجم مجموعة البيانات: 15-200 صورة عالية الجودة للموضوع أو الأسلوب المستهدف
- جودة التسميات: تحتاج كل صورة إلى وصف دقيق ومفصّل
- اختيار النموذج الأساسي: تحدد القدرات الموجودة في النموذج الأساسي ما يمكن أن يضيفه الضبط الدقيق
- المعاملات الفائقة: معدل التعلم وعدد الخطوات وحجم الرتبة كلها تؤثر في جودة المخرجات
💡 فخ الإفراط في الملاءمة: التدريب لفترة طويلة على عدد قليل جدًا من الصور يجعل النموذج يحفظ الأمثلة بدلًا من أن يعمّم. إذا بدت كل صورة مولّدة متطابقة مع صور تدريبك، فإما أن معدل التعلم كان مرتفعًا جدًا أو أنك شغّلت عددًا كبيرًا جدًا من الخطوات.
متى تضبط النموذج بدقة ومتى تكتفي بالأمر النصي
ليست كل حالة استخدام تحتاج إلى نموذج مضبوط بدقة. نماذج تحويل النص إلى صورة مثل Flux Schnell LoRA قادرة أصلًا على اتباع الأوامر النصية الطبيعية المفصّلة لموضوعات متنوعة. ويصبح الضبط الدقيق ضروريًا فعلًا عندما:
- تحتاج إلى تمثيل ثابت لوجه محدد أو شخصية محددة
- تريد أسلوبًا بصريًا خاصًا لا يستطيع الأمر النصي وحده تكراره
- تولّد صور منتجات يجب أن تظهر فيها ألوان العلامة التجارية وتفاصيلها بدقة
- تحتاج إلى أن يولّد النموذج محتوى من مجال متخصص له حضور محدود على الإنترنت
مقارنة النماذج الحديثة
شهد مشهد تحويل النص إلى صورة في 2025 تشظّيًا إلى عدة فلسفات معمارية متمايزة:
| النموذج | البنية | نقطة القوة | الاستخدام الأمثل |
|---|
| Stable Diffusion 3 | محوّل الانتشار (Diffusion Transformer) | أوزان مفتوحة، قابلة للتخصيص | الضبط الدقيق والبحث |
| Flux Redux Dev | مطابقة التدفق (Flow Matching) | جودة تنويعات الصور | ثبات الأسلوب |
| GPT Image 2 | انحداري ذاتي (Autoregressive) | عرض النصوص، اتباع التعليمات | الرسوم المستندية |
| Seedream 4.5 | انتشار | تفاصيل 4K، جماليات دقيقة | المخرجات عالية الدقة |
| Recraft 20B | انتشار | الطباعة، الأساليب المتجهية | التصميم والعلامات التجارية |
| Hunyuan Image 2.1 | انتشار | الواقعية الفوتوغرافية | تصوير المنتجات |
يعكس هذا التنوع حقيقة أنه لا يوجد نهج تدريب واحد يهيمن على كل حالات الاستخدام. فالنموذج المدرَّب على عرض نصوص دقيقة داخل الصور (مثل GPT Image 2) اتخذ تنازلات معمارية وفي البيانات تختلف عن نموذج مدرَّب لأقصى واقعية فوتوغرافية (مثل Hunyuan).
الفجوة بين التدريب وما تراه
تفصيل جدير بالملاحظة: النموذج الذي تتفاعل معه نادرًا ما يكون checkpoint خامًا مدرَّبًا مسبقًا. تمر معظم أنظمة تحويل النص إلى صورة المنشورة بمراحل إضافية بعد التدريب الأساسي.
التوجيه بدون مصنّف (CFG) يدرّب النموذج على قبول معامل مقياس التوجيه الذي يضخّم الالتزام بالأمر النصي على حساب بعض التنوع. وكلما ارتفع مقياس التوجيه، التزمت المخرجات بالأمر النصي أكثر، لكنها تستكشف مساحة أقل من المخرجات الممكنة.
التعلم المعزز من التغذية الراجعة البشرية (RLHF) أو مراحل نمذجة المكافآت المشابهة تستخدم تقييمات التفضيل البشري لتوجيه النموذج نحو مخرجات يجدها الناس جذابة فعلًا، لا مجرد مخرجات تشبه بيانات التدريب إحصائيًا.
الضبط الدقيق للسلامة يضيف طبقات تمنع توليد فئات معينة من المحتوى، مرة أخرى عبر التوسيم البشري ونمذجة المكافآت.
تنطوي كل مرحلة من هذه المراحل على حوسبة إضافية، وعمل بشري إضافي، وقرارات إضافية حول ما ينبغي أن ينتجه النموذج وما لا ينبغي. فالفعل البسيط المتمثل في كتابة أمر نصي يرتبط بأشهر من العمل الذي يجري عبر فرق متعددة.
💡 ما الذي يعنيه هذا لأوامرك النصية: لأن مراحل ما بعد التدريب هذه تدفع النماذج نحو الجماليات التي يفضلها البشر، فإن الأوامر التي تصف ما يهتم به مصوّر محترف أو مدير فني (اتجاه الإضاءة، واختيار العدسة، والمزاج، والتكوين) تميل إلى التفوق على الطلبات الإبداعية الغامضة.
البنية التحتية وراء المخرجات
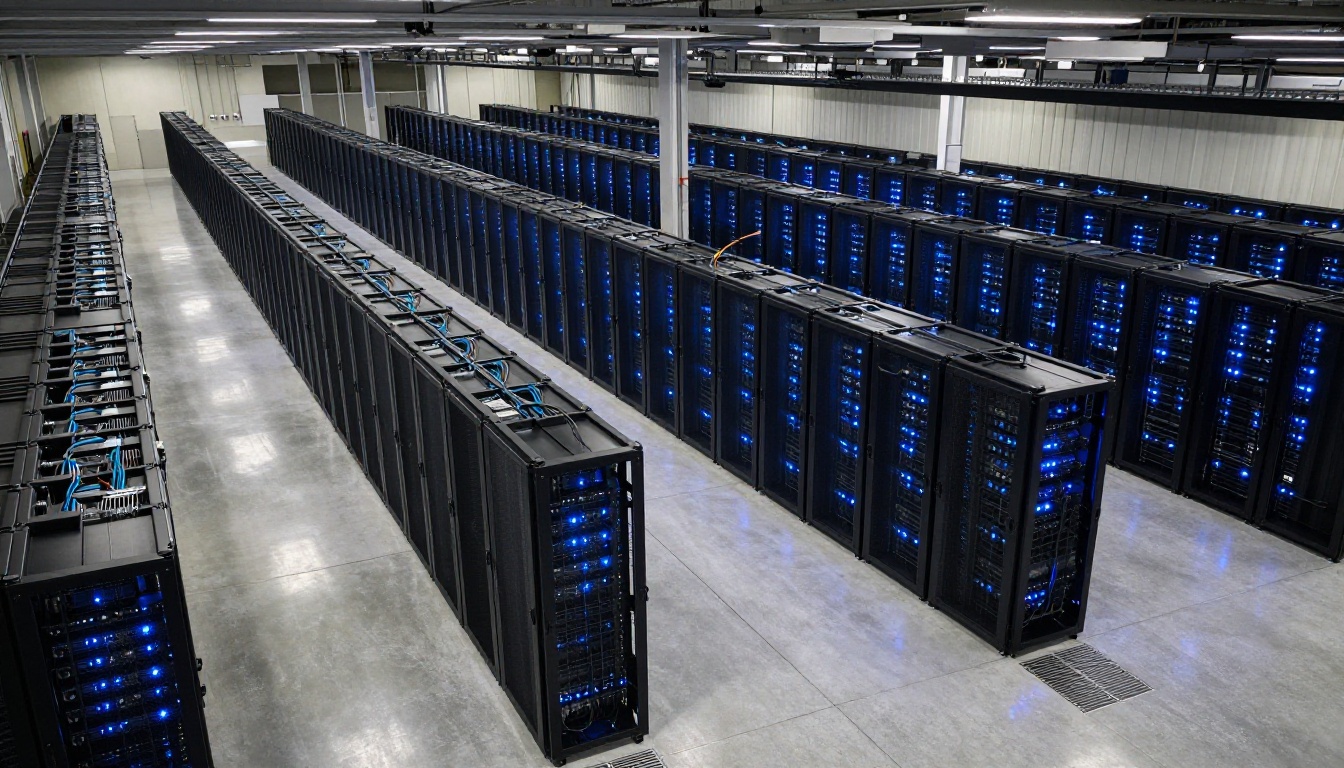
يتطلب التدريب بحجم نماذج تحويل النص إلى صورة الحديثة بنية تحتية مخصصة تعمل بلا انقطاع لأشهر. قد تستهلك جولة تدريب واحدة لنموذج كبير من الكهرباء ما تستهلكه بلدة صغيرة في أسبوع. وتصبح أنظمة التبريد، والاحتياط في مصادر الطاقة، وشبكة الاتصالات، كلها اعتبارات هندسية أساسية لا أمورًا ثانوية.
هذا هو واقع البنية التحتية وراء النماذج التي تصل إليها الآن في ثوانٍ عبر واجهة ويب. فمولّد PicassoIA Image يربطك بنماذج مدرَّبة مسبقًا استغرق إنتاجها أشهرًا من وقت العناقيد، ويُقدَّم على أجهزة محسّنة للتشغيل السريع لا لإنتاجية التدريب.
ما تراه صندوق أوامر نصية نظيفًا وبسيطًا يمثل الطبقة الخارجية لنظام شديد التعقيد: مجموعات بيانات جُمعت بالزحف، وتعليقات نصية مختارة بعناية، وتدريب موزّع على آلاف وحدات GPU، ومراحل مواءمة مع مقيّمين بشريين، وتصفية للمحتوى من حيث السلامة، كل ذلك مضغوط في استدعاء واحد عبر API.
ضع التدريب موضع التطبيق
أنت تعرف الآن السلسلة كاملة: مجموعات بيانات منتقاة، ومشفّرات نصية تباينية، وعمليات انتشار في الفضاء الكامن، وتحسين للخسارة عبر مليارات الأمثلة، وخطوات محاذاة ما بعد التدريب. وكل صورة تولّدها تحمل بصمة هذه القرارات.
أكثر الطرق مباشرة لتطبيق هذه المعرفة هي تجربة مجموعة النماذج المتاحة على PicassoIA Image. يعكس كل نموذج خيارات تدريب مختلفة وأولويات بيانات مختلفة ورهانات معمارية مختلفة. والفرق بين استجابة مفصّلة للغاية واستجابة عامة غالبًا ما يعود إلى كتابة أوامر تتوافق مع ما دُرّب النموذج على الاستجابة له.
إذا أردت التعمق أكثر، يتيح لك P Image Trainer تشغيل ضبط LoRA الدقيق الخاص بك مباشرة في المتصفح، دون الحاجة إلى إعداد وحدة GPU. ارفع 20-100 صورة لموضوع، واكتب التسميات، وخلال ساعات ستحصل على checkpoint مخصص يولّد ذلك الموضوع عند الطلب.
الحاجز بين قراءة كيفية تدريب نماذج تحويل النص إلى صورة وبين تجربتها بنفسك لم يكن أدنى من أي وقت مضى. اختر موضوعًا، واجمع صورك، وابدأ التدريب.


