आप कुछ शब्द टाइप करते हैं, जेनरेट दबाते हैं, और कुछ ही सेकंड में एक फोटोरियलिस्टिक इमेज सामने आ जाती है। बाहर से यह प्रक्रिया बेहद आसान लगती है, लेकिन हर टेक्स्ट-टू-इमेज मॉडल के पीछे महीनों की कम्प्यूटेशन, अरबों ट्रेनिंग उदाहरण और machine learning के फ़ैसलों की एक बेहद सटीक श्रृंखला होती है। यह आर्टिकल परदा हटाकर दिखाता है कि text to image मॉडल कैसे ट्रेन होते हैं, कच्चे मटेरियल से लेकर उस अंतिम सिस्टम तक, जिससे आप बातचीत करते हैं।
सबसे पहले डेटा की समस्या आती है
किसी भी न्यूरल नेटवर्क के एक भी वेट को ट्रेन करने से पहले, डेटा की समस्या हल करनी होती है। Text to image मॉडल को इमेज-कैप्शन जोड़ों के विशाल संग्रह चाहिए, यानी हर फोटो या इलस्ट्रेशन के साथ उसका सटीक लिखित विवरण होना चाहिए कि वह क्या दिखाता है।
यहाँ पैमाना छोटा नहीं है। Stable Diffusion जैसे मॉडल LAION-5B डेटासेट के सबसेट पर ट्रेन किए गए थे, जिसमें सार्वजनिक वेब पेजों से लिए गए लगभग पाँच अरब इमेज-टेक्स्ट जोड़े हैं। हाल के सिस्टम, जिनमें Black Forest Labs की Flux Redux Dev शामिल है, कच्चे आकार की बजाय गुणवत्ता के लिए छाँटे गए क्यूरेटेड डेटासेट इस्तेमाल करते हैं।
इमेज कहाँ से आती हैं
ज़्यादातर ट्रेनिंग इमेज बड़े पैमाने पर वेब स्क्रैपिंग से आती हैं। ऑटोमेटेड क्रॉलर अरबों वेब पेज पर जाते हैं और हर मिली इमेज को आसपास के HTML टेक्स्ट, alt एट्रिब्यूट और कैप्शन के साथ डाउनलोड कर लेते हैं। यह कच्चा संग्रह फिर कई फ़िल्टरिंग चरणों से गुज़रता है।
आम फ़िल्टर ये हटाते हैं:
- न्यूनतम रिज़ॉल्यूशन सीमा से कम इमेज (आमतौर पर 512x512 पिक्सल)
- लगभग डुप्लिकेट इमेज, जो मॉडल को किसी खास कंटेंट की ओर झुका सकती हैं
- बेमेल या खाली कैप्शन वाली इमेज
- सेफ़्टी क्लासिफ़ायर द्वारा फ़्लैग किया गया कंटेंट
जो बचता है, वह फिर भी इंटरनेट का एक अधूरा और भारी पक्षपाती नमूना है, और इसी वजह से डेटासेट क्यूरेशन किसी भी मॉडल लैब का सबसे असरदार फ़ैसला बन गया है।
टेक्स्ट कैप्शन कैसे जोड़े जाते हैं
वेब पर हर इमेज के साथ काम का विवरण नहीं आता। किसी प्रोडक्ट फोटो में alt टैग "img_4782.jpg" हो सकता है, जबकि किसी सोशल पोस्ट में कोई कैप्शन ही नहीं होता। इसे संभालने के लिए मॉडल लैब दो में से एक काम करते हैं:
- मौजूदा कैप्शन इस्तेमाल करना भरोसेमंद स्रोतों से (Wikipedia, स्टॉक फोटो डेटाबेस, न्यूज़ आर्काइव), जहाँ इंसानों के लिखे विवरण पहले से मौजूद होते हैं
- सिंथेटिक कैप्शन जनरेट करना एक vision-language मॉडल की मदद से, जो इमेज के कंटेंट का अपने-आप वर्णन करता है
दूसरा तरीका अब मानक बन चुका है। LLaVA या Flamingo जैसे सिस्टम उन लाखों इमेज के लिए विस्तृत विवरण बनाने में इस्तेमाल होते हैं, जिनके पास काम के टेक्स्ट जोड़े नहीं होते। नतीजा एक ज़्यादा समृद्ध कैप्शन होता है, जो सिर्फ़ सब्जेक्ट नहीं, बल्कि लाइटिंग, कंपोज़िशन और मूड भी बताता है।
डेटासेट की गुणवत्ता सब कुछ क्यों बदल देती है
खराब तरह से मेल खाते कैप्शन पर ट्रेन किया गया मॉडल प्रॉम्प्ट को सटीक रूप से फ़ॉलो करने में संघर्ष करेगा। अगर सूर्यास्त की इमेज का कैप्शन "सुंदर पिक" है, न कि "orange और purple आसमान वाला समुद्री लहरों पर गोल्डन आवर सनसेट", तो मॉडल उस उदाहरण से लगभग कुछ नहीं सीखता कि "सनसेट" कैसा दिखना चाहिए।
इसीलिए Bytedance (जो Seedream 4.5 के पीछे है) और Stability AI (जो Stable Diffusion 3 के पीछे है) जैसी लैब्स सिर्फ़ कम्प्यूट पर नहीं, बल्कि डेटासेट पाइपलाइन पर भारी निवेश करती हैं। अक्सर बेहतर डेटा, ज़्यादा कम्प्यूट से बेहतर साबित होता है।
💡 डेटा फ़्लाईव्हील: बड़े यूज़र बेस वाली कंपनियाँ असली प्रॉम्प्ट और यूज़र रेटिंग का इस्तेमाल करके डेटासेट की गुणवत्ता लगातार सुधार सकती हैं, जिससे स्थापित प्लेटफ़ॉर्म को नए खिलाड़ियों पर बढ़ती बढ़त मिलती है।
वह आर्किटेक्चर जो सीखने का काम करता है
एक साफ़ डेटासेट तैयार होने के बाद, मॉडल का आर्किटेक्चर तय करता है कि सिस्टम उसे कैसे प्रोसेस करेगा। आज के ज़्यादातर text to image मॉडलों को दो प्रमुख तरीके शक्ति देते हैं: डिफ्यूज़न मॉडल और ऑटोरिग्रेसिव मॉडल। डिफ्यूज़न मॉडल सबसे आम विकल्प हैं।
डिफ्यूज़न मॉडल सरल भाषा में
डिफ्यूज़न मॉडल एक विनाश प्रक्रिया को उल्टा चलाकर इमेज बनाता है। ट्रेनिंग के दौरान सिस्टम असली इमेज लेता है और सैकड़ों चरणों में धीरे-धीरे Gaussian नॉइज़ जोड़ता है, जब तक इमेज शुद्ध रैंडम स्टैटिक से अलग न दिखे। फिर मॉडल उस नॉइज़ को एक-एक चरण में पहचानना और हटाना सीखता है, अराजकता से शुरू करके एक सुसंगत इमेज की ओर पीछे की ओर बढ़ते हुए।
इनफ़रेंस के समय, मॉडल शुद्ध नॉइज़ से शुरू करता है और उसे बार-बार डिनॉइज़ करता है, टेक्स्ट प्रॉम्प्ट के मार्गदर्शन में, जब तक कोई पहचानने लायक इमेज उभर न आए। टेक्स्ट कंडीशनिंग ही डिनॉइज़िंग को किसी खास दिशा में मोड़ती है।
यह प्रक्रिया पिक्सल स्पेस की बजाय लैटेंट स्पेस में चलती है। Variational Autoencoder (VAE) नाम का एक अलग नेटवर्क डिफ्यूज़न शुरू होने से पहले पूरे रिज़ॉल्यूशन की इमेज को एक छोटे, कम-आयामी रूप में संकुचित कर देता है। इससे ट्रेनिंग और इनफ़रेंस की कम्प्यूट लागत काफ़ी घट जाती है।
ट्रेनिंग में CLIP की भूमिका
किसी मॉडल को टेक्स्ट से इमेज बनाने के लिए एक साझा रिप्रेज़ेंटेशन स्पेस चाहिए, जहाँ टेक्स्ट और इमेज की सार्थक तुलना हो सके। OpenAI का CLIP (Contrastive Language-Image Pretraining) वह सफ़लता थी जिसने यह संभव बनाया।
CLIP को 400 मिलियन इमेज-टेक्स्ट जोड़ियों पर प्रशिक्षित किया गया था, ताकि ऐसे एम्बेडिंग बनें जिनमें मेल खाने वाली इमेज और कैप्शन वेक्टर स्पेस में पास-पास हों, जबकि बेमेल जोड़ियाँ एक-दूसरे से दूर धकेली जाएँ। इस कॉन्ट्रास्टिव लर्निंग तरीके का मतलब है कि वाक्यांश "a red sports car on a mountain road" एक ऐसा एम्बेडिंग बनाता है जो ज्यामितीय रूप से पहाड़ी सड़कों पर लाल स्पोर्ट्स कारों की असली इमेज के बहुत करीब होता है।
ज़्यादातर डिफ्यूज़न मॉडल इनपुट टेक्स्ट प्रॉम्प्ट को कंडीशनिंग वेक्टर में बदलने के लिए CLIP या उसके उत्तराधिकारी का इस्तेमाल करते हैं (जैसे Stable Diffusion 3 में इस्तेमाल होने वाला T5 टेक्स्ट एनकोडर)। ये वेक्टर cross-attention लेयर के ज़रिए डिनॉइज़िंग नेटवर्क में डाले जाते हैं, और हर डिनॉइज़िंग चरण पर बताते हैं कि मॉडल किन विज़ुअल कॉन्सेप्ट पर ज़ोर दे।
लैटेंट स्पेस: यह क्यों मायने रखता है
लैटेंट स्पेस की अवधारणा आधुनिक इमेज जनरेटर के कामकाज के केंद्र में है, और यही समझाती है कि प्रॉम्प्ट इंजीनियरिंग इतनी अहम क्यों है। लैटेंट स्पेस का हर बिंदु एक संभावित इमेज से मेल खाता है। मिलते-जुलते विज़ुअल गुणों वाली इमेज एक-दूसरे के पास गुच्छों में होती हैं। जब आप प्रॉम्प्ट टाइप करते हैं, तो टेक्स्ट एनकोडर आपके शब्दों को इस स्पेस के एक क्षेत्र पर मैप करता है, और डिनॉइज़र उस क्षेत्र के भीतर एक विश्वसनीय इमेज ढूँढता है।
इसीलिए प्रॉम्प्ट में छोटे बदलाव भी बेहद अलग नतीजे दे सकते हैं। लैटेंट स्पेस में थोड़ी-सी भी हरकत किसी दूसरे विज़ुअल गुच्छे में पहुँचा सकती है। Recraft 20B और GPT Image 2 जैसे मॉडल खास तौर पर इस तरह ट्यून किए गए हैं कि उनका लैटेंट स्पेस सटीक प्रॉम्प्ट निर्देशों का बेहतर पालन करे।
असल में ट्रेनिंग कैसी दिखती है
आर्किटेक्चर समझना एक बात है। यह देखना कि ट्रेनिंग में असल में क्या शामिल है, दूसरी बात है। यह एक लंबा, कम्प्यूटेशनल रूप से महँगा ऑप्टिमाइज़ेशन लूप है, जो हफ़्तों या महीनों तक लगातार चलता है।
लॉस फ़ंक्शन और ग्रेडिएंट
ट्रेनिंग के दौरान मॉडल इमेज-टेक्स्ट जोड़ों का एक बैच प्रोसेस करता है। हर जोड़ी के लिए, वह इमेज में नॉइज़ जोड़ता है और फिर अनुमान लगाता है कि असल में कौन-सा नॉइज़ जोड़ा गया था। अनुमानित नॉइज़ और असली नॉइज़ के बीच का अंतर लॉस है, जिसे खास तौर पर denoising score matching loss कहा जाता है।
इसके बाद ऑप्टिमाइज़र (आमतौर पर Adam या AdamW) इस लॉस के ग्रेडिएंट को मॉडल के हर पैरामीटर के सापेक्ष निकालता है, और उन पैरामीटर को उस दिशा में थोड़ा धकेलता है जो एरर घटाए। यह अरबों इमेज-टेक्स्ट जोड़ों पर दिनों या हफ़्तों तक दोहराया जाता है।
जैसे-जैसे ट्रेनिंग आगे बढ़ती है, लॉस कर्व नीचे गिरता है। शुरुआत में मॉडल धुंधली आकृतियों वाला असंगत नॉइज़ बनाता है। लाखों चरणों के बाद साफ़ संरचनाएँ उभरती हैं। दसियों मिलियन चरणों के बाद फोटोरियलिस्टिक नतीजे और सटीक प्रॉम्प्ट पालन संभव हो जाता है।
ट्रेनिंग में असल में कितना समय लगता है
यहाँ के आँकड़े चौंकाने वाले हैं:
| मॉडल का पैमाना | अनुमानित ट्रेनिंग समय | ज़रूरी GPU |
|---|
| छोटा (300M पैरामीटर) | 2-5 दिन | 8-32 A100 |
| मध्यम (1B पैरामीटर) | 1-3 सप्ताह | 64-256 A100 |
| बड़ा (3B+ पैरामीटर) | 4-12 सप्ताह | 512-2048 H100 |
| बहुत बड़ा (10B+) | 3-6 महीने | 4000+ H100 |
Wan 2.7 Image Pro और Hunyuan Image 2.1 जैसे मॉडल बड़े से बहुत बड़े वर्ग में आते हैं, और इनके लिए ऐसे क्लस्टर चाहिए जो ज़्यादातर संगठन कभी अपने पास नहीं रख पाएँगे।
हार्डवेयर की असलियत
GPU मॉडल ट्रेनिंग के सबसे अहम औज़ार हैं, लेकिन उनके आसपास का इंफ़्रास्ट्रक्चर भी उतना ही मायने रखता है। सैकड़ों GPU पर एक साथ ग्रेडिएंट सिंक करने के लिए तेज़ इंटरकनेक्ट (NVLink, InfiniBand) ज़रूरी हैं। स्टोरेज सिस्टम को ट्रेनिंग डेटा इतनी तेज़ी से देना होता है कि GPU बिना रुकावट के चलते रहें। बड़े पैमाने पर बिजली और कूलिंग भी वास्तविक इंजीनियरिंग चुनौतियाँ बन जाती हैं।
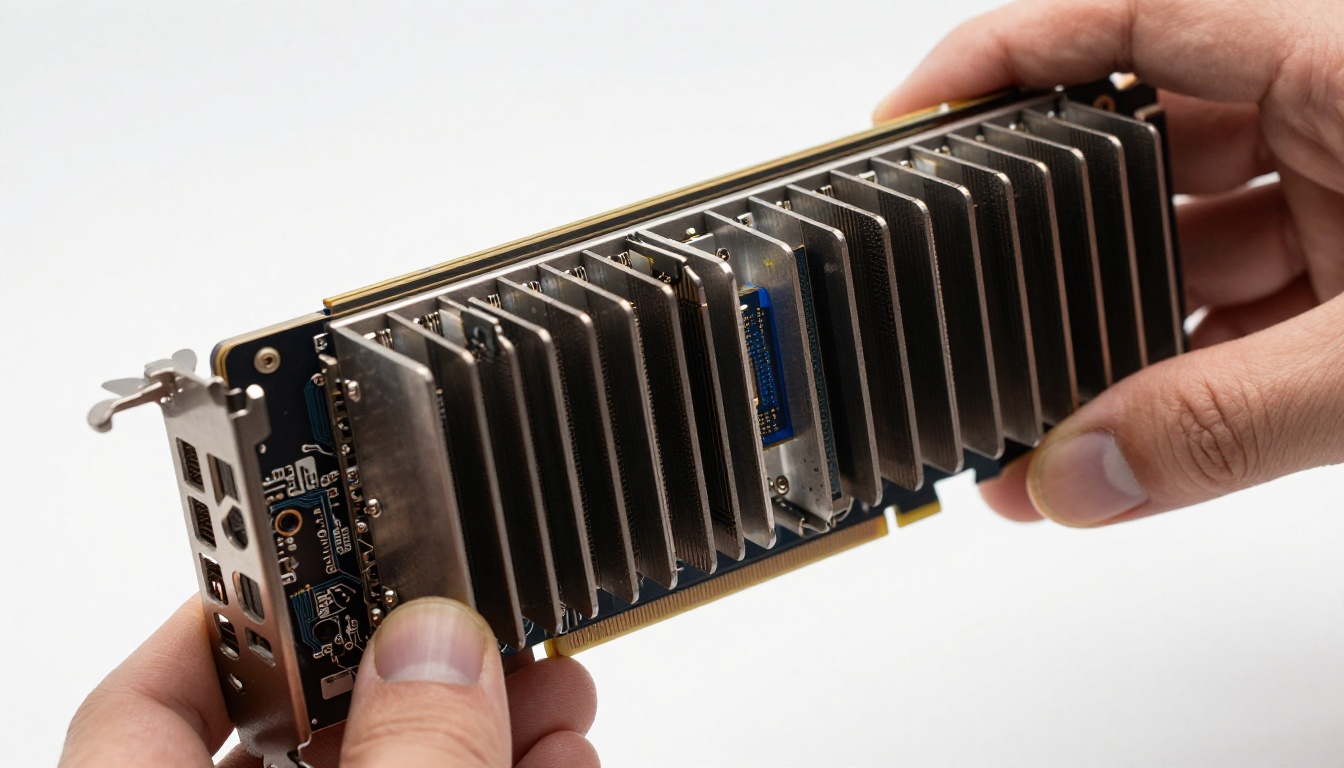
एक अत्याधुनिक text to image मॉडल को शून्य से ट्रेन करने की लागत अब लाखों डॉलर तक पहुँचती है। इसीलिए बहुत कम संगठन बेस मॉडल शून्य से ट्रेन करते हैं, जबकि कहीं ज़्यादा संगठन मौजूदा मॉडलों की फाइन-ट्यूनिंग पर ध्यान देते हैं।
प्री-ट्रेनिंग के बाद फाइन-ट्यूनिंग
अरबों उदाहरणों पर प्री-ट्रेनिंग मॉडल को व्यापक सामान्य क्षमताएँ देती है। फाइन-ट्यूनिंग उसे फिर खास स्टाइल, सब्जेक्ट या व्यवहार के लिए विशेष बनाती है, बिना पूरी ट्रेनिंग प्रक्रिया दोहराए।
LoRA: पूरी रीट्रेनिंग के बिना कस्टम स्टाइल
LoRA (Low-Rank Adaptation) text to image क्षेत्र का सबसे लोकप्रिय फाइन-ट्यूनिंग तरीका बन गया है। मॉडल के अरबों पैरामीटर अपडेट करने की बजाय, LoRA मौजूदा वेट मैट्रिक्स के साथ छोटे low-rank मैट्रिक्स जोड़ता है। सिर्फ़ ये जोड़े गए हिस्से कस्टम डेटासेट पर ट्रेन होते हैं।
व्यावहारिक नतीजा: किसी खास फोटोग्राफी स्टाइल, कैरेक्टर या प्रोडक्ट के लिए LoRA ट्रेनिंग रन में सिर्फ़ 20-100 इमेज, एक कंज़्यूमर-ग्रेड GPU और कुछ घंटे लग सकते हैं, न कि पूरे बेस मॉडल के लिए ज़रूरी महीनों और लाखों की लागत।
PicassoIA पर P Image Trainer यही सुविधा देता है। यह किसी को भी अपनी इमेज पर कस्टम LoRA ट्रेन करने देता है, और फिर उस ट्रेन्ड एडॉप्टर से उसी स्टाइल में या उसी सब्जेक्ट वाली नई इमेज जेनरेट करने देता है।
फाइन-ट्यूनिंग को क्या चाहिए
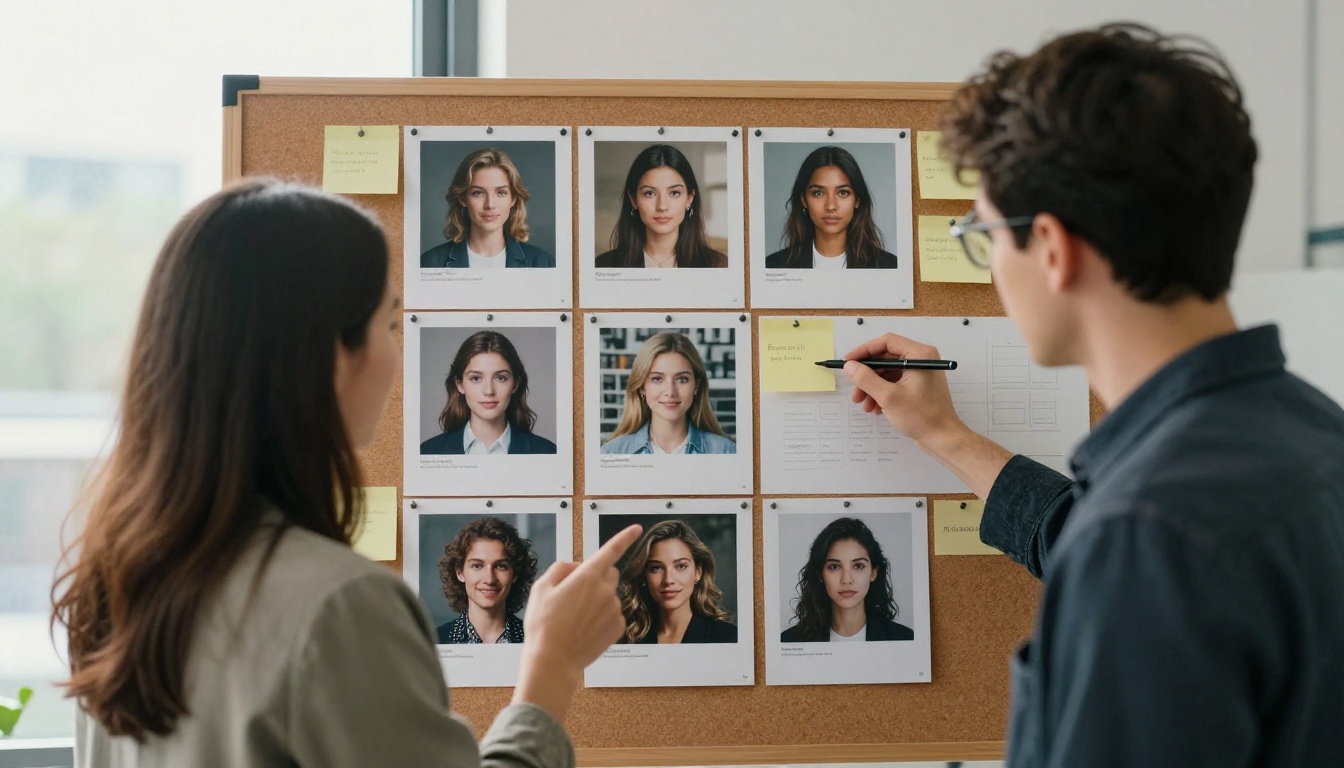
एक सफल LoRA फाइन-ट्यूनिंग सत्र को चाहिए:
- डेटासेट का आकार: लक्ष्य सब्जेक्ट या स्टाइल की 15-200 उच्च-गुणवत्ता वाली इमेज
- कैप्शन की गुणवत्ता: हर इमेज को एक सटीक, विस्तृत विवरण चाहिए
- बेस मॉडल का चुनाव: बेस मॉडल की मौजूदा क्षमताएँ तय करती हैं कि फाइन-ट्यूनिंग क्या जोड़ सकती है
- हाइपरपैरामीटर: लर्निंग रेट, ट्रेनिंग स्टेप और rank साइज़ सभी आउटपुट की गुणवत्ता पर असर डालते हैं
💡 ओवरफ़िटिंग का जाल: कम इमेज पर बहुत लंबी ट्रेनिंग मॉडल को सामान्यीकरण की बजाय याद करने पर मजबूर कर देती है। अगर हर जेनरेट की गई इमेज आपकी ट्रेनिंग फोटो जैसी दिखती है, तो आपका लर्निंग रेट बहुत ज़्यादा था या आपने बहुत अधिक स्टेप चलाए।
फाइन-ट्यून कब करें और प्रॉम्प्ट कब करें
हर उपयोग के लिए फाइन-ट्यून किया गया मॉडल ज़रूरी नहीं है। Flux Schnell LoRA जैसे text to image मॉडल पहले से ही विविध सब्जेक्ट के लिए विस्तृत प्राकृतिक भाषा प्रॉम्प्ट को फ़ॉलो करने में बेहद सक्षम हैं। फाइन-ट्यूनिंग असल में तब ज़रूरी हो जाती है जब:
- आपको किसी खास चेहरे या कैरेक्टर का लगातार एक जैसा चित्रण चाहिए
- आपको एक मालिकाना विज़ुअल स्टाइल चाहिए जिसे अकेले प्रॉम्प्टिंग से दोहराया न जा सके
- आप प्रोडक्ट इमेज बना रहे हैं, जिनमें ब्रांड के सटीक रंग और विवरण दिखने ज़रूरी हैं
- आपको किसी विशेष डोमेन का कंटेंट चाहिए, जिसका ऑनलाइन प्रतिनिधित्व सीमित है
आज के मॉडल कैसे तुलना करते हैं
2025 का text to image परिदृश्य कई अलग आर्किटेक्चर दर्शनों में बँट गया है:
| मॉडल | आर्किटेक्चर | ताकत | सबसे उपयुक्त |
|---|
| Stable Diffusion 3 | Diffusion Transformer | ओपन वेट्स, कस्टमाइज़ेबल | फाइन-ट्यूनिंग, रिसर्च |
| Flux Redux Dev | Flow Matching | इमेज वेरिएशन की गुणवत्ता | स्टाइल की स्थिरता |
| GPT Image 2 | Autoregressive | टेक्स्ट रेंडरिंग, निर्देश पालन | डॉक्युमेंट ग्राफ़िक्स |
| Seedream 4.5 | Diffusion | 4K डिटेल, बारीक सौंदर्य | हाई-रिज़ॉल्यूशन आउटपुट |
| Recraft 20B | Diffusion | टाइपोग्राफ़ी, वेक्टर स्टाइल | डिज़ाइन और ब्रांडिंग |
| Hunyuan Image 2.1 | Diffusion | फोटोरियलिज़्म | प्रोडक्ट फोटोग्राफ़ी |
यह विविधता इस बात को दिखाती है कि कोई एक ट्रेनिंग तरीका सभी उपयोगों पर हावी नहीं है। इमेज में सटीक टेक्स्ट रेंडर करने के लिए ट्रेन किए गए मॉडल (जैसे GPT Image 2) ने आर्किटेक्चर और डेटासेट से जुड़े अलग ट्रेड-ऑफ़ चुने हैं, जो अधिकतम फोटोरियलिज़्म के लिए ट्रेन किए गए मॉडल (जैसे Hunyuan) से अलग हैं।
ट्रेनिंग और आपके देखे नतीजे के बीच का अंतर
एक बात ध्यान देने लायक है: जिस मॉडल से आप बातचीत करते हैं, वह शायद ही कच्चा प्री-ट्रेन्ड चेकपॉइंट होता है। ज़्यादातर तैनात text to image सिस्टम बेस प्री-ट्रेनिंग के बाद अतिरिक्त चरणों से गुज़रते हैं।
Classifier-free guidance (CFG) मॉडल को एक गाइडेंस स्केल पैरामीटर स्वीकार करना सिखाता है, जो कुछ विविधता की कीमत पर प्रॉम्प्ट पालन बढ़ाता है। ज़्यादा गाइडेंस स्केल का मतलब है कि आउटपुट प्रॉम्प्ट के ज़्यादा करीब रहते हैं, लेकिन संभावित आउटपुट स्पेस का कम हिस्सा खोजते हैं।
Reinforcement Learning from Human Feedback (RLHF) या इसी तरह के reward modeling चरण इंसानी पसंद की रेटिंग का इस्तेमाल करके मॉडल को ऐसे आउटपुट की ओर मोड़ते हैं, जो लोगों को सचमुच पसंद आएँ, न कि सिर्फ़ वे जो आँकड़ों में ट्रेनिंग डेटा जैसे दिखें।
Safety फाइन-ट्यूनिंग ऐसी परतें जोड़ती है जो कुछ कंटेंट श्रेणियों को जेनरेट होने से रोकती हैं, फिर से इंसानी लेबलिंग और reward modeling के ज़रिए।
इन चरणों में से हर एक में अतिरिक्त कम्प्यूट, अतिरिक्त इंसानी मेहनत और इस बारे में अतिरिक्त फ़ैसले शामिल हैं कि मॉडल क्या बनाए और क्या न बनाए। प्रॉम्प्ट टाइप करने का "सरल" काम कई टीमों में चल रहे महीनों के काम से जुड़ा है।
💡 आपके प्रॉम्प्ट के लिए इसका मतलब: क्योंकि ये पोस्ट-ट्रेनिंग चरण मॉडल को इंसानी पसंद की सौंदर्य दृष्टि की ओर धकेलते हैं, ऐसे प्रॉम्प्ट जो बताते हैं कि एक पेशेवर फोटोग्राफर या आर्ट डायरेक्टर किन बातों की परवाह करेगा (लाइटिंग की दिशा, लेंस का चुनाव, मूड, कंपोज़िशन), आम तौर पर अस्पष्ट रचनात्मक अनुरोधों से बेहतर नतीजे देते हैं।
आउटपुट के पीछे का इंफ़्रास्ट्रक्चर
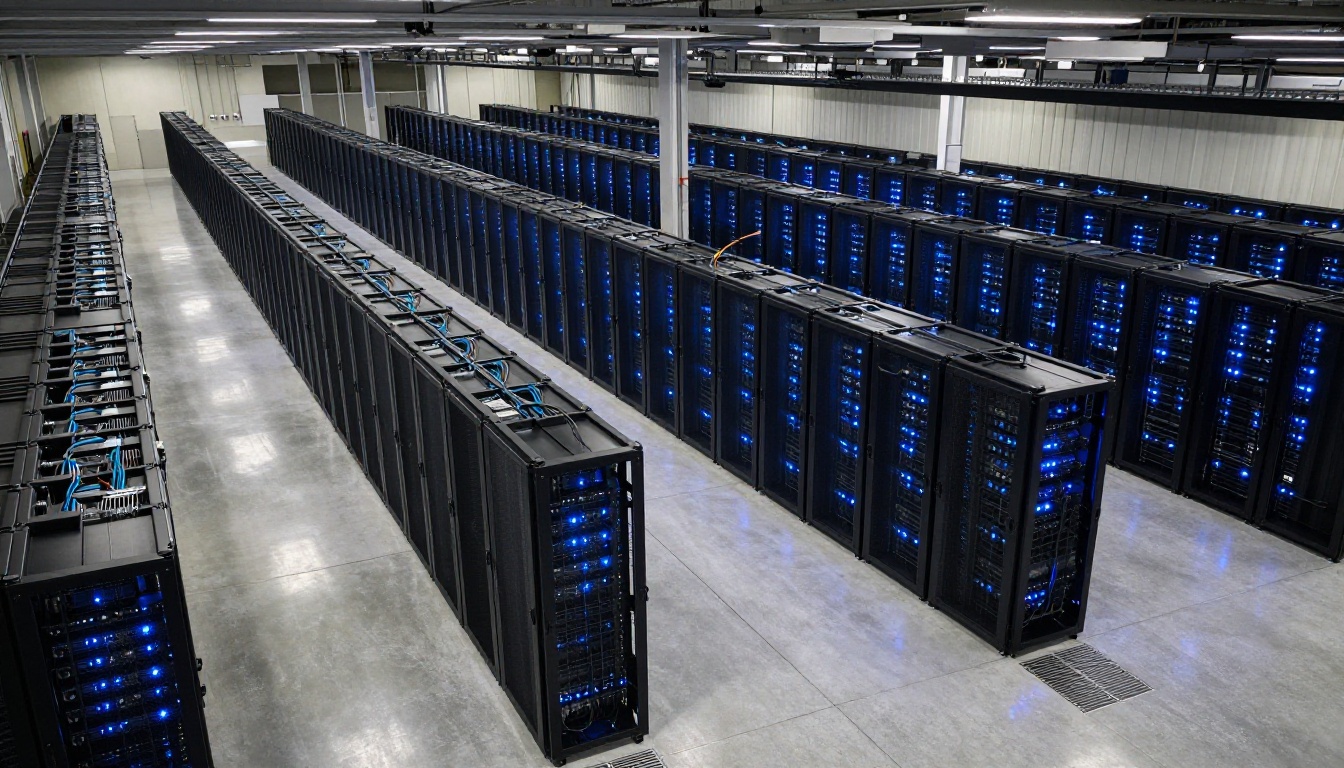
आधुनिक text to image मॉडल के पैमाने पर ट्रेनिंग के लिए समर्पित इंफ़्रास्ट्रक्चर चाहिए, जो महीनों तक लगातार चलता है। एक बड़े मॉडल का एक ट्रेनिंग रन उतनी बिजली खा सकता है जितनी एक छोटा कस्बा एक हफ़्ते में इस्तेमाल करता है। कूलिंग सिस्टम, पावर रिडंडेंसी और नेटवर्क फ़ैब्रिक, ये सब बाद में सोचने की बातें नहीं, बल्कि पहली श्रेणी की इंजीनियरिंग चिंताएँ बन जाते हैं।
यही वह इंफ़्रास्ट्रक्चर की असलियत है, जिसके पीछे वे मॉडल हैं जिन्हें आप अब एक वेब इंटरफ़ेस के ज़रिए सेकंडों में इस्तेमाल करते हैं। PicassoIA Image जेनरेटर आपको ऐसे प्री-ट्रेन्ड मॉडलों से जोड़ता है, जिन्हें बनाने में महीनों का क्लस्टर समय लगा, और जो ट्रेनिंग थ्रूपुट की बजाय फ़ास्ट इनफ़रेंस के लिए ऑप्टिमाइज़ हार्डवेयर पर चलते हैं।
आप जिस साफ़-सुथरे, सरल प्रॉम्प्ट बॉक्स को देखते हैं, वह एक असाधारण जटिल सिस्टम की सबसे बाहरी परत है: क्रॉल किए गए डेटासेट, क्यूरेट किए गए कैप्शन, हज़ारों GPU पर वितरित ट्रेनिंग, इंसानी रेटर्स के साथ अलाइनमेंट चरण और सेफ़्टी फ़िल्टरिंग, ये सब एक ही API कॉल में समाहित हैं।
ट्रेनिंग को काम में लगाएँ
अब आप पूरी श्रृंखला जानते हैं: क्यूरेट किए गए डेटासेट, कॉन्ट्रास्टिव टेक्स्ट एनकोडर, लैटेंट स्पेस में डिफ्यूज़न प्रोसेस, अरबों उदाहरणों पर लॉस ऑप्टिमाइज़ेशन और पोस्ट-ट्रेनिंग अलाइनमेंट चरण। आपकी जेनरेट की हर इमेज पर इन फ़ैसलों की छाप होती है।
इस ज्ञान को लागू करने का सबसे सीधा तरीका PicassoIA Image पर उपलब्ध मॉडलों की विविधता के साथ प्रयोग करना है। हर मॉडल अलग ट्रेनिंग विकल्पों, अलग डेटासेट प्राथमिकताओं और अलग आर्किटेक्चरल दांव को दर्शाता है। एक अत्यंत विस्तृत प्रॉम्प्ट के उत्तर और एक सामान्य उत्तर के बीच का अंतर अक्सर इस पर निर्भर करता है कि आप ऐसे प्रॉम्प्ट लिखें जो उस चीज़ से मेल खाएँ, जिस पर मॉडल को प्रतिक्रिया देने के लिए ट्रेन किया गया था।
अगर आप और गहराई में जाना चाहते हैं, तो P Image Trainer आपको सीधे ब्राउज़र में अपना LoRA फाइन-ट्यूनिंग चलाने देता है, किसी GPU सेटअप की ज़रूरत नहीं। किसी सब्जेक्ट की 20-100 इमेज अपलोड करें, कैप्शन लिखें, और कुछ घंटों में आपके पास एक कस्टम मॉडल चेकपॉइंट होगा, जो उस सब्जेक्ट को माँगने पर जेनरेट करेगा।
text to image मॉडल कैसे ट्रेन होते हैं, यह पढ़ने और खुद करने के बीच की दूरी पहले कभी इतनी कम नहीं थी। एक सब्जेक्ट चुनें, अपनी इमेज इकट्ठा करें, और ट्रेनिंग शुरू करें।


