Você digita algumas palavras, clica em gerar e, em poucos segundos, uma imagem fotorrealista aparece. Por fora, o processo parece simples, mas por trás de cada modelo de texto para imagem há meses de computação, bilhões de exemplos de treinamento e uma cadeia de decisões de aprendizado de máquina extremamente precisa. Este artigo revela os bastidores de como os modelos de texto para imagem são treinados, desde os ingredientes brutos até o sistema final que você usa.
O problema dos dados vem primeiro
Antes que qualquer rede neural treine um único peso, alguém precisa resolver o problema dos dados. Os modelos de texto para imagem exigem coleções enormes de pares imagem-legenda, o que significa que cada fotografia ou ilustração precisa vir acompanhada de uma descrição escrita precisa do que mostra.
A escala aqui não é modesta. Modelos como o Stable Diffusion foram treinados com subconjuntos do dataset LAION-5B, que contém cerca de cinco bilhões de pares imagem-texto extraídos de páginas da web disponíveis publicamente. Sistemas mais recentes, incluindo o Flux Redux Dev da Black Forest Labs, usam datasets curados e refinados em qualidade, e não em volume bruto.
De onde vêm as imagens
A maior parte das imagens de treinamento vem de raspagem da web em grande escala. Rastreadores automatizados visitam bilhões de páginas e baixam cada imagem que encontram, junto com o texto HTML ao redor, os atributos alt e as legendas. Esse conjunto bruto então passa por várias etapas de filtragem.
Os filtros comuns removem:
- Imagens abaixo de um limite mínimo de resolução (geralmente 512x512 pixels)
- Imagens quase duplicadas, que enviesariam o modelo para conteúdos específicos
- Imagens com legendas incompatíveis ou vazias
- Conteúdo sinalizado por classificadores de segurança
O que sobra ainda é uma amostra imperfeita e muito enviesada da internet, e é por isso que a curadoria de dados se tornou uma das decisões mais importantes que qualquer laboratório de modelos toma.
Como as legendas são pareadas com as imagens
Nem toda imagem da web vem com uma descrição útil. Uma foto de produto pode ter uma tag alt como "img_4782.jpg", enquanto uma publicação em rede social não tem legenda alguma. Para lidar com isso, os laboratórios de modelos fazem uma de duas coisas:
- Usar legendas existentes de fontes confiáveis (Wikipédia, bancos de fotos de estoque, arquivos de notícias) nas quais já há descrições escritas por humanos
- Gerar legendas sintéticas com um modelo de visão e linguagem que descreve automaticamente o conteúdo da imagem
A segunda abordagem se tornou padrão. Sistemas como LLaVA ou Flamingo são usados para gerar descrições detalhadas de milhões de imagens que, de outra forma, não teriam pares de texto utilizáveis. O resultado é uma legenda mais rica, que descreve não só o assunto, mas também a iluminação, a composição e o clima.
Por que a qualidade do dataset muda tudo
Um modelo treinado com legendas mal associadas vai ter dificuldade para seguir prompts com precisão. Se uma imagem de um pôr do sol tiver a legenda "foto bonita" em vez de "pôr do sol na hora dourada sobre ondas do oceano com céu laranja e roxo", o modelo quase não aprende nada, a partir desse exemplo, sobre como um "pôr do sol" deveria ser.
É por isso que empresas como a Bytedance (por trás do Seedream 4.5) e a Stability AI (por trás do Stable Diffusion 3) investem pesado em pipelines de dados, e não apenas em computação. Dados melhores muitas vezes superam mais computação.
💡 O volante de dados: Empresas com grandes bases de usuários podem usar prompts reais e avaliações dos usuários para melhorar continuamente a qualidade dos datasets, o que dá às plataformas estabelecidas uma vantagem crescente sobre os recém-chegados.
A arquitetura que faz o aprendizado
Depois que existe um dataset limpo, a arquitetura do modelo determina como o sistema o processa. Duas abordagens dominantes sustentam a maioria dos modelos modernos de texto para imagem: os modelos de difusão e os modelos autorregressivos. Os modelos de difusão são, de longe, a escolha mais comum.
Modelos de difusão explicados de forma simples
Um modelo de difusão gera imagens revertendo um processo de destruição. Durante o treinamento, o sistema pega imagens reais e adiciona gradualmente ruído gaussiano ao longo de centenas de etapas, até que a imagem fique indistinguível de estática aleatória pura. Em seguida, o modelo aprende a prever e remover esse ruído, uma etapa por vez, voltando do caos até uma imagem coerente.
Na inferência, o modelo começa com ruído puro e o remove iterativamente, guiado por um prompt de texto, até que uma imagem reconhecível apareça. O condicionamento pelo texto é o que direciona a remoção do ruído em uma direção específica.
Esse processo acontece no que se chama de espaço latente, e não no espaço de pixels. Uma rede separada, chamada Autoencoder Variacional (VAE), comprime imagens em resolução total em uma representação compacta de menor dimensão antes de o processo de difusão começar. Isso reduz drasticamente o custo computacional do treinamento e da inferência.
O papel do CLIP no treinamento
Para que um modelo gere imagens a partir de texto, ele precisa de um espaço de representação compartilhado no qual texto e imagens possam ser comparados de forma significativa. O CLIP (Contrastive Language-Image Pretraining), da OpenAI, trouxe o avanço que tornou isso possível.
O CLIP foi treinado com 400 milhões de pares imagem-texto para produzir embeddings nos quais imagens e legendas correspondentes ficam próximas no espaço vetorial, enquanto pares não correspondentes são afastados. Essa abordagem de aprendizado contrastivo significa que a frase "um carro esportivo vermelho em uma estrada de montanha" produz um embedding geometricamente próximo de imagens reais de carros esportivos vermelhos em estradas de montanha.
A maioria dos modelos de difusão usa o CLIP ou um sucessor (como o codificador de texto T5 usado no Stable Diffusion 3) para converter prompts de texto em vetores de condicionamento. Esses vetores são então injetados na rede de remoção de ruído por meio de camadas de cross-attention, indicando ao modelo quais conceitos visuais enfatizar em cada etapa.
Espaço latente: por que ele importa
O conceito de espaço latente é central para o funcionamento dos geradores de imagem modernos e explica por que a engenharia de prompts importa tanto. Cada ponto no espaço latente corresponde a uma imagem possível. Imagens com características visuais semelhantes se agrupam perto umas das outras. Quando você digita um prompt, o codificador de texto mapeia suas palavras para uma região desse espaço, e o removedor de ruído encontra uma imagem plausível dentro dessa região.
É por isso que pequenas mudanças no prompt podem produzir resultados muito diferentes. Mesmo um pequeno deslocamento no espaço latente pode levar a um grupo visual diferente. Modelos como o Recraft 20B e o GPT Image 2 foram ajustados especificamente para que seus espaços latentes respeitem melhor instruções precisas do prompt.
Como o treinamento realmente é
Entender a arquitetura é uma coisa. Ver o que o treinamento realmente envolve é outra. Trata-se de um ciclo de otimização longo e caro computacionalmente, que roda continuamente por semanas ou meses.
Funções de perda e gradientes
Durante o treinamento, o modelo processa um lote de pares imagem-texto. Para cada par, ele adiciona ruído à imagem e depois tenta prever o que foi adicionado. A diferença entre o ruído previsto e o ruído real é a perda, especificamente chamada de perda de correspondência de escore de remoção de ruído.
O otimizador (normalmente Adam ou AdamW) então calcula os gradientes dessa perda em relação a cada parâmetro do modelo e ajusta esses parâmetros na direção que reduz o erro. Isso se repete por bilhões de pares imagem-texto ao longo de dias ou semanas.
Conforme o treinamento avança, a curva de perda cai. No início, o modelo gera ruído incoerente com formas vagas. Depois de milhões de passos, surgem estruturas claras. Depois de dezenas de milhões de passos, resultados fotorrealistas com boa aderência ao prompt se tornam possíveis.
Quanto tempo o treinamento realmente leva
Os números aqui são impressionantes:
| Escala do modelo | Tempo aproximado de treinamento | GPUs necessárias |
|---|
| Pequeno (300M parâmetros) | 2-5 dias | 8-32 A100s |
| Médio (1B parâmetros) | 1-3 semanas | 64-256 A100s |
| Grande (3B+ parâmetros) | 4-12 semanas | 512-2048 H100s |
| Muito grande (10B+) | 3-6 meses | 4000+ H100s |
Modelos como o Wan 2.7 Image Pro e o Hunyuan Image 2.1 ficam nas categorias grande e muito grande, exigindo clusters que a maioria das organizações nunca vai ter por conta própria.
A realidade do hardware
As GPUs são o cavalo de batalha do treinamento de modelos, mas a infraestrutura ao redor delas importa tanto quanto. Interconexões rápidas (NVLink, InfiniBand) são necessárias para sincronizar gradientes entre centenas de GPUs ao mesmo tempo. Os sistemas de armazenamento precisam entregar dados de treinamento rápido o suficiente para manter as GPUs alimentadas, sem gargalos. Energia e resfriamento em grande escala se tornam desafios de engenharia reais.
O custo de treinar do zero um modelo de texto para imagem de ponta agora chega a milhões de dólares. É por isso que muito poucas organizações treinam modelos base do zero, enquanto muitas outras se concentram em fazer fine-tuning dos existentes.
Fine-tuning depois do pré-treinamento
Pré-treinar um modelo com bilhões de exemplos lhe dá capacidades gerais amplas. O fine-tuning então o especializa para estilos, assuntos ou comportamentos específicos, sem repetir todo o processo de treinamento.
LoRA: estilos personalizados sem retreinamento completo
O LoRA (Low-Rank Adaptation) se tornou o método de fine-tuning mais popular no universo do texto para imagem. Em vez de atualizar todos os bilhões de parâmetros de um modelo, o LoRA adiciona pequenas matrizes de baixo rank ao lado das matrizes de pesos existentes. Apenas essas adições são treinadas no dataset personalizado.
O resultado prático: um treinamento LoRA de um estilo fotográfico, um personagem ou um produto específico pode exigir apenas de 20 a 100 imagens, uma GPU de consumo e algumas horas de treinamento, em vez dos meses e milhões necessários para um modelo base completo.
É exatamente isso que o P Image Trainer do PicassoIA oferece. Ele permite que qualquer pessoa treine um LoRA personalizado com as próprias imagens e depois use esse adaptador treinado para gerar novas imagens no mesmo estilo ou com o mesmo assunto.
O que o fine-tuning exige
Uma sessão de fine-tuning LoRA bem-sucedida precisa de:
- Tamanho do dataset: 15 a 200 imagens de alta qualidade do assunto ou estilo-alvo
- Qualidade das legendas: cada imagem precisa de uma descrição precisa e detalhada
- Escolha do modelo base: as capacidades existentes do modelo base limitam o que o fine-tuning consegue acrescentar
- Hiperparâmetros: taxa de aprendizado, número de passos de treinamento e tamanho do rank afetam a qualidade do resultado
💡 Armadilha do overfitting: Treinar por tempo demais com poucas imagens faz o modelo memorizar em vez de generalizar. Se toda imagem gerada parecer idêntica às suas fotos de treinamento, sua taxa de aprendizado estava alta demais ou você executou passos demais.
Quando fazer fine-tuning e quando usar apenas o prompt
Nem todo caso de uso precisa de um modelo com fine-tuning. Modelos de texto para imagem como o Flux Schnell LoRA já são muito capazes de seguir prompts detalhados em linguagem natural para assuntos variados. O fine-tuning se torna realmente necessário quando:
- Você precisa de uma representação consistente de um rosto ou personagem específico
- Você quer um estilo visual proprietário que o prompt sozinho não consegue reproduzir
- Você gera imagens de produtos nas quais as cores e os detalhes exatos da marca precisam aparecer
- Você precisa que o modelo gere conteúdo de um domínio especializado com pouca representação online
Como os modelos modernos se comparam
O cenário do texto para imagem em 2025 se fragmentou em várias filosofias arquiteturais distintas:
| Modelo | Arquitetura | Ponto forte | Melhor para |
|---|
| Stable Diffusion 3 | Transformer de difusão | Pesos abertos, personalizável | Fine-tuning, pesquisa |
| Flux Redux Dev | Flow Matching | Qualidade de variação de imagem | Consistência de estilo |
| GPT Image 2 | Autorregressivo | Renderização de texto, seguimento de instruções | Gráficos de documentos |
| Seedream 4.5 | Difusão | Detalhe em 4K, estética refinada | Saída em alta resolução |
| Recraft 20B | Difusão | Tipografia, estilos vetoriais | Design e branding |
| Hunyuan Image 2.1 | Difusão | Fotorrealismo | Fotografia de produtos |
A variedade reflete o fato de que nenhuma abordagem de treinamento domina todos os casos de uso. Um modelo treinado para renderizar texto preciso em imagens (como o GPT Image 2) fez contrapartidas arquiteturais e de dataset diferentes de um modelo treinado para o máximo de fotorrealismo (como o Hunyuan).
A distância entre o treinamento e o que você vê
Um detalhe que vale a pena notar: o modelo com o qual você interage raramente é o checkpoint pré-treinado bruto. A maioria dos sistemas de texto para imagem em uso passa por etapas adicionais depois do pré-treinamento base.
Classifier-free guidance (CFG) treina o modelo para aceitar um parâmetro de guidance scale que amplifica a aderência ao prompt ao custo de alguma diversidade. Um guidance scale mais alto significa resultados mais fiéis ao prompt, mas que exploram menos o espaço possível de saídas.
Aprendizado por reforço com feedback humano (RLHF) ou etapas semelhantes de modelagem de recompensa usam avaliações de preferência humana para direcionar o modelo a resultados que as pessoas realmente acham atraentes, e não apenas resultados que se parecem estatisticamente com os dados de treinamento.
Fine-tuning de segurança acrescenta camadas que impedem a geração de certas categorias de conteúdo, novamente por meio de rotulagem humana e modelagem de recompensa.
Cada uma dessas etapas envolve computação adicional, trabalho humano adicional e decisões adicionais sobre o que o modelo deve e não deve produzir. O ato "simples" de digitar um prompt está ligado a meses de trabalho realizado em várias equipes.
💡 O que isso significa para seus prompts: Como essas etapas pós-treinamento empurram os modelos para estéticas preferidas pelas pessoas, prompts que descrevem o que um fotógrafo profissional ou um diretor de arte se importaria (direção da luz, escolha da lente, clima, composição) tendem a superar pedidos criativos vagos.
A infraestrutura por trás do resultado
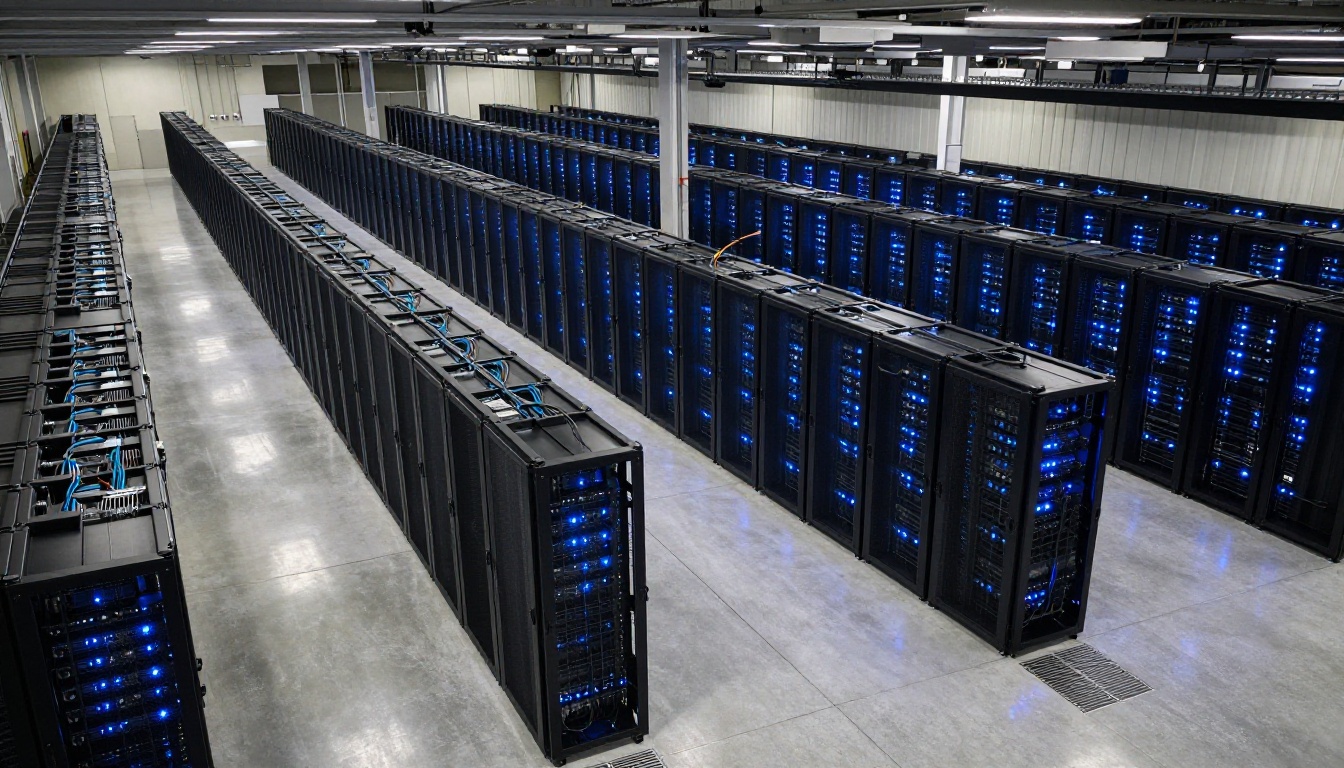
O treinamento na escala dos modelos modernos de texto para imagem exige uma infraestrutura dedicada que roda continuamente por meses. Uma única execução de treinamento de um modelo grande pode consumir tanta eletricidade quanto uma pequena cidade usa em uma semana. Sistemas de resfriamento, redundância de energia e a rede de interconexão se tornam preocupações de engenharia de primeira ordem, e não ideias de última hora.
Essa é a realidade de infraestrutura por trás dos modelos que você agora acessa em segundos por uma interface web. O gerador PicassoIA Image conecta você a modelos pré-treinados que levaram meses de tempo de cluster para ser produzidos, servidos em hardware otimizado para inferência rápida, e não para vazão de treinamento.
O que você vê como uma caixa de prompt limpa e simples representa a camada mais externa de um sistema extraordinariamente complexo: datasets rastreados, legendas curadas, treinamento distribuído em milhares de GPUs, etapas de alinhamento com avaliadores humanos e filtragem de segurança, tudo comprimido em uma única chamada de API.
Coloque o treinamento para funcionar
Agora você conhece a cadeia completa: datasets curados, codificadores de texto contrastivos, processos de difusão no espaço latente, otimização de perda sobre bilhões de exemplos e etapas de alinhamento pós-treinamento. Cada imagem que você gera carrega a marca dessas decisões.
A forma mais direta de aplicar esse conhecimento é experimentar a variedade de modelos disponíveis no PicassoIA Image. Cada modelo reflete escolhas de treinamento diferentes, prioridades de dataset diferentes e apostas arquiteturais diferentes. A diferença entre uma resposta muito detalhada a um prompt e uma genérica muitas vezes se resume a escrever prompts alinhados com aquilo para que o modelo foi treinado.
Se você quer ir além, o P Image Trainer permite executar seu próprio fine-tuning LoRA diretamente no navegador, sem precisar configurar GPU. Envie de 20 a 100 imagens de um assunto, escreva as legendas e, em horas, você terá um checkpoint de modelo personalizado que gera esse assunto sob demanda.
A distância entre ler sobre como os modelos de texto para imagem são treinados e fazer isso você mesmo nunca foi tão pequena. Escolha um assunto, reúna suas imagens e comece a treinar.


