Escribes unas cuantas palabras, pulsas generar y, en cuestión de segundos, aparece una imagen fotorrealista. Desde fuera, el proceso parece sencillo, pero detrás de cada modelo de texto a imagen hay meses de cálculo, miles de millones de ejemplos de entrenamiento y una cadena de decisiones de aprendizaje automático muy precisa. Este artículo levanta el telón sobre cómo se entrenan los modelos de texto a imagen, desde los ingredientes en bruto hasta el sistema final desplegado con el que interactúas.
El problema de los datos llega primero
Antes de que una red neuronal entrene un solo peso, alguien tiene que resolver el problema de los datos. Los modelos de texto a imagen requieren colecciones enormes de pares imagen-descripción, es decir, cada fotografía o ilustración debe venir acompañada de una descripción escrita precisa de lo que muestra.
La escala aquí no es modesta. Modelos como Stable Diffusion se entrenaron con subconjuntos del dataset LAION-5B, que contiene aproximadamente cinco mil millones de pares imagen-texto extraídos de páginas web de acceso público. Sistemas más recientes, como Flux Redux Dev de Black Forest Labs, se apoyan en datasets seleccionados y refinados por su calidad más que por su volumen bruto.
De dónde salen las imágenes
La mayoría de las imágenes de entrenamiento proceden del rastreo web a gran escala. Rastreadores automatizados visitan miles de millones de páginas web y descargan cada imagen que encuentran junto con el texto HTML circundante, los atributos alt y los pies de foto. Ese volcado en bruto pasa después por varias etapas de filtrado.
Los filtros habituales eliminan:
- Imágenes por debajo de un umbral mínimo de resolución (normalmente 512x512 píxeles)
- Imágenes casi duplicadas que sesgarían el modelo hacia contenidos concretos
- Imágenes con descripciones que no coinciden o que están vacías
- Contenido marcado por clasificadores de seguridad
Lo que queda sigue siendo una muestra imperfecta y muy sesgada de internet, y por eso la curación de datasets se ha convertido en una de las decisiones más importantes que toma cualquier laboratorio de modelos.
Cómo se emparejan las descripciones de texto
No todas las imágenes de la web vienen con una descripción útil. Una foto de producto puede tener una etiqueta alt como "img_4782.jpg", mientras que una publicación en redes sociales no tiene ninguna descripción. Para resolverlo, los laboratorios de modelos hacen una de dos cosas:
- Usar descripciones existentes de fuentes fiables (Wikipedia, bases de datos de fotos de archivo, archivos de noticias) en las que ya hay descripciones escritas por personas
- Generar descripciones sintéticas con un modelo de visión y lenguaje que describe automáticamente el contenido de la imagen
El segundo enfoque se ha convertido en estándar. Sistemas como LLaVA o Flamingo se usan para generar descripciones detalladas de millones de imágenes que, de otro modo, carecerían de pares de texto utilizables. El resultado es una descripción más rica, que no solo habla del sujeto, sino también de la iluminación, la composición y el estado de ánimo.
Por qué la calidad del dataset lo cambia todo
Un modelo entrenado con descripciones mal emparejadas tendrá dificultades para seguir los prompts con precisión. Si una imagen de un atardecer tiene como descripción "foto bonita" en lugar de "atardecer dorado sobre olas del océano con cielo naranja y morado", el modelo apenas aprende de ese ejemplo qué debería ser un "atardecer".
Por eso laboratorios como Bytedance (detrás de Seedream 4.5) y Stability AI (detrás de Stable Diffusion 3) invierten mucho en pipelines de datos y no solo en cómputo. Los datos de mejor calidad suelen superar a un mayor cómputo.
💡 El volante de datos: Las empresas con grandes bases de usuarios pueden usar prompts reales y valoraciones de sus usuarios para mejorar continuamente la calidad de sus datasets, lo que da a las plataformas consolidadas una ventaja creciente frente a los recién llegados.
La arquitectura que hace el aprendizaje
Una vez que existe un dataset limpio, la arquitectura del modelo determina cómo procesa el sistema esos datos. Dos enfoques dominantes sustentan la mayoría de los modelos de texto a imagen actuales: los modelos de difusión y los modelos autorregresivos. Los modelos de difusión son, con diferencia, la opción más habitual.
Los modelos de difusión explicados de forma sencilla
Un modelo de difusión genera imágenes invirtiendo un proceso de destrucción. Durante el entrenamiento, el sistema toma imágenes reales y añade ruido gaussiano de forma progresiva a lo largo de cientos de pasos, hasta que la imagen resulta indistinguible de una estática aleatoria pura. Después, el modelo aprende a predecir y eliminar ese ruido, un paso cada vez, trabajando hacia atrás desde el caos hasta llegar a una imagen coherente.
En la inferencia, el modelo parte de ruido puro y lo va eliminando de forma iterativa, guiado por un prompt de texto, hasta que aparece una imagen reconocible. El condicionamiento por texto es lo que orienta la eliminación del ruido en una dirección concreta.
Este proceso se ejecuta en lo que se llama espacio latente y no en el espacio de píxeles. Una red independiente llamada autocodificador variacional (VAE) comprime las imágenes de resolución completa en una representación compacta de menor dimensión antes de que empiece el proceso de difusión. Esto reduce drásticamente el costo de cómputo del entrenamiento y de la inferencia.
El papel de CLIP en el entrenamiento
Para que un modelo genere imágenes a partir de texto, necesita un espacio de representación compartido en el que el texto y las imágenes puedan compararse de forma significativa. CLIP (Contrastive Language-Image Pretraining), de OpenAI, supuso el avance que hizo esto posible.
CLIP se entrenó con 400 millones de pares imagen-texto para producir embeddings en los que las imágenes y descripciones que coinciden quedan cerca en el espacio vectorial, mientras que los pares que no coinciden se alejan. Este enfoque de aprendizaje contrastivo hace que la frase "un coche deportivo rojo en una carretera de montaña" produzca un embedding geométricamente cercano a imágenes reales de coches deportivos rojos en carreteras de montaña.
La mayoría de los modelos de difusión usan CLIP o un sucesor (como el codificador de texto T5 que emplea Stable Diffusion 3) para convertir los prompts de texto de entrada en vectores de condicionamiento. Estos vectores se inyectan en la red de eliminación de ruido mediante capas de atención cruzada, indicando al modelo qué conceptos visuales debe enfatizar en cada paso.
Espacio latente: por qué importa
El concepto de espacio latente es central en el funcionamiento de los generadores de imágenes modernos, y explica por qué la ingeniería de prompts importa tanto. Cada punto del espacio latente corresponde a una imagen posible. Las imágenes con características visuales similares se agrupan cerca unas de otras. Cuando escribes un prompt, el codificador de texto asigna tus palabras a una región de ese espacio, y el eliminador de ruido encuentra una imagen plausible dentro de esa región.
Por eso cambios pequeños en el prompt pueden producir resultados muy distintos. Moverse incluso un poco en el espacio latente puede cruzar a un grupo visual diferente. Modelos como Recraft 20B y GPT Image 2 han sido ajustados específicamente para que sus espacios latentes respeten mejor las instrucciones precisas del prompt.
Qué ocurre realmente durante el entrenamiento
Entender la arquitectura es una cosa. Ver lo que implica realmente el entrenamiento es otra. Se trata de un bucle de optimización largo y muy costoso en cómputo, que se ejecuta de forma continua durante semanas o meses.
Funciones de pérdida y gradientes
Durante el entrenamiento, el modelo procesa un lote de pares imagen-texto. Para cada par, añade ruido a la imagen y después intenta predecir qué ruido se añadió. La diferencia entre el ruido predicho y el ruido real es la pérdida, concretamente llamada pérdida de coincidencia de puntuación por eliminación de ruido.
El optimizador (normalmente Adam o AdamW) calcula luego los gradientes de esa pérdida con respecto a cada parámetro del modelo y ajusta esos parámetros en la dirección que reduce el error. Esto se repite con miles de millones de pares imagen-texto durante días o semanas.
A medida que avanza el entrenamiento, la curva de pérdida baja. Al principio, el modelo genera ruido incoherente con formas vagas. Tras millones de pasos, empiezan a aparecer estructuras claras. Tras decenas de millones de pasos, se vuelven posibles resultados fotorrealistas con una adherencia precisa al prompt.
Cuánto tarda realmente el entrenamiento
Las cifras son llamativas:
| Escala del modelo | Tiempo aproximado de entrenamiento | GPU necesarias |
|---|
| Pequeño (300M parámetros) | 2-5 días | 8-32 A100 |
| Mediano (1B parámetros) | 1-3 semanas | 64-256 A100 |
| Grande (3B+ parámetros) | 4-12 semanas | 512-2048 H100 |
| Muy grande (10B+) | 3-6 meses | Más de 4000 H100 |
Modelos como Wan 2.7 Image Pro y Hunyuan Image 2.1 están en la categoría de grande a muy grande, y requieren clústeres que la mayoría de las organizaciones nunca tendrán en propiedad.
La realidad del hardware
Las GPU son los caballos de batalla del entrenamiento de modelos, pero la infraestructura que las rodea importa igual de mucho. Son necesarias interconexiones rápidas (NVLink, InfiniBand) para sincronizar los gradientes entre cientos de GPU al mismo tiempo. Los sistemas de almacenamiento deben servir los datos de entrenamiento con la rapidez suficiente para mantener las GPU alimentadas sin cuellos de botella. La energía y la refrigeración a gran escala se convierten en verdaderos retos de ingeniería.
El costo de entrenar desde cero un modelo de texto a imagen de vanguardia ya asciende a millones de dólares. Por eso muy pocas organizaciones entrenan modelos base desde cero, mientras que muchas más se centran en ajustar modelos existentes.
El ajuste fino después del preentrenamiento
Preentrenar un modelo con miles de millones de ejemplos le da capacidades generales amplias. El ajuste fino lo especializa después en estilos, sujetos o comportamientos concretos, sin repetir el proceso completo de entrenamiento.
LoRA: estilos personalizados sin reentrenamiento completo
LoRA (Low-Rank Adaptation) se ha convertido en el método de ajuste fino más popular en el ámbito del texto a imagen. En lugar de actualizar todos los miles de millones de parámetros de un modelo, LoRA añade pequeñas matrices de bajo rango junto a las matrices de pesos existentes. Solo estas adiciones se entrenan con el dataset personalizado.
En la práctica, una sesión de entrenamiento LoRA sobre un estilo fotográfico, un personaje o un producto concretos puede necesitar solo entre 20 y 100 imágenes, una GPU de consumo y unas pocas horas de entrenamiento, en lugar de los meses y los millones que requiere un modelo base completo.
Esto es exactamente lo que ofrece el P Image Trainer de PicassoIA. Permite a cualquiera entrenar un LoRA personalizado con sus propias imágenes y después usar ese adaptador entrenado para generar nuevas imágenes con el mismo estilo o con el mismo sujeto.
Qué requiere el ajuste fino
Una sesión de ajuste fino LoRA exitosa necesita:
- Tamaño del dataset: entre 15 y 200 imágenes de alta calidad del sujeto o estilo objetivo
- Calidad de las descripciones: cada imagen necesita una descripción precisa y detallada
- Elección del modelo base: las capacidades existentes del modelo base limitan lo que el ajuste fino puede añadir
- Hiperparámetros: la tasa de aprendizaje, los pasos de entrenamiento y el tamaño del rango influyen en la calidad del resultado
💡 La trampa del sobreajuste: Entrenar demasiado tiempo con muy pocas imágenes hace que el modelo memorice en lugar de generalizar. Si todas las imágenes generadas se parecen a tus fotos de entrenamiento, tu tasa de aprendizaje era demasiado alta o diste demasiados pasos.
Cuándo ajustar el modelo y cuándo basta con el prompt
No todos los casos de uso necesitan un modelo ajustado. Modelos de texto a imagen como Flux Schnell LoRA ya son muy capaces de seguir prompts detallados en lenguaje natural para sujetos muy variados. El ajuste fino se vuelve realmente necesario cuando:
- Necesitas una representación coherente de un rostro o personaje concreto
- Quieres un estilo visual propio que el prompt por sí solo no puede replicar
- Generas imágenes de producto en las que deben aparecer los colores y detalles exactos de la marca
- Necesitas que el modelo genere contenido de un ámbito especializado con poca representación en internet
Cómo se comparan los modelos actuales
El panorama del texto a imagen en 2025 se ha fragmentado en varias filosofías arquitectónicas distintas:
| Modelo | Arquitectura | Fortaleza | Ideal para |
|---|
| Stable Diffusion 3 | Transformador de difusión | Pesos abiertos, personalizable | Ajuste fino, investigación |
| Flux Redux Dev | Flow matching | Calidad de variación de imagen | Coherencia de estilo |
| GPT Image 2 | Autorregresiva | Render de texto, seguimiento de instrucciones | Gráficos para documentos |
| Seedream 4.5 | Difusión | Detalle en 4K, estética fina | Salida de alta resolución |
| Recraft 20B | Difusión | Tipografía, estilos vectoriales | Diseño y branding |
| Hunyuan Image 2.1 | Difusión | Fotorrealismo | Fotografía de producto |
La variedad refleja que ningún enfoque de entrenamiento domina en todos los casos de uso. Un modelo entrenado para renderizar texto preciso en imágenes (como GPT Image 2) ha tomado otras contrapartidas de arquitectura y de conjunto de datos que uno entrenado para el máximo fotorrealismo (como Hunyuan).
La brecha entre el entrenamiento y lo que ves
Un detalle que conviene señalar: el modelo con el que interactúas rara vez es el checkpoint preentrenado en bruto. La mayoría de los sistemas de texto a imagen desplegados pasan por etapas adicionales después del preentrenamiento base.
La guía sin clasificador (CFG) entrena el modelo para aceptar un parámetro de guidance scale que aumenta la adherencia al prompt a costa de cierta diversidad. Un guidance scale más alto significa resultados que se ajustan más al prompt, pero que exploran menos el espacio de salidas posibles.
El aprendizaje por refuerzo con retroalimentación humana (RLHF) o etapas similares de modelado de recompensa usan valoraciones de preferencia humanas para orientar el modelo hacia resultados que a las personas les resultan atractivos, y no solo hacia resultados que se parecen estadísticamente a los datos de entrenamiento.
El ajuste fino de seguridad añade capas que impiden generar ciertas categorías de contenido, de nuevo mediante etiquetado humano y modelado de recompensa.
Cada una de estas etapas implica cómputo adicional, trabajo humano adicional y decisiones adicionales sobre lo que el modelo debe producir y lo que no. El acto "sencillo" de escribir un prompt está conectado con meses de trabajo repartido entre varios equipos.
💡 Qué significa esto para tus prompts: Como estas etapas posteriores al entrenamiento empujan a los modelos hacia estéticas que prefieren las personas, los prompts que describen lo que le importaría a un fotógrafo o director de arte profesional (dirección de la luz, elección de objetivo, estado de ánimo, composición) suelen superar a las peticiones creativas vagas.
La infraestructura detrás del resultado
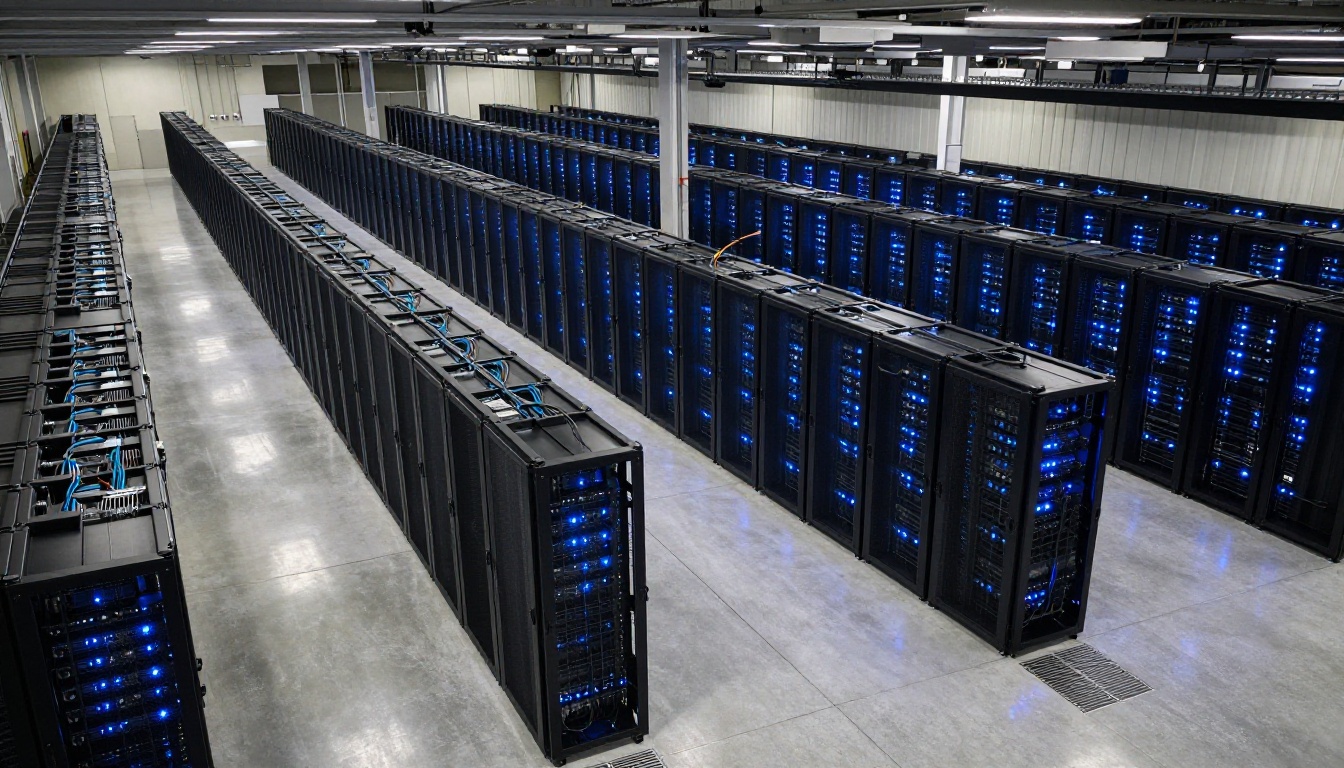
El entrenamiento a la escala de los modelos de texto a imagen actuales requiere una infraestructura dedicada que funciona de forma continua durante meses. Una sola sesión de entrenamiento de un modelo grande puede consumir tanta electricidad como una pequeña ciudad en una semana. Los sistemas de refrigeración, la redundancia energética y la red de interconexión pasan a ser problemas de ingeniería de primer orden, no algo secundario.
Esta es la realidad de infraestructura que hay detrás de los modelos a los que ahora accedes en segundos a través de una interfaz web. El generador PicassoIA Image te conecta con modelos preentrenados que tardaron meses de tiempo de clúster en producirse, servidos en hardware optimizado para inferencia rápida y no para el rendimiento del entrenamiento.
Lo que ves como un cuadro de prompt limpio y sencillo representa la capa más externa de un sistema extraordinariamente complejo: datasets rastreados, descripciones curadas, entrenamiento distribuido en miles de GPU, etapas de alineación con evaluadores humanos y filtrado de seguridad, todo comprimido en una sola llamada a la API.
Pon el entrenamiento a trabajar
Ahora conoces la cadena completa: datasets curados, codificadores de texto contrastivos, procesos de difusión en espacio latente, optimización de pérdidas sobre miles de millones de ejemplos y pasos de alineación posteriores al entrenamiento. Cada imagen que generas lleva la huella de estas decisiones.
La forma más directa de aplicar este conocimiento es experimentar con la gama de modelos disponibles en PicassoIA Image. Cada modelo refleja distintas decisiones de entrenamiento, prioridades de dataset y apuestas arquitectónicas. La diferencia entre una respuesta muy detallada y una genérica suele depender de escribir prompts que encajen con aquello a lo que el modelo fue entrenado para responder.
Si quieres profundizar, el P Image Trainer te permite ejecutar tu propio ajuste fino LoRA directamente en el navegador, sin necesidad de configurar una GPU. Sube entre 20 y 100 imágenes de un sujeto, escribe las descripciones y, en cuestión de horas, tendrás un checkpoint de modelo personalizado que genera ese sujeto cuando lo pidas.
La barrera entre leer sobre cómo se entrenan los modelos de texto a imagen y hacerlo tú mismo nunca ha sido tan baja. Elige un sujeto, reúne tus imágenes y empieza a entrenar.


