Vous tapez quelques mots, cliquez sur générer, et en quelques secondes une image photoréaliste apparaît. Vu de l’extérieur, le processus paraît sans effort, mais derrière chaque modèle texte vers image se cachent des mois de calcul, des milliards d’exemples d’entraînement et une chaîne de décisions d’apprentissage automatique remarquablement précise. Cet article lève le voile sur la façon dont les modèles texte vers image sont entraînés, depuis les ingrédients bruts jusqu’au système final déployé avec lequel vous interagissez.
Le problème des données passe en premier
Avant qu’un réseau de neurones n’ajuste le moindre poids, il faut résoudre le problème des données. Les modèles texte vers image nécessitent d’énormes collections de paires image-légende, c’est-à-dire que chaque photographie ou illustration doit être accompagnée d’une description écrite fidèle de ce qu’elle montre.
L’échelle est loin d’être modeste. Des modèles comme Stable Diffusion ont été entraînés sur des sous-ensembles du jeu de données LAION-5B, qui contient environ cinq milliards de paires image-texte collectées sur des pages web accessibles au public. Des systèmes plus récents, dont Flux Redux Dev de Black Forest Labs, s’appuient sur des jeux de données sélectionnés et affinés pour leur qualité plutôt que pour leur volume brut.
D’où viennent les images
La majorité des images d’entraînement proviennent d’un moissonnage web à grande échelle. Des robots d’exploration automatisés parcourent des milliards de pages web et téléchargent chaque image trouvée, avec le texte HTML environnant, les attributs alt et les légendes. Cette masse brute passe ensuite par plusieurs étapes de filtrage.
Les filtres courants éliminent :
- les images en dessous d’un seuil minimal de résolution (généralement 512x512 pixels)
- les quasi-doublons qui biaiseraient le modèle vers certains contenus
- les images dont la légende ne correspond pas ou est vide
- les contenus signalés par les classificateurs de sécurité
Ce qui reste demeure néanmoins un échantillon imparfait et fortement biaisé d’internet, ce qui explique pourquoi la sélection des données est devenue l’une des décisions les plus lourdes de conséquences pour tout laboratoire de modèles.
Comment les légendes textuelles sont associées
Toutes les images du web ne sont pas accompagnées d’une description utile. Une photo de produit peut avoir une balise alt « img_4782.jpg » tandis qu’une publication sur les réseaux sociaux n’a aucune légende. Pour gérer cela, les laboratoires font l’une de deux choses :
- Utiliser des légendes existantes provenant de sources fiables (Wikipédia, bases de données de photos de banques d’images, archives de presse) où des descriptions rédigées par des humains sont déjà présentes
- Générer des légendes synthétiques à l’aide d’un modèle vision-langage qui décrit automatiquement le contenu de l’image
La seconde approche est devenue la norme. Des systèmes comme LLaVA ou Flamingo servent à générer des descriptions détaillées pour des millions d’images qui n’auraient autrement pas de texte exploitable. Le résultat est une légende plus riche, qui décrit non seulement le sujet mais aussi l’éclairage, la composition et l’ambiance.
Pourquoi la qualité des données change tout
Un modèle entraîné sur des légendes mal appariées aura du mal à suivre fidèlement les prompts. Si une image de coucher de soleil est légendée « belle photo » au lieu de « coucher de soleil à l’heure dorée sur des vagues océaniques avec un ciel orange et violet », le modèle ne tire presque rien de cet exemple sur ce à quoi devrait ressembler un « coucher de soleil ».
C’est pourquoi des acteurs comme ByteDance (derrière Seedream 4.5) et Stability AI (derrière Stable Diffusion 3) investissent fortement dans leurs chaînes de traitement des données plutôt que seulement dans la puissance de calcul. De meilleures données l’emportent souvent sur davantage de calcul.
💡 Le cercle vertueux des données : les entreprises disposant de grandes bases d’utilisateurs peuvent exploiter les prompts réels et les évaluations de leurs utilisateurs pour améliorer continuellement la qualité des données, ce qui donne aux plateformes établies un avantage grandissant sur les nouveaux venus.
L’architecture qui réalise l’apprentissage
Une fois qu’un jeu de données propre existe, l’architecture du modèle détermine la façon dont le système le traite. Deux approches dominantes alimentent la plupart des modèles texte vers image modernes : les modèles de diffusion et les modèles autorégressifs. Les modèles de diffusion sont de loin le choix le plus courant.
Les modèles de diffusion expliqués simplement
Un modèle de diffusion génère des images en inversant un processus de destruction. Pendant l’entraînement, le système prend de vraies images et ajoute progressivement un bruit gaussien sur des centaines d’étapes, jusqu’à ce que l’image soit indiscernable d’une pure statique aléatoire. Le modèle apprend ensuite à prédire et à retirer ce bruit, une étape à la fois, en remontant du chaos vers une image cohérente.
Au moment de l’inférence, le modèle part d’un bruit pur et le débruite itérativement, guidé par un prompt textuel, jusqu’à ce qu’une image reconnaissable apparaisse. Le conditionnement par le texte est ce qui oriente le débruitage dans une direction précise.
Ce processus se déroule dans ce que l’on appelle l’espace latent plutôt que dans l’espace des pixels. Un réseau distinct appelé auto-encodeur variationnel (VAE) compresse les images en pleine résolution en une représentation compacte de plus faible dimension avant que le processus de diffusion ne commence. Cela réduit considérablement le coût de calcul de l’entraînement et de l’inférence.
Le rôle de CLIP dans l’entraînement
Pour qu’un modèle génère des images à partir de texte, il a besoin d’un espace de représentation commun où le texte et les images peuvent être comparés de façon pertinente. CLIP (Contrastive Language-Image Pretraining) d’OpenAI a apporté la percée qui a rendu cela possible.
CLIP a été entraîné sur 400 millions de paires image-texte pour produire des embeddings où les images et légendes correspondantes se trouvent proches dans l’espace vectoriel, tandis que les paires non concordantes sont éloignées. Cette approche d’apprentissage contrastif fait que la phrase « une voiture de sport rouge sur une route de montagne » produit un embedding géométriquement proche d’images réelles de voitures de sport rouges sur des routes de montagne.
La plupart des modèles de diffusion utilisent CLIP ou un successeur (comme l’encodeur de texte T5 employé dans Stable Diffusion 3) pour convertir les prompts textuels en vecteurs de conditionnement. Ces vecteurs sont ensuite injectés dans le réseau de débruitage via des couches d’attention croisée, indiquant au modèle quels concepts visuels mettre en avant à chaque étape du débruitage.
L’espace latent : pourquoi il compte
La notion d’espace latent est centrale dans le fonctionnement des générateurs d’images modernes, et elle explique pourquoi l’ingénierie des prompts compte autant. Chaque point de l’espace latent correspond à une image possible. Les images aux caractéristiques visuelles semblables se regroupent les unes près des autres. Lorsque vous tapez un prompt, l’encodeur de texte associe vos mots à une région de cet espace, et le débruiteur trouve une image plausible à l’intérieur de cette région.
C’est pourquoi de petites modifications de prompt peuvent produire des résultats très différents. Un déplacement, même léger, dans l’espace latent peut faire basculer vers un autre groupe visuel. Des modèles comme Recraft 20B et GPT Image 2 ont été spécifiquement réglés pour que leurs espaces latents respectent mieux les instructions précises du prompt.
À quoi ressemble réellement l’entraînement
Comprendre l’architecture est une chose. Voir ce que l’entraînement implique réellement en est une autre. C’est une boucle d’optimisation longue et très coûteuse en calcul, qui tourne en continu pendant des semaines ou des mois.
Fonctions de perte et gradients
Pendant l’entraînement, le modèle traite un lot de paires image-texte. Pour chaque paire, il ajoute du bruit à l’image puis tente de prédire ce qui a été ajouté. La différence entre le bruit prédit et le bruit réel constitue la perte, appelée précisément perte de correspondance de score de débruitage.
L’optimiseur (généralement Adam ou AdamW) calcule alors les gradients de cette perte par rapport à chaque paramètre du modèle, et ajuste ces paramètres dans le sens qui réduit l’erreur. Cela se répète sur des milliards de paires image-texte, pendant des jours ou des semaines.
À mesure que l’entraînement progresse, la courbe de perte descend. Au début, le modèle produit un bruit incohérent aux formes vagues. Après des millions d’étapes, des structures claires apparaissent. Après des dizaines de millions d’étapes, des résultats photoréalistes et un respect précis du prompt deviennent possibles.
Combien de temps dure réellement l’entraînement
Les chiffres sont frappants :
| Échelle du modèle | Durée d’entraînement approximative | GPU nécessaires |
|---|
| Petit (300 M de paramètres) | 2 à 5 jours | 8 à 32 A100 |
| Moyen (1 Md de paramètres) | 1 à 3 semaines | 64 à 256 A100 |
| Grand (3 Md de paramètres et plus) | 4 à 12 semaines | 512 à 2 048 H100 |
| Très grand (10 Md de paramètres et plus) | 3 à 6 mois | Plus de 4 000 H100 |
Des modèles comme Wan 2.7 Image Pro et Hunyuan Image 2.1 se situent dans les catégories grande à très grande, nécessitant des clusters que la plupart des organisations ne possèderont jamais entièrement.
La réalité du matériel
Les GPU sont les chevaux de trait de l’entraînement des modèles, mais l’infrastructure qui les entoure compte tout autant. Des interconnexions rapides (NVLink, InfiniBand) sont nécessaires pour synchroniser les gradients sur des centaines de GPU simultanément. Les systèmes de stockage doivent alimenter les GPU en données d’entraînement assez vite pour éviter les goulots d’étranglement. L’alimentation électrique et le refroidissement à grande échelle deviennent de véritables défis d’ingénierie.
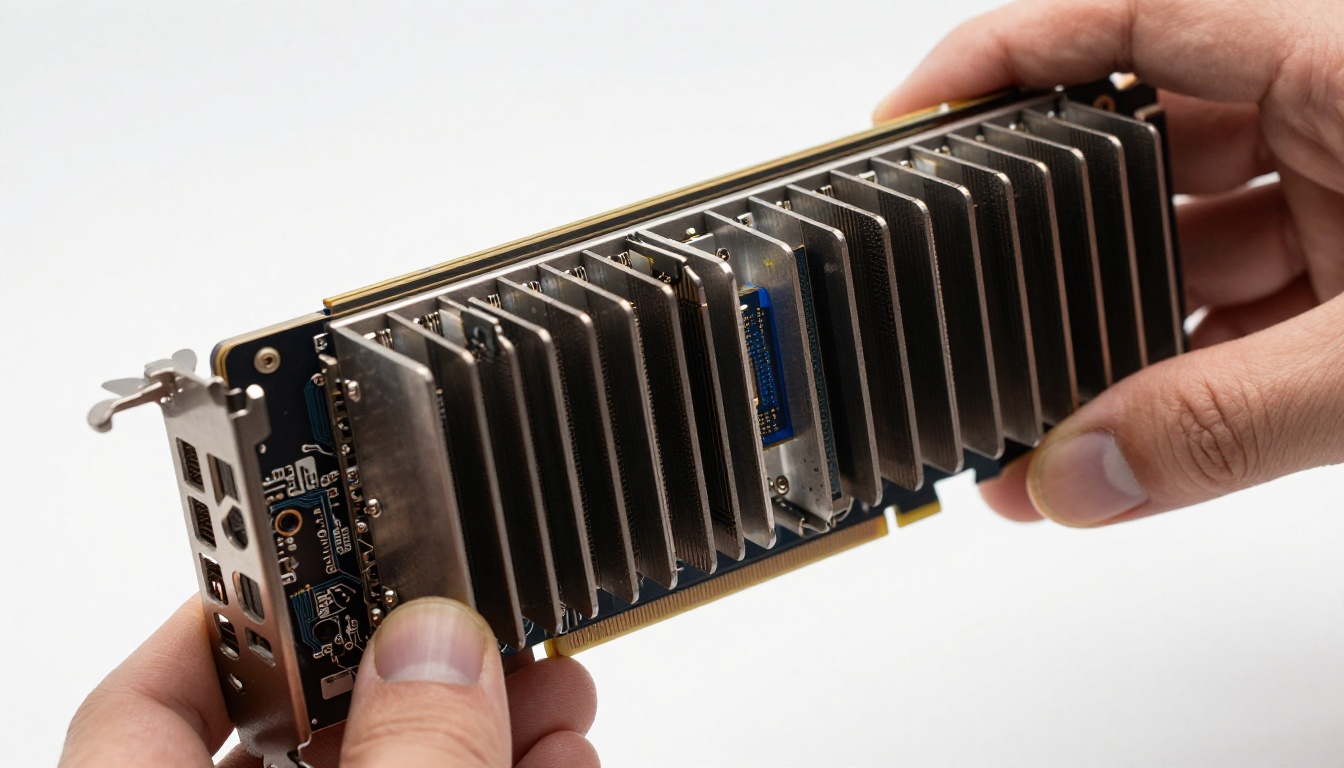
Le coût de l’entraînement d’un modèle texte vers image de pointe depuis zéro se chiffre désormais en millions de dollars. C’est pourquoi très peu d’organisations entraînent des modèles de base depuis zéro, tandis que beaucoup d’autres se concentrent sur le fine-tuning de modèles existants.
Le fine-tuning après le pré-entraînement
Pré-entraîner un modèle sur des milliards d’exemples lui donne de vastes capacités générales. Le fine-tuning le spécialise ensuite pour des styles, des sujets ou des comportements précis, sans reprendre l’intégralité du processus d’entraînement.
LoRA : des styles personnalisés sans réentraînement complet
LoRA (Low-Rank Adaptation) est devenu la méthode de fine-tuning la plus populaire dans le domaine du texte vers image. Au lieu de mettre à jour les milliards de paramètres d’un modèle, LoRA ajoute de petites matrices de rang faible à côté des matrices de poids existantes. Seules ces additions sont entraînées sur le jeu de données personnalisé.
Le résultat pratique : un entraînement LoRA sur un style photographique, un personnage ou un produit précis peut ne demander que 20 à 100 images, un GPU grand public et quelques heures d’entraînement, au lieu des mois et des millions nécessaires pour un modèle de base complet.
C’est exactement ce que propose le P Image Trainer sur PicassoIA. Il permet à chacun d’entraîner un LoRA personnalisé sur ses propres images, puis d’utiliser cet adaptateur entraîné pour générer de nouvelles images dans le même style ou mettant en scène le même sujet.
Ce que le fine-tuning exige
Une session de fine-tuning LoRA réussie nécessite :
- Taille du jeu de données : 15 à 200 images de haute qualité du sujet ou du style visé
- Qualité des légendes : chaque image a besoin d’une description précise et détaillée
- Choix du modèle de base : les capacités existantes du modèle de base limitent ce que le fine-tuning peut ajouter
- Hyperparamètres : le taux d’apprentissage, le nombre d’étapes et la taille du rang influencent tous la qualité du résultat
💡 Le piège du surapprentissage : un entraînement trop long sur trop peu d’images amène le modèle à mémoriser au lieu de généraliser. Si chaque image générée ressemble à vos photos d’entraînement, votre taux d’apprentissage était trop élevé ou vous avez effectué trop d’étapes.
Quand faire du fine-tuning et quand se contenter du prompt
Tous les cas d’usage ne nécessitent pas un modèle fine-tuné. Des modèles texte vers image comme Flux Schnell LoRA sont déjà très capables de suivre des prompts en langage naturel détaillés pour des sujets variés. Le fine-tuning devient réellement nécessaire lorsque :
- vous avez besoin d’une représentation cohérente d’un visage ou d’un personnage précis
- vous voulez un style visuel propriétaire que le prompt seul ne peut pas reproduire
- vous générez des visuels de produits où les couleurs et les détails exacts de la marque doivent apparaître
- vous avez besoin que le modèle génère des contenus d’un domaine spécialisé peu représenté en ligne
Comparaison des modèles actuels
Le paysage du texte vers image en 2025 s’est fragmenté en plusieurs philosophies architecturales distinctes :
| Modèle | Architecture | Point fort | Idéal pour |
|---|
| Stable Diffusion 3 | Transformeur de diffusion | Poids ouverts, personnalisable | Fine-tuning, recherche |
| Flux Redux Dev | Flow matching | Qualité des variations d’image | Cohérence de style |
| GPT Image 2 | Autorégressif | Rendu du texte, respect des instructions | Visuels de documents |
| Seedream 4.5 | Diffusion | Détail en 4K, esthétique fine | Sortie haute résolution |
| Recraft 20B | Diffusion | Typographie, styles vectoriels | Design et image de marque |
| Hunyuan Image 2.1 | Diffusion | Photoréalisme | Photographie de produit |
Cette variété reflète le fait qu’aucune approche d’entraînement unique ne domine tous les cas d’usage. Un modèle entraîné pour rendre un texte précis dans les images (comme GPT Image 2) a fait des compromis d’architecture et de données différents de ceux d’un modèle entraîné pour un photoréalisme maximal (comme Hunyuan).
L’écart entre l’entraînement et ce que vous voyez
Un détail mérite d’être souligné : le modèle avec lequel vous interagissez n’est presque jamais le checkpoint pré-entraîné brut. La plupart des systèmes texte vers image déployés passent par des étapes supplémentaires après le pré-entraînement de base.
Le guidage sans classifieur (CFG) entraîne le modèle à accepter un paramètre de guidance scale qui amplifie le respect du prompt au prix d’une certaine diversité. Un guidance scale plus élevé donne des résultats plus fidèles au prompt, mais explorent moins l’espace des sorties possibles.
L’apprentissage par renforcement à partir de retours humains (RLHF) ou des étapes de modélisation de récompense similaires utilisent des évaluations de préférence humaines pour orienter le modèle vers des résultats que les gens trouvent réellement attrayants, et pas seulement des résultats qui ressemblent statistiquement aux données d’entraînement.
Le fine-tuning de sécurité ajoute des couches qui empêchent la génération de certaines catégories de contenus, là encore grâce à un étiquetage humain et à la modélisation de récompense.
Chacune de ces étapes implique du calcul supplémentaire, du travail humain supplémentaire et des décisions supplémentaires sur ce que le modèle doit produire ou ne pas produire. L’acte « simple » de taper un prompt est relié à des mois de travail réalisé par plusieurs équipes.
💡 Ce que cela implique pour vos prompts : parce que ces étapes post-entraînement orientent les modèles vers des esthétiques préférées par les humains, les prompts qui décrivent ce qui préoccupe un photographe professionnel ou un directeur artistique (direction de la lumière, choix de l’objectif, ambiance, composition) donnent généralement de meilleurs résultats que des demandes créatives vagues.
L’infrastructure derrière le résultat
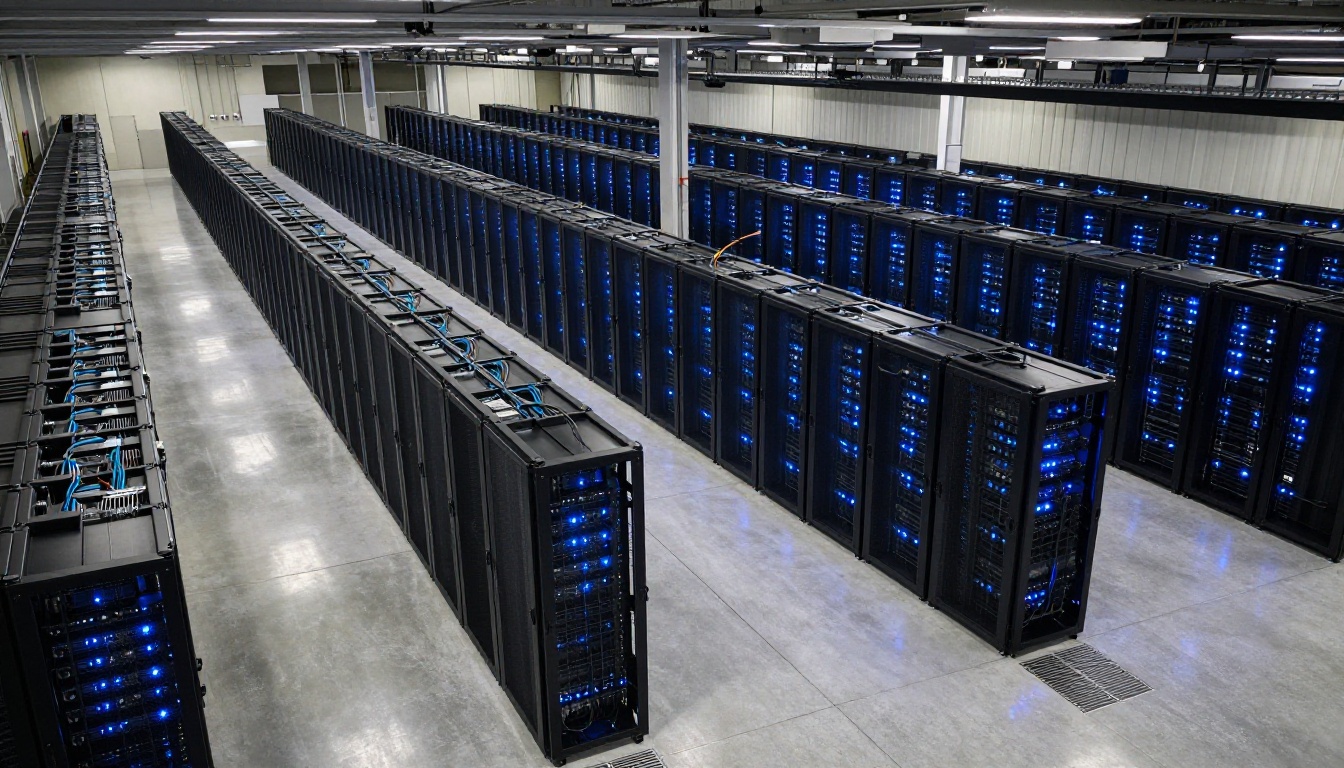
L’entraînement à l’échelle des modèles texte vers image modernes exige une infrastructure dédiée qui fonctionne en continu pendant des mois. Une seule session d’entraînement d’un grand modèle peut consommer autant d’électricité qu’une petite ville en une semaine. Les systèmes de refroidissement, la redondance électrique et le réseau deviennent des préoccupations d’ingénierie de premier plan, et non des réflexions après coup.
C’est la réalité de l’infrastructure qui se cache derrière les modèles auxquels vous accédez aujourd’hui en quelques secondes via une interface web. Le générateur PicassoIA Image vous connecte à des modèles pré-entraînés qui ont demandé des mois de temps de cluster pour être produits, servis sur un matériel optimisé pour une inférence rapide plutôt que pour le débit d’entraînement.
Ce que vous voyez comme une zone de saisie de prompt simple et épurée représente la couche la plus externe d’un système extraordinairement complexe : jeux de données moissonnés, légendes sélectionnées, entraînement distribué sur des milliers de GPU, étapes d’alignement avec des évaluateurs humains et filtrage de sécurité, le tout condensé en un seul appel d’API.
Mettez l’entraînement au service de vos créations
Vous connaissez désormais la chaîne complète : jeux de données sélectionnés, encodeurs de texte contrastifs, processus de diffusion dans l’espace latent, optimisation de la perte sur des milliards d’exemples et étapes d’alignement post-entraînement. Chaque image que vous générez porte l’empreinte de ces décisions.
La façon la plus directe d’appliquer ces connaissances est d’expérimenter avec la gamme de modèles disponibles sur PicassoIA Image. Chaque modèle reflète des choix d’entraînement, des priorités de données et des paris architecturaux différents. La différence entre une réponse très détaillée à un prompt et une réponse générique tient souvent à la façon d’écrire des prompts qui correspondent à ce que le modèle a été entraîné à comprendre.
Si vous voulez aller plus loin, le P Image Trainer vous permet de lancer votre propre fine-tuning LoRA directement dans le navigateur, sans configuration de GPU. Importez 20 à 100 images d’un sujet, rédigez les légendes, et en quelques heures vous disposez d’un checkpoint personnalisé qui génère ce sujet à la demande.
La frontière entre lire comment les modèles texte vers image sont entraînés et le faire soi-même n’a jamais été aussi mince. Choisissez un sujet, rassemblez vos images et lancez l’entraînement.


