تخيّل أنك أمضيت أسابيع في بناء شخصية، وتحريك كل تعبير فيها، وصقل خلفيتها القصصية، ثم اصطدمت بحائط حين يسألك أحدهم: "هل يستطيع التحدث بالإسبانية؟" أو "هل يمكنك إضافة نسخة يابانية؟". كان هذا الحائط يعني في السابق الاستعانة باستوديوهات دبلجة محترفة وممثلين صوتيين ومحرّكي مزامنة للشفاه. اليوم، جمع الذكاء الاصطناعي هذه السلسلة كلها في عملية رفع واحدة. يمكنك جعل شخصية تتحدث بأي لغة بالذكاء الاصطناعي خلال دقائق، مع شفاه متزامنة، ونبرة طبيعية، ودون أي وقت في الاستوديو.
هذا ليس مجرد أسلوب دعائي. النتائج التي تخرج من نماذج مثل HeyGen Video Translate وOmni Human 1.5 وSync Lipsync 2 Pro تُستخدم الآن في إنتاجات حقيقية، وقنوات YouTube حقيقية، ومنصات تعليمية حقيقية. لقد تجاوزت التقنية مرحلة صار فيها الناتج مقنعًا بما يكفي لنشره فعلًا.
ماذا يفعل مزامنة الشفاه بالذكاء الاصطناعي فعلًا
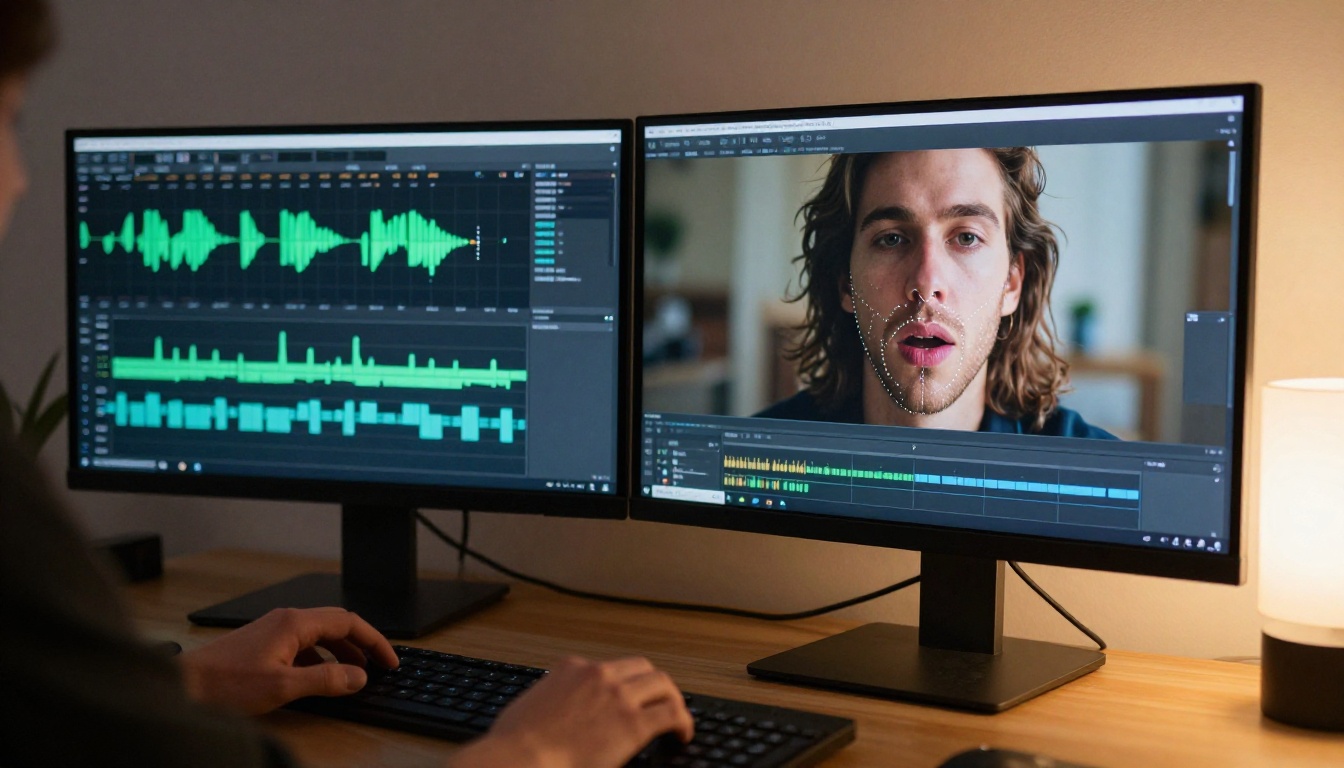
يظن معظم الناس أن دبلجة الذكاء الاصطناعي مجرد استبدال للصوت. وهذا غير صحيح. إذا استبدلت الصوت وحده، سيستمر الفم في الحركة على الكلمات الخاطئة، وهذا يبدو سيئًا للغاية. تنطوي مزامنة الشفاه الحقيقية بالذكاء الاصطناعي على ثلاث عمليات متزامنة: توليف الكلام باللغة الهدف، واستخلاص الفونيمات من هذا الصوت الجديد، وإعادة توجيه تحريك الوجه الذي يعيد وضع الفم والفك والعضلات المحيطة بالوجه لتتطابق مع هذه الفونيمات إطارًا بإطار.
كيف يعمل ربط الفونيمات
الفونيم هو أصغر وحدة صوتية في الكلام. تتكون كلمة "cat" من ثلاثة فونيمات: /k/ و/æ/ و/t/. ولكل لغة مخزونها الخاص من الفونيمات. فالإسبانية تملك أصواتًا مختلفة عن الإنجليزية في الحروف المتحركة، والعربية تضم أصواتًا لا وجود لها أصلًا في اللغات الرومانسية.
تُدرَّب نماذج مزامنة الشفاه بالذكاء الاصطناعي على مجموعات بيانات ضخمة من الكلام البشري مقرونًا بفيديوهات عالية السرعة لأفواه تنطق تلك الأصوات. وعند تزويد النموذج بمسار صوتي هدف، يستخرج تسلسل الفونيمات ويربط كل صوت بالشكل المقابل للفم، ويسمى الفيزيم. ثم يمزج هذه الفيزيمات عبر الإطارات بتوقيت يطابق أنماط الكلام البشري الطبيعية.
لماذا يبدو الصوت طبيعيًا الآن
أنتجت الدبلجة بالذكاء الاصطناعي في بداياتها نتائج آلية، لأن النماذج كانت تُدرَّب على كلام مسجّل في استوديو وفي ظروف هادئة. وكانت تعاني مع إيقاع الكلام الطبيعي، حيث تذوب الكلمات في بعضها، وتُختزل الحروف المتحركة، ويتغير التأكيد بحسب موقع الجملة.
تُدرَّب النماذج الحديثة على كلام محادثاتي بعشرات اللغات، مع تعزيز للبيانات يحاكي ظروف الصوت في العالم الحقيقي. والنتيجة كلام مدبلج يحمل الإيقاع الصوتي (prosody) الطبيعي، أي الارتفاعات والانخفاضات في درجة الصوت وسرعته، وهي ما يجعل الكلام يبدو بشريًا لا مُصنّعًا.
💡 Tip: جودة الصوت المصدر تؤثر مباشرة في دقة مزامنة الشفاه. الصوت النظيف الخالي من ضجيج الخلفية ينتج حركات شفاه أوضح بشكل ملحوظ.
التكلفة الحقيقية للدبلجة التقليدية
قبل الذكاء الاصطناعي، كان إنتاج نسخة متعددة اللغات من فيديو يحتاج إلى سلسلة إنتاج كاملة. إليك ما كان يعنيه ذلك مقارنةً بما يتيحه الذكاء الاصطناعي اليوم:
| العامل | الدبلجة التقليدية | مزامنة الشفاه بالذكاء الاصطناعي |
|---|
| وقت التنفيذ | من 2 إلى 6 أسابيع | دقائق إلى ساعات |
| التكلفة لكل دقيقة | من $500 إلى $3,000+ | أجزاء من السنت |
| اللغات المدعومة | محدودة بتوافر المواهب | من 100 إلى 150+ |
| جودة مزامنة الشفاه | رسوم متحركة يدوية إطارًا تلو الآخر | مطابقة تلقائية للفونيمات |
| قابلية التوسع | مقيّدة بطاقة الاستوديو | معالجة متوازية غير محدودة |
| سرعة المراجعة | أيام لكل تعديل | ثوانٍ لكل إعادة تصيير |
تكفي الاقتصاديات وحدها لتفسير سبب تبنّي صنّاع المحتوى واستوديوهات الألعاب والمعلّمين لمزامنة الشفاه بالذكاء الاصطناعي بوتيرة متسارعة. لقد تجاوزت الجودة التقنية حدّ الجدوى التجارية، وفرق التكلفة ليس هامشيًا، بل هو بفارق رتبة كاملة من حيث الحجم.
أفضل نماذج الذكاء الاصطناعي للشخصيات متعددة اللغات
ليست كل نماذج مزامنة الشفاه تتعامل مع كل حالة الاستخدام بالكفاءة نفسها. بعضها مُحسَّن للوجوه الحقيقية في الفيديو، وبعضها يعمل انطلاقًا من صورة فوتوغرافية واحدة. إليك أكثر الخيارات كفاءة المتاحة الآن.
HeyGen Video Translate
HeyGen Video Translate هو النموذج الذي يلجأ إليه معظم الناس حين يحتاجون إلى تغطية واسعة للغات. يدعم أكثر من 150 لغة، ويتولى الترجمة ومزامنة الشفاه في سير عمل واحد. ترفع فيديو، وتختار اللغة الهدف، فيُنتج النموذج نسخة بحركة شفاه متزامنة وكلام مترجم.
ما يميّزه بقوة هو تعامله مع نقل prosody، أي أن النبرة العاطفية للمتحدث الأصلي تنتقل إلى النسخة المدبلجة. فالشخصية التي تبدو متحمسة بالإنجليزية تبدو متحمسة بالبرتغالية، لا جافة وآلية.
HeyGen Lipsync Precision وHeyGen Lipsync Speed
في الحالات التي يتوفر فيها مسار صوتي مترجم جاهز وتحتاج فقط إلى مطابقة الشفاه له، يقدّم Lipsync Precision وLipsync Speed حلولًا مخصصة. يعطي Precision الأولوية للدقة، فيعمل إطارًا بإطار مع تعديل دقيق للوجه. أما Speed فمُحسَّن للإنجاز السريع عند معالجة أحجام كبيرة من المحتوى.
يعتمد الفرق على سير عملك. فبالنسبة إلى فيديو رئيسي مصقول، يستحق Precision وقت المعالجة الإضافي. أما لدبلجة مكتبة دورات بالجملة إلى خمس لغات، فيوصلك Speed إلى هدفك دون اختناقات.
Omni Human 1.5 من ByteDance
يتبنّى Omni Human 1.5 من ByteDance مقاربة مختلفة. فبدلًا من معالجة فيديو موجود، يمكنه تحريك صورة فوتوغرافية واحدة لتصبح فيديو كاملًا لشخص يتحدث، بحركة رأس طبيعية ورمش ومزامنة للشفاه. تزوّده بصورة ثابتة لشخصيتك وملف صوتي، فينتج نسخة متحركة مقنعة تتحدث.
وهذا مفيد بشكل خاص للشخصيات التي تظهر فقط في الرسوم التوضيحية أو الفن المفاهيمي أو البورتريهات. فأنت لا تقتصر على لقطات فيديو لشخص حقيقي يتحدث.
Sync Lipsync 2 Pro
صُمم Sync Lipsync 2 Pro خصيصًا لمواجهة تحدي مطابقة صوت موجود مسبقًا مع الفيديو بأقصى درجات الإخلاص. يتعامل مع المحاذاة الدقيقة بين الفونيم والفيزيم، وهو قوي بشكل خاص عند العمل مع أصوات شخصيات ذات نبرة غير معتادة أو أساليب كلام مميزة.
ونموذجه المرافق، Sync Lipsync 2، يتعامل مع الحالات الأبسط ويعالج أسرع، ما يجعله مفيدًا كمرور أولي قبل إنهاء العمل بنسخة Pro.
Kling Lip Sync
يتفوّق Kling Lip Sync من Kwaivgi في معالجة الفيديو ذي حركات الرأس المعقدة. تعاني نماذج كثيرة لمزامنة الشفاه حين يلتفت الشخص جانبيًا أو يتحرك بشكل ملحوظ أثناء الكلام. يحافظ Kling على دقة موضع الشفاه حتى مع دوران معتدل للرأس، ما يجعله أكثر متانة لفيديوهات الشخصيات ذات الطابع الحركي أو الشخصيات المتحركة التي لا تبقى ثابتة تمامًا.
Fabric 1.0 من Veed
تم تحسين Fabric 1.0 لجعل الصور الثابتة تتحدث. إذا كان لديك بورتريه لشخصية أو شخصية تاريخية أو أفاتار مرسوم، ينشئ Fabric تحريكًا طبيعيًا للكلام مباشرة من الصورة دون الحاجة إلى فيديو مصدر. ويتناسب جيدًا مع أدوات تحويل النص إلى كلام لبناء سير عمل صوتي للشخصية مولَّد بالكامل بالذكاء الاصطناعي.
كيف تجعل شخصية تتحدث بأي لغة
استخدام HeyGen Video Translate على PicassoIA هو أكثر الطرق وضوحًا للدبلجة متعددة اللغات للشخصيات. إليك طريقة عمل العملية بالتفصيل.
الخطوة 1: جهّز فيديو المصدر
يحتاج فيديو المصدر إلى استيفاء بعض الشروط للحصول على أفضل النتائج:
- يجب أن يكون وجه الشخصية ظاهرًا بوضوح لمدة 80% على الأقل من اللقطة
- تجنّب القطع السريعة أو ضبابية الحركة الشديدة أثناء الكلام
- يجب أن يكون الصوت نظيفًا، مع هيمنة واضحة للصوت الرئيسي في المزج
- يمنح ما بين 5 و10 ثوانٍ من لقطات الكلام النموذجَ بيانات كافية للمعايرة
لا تحتاج إلى تسجيل في استوديو مُضاء بشكل مثالي. يكفي إضاءة جيدة ومسار صوتي واضح بدرجة معقولة. أما الباقي فيتولاه النموذج.
💡 Tip: إذا كانت شخصيتك تملك تعليقًا صوتيًا موجودًا بالإنجليزية، فاستخدمه كمصدر. كلما كان الصوت بلغة المصدر أنظف، استطاع النموذج إعادة بناء خريطة الفونيمات للغة الهدف بدقة أكبر.
الخطوة 2: اختر لغة الهدف
يدعم HeyGen Video Translate أكثر من 150 لغة، من بينها الإسبانية والفرنسية والألمانية واليابانية والكورية والماندرين والعربية والهندية والبرتغالية والإيطالية، وعشرات غيرها. واجهة الاختيار بسيطة: تختار لغة المصدر ولغة الهدف، ويتولى النموذج الترجمة وتوليف الصوت ومزامنة الشفاه تلقائيًا.
بالنسبة إلى اللغات ذات بنية الفونيمات المختلفة كثيرًا عن لغة المصدر (مثلًا من الإنجليزية إلى العربية أو اليابانية)، امنح النموذج بضع ثوانٍ إضافية لكل دقيقة من المعالجة. فإعادة ربط الفونيمات أثقل حسابيًا عندما تشترك اللغتان في أصوات أقل.
الخطوة 3: راجع وصدّر
بعد اكتمال المعالجة، راجع المخرجات مع التركيز على ثلاثة جوانب محددة:
- الفونيمات الحرجة: تحقق من الكلمات الغنية بالحروف المتحركة والكلمات التي تنتهي بتجمعات صامتة. هنا تظهر الانحرافات على الأرجح.
- الاتساق العاطفي: هل ما زالت الشخصية تبدو وتظهر منخرطة، أم أن النسخة المدبلجة سطّحت الأداء؟
- التوقيت عند الوقفات: يجب أن تبدو الوقفات الطبيعية بين الجمل طبيعية في النسخة المدبلجة. إذا بدت مستعجلة أو مُمدّدة، فهذه علامة على أن نقل الـ prosody يحتاج إلى تعديل.
لا تحتاج معظم النتائج إلى أي تصحيحات على الإطلاق. وعند الحاجة إلى تصحيحات، تقتصر عادةً على عبارة أو عبارتين محددتين يمكن إعادة معالجتهما على حدة.
3 أمور تصنع نتيجتك أو تُفسدها
يتولى النموذج العمل الشاق، لكن ثلاثة عوامل من جهتك لها تأثير كبير على جودة المخرجات.
وضوح الصوت
هذا هو المتغير الأكبر على الإطلاق. فموسيقى الخلفية أو ضجيج المحيط أو الصدى في الصوت المصدر تجبر النموذج على بذل جهد أكبر لعزل إشارة الكلام. المصدر المشوّش ينتج استخلاصًا مشوّشًا للفونيمات، وهذا بدوره ينتج حركات شفاه غير دقيقة. استخدم دائمًا أنظف مسار صوتي ممكن كمصدر، حتى لو تطلّب ذلك تنظيفًا سريعًا قبل الرفع.
ظهور الوجه
يحتاج نموذج مزامنة الشفاه إلى رؤية فم الشخصية بوضوح. فالحجب الجزئي بالأيدي أو الأشياء في المقدمة أو الزوايا الجانبية الحادة يُضعف الدقة بشكل ملحوظ. اللقطات التي تواجه فيها الشخصية الكاميرا بزاوية بين 0 و45 درجة تنتج أفضل النتائج. وبعد 45 درجة من الدوران، تبدأ معظم النماذج في تقريب مواضع الشفاه بدلًا من حسابها بدقة.
وتيرة الكلام
الكلام السريع جدًا ينتج تسلسلات فونيمية مضغوطة يصعب إعادة ربطها بدقة. إذا كانت شخصيتك تتحدث بوتيرة طبيعية ومدروسة، يتوفر للنموذج مساحة زمنية أوسع للعمل، فيُنتج نتائج أنظف. وينطبق هذا بشكل خاص عند الانتقال إلى لغات مثل الألمانية أو الفرنسية، حيث تكون الكلمات أطول صوتيًا عادةً من مقابلاتها الإنجليزية.
من يستخدم هذا فعلًا
توسّعت حالات استخدام الدبلجة متعددة اللغات للشخصيات بالذكاء الاصطناعي إلى ما هو أبعد بكثير مما يتوقعه معظم الناس في البداية.
محرّكو الرسوم المتحركة ومصمّمو الشخصيات
يمكن للرسّامين المستقلين اليوم إنشاء نسخة رئيسية واحدة من شخصيتهم وإطلاق نسخ مُعرَّبة للجمهور الإسباني أو الفرنسي أو الياباني دون التعاقد مع ممثل صوتي لكل لغة. سير العمل الذي كان يتطلب ميزانية إنتاج منفصلة لكل لغة صار اليوم تصديرًا بالجملة.
صنّاع YouTube الطامحون إلى العالمية
تستخدم القنوات المركّزة على الشروحات أو التعليق أو سرد القصص بالشخصيات دبلجة الذكاء الاصطناعي لنشر محتواها بلغات متعددة في الوقت نفسه. فبدلًا من انتظار إضافة الترجمات يدويًا، تنشر النسخ المدبلجة في اليوم نفسه للنسخة الأصلية. الوصول متعدد اللغات دون وقت تسجيل إضافي ميزة تنافسية كبيرة للقنوات الصاعدة.
المعلّمون ومنشئو الدورات
بدأت منصات الدورات الإلكترونية تشترط وجود نسخ متعددة اللغات من محتواها لخدمة جمهور عالمي. مكتبة دورات مدتها 3 ساعات كانت ستكلّف عشرات الآلاف من الدولارات لدبلجتها باحترافية يمكن معالجتها اليوم خلال ساعات. يتولى الذكاء الاصطناعي الترجمة والتوليف ومزامنة الشفاه، ويراجع المدرب المخرجات وينشرها.
💡 Tip: بالنسبة إلى المحتوى التعليمي، اعرض النسخة المدبلجة على متحدث أصلي باللغة الهدف قبل النشر. ترجمة الذكاء الاصطناعي دقيقة للغاية، لكنها تنتج أحيانًا صياغات صحيحة تقنيًا وغريبة سياقيًا.
ماذا يمكنك أن تبني الآن
الأدوات الموصوفة في هذا المقال متاحة كلها على PicassoIA اليوم. لا تحتاج إلى استوديو إنتاج أو فريق دبلجة أو ميزانية توطين بستة أرقام. تحتاج إلى فيديو، ومسار صوتي أو حوار مصدر، وبضع دقائق.
يستطيع نموذج Omni Human 1.5 تحويل صورة فوتوغرافية واحدة لشخصيتك إلى وجه متحدث ومتحرك. ويمكن لـ HeyGen Video Translate أخذ ذلك الفيديو وإنتاج نسخ بأكثر من 150 لغة. ويضمن Sync Lipsync 2 Pro أن يقع كل فونيم في موضعه الصحيح. ويتعامل Kling Lip Sync مع الشخصيات التي تتحرك داخل الإطار. ويتعامل Fabric 1.0 مع الشخصيات التي لا تظهر إلا كبورتريه.
سير العمل الكامل لجعل أي شخصية تتحدث بأي لغة مع مزامنة شفاه دقيقة متاح الآن. اختر شخصية، واختر لغة، وارفع إلى PicassoIA، وشاهد ما تنتجه التقنية فعلًا. ستغيّر النتائج طريقة تفكيرك في إنتاج المحتوى متعدد اللغات.
توجّه إلى PicassoIA وجرّب نماذج مزامنة الشفاه اليوم. الشخصية التي كنت تبنيها تستحق أن تُسمع بكل لغة.


