Imaginez que vous ayez passé des semaines à construire un personnage, à animer chaque expression et à peaufiner son histoire, pour finir par vous heurter à un mur le jour où quelqu’un demande : « Peut-il parler espagnol ? » ou « Pouvez-vous ajouter une version japonaise ? » Ce mur impliquait autrefois de faire appel à des studios de doublage professionnels, à des comédiens de doublage et à des animateurs spécialisés dans la synchronisation labiale. Aujourd’hui, l’IA a réduit toute cette chaîne à un simple import. Vous pouvez faire parler un personnage dans n’importe quelle langue avec l’IA en quelques minutes, avec des lèvres synchronisées, une intonation naturelle et zéro heure de studio.
Ce n’est pas un gadget. Les résultats produits par des modèles comme HeyGen Video Translate, Omni Human 1.5 et Sync Lipsync 2 Pro sont déjà utilisés dans de vraies productions, sur de vraies chaînes YouTube et sur de vraies plateformes éducatives. La technologie a franchi le seuil où le rendu est assez convaincant pour être réellement mis en ligne.
Ce que fait réellement le lipsync par IA
La plupart des gens pensent que le doublage par IA consiste simplement à remplacer la piste audio. Ce n’est pas le cas. Si l’on se contente de changer l’audio, la bouche continue de bouger sur les mauvais mots, ce qui donne un résultat désastreux. Le lipsync par IA repose sur trois processus simultanés : la synthèse vocale dans la langue cible, l’extraction des phonèmes à partir de ce nouvel audio, et le reciblage de l’animation faciale, qui repositionne la bouche, la mâchoire et les muscles du visage environnants pour correspondre à ces phonèmes image par image.
Comment fonctionne la correspondance des phonèmes
Un phonème est la plus petite unité sonore de la parole. Le mot « chat » compte deux phonèmes : /ʃ/, /a/. Chaque langue possède son propre inventaire de phonèmes. L’espagnol a des voyelles différentes de celles de l’anglais. L’arabe contient des sons qui n’existent pas du tout dans les langues romanes.
Les modèles de lipsync par IA sont entraînés sur d’immenses jeux de données associant la parole humaine à des vidéos haute vitesse de bouches prononçant ces sons. Lorsque vous fournissez au modèle une piste audio cible, il extrait la séquence de phonèmes et associe chaque son à la forme de bouche correspondante, appelée visème. Il fusionne ensuite ces visèmes d’une image à l’autre, avec un rythme qui reproduit celui de la parole humaine naturelle.
Pourquoi le résultat sonne désormais naturel
Les premiers doublages par IA donnaient des résultats robotiques, car les modèles étaient entraînés sur une parole enregistrée en studio, dans des conditions silencieuses. Ils peinaient à reproduire le rythme naturel de la parole, où les mots se fondent les uns dans les autres, où les voyelles s’affaiblissent et où l’accent tonique change selon la position dans la phrase.
Les modèles actuels sont entraînés sur de la parole conversationnelle dans des dizaines de langues, avec une augmentation des données qui simule des conditions audio réelles. Le résultat est une parole doublée qui porte une prosodie naturelle, c’est-à-dire les hausses et baisses de hauteur et de vitesse qui donnent à la voix une impression humaine plutôt que synthétique.
💡 Astuce : La qualité de votre audio source influence directement la précision du lipsync. Un audio propre, avec peu de bruit de fond, produit des mouvements de lèvres nettement plus précis.
Le coût réel du doublage traditionnel
Avant l’IA, la production d’une version multilingue d’un personnage de vidéo nécessitait une chaîne de production complète. Voici ce que cela impliquait, comparé à ce que l’IA permet aujourd’hui :
| Critère | Doublage traditionnel | Lipsync par IA |
|---|
| Délai de livraison | 2 à 6 semaines | Quelques minutes à quelques heures |
| Coût par minute | 500 $ à 3 000 $ et plus | Une fraction de centime |
| Langues prises en charge | Limitées par la disponibilité des comédiens | 100 à 150 et plus |
| Qualité du lipsync | Animation manuelle image par image | Correspondance automatique des phonèmes |
| Évolutivité | Limitée par la capacité du studio | Traitement parallèle illimité |
| Vitesse de révision | Plusieurs jours par modification | Quelques secondes par nouveau rendu |
Les considérations économiques à elles seules expliquent pourquoi les créateurs de contenu, les studios de jeux vidéo et les éducateurs adoptent le lipsync par IA à un rythme toujours plus rapide. La qualité technique a franchi le seuil de viabilité commerciale, et l’écart de coût n’est pas marginal. Il représente un ordre de grandeur.
Les meilleurs modèles d’IA pour les personnages multilingues
Tous les modèles de lipsync ne gèrent pas les cas d’usage de la même manière. Certains sont optimisés pour des visages réels dans une vidéo. D’autres fonctionnent à partir d’une seule photographie. Voici les options les plus performantes disponibles aujourd’hui.
HeyGen Video Translate
HeyGen Video Translate est le modèle vers lequel la plupart des gens se tournent lorsqu’ils ont besoin d’une large couverture linguistique. Il prend en charge plus de 150 langues et gère à la fois la traduction et le lipsync dans un seul flux de travail. Vous importez une vidéo, sélectionnez la langue cible, et le modèle produit une version avec des mouvements de lèvres synchronisés et une parole traduite.
Sa force réside notamment dans le transfert prosodique : le ton émotionnel de l’intervenant d’origine se retrouve dans la version doublée. Un personnage qui paraît enthousiaste en anglais garde cet enthousiasme en portugais, sans sonner plat ni mécanique.
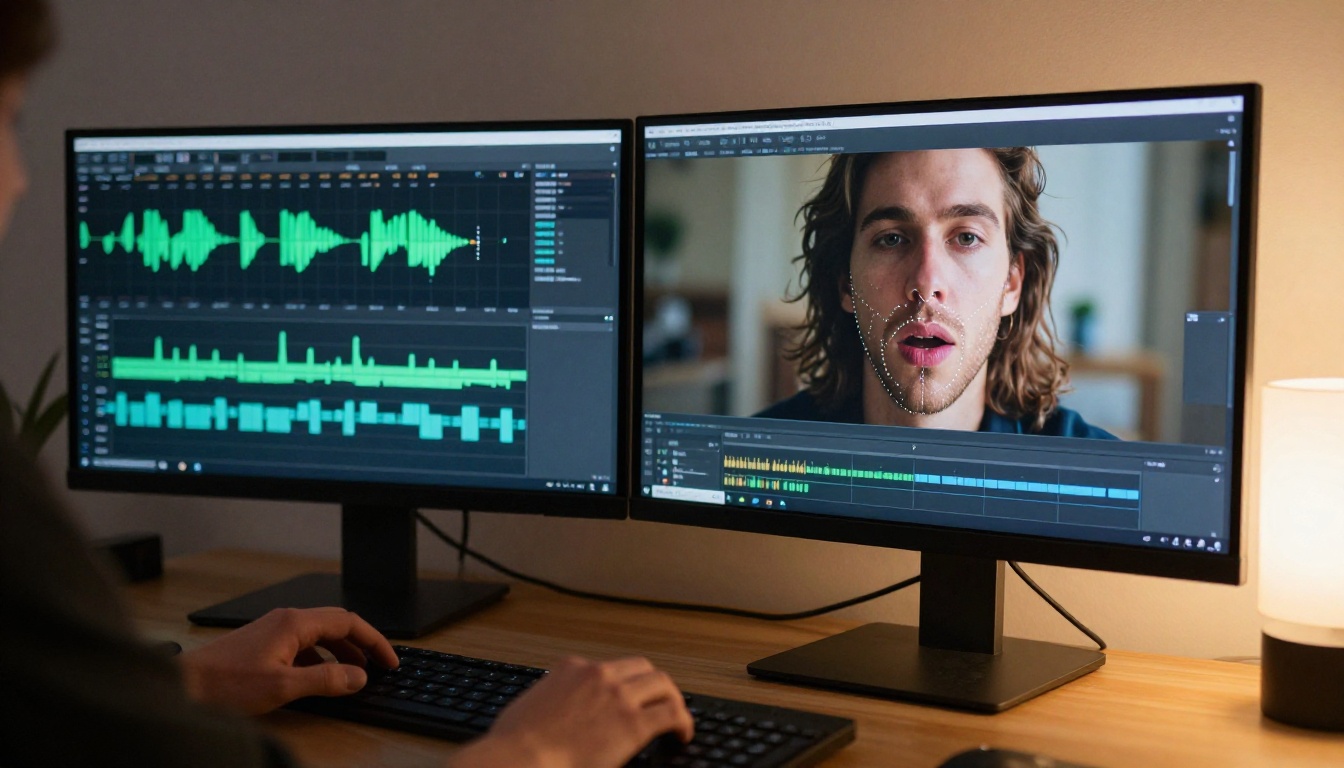
HeyGen Lipsync Precision et Lipsync Speed
Lorsque vous disposez déjà d’une piste audio traduite et que vous avez seulement besoin d’aligner les lèvres, Lipsync Precision et Lipsync Speed proposent des solutions ciblées. Precision privilégie la précision, en travaillant image par image avec un ajustement fin du visage. Speed est optimisé pour une livraison rapide lorsque vous traitez de gros volumes de contenu.
La distinction compte selon votre chaîne de production. Pour une vidéo phare soignée, Precision vaut le temps de traitement supplémentaire. Pour le doublage par lots d’une bibliothèque de cours en cinq langues, Speed vous permet d’y arriver sans goulot d’étranglement.
Omni Human 1.5 de ByteDance
Omni Human 1.5 de ByteDance adopte une approche différente. Plutôt que de traiter une vidéo existante, il peut animer une seule photographie pour en faire une vidéo complète de personnage qui parle, avec des mouvements naturels de la tête, des clignements et une synchronisation labiale. Vous fournissez une image fixe du personnage et un fichier audio, et il produit une version parlante convaincante.
C’est particulièrement utile pour les personnages qui n’existent que sous forme d’illustrations, de concept art ou de portraits. Vous n’êtes pas limité aux séquences vidéo d’une personne réelle qui parle.
Sync Lipsync 2 Pro
Sync Lipsync 2 Pro est conçu spécialement pour le défi consistant à faire correspondre un audio préexistant à une vidéo avec une fidélité maximale. Il gère un alignement serré entre phonèmes et visèmes et se distingue particulièrement avec les voix de personnages au timbre ou au style d’élocution inhabituels.
Son modèle complémentaire, Sync Lipsync 2, traite des cas plus simples et s’exécute plus rapidement, ce qui le rend utile comme première passe avant de finaliser avec la version Pro.
Kling Lip Sync
Kling Lip Sync de Kwaivgi excelle dans le traitement de vidéos avec des mouvements de tête complexes. De nombreux modèles de lipsync peinent lorsque le sujet se tourne de côté ou bouge beaucoup en parlant. Kling conserve un positionnement précis des lèvres, même avec une rotation modérée de la tête, ce qui le rend plus robuste pour les vidéos de personnages en mouvement ou les sujets animés qui ne restent pas parfaitement immobiles.
Fabric 1.0 de Veed
Fabric 1.0 est optimisé pour faire parler des photos fixes. Si vous disposez d’un portrait de personnage, d’une figure historique ou d’un avatar illustré, Fabric génère une animation de parole naturelle directement à partir de l’image, sans vidéo source. Il se combine bien avec des outils de synthèse vocale pour un flux audio de personnage entièrement généré par IA.
Utiliser HeyGen Video Translate sur PicassoIA est la voie la plus simple pour le doublage multilingue de personnages. Voici exactement comment se déroule le processus.
Étape 1 : préparez votre vidéo source
Votre vidéo source doit respecter quelques conditions pour obtenir les meilleurs résultats :
- Le visage du personnage doit être clairement visible pendant au moins 80 % du plan
- Évitez les coupes rapides et le flou de bougé important pendant la parole
- L’audio doit être propre, la voix principale étant nettement dominante dans le mixage
- Au minimum 5 à 10 secondes de séquences où le personnage parle permettent au modèle de se calibrer
Vous n’avez pas besoin d’un enregistrement en studio parfaitement éclairé. Un éclairage correct et une piste audio raisonnablement claire suffisent. Le modèle se charge du reste.
💡 Astuce : si votre personnage dispose d’une voix off en anglais, utilisez-la comme source. Plus l’audio de la langue source est propre, plus le modèle peut reconstruire avec précision la correspondance des phonèmes pour la langue cible.
Étape 2 : choisissez la langue cible
HeyGen Video Translate prend en charge plus de 150 langues, dont l’espagnol, le français, l’allemand, le japonais, le coréen, le mandarin, l’arabe, l’hindi, le portugais, l’italien, et des dizaines d’autres. L’interface de sélection est simple : choisissez votre langue source, choisissez votre langue cible, et le modèle gère automatiquement la traduction, la synthèse vocale et la synchronisation labiale.
Pour les langues dont la structure phonétique diffère beaucoup de votre source (par exemple, de l’anglais vers l’arabe ou le japonais), accordez au modèle quelques secondes supplémentaires par minute de traitement. La réattribution des phonèmes demande davantage de calcul lorsque les deux langues partagent moins de sons.
Étape 3 : vérifiez et exportez
Une fois le traitement terminé, examinez le résultat en vous concentrant sur trois points précis :
- Phonèmes critiques : vérifiez les mots riches en voyelles et ceux qui se terminent par des groupes de consonnes. Ce sont les endroits où les décalages risquent le plus d’apparaître.
- Cohérence émotionnelle : le personnage semble-t-il toujours engagé, ou la version doublée a-t-elle aplati l’interprétation ?
- Timing des pauses : les pauses naturelles entre les phrases doivent rester naturelles dans la version doublée. Si elles paraissent précipitées ou étirées, c’est le signe que le transfert prosodique doit être ajusté.
La plupart des résultats ne nécessitent aucune correction. Lorsque des corrections sont nécessaires, elles concernent généralement une ou deux phrases précises, qui peuvent être retraitées individuellement.
3 éléments qui font ou défont votre résultat
Le modèle fait le plus gros du travail, mais trois facteurs de votre côté ont un effet disproportionné sur la qualité du rendu.
Clarté audio
C’est la variable la plus importante. La musique de fond, le bruit ambiant ou la réverbération dans l’audio source obligent le modèle à travailler davantage pour isoler le signal de la parole. Une source bruyante produit une extraction de phonèmes bruitée, qui à son tour donne des mouvements de lèvres imprécis. Utilisez toujours la piste audio la plus propre possible comme source, quitte à effectuer un rapide nettoyage avant l’import.
Visibilité du visage
Le modèle de lipsync doit voir clairement la bouche du personnage. Une occlusion partielle par des mains, des objets au premier plan ou des angles latéraux extrêmes dégrade sensiblement la précision. Les plans où le personnage fait face à la caméra avec un angle compris entre 0 et 45 degrés donnent les meilleurs résultats. Au-delà de 45 degrés de rotation, la plupart des modèles commencent à approximer plutôt qu’à calculer précisément la position des lèvres.
Rythme de parole
Une parole très rapide produit des séquences de phonèmes compressées, plus difficiles à réattribuer avec précision. Si votre personnage parle à un rythme naturel et mesuré, le modèle dispose de plus d’espace temporel pour travailler et produit des résultats plus propres. C’est particulièrement vrai pour les langues comme l’allemand ou le français, où les mots sont souvent phonétiquement plus longs que leurs équivalents anglais.
Qui utilise vraiment cette technologie
Les cas d’usage du doublage multilingue de personnages par IA ont largement dépassé ce que la plupart des gens imaginent au départ.
Animateurs et créateurs de personnages
Les animateurs indépendants peuvent désormais créer une version maîtresse de leur personnage et décliner des versions localisées pour des publics espagnols, français ou japonais, sans faire appel à des comédiens pour chaque langue. Le flux de travail qui exigeait autrefois un budget de production distinct pour chaque langue se résume désormais à un export par lots.
Les YouTubeurs qui s’ouvrent à l’international
Les chaînes consacrées aux tutoriels, aux commentaires ou aux récits de personnages utilisent le doublage par IA pour publier simultanément dans plusieurs langues. Plutôt que d’attendre l’ajout manuel de sous-titres, elles mettent en ligne les versions doublées le jour même de l’original. Une portée multilingue sans temps d’enregistrement supplémentaire constitue un avantage concurrentiel majeur pour les chaînes en croissance.
Éducateurs et créateurs de cours
Les plateformes de cours en ligne ont commencé à exiger des versions multilingues de leurs contenus pour toucher un public mondial. Une bibliothèque de cours de 3 heures qui aurait coûté des dizaines de milliers de dollars en doublage professionnel peut désormais être traitée en quelques heures. L’IA gère la traduction, la synthèse et le lipsync. L’intervenant examine le résultat, puis le publie.
💡 Astuce : pour les contenus éducatifs, faites relire la version doublée par un locuteur natif de la langue cible avant publication. La traduction par IA est très précise, mais elle produit parfois des formulations techniquement correctes mais maladroites dans leur contexte.
Ce que vous pouvez créer dès maintenant
Les outils présentés dans cet article sont tous disponibles sur PicassoIA dès aujourd’hui. Vous n’avez besoin ni d’un studio de production, ni d’une équipe de doublage, ni d’un budget de localisation à six chiffres. Il vous suffit d’une vidéo, d’une piste audio ou d’un dialogue source, et de quelques minutes.
Omni Human 1.5 peut transformer une seule photographie de votre personnage en un visage animé qui parle. HeyGen Video Translate peut prendre cette vidéo et produire des versions en plus de 150 langues. Sync Lipsync 2 Pro veille à ce que chaque phonème tombe exactement au bon endroit. Kling Lip Sync gère les personnages qui se déplacent dans le cadre. Fabric 1.0 gère les personnages qui ne sont qu’un portrait.
Le processus complet pour faire parler n’importe quel personnage dans n’importe quelle langue avec un lipsync précis est disponible dès maintenant. Choisissez un personnage, choisissez une langue, importez le tout sur PicassoIA et découvrez ce que la technologie produit réellement. Les résultats changeront votre façon de penser la création de contenu multilingue.
Rendez-vous sur PicassoIA et essayez dès aujourd’hui les modèles de lipsync. Le personnage que vous avez construit mérite d’être entendu dans toutes les langues.


