Imagina que has pasado semanas creando un personaje, animando cada expresión y perfeccionando su historia, solo para chocar con un muro en cuanto alguien pregunta "¿puede hablar español?" o "¿puedes añadir una versión en japonés?". Ese muro solía significar contratar estudios de doblaje profesionales, actores de voz y animadores de sincronización labial. Hoy, la IA ha reducido todo ese proceso a una sola subida de archivo. Puedes hacer que un personaje hable en cualquier idioma con IA en minutos, con los labios sincronizados, entonación natural y sin tiempo de estudio.
Esto no es un truco. Los resultados que salen de modelos como HeyGen Video Translate, Omni Human 1.5 y Sync Lipsync 2 Pro ya se usan en producciones reales, en canales reales de YouTube y en plataformas educativas reales. La tecnología ha superado el umbral en el que el resultado es lo bastante convincente como para publicarlo.
Qué hace realmente la sincronización labial con IA
La mayoría de la gente piensa que el doblaje con IA consiste solo en cambiar el audio. No es así. Si solo cambias el audio, la boca seguirá moviéndose al ritmo de las palabras equivocadas, y eso se ve fatal. La sincronización labial real con IA combina tres procesos simultáneos: síntesis de voz en el idioma de destino, extracción de fonemas a partir de ese nuevo audio y retargeting de la animación facial, que recoloca la boca, la mandíbula y los músculos faciales de alrededor para que coincidan con esos fonemas, fotograma a fotograma.
Cómo funciona el mapeo de fonemas
Un fonema es la unidad de sonido más pequeña del habla. La palabra "cat" tiene tres fonemas: /k/, /æ/, /t/. Cada idioma tiene su propio inventario de fonemas. El español tiene sonidos vocálicos distintos del inglés. El árabe tiene sonidos que no existen en absoluto en las lenguas romances.
Los modelos de sincronización labial con IA se entrenan con enormes conjuntos de datos de habla humana emparejada con videos de alta velocidad de bocas pronunciando esos sonidos. Cuando le das al modelo una pista de audio de destino, extrae la secuencia de fonemas y asocia cada sonido con la forma de boca correspondiente, llamada visema. Después mezcla esos visemas entre fotogramas con una temporización que coincide con los patrones naturales del habla humana.
Por qué ahora suena natural
El doblaje temprano con IA producía resultados robóticos porque los modelos se entrenaban con voz grabada en estudio y en condiciones silenciosas. Les costaba reproducir el ritmo natural del habla, donde las palabras se funden, las vocales se reducen y el énfasis cambia según la posición de la frase.
Los modelos actuales se entrenan con habla conversacional en decenas de idiomas, con aumento de datos que simula condiciones de audio del mundo real. El resultado es un habla doblada que conserva una prosodia natural, es decir, las subidas y bajadas de tono y velocidad que hacen que la voz suene humana y no sintetizada.
💡 Consejo: La calidad del audio original afecta directamente a la precisión de la sincronización labial. Un audio limpio, con poco ruido de fondo, produce movimientos de labios notablemente más nítidos.
El costo real del doblaje tradicional
Antes de la IA, producir una versión multilingüe de un personaje de video requería un proceso de producción completo. Esto es lo que suponía, comparado con lo que la IA hace posible hoy:
| Factor | Doblaje tradicional | Sincronización labial con IA |
|---|
| Tiempo de entrega | De 2 a 6 semanas | De minutos a horas |
| Costo por minuto | De $500 a $3,000+ | Fracciones de centavo |
| Idiomas disponibles | Limitados por la disponibilidad de talento | De 100 a 150+ |
| Calidad de sincronización labial | Animación manual fotograma a fotograma | Coincidencia automática de fonemas |
| Escalabilidad | Limitada por la capacidad del estudio | Procesamiento paralelo ilimitado |
| Velocidad de revisión | Días por cambio | Segundos por nuevo render |
Solo la economía explica por qué los creadores de contenido, los estudios de videojuegos y los educadores adoptan la sincronización labial con IA a un ritmo cada vez mayor. La calidad técnica ha superado el umbral en el que es viable comercialmente, y la diferencia de costo no es marginal. Es de un orden de magnitud.
Los mejores modelos de IA para personajes multilingües
No todos los modelos de sincronización labial manejan cada caso de uso por igual. Algunos están optimizados para rostros reales en video. Otros trabajan a partir de una sola fotografía. Estas son las opciones más capaces disponibles ahora mismo.
HeyGen Video Translate
HeyGen Video Translate es el modelo al que más gente recurre cuando necesita una cobertura amplia de idiomas. Admite más de 150 idiomas y gestiona tanto la traducción como la sincronización labial en un solo flujo de trabajo. Subes un video, eliges un idioma de destino y el modelo produce una versión con movimientos de labios sincronizados y habla traducida.
Lo que lo hace especialmente bueno es su manejo de la transferencia prosódica, es decir, que el tono emocional del hablante original pasa a la versión doblada. Un personaje que suena entusiasmado en inglés suena entusiasmado en portugués, no plano ni mecánico.
HeyGen Lipsync Precision y Lipsync Speed
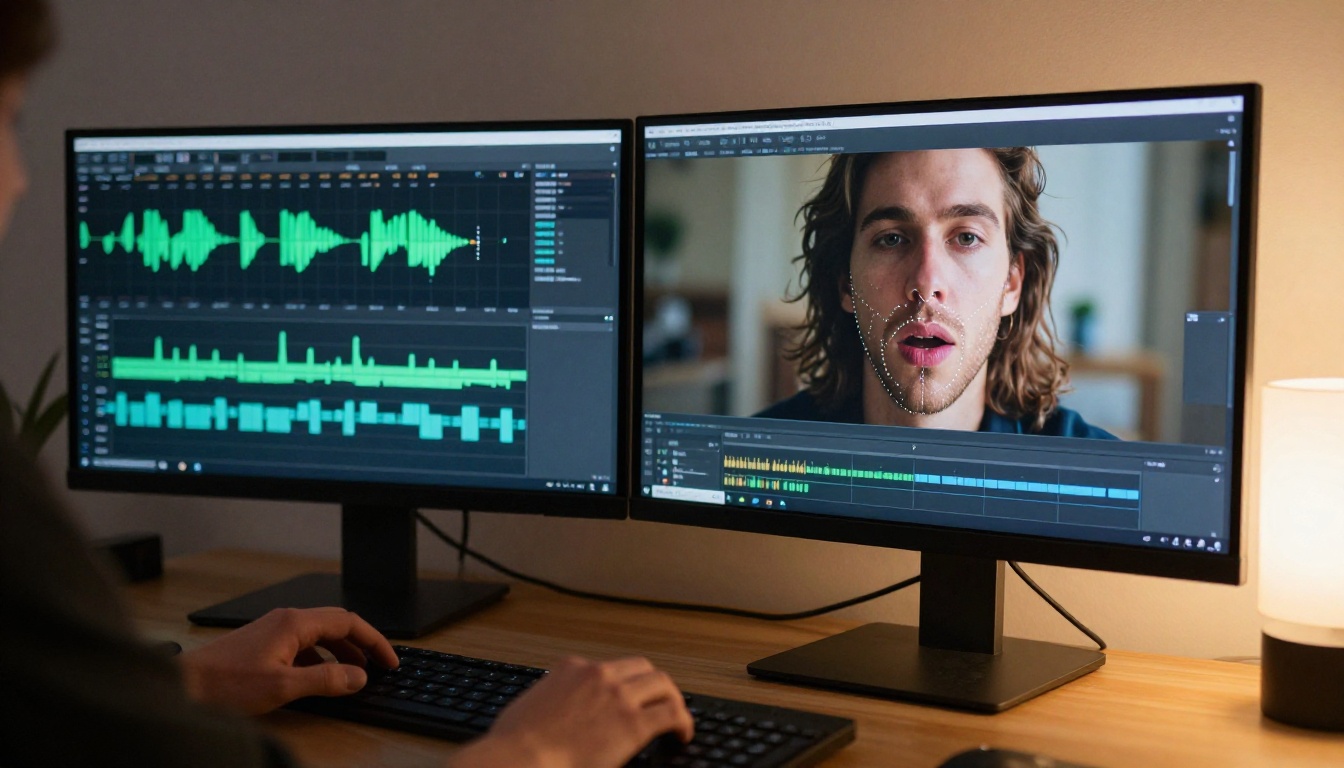
Para los casos en los que ya tienes una pista de audio traducida y solo necesitas que los labios coincidan, Lipsync Precision y Lipsync Speed ofrecen soluciones específicas. Precision prioriza la exactitud, trabajando fotograma a fotograma con un ajuste facial muy fino. Speed está optimizado para entregas rápidas cuando procesas grandes volúmenes de contenido.
La diferencia importa según tu flujo de trabajo. Para un video principal muy pulido, Precision merece el tiempo de procesamiento extra. Para doblar en lote una biblioteca de cursos a cinco idiomas, Speed te lleva hasta allí sin cuellos de botella.
Omni Human 1.5 de ByteDance
Omni Human 1.5 de ByteDance adopta un enfoque distinto. En lugar de procesar video existente, puede animar una sola fotografía y convertirla en un video completo con la cabeza en movimiento natural, parpadeo y sincronización labial. Le das una imagen fija de un personaje y un archivo de audio, y produce una versión animada que habla y tiene un aspecto convincente.
Esto es especialmente potente para personajes que solo existen como ilustraciones, arte conceptual o retratos. No estás limitado a grabaciones de una persona real hablando.
Sync Lipsync 2 Pro
Sync Lipsync 2 Pro está creado específicamente para el reto de ajustar audio preexistente a un video con la máxima fidelidad. Maneja una alineación precisa de fonemas y visemas y destaca especialmente cuando trabaja con voces de personajes con timbres o estilos de habla poco habituales.
Su modelo complementario, Sync Lipsync 2, cubre casos más sencillos y procesa más rápido, lo que lo hace útil como primera pasada antes de terminar con la versión Pro.
Kling Lip Sync
Kling Lip Sync de Kwaivgi destaca al procesar video con movimientos complejos de cabeza. Muchos modelos de sincronización labial tienen problemas cuando el sujeto gira hacia un lado o se mueve mucho mientras habla. Kling mantiene la posición de los labios con precisión incluso con una rotación moderada de la cabeza, lo que lo hace más robusto para videos de personajes de acción o sujetos animados que no permanecen completamente quietos.
Fabric 1.0 de Veed
Fabric 1.0 está optimizado para hacer que las fotos estáticas hablen. Si tienes un retrato de un personaje, una figura histórica o un avatar ilustrado, Fabric genera una animación de habla de aspecto natural directamente a partir de la imagen, sin necesidad de video de origen. Combina bien con herramientas de texto a voz para tener un flujo de audio de personaje totalmente generado por IA.
Cómo hacer que un personaje hable en cualquier idioma
Usar HeyGen Video Translate en PicassoIA es la vía más directa para el doblaje multilingüe de personajes. Así funciona el proceso, paso a paso.
Paso 1: prepara tu video de origen
Tu video de origen debe cumplir algunas condiciones para obtener los mejores resultados:
- El rostro del personaje debe verse con claridad durante al menos el 80% del plano
- Evita los cortes rápidos o el desenfoque por movimiento intenso mientras habla
- El audio debe estar limpio, con la voz principal claramente dominante en la mezcla
- Un mínimo de 5 a 10 segundos de metraje hablando da al modelo datos suficientes para calibrarse
No necesitas una grabación de estudio con iluminación perfecta. Una iluminación decente y una pista de audio razonablemente clara bastan. El modelo se encarga del resto.
💡 Consejo: Si tu personaje tiene una locución en inglés, úsala como origen. Cuanto más limpio sea el audio del idioma original, con más precisión podrá el modelo reconstruir el mapa de fonemas para el idioma de destino.
Paso 2: elige el idioma de destino
HeyGen Video Translate admite más de 150 idiomas, entre ellos español, francés, alemán, japonés, coreano, mandarín, árabe, hindi, portugués, italiano, y decenas más. La interfaz de selección es sencilla: elige el idioma de origen, elige el idioma de destino, y el modelo se encarga automáticamente de la traducción, la síntesis de voz y la sincronización labial.
Para los idiomas con estructuras fonéticas muy distintas a la de tu origen (por ejemplo, pasar del inglés al árabe o al japonés), dale al modelo unos segundos extra de procesamiento por cada minuto. El reajuste de fonemas exige más cálculo cuando los dos idiomas comparten menos sonidos.
Paso 3: revisa y exporta
Cuando termine el procesamiento, revisa el resultado con atención a tres aspectos concretos:
- Fonemas críticos: revisa las palabras con muchas vocales y las que terminan en grupos de consonantes. Ahí es donde es más probable que aparezcan desajustes.
- Coherencia emocional: ¿el personaje sigue sonando y pareciendo implicado, o la versión doblada ha aplanado la interpretación?
- Temporización de las pausas: las pausas naturales entre frases deben seguir resultando naturales en la versión doblada. Si parecen apresuradas o estiradas, es señal de que la transferencia prosódica necesita un ajuste.
La mayoría de los resultados no requieren ninguna corrección. Cuando hacen falta correcciones, suelen limitarse a una o dos frases concretas que pueden volver a procesarse por separado.
3 cosas que deciden el éxito o el fracaso de tu resultado
El modelo hace el trabajo pesado, pero tres factores de tu lado tienen un efecto desproporcionado en la calidad del resultado.
Claridad del audio
Es la variable más importante. La música de fondo, el ruido ambiente o la reverberación en el audio de origen obligan al modelo a esforzarse más para aislar la señal de voz. Un origen ruidoso produce una extracción de fonemas ruidosa, y eso da movimientos de labios imprecisos. Usa siempre la pista de audio más limpia posible como origen, aunque eso implique hacer una limpieza rápida antes de subirla.
Visibilidad del rostro
El modelo de sincronización labial necesita ver la boca del personaje con claridad. Las oclusiones parciales por manos, objetos en primer plano o ángulos laterales extremos degradan mucho la precisión. Los planos en los que el personaje mira a cámara entre 0 y 45 grados producen los mejores resultados. Más allá de 45 grados de rotación, la mayoría de los modelos empiezan a aproximar en lugar de calcular con precisión la posición de los labios.
Ritmo al hablar
El habla muy rápida produce secuencias de fonemas comprimidas que son más difíciles de reajustar con precisión. Si tu personaje habla a un ritmo natural y medido, el modelo tiene más espacio temporal con el que trabajar y produce resultados más limpios. Esto es especialmente cierto cuando se pasa a idiomas como el alemán o el francés, donde las palabras suelen ser fonéticamente más largas que sus equivalentes en inglés.
Quién lo usa de verdad
Los casos de uso del doblaje multilingüe de personajes con IA se han ampliado mucho más allá de lo que la mayoría esperaba al principio.
Animadores y creadores de personajes
Los animadores independientes ya pueden crear una única versión maestra de su personaje y preparar versiones localizadas para públicos en español, francés o japonés sin contratar talento de voz para cada idioma. El flujo de trabajo que antes exigía un presupuesto de producción aparte para cada idioma es ahora una exportación por lotes.
YouTubers que dan el salto internacional
Los canales centrados en tutoriales, comentarios o narrativa con personajes usan el doblaje con IA para publicar en varios idiomas a la vez. En lugar de esperar a que se añadan subtítulos a mano, publican las versiones dobladas el mismo día que el original. Llegar a más idiomas sin tiempo de grabación adicional es una ventaja competitiva importante para los canales en crecimiento.
Educadores y creadores de cursos
Las plataformas de cursos en línea han empezado a exigir versiones multilingües de sus contenidos para llegar a audiencias globales. Una biblioteca de cursos de 3 horas que habría costado decenas de miles de dólares doblar profesionalmente ahora puede procesarse en horas. La IA se encarga de la traducción, la síntesis y la sincronización labial. El instructor revisa el resultado y lo publica.
💡 Consejo: En el contenido educativo, haz que un hablante nativo del idioma de destino revise la versión doblada antes de publicarla. La traducción con IA es muy precisa, pero a veces produce frases técnicamente correctas que resultan incómodas en el contexto.
Lo que puedes crear ahora mismo
Las herramientas descritas en este artículo están disponibles hoy en PicassoIA. No necesitas un estudio de producción, un equipo de doblaje ni un presupuesto de localización de seis cifras. Necesitas un video, una pista de audio o diálogo de origen y unos minutos.
Omni Human 1.5 puede convertir una sola fotografía de tu personaje en un rostro animado que habla. HeyGen Video Translate puede tomar ese video y producir versiones en más de 150 idiomas. Sync Lipsync 2 Pro asegura que cada fonema caiga exactamente donde debe. Kling Lip Sync se encarga de los personajes que se mueven por el encuadre. Fabric 1.0 se encarga de los personajes que son solo un retrato.
El proceso completo para que cualquier personaje hable cualquier idioma con sincronización labial precisa está disponible ahora mismo. Elige un personaje, elige un idioma, sube el archivo a PicassoIA y mira lo que la tecnología produce de verdad. Los resultados cambiarán tu forma de pensar sobre la creación de contenido multilingüe.
Entra en PicassoIA y prueba hoy los modelos de sincronización labial. El personaje en el que llevas trabajando merece que se le oiga en todos los idiomas.


