सोचिए, आपने हफ़्तों तक एक कैरेक्टर बनाया, हर एक्सप्रेशन को एनिमेट किया, उसकी बैकस्टोरी को परफ़ेक्ट किया, और फिर जैसे ही कोई पूछता है "क्या यह स्पैनिश बोल सकता है?" या "क्या आप इसका जापानी वर्ज़न जोड़ सकते हैं?", आप रुक जाते हैं। पहले इस रुकावट का मतलब था प्रोफ़ेशनल डबिंग स्टूडियो, वॉइस एक्टर और लिप-सिंक एनिमेटर किराए पर लेना। आज AI ने वही पूरी प्रक्रिया एक अपलोड में समेट दी है। आप मिनटों में, सिंक्रनाइज़ होंठों, स्वाभाविक इंटोनेशन और बिना किसी स्टूडियो समय के, किसी भी भाषा में कैरेक्टर को बोलता हुआ बना सकते हैं।
यह कोई गिमिक नहीं है। HeyGen Video Translate, Omni Human 1.5 और Sync Lipsync 2 Pro जैसे मॉडलों के नतीजे अभी असली प्रोडक्शन, असली YouTube चैनलों और असली एजुकेशनल प्लेटफ़ॉर्मों में इस्तेमाल हो रहे हैं। यह तकनीक उस सीमा तक पहुँच चुकी है, जहाँ आउटपुट इतना विश्वसनीय है कि उसे सचमुच प्रकाशित किया जा सके।
AI लिपसिंक असल में क्या करता है
ज़्यादातर लोगों को लगता है कि AI डबिंग का मतलब बस ऑडियो बदलना है। ऐसा नहीं है। अगर आप सिर्फ़ ऑडियो बदलते हैं, तो मुँह गलत शब्दों पर चलता रहेगा, और वह बहुत बुरा लगेगा। असली AI लिपसिंक में तीन प्रक्रियाएँ एक साथ चलती हैं: टार्गेट भाषा में स्पीच सिंथेसिस, उस नए ऑडियो से फ़ोनीम एक्सट्रैक्शन, और फ़ेशियल एनिमेशन रीटार्गेटिंग जो हर फ़्रेम में उन फ़ोनीम से मेल खाने के लिए मुँह, जबड़े और आसपास की चेहरे की मांसपेशियों को फिर से व्यवस्थित करती है।
फ़ोनीम मैपिंग कैसे काम करती है
फ़ोनीम बोली में ध्वनि की सबसे छोटी इकाई है। शब्द "cat" में तीन फ़ोनीम हैं: /k/, /æ/, /t/। हर भाषा का अपना फ़ोनीम भंडार होता है। स्पैनिश में अंग्रेज़ी से अलग स्वर होते हैं। अरबी में कुछ ऐसी ध्वनियाँ हैं जो रोमांस भाषाओं में बिल्कुल नहीं मिलतीं।
AI लिपसिंक मॉडल इंसानी बोली की विशाल डेटासेट पर प्रशिक्षित होते हैं, जिन्हें उन ध्वनियों को बनाते मुँह की हाई-स्पीड वीडियो के साथ जोड़ा गया होता है। जब आप मॉडल को टार्गेट ऑडियो ट्रैक देते हैं, तो वह फ़ोनीम क्रम निकालता है और हर ध्वनि को उससे मेल खाते मुँह के आकार से जोड़ता है, जिसे वाइसीम कहते हैं। फिर वह इन वाइसीम को फ़्रेमों के पार ऐसे मिलाता है कि समय इंसानी बोलने के स्वाभाविक पैटर्न से मेल खाए।
अब यह स्वाभाविक क्यों लगता है
शुरुआती AI डबिंग के नतीजे रोबोटिक लगते थे, क्योंकि मॉडल शांत परिस्थितियों में स्टूडियो में रिकॉर्ड की गई बोली पर प्रशिक्षित होते थे। उन्हें बोली की स्वाभाविक लय में दिक्कत होती थी, जहाँ शब्द आपस में घुल जाते हैं, स्वर हल्के हो जाते हैं, और वाक्य में स्थिति के हिसाब से ज़ोर बदलता है।
आधुनिक मॉडल दर्जनों भाषाओं में बातचीत वाली बोली पर प्रशिक्षित होते हैं, साथ में डेटा ऑगमेंटेशन भी होता है जो असली दुनिया की ऑडियो परिस्थितियों की नकल करता है। नतीजा यह है कि डब की गई बोली में प्रोसोडी होती है, यानी पिच और रफ़्तार के वे उतार-चढ़ाव जो बोली को इंसानी और सिंथेसाइज़्ड से अलग बनाते हैं।
💡 टिप: आपके सोर्स ऑडियो की गुणवत्ता सीधे लिपसिंक की सटीकता पर असर डालती है। बैकग्राउंड शोर कम वाला साफ़ ऑडियो होंठों की हरकत को नज़र आने लायक़ रूप से ज़्यादा साफ़ और सटीक बनाता है।
पारंपरिक डबिंग की असली लागत
AI से पहले, किसी वीडियो कैरेक्टर का बहुभाषी वर्ज़न बनाने के लिए पूरी प्रोडक्शन प्रक्रिया चाहिए थी। आज AI जो संभव बनाता है, उसकी तुलना में यह ऐसा दिखता था:
| कारक | पारंपरिक डबिंग | AI लिपसिंक |
|---|
| टर्नअराउंड समय | 2 से 6 हफ़्ते | मिनट से घंटे |
| प्रति मिनट लागत | $500 से $3,000+ | एक सेंट के अंश |
| समर्थित भाषाएँ | टैलेंट की उपलब्धता पर निर्भर | 100 से 150+ |
| लिपसिंक गुणवत्ता | मैन्युअल फ़्रेम-दर-फ़्रेम एनिमेशन | स्वचालित फ़ोनीम मिलान |
| स्केलेबिलिटी | स्टूडियो क्षमता से सीमित | असीमित समानांतर प्रोसेसिंग |
| संशोधन की गति | हर बदलाव में दिन | हर री-रेंडर में सेकंड |
सिर्फ़ इकोनॉमिक्स ही बताता है कि कंटेंट क्रिएटर, गेम स्टूडियो और शिक्षक AI लिपसिंक को इतनी तेज़ी से क्यों अपना रहे हैं। तकनीकी गुणवत्ता उस सीमा तक पहुँच चुकी है जहाँ वह व्यावसायिक रूप से व्यवहार्य है, और लागत का फ़र्क मामूली नहीं है। यह लगभग दस गुना बड़ा फ़र्क है।
मल्टीलिंगुअल कैरेक्टर के लिए सबसे अच्छे AI मॉडल
सभी लिपसिंक मॉडल हर उपयोग को बराबर अच्छी तरह नहीं संभालते। कुछ वीडियो में असली चेहरों के लिए अनुकूलित हैं। कुछ एक ही फ़ोटो से काम करते हैं। यहाँ अभी उपलब्ध सबसे सक्षम विकल्प दिए गए हैं।
HeyGen Video Translate
HeyGen Video Translate वह मॉडल है जिसे ज़्यादातर लोग तब चुनते हैं जब उन्हें भाषाओं का व्यापक समर्थन चाहिए। यह 150 से ज़्यादा भाषाओं को सपोर्ट करता है और एक ही वर्कफ़्लो में अनुवाद और लिपसिंक दोनों संभालता है। आप एक वीडियो अपलोड करते हैं, टार्गेट भाषा चुनते हैं, और मॉडल सिंक्रनाइज़ होंठों और अनूदित बोली वाला वर्ज़न बना देता है।
इसकी खास ताकत प्रोसोडिक ट्रांसफ़र को संभालने में है, यानी मूल वक्ता का भावनात्मक लहजा डब किए गए वर्ज़न में भी आता है। जो कैरेक्टर अंग्रेज़ी में उत्साहित लगता है, वह पुर्तगाली में भी उत्साहित लगता है, सपाट और मशीनी नहीं।
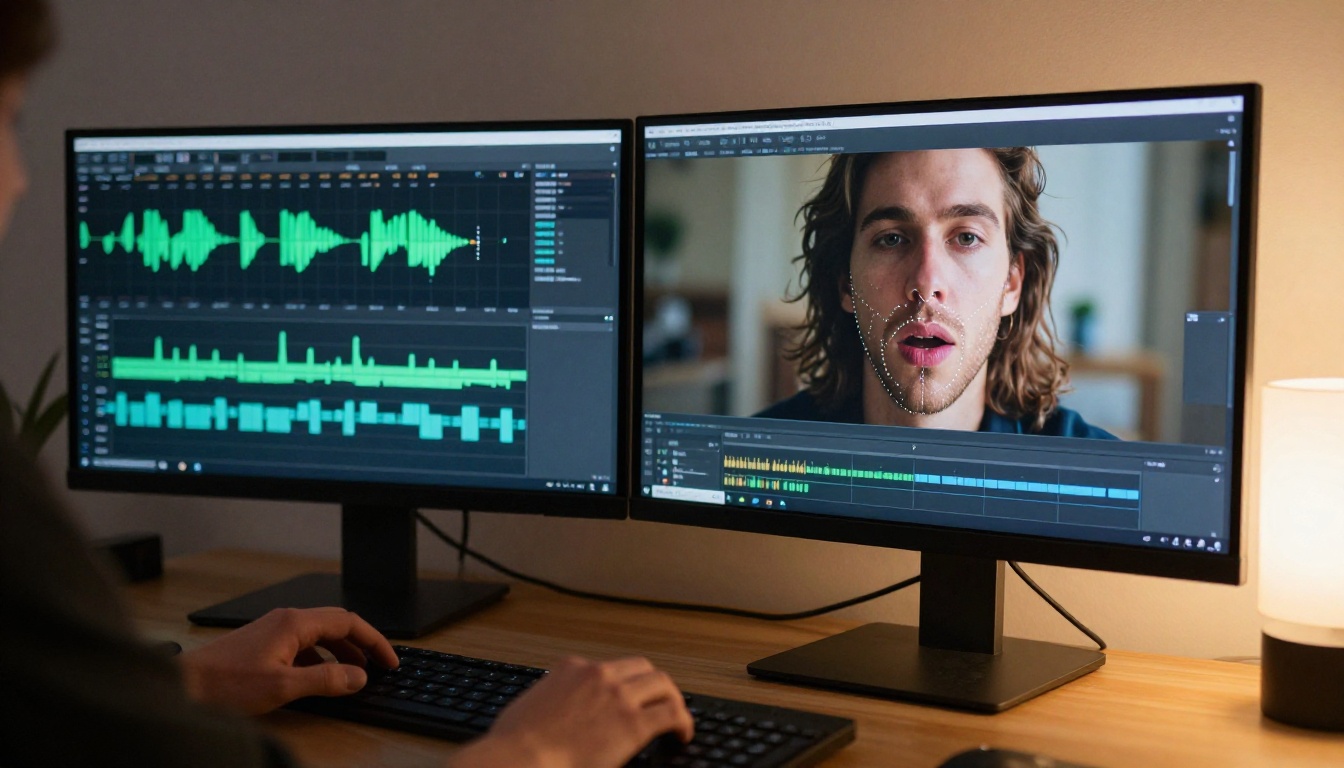
HeyGen Lipsync Precision और Lipsync Speed
जब आपके पास पहले से अनूदित ऑडियो ट्रैक हो और आपको सिर्फ़ होंठों को उससे मिलाना हो, तब Lipsync Precision और Lipsync Speed लक्षित समाधान देते हैं। Precision सटीकता को प्राथमिकता देता है, बारीक चेहरे के समायोजन के साथ फ़्रेम-दर-फ़्रेम काम करता है। Speed बड़ी मात्रा में कंटेंट प्रोसेस करते समय तेज़ नतीजों के लिए अनुकूलित है।
आपकी पाइपलाइन के हिसाब से यह फ़र्क मायने रखता है। किसी पॉलिश्ड हीरो वीडियो के लिए Precision अतिरिक्त प्रोसेसिंग समय के लायक है। पाँच भाषाओं में किसी कोर्स लाइब्रेरी की बैच डबिंग के लिए Speed बिना रुकावट के काम पूरा कर देता है।
ByteDance का Omni Human 1.5
Omni Human 1.5 ByteDance से आता है और अलग तरीका अपनाता है। मौजूदा वीडियो प्रोसेस करने के बजाय, यह एक ही फ़ोटो को स्वाभाविक सिर की हरकत, पलकें झपकाने और लिप सिंक्रनाइज़ेशन के साथ एक पूरे टॉकिंग वीडियो में बदल सकता है। आप इसे किसी कैरेक्टर की स्थिर तस्वीर और एक ऑडियो फ़ाइल देते हैं, और यह एक ऐसा एनिमेटेड बोलता हुआ वर्ज़न बना देता है जो यक़ीन दिलाने वाला लगे।
यह उन कैरेक्टरों के लिए ख़ास तौर पर शक्तिशाली है जो सिर्फ़ इलस्ट्रेशन, कॉन्सेप्ट आर्ट या पोर्ट्रेट के रूप में मौजूद हैं। आप सिर्फ़ किसी असली इंसान के बोलते हुए वीडियो फ़ुटेज तक सीमित नहीं हैं।
Sync Lipsync 2 Pro
Sync Lipsync 2 Pro ख़ास तौर पर पहले से मौजूद ऑडियो को अधिकतम विश्वसनीयता के साथ वीडियो से मिलाने की चुनौती के लिए बनाया गया है। यह कसे हुए फ़ोनीम-से-वाइसीम अलाइनमेंट को संभालता है और असामान्य टिम्बर या बोलने की शैली वाली कैरेक्टर आवाज़ों के साथ ख़ास तौर पर मज़बूत है।
इसका साथी मॉडल, Sync Lipsync 2, सीधे-सादे मामलों को संभालता है और तेज़ी से प्रोसेस करता है, इसलिए Pro वर्ज़न के साथ अंतिम रूप देने से पहले यह पहले चरण के रूप में उपयोगी है।
Kling Lip Sync
Kwaivgi का Kling Lip Sync जटिल सिर की हरकतों वाले वीडियो को प्रोसेस करने में माहिर है। कई लिपसिंक मॉडल तब लड़खड़ा जाते हैं जब सब्जेक्ट बोलते समय बगल में मुड़ता है या काफ़ी हिलता है। Kling मध्यम सिर के घुमाव में भी होंठों की सटीक स्थिति बनाए रखता है, जिससे यह एक्शन-स्टाइल कैरेक्टर वीडियो या एनिमेटेड सब्जेक्ट के लिए ज़्यादा मज़बूत विकल्प बनता है जो पूरी तरह स्थिर नहीं रहते।
Veed का Fabric 1.0
Fabric 1.0 स्थिर फ़ोटो को बोलने के लिए अनुकूलित है। अगर आपके पास किसी कैरेक्टर, ऐतिहासिक व्यक्ति या इलस्ट्रेटेड अवतार का पोर्ट्रेट है, तो Fabric सीधे उस इमेज से स्वाभाविक दिखने वाली बोलने की एनिमेशन बना देता है, और इसके लिए किसी सोर्स वीडियो की ज़रूरत नहीं होती। पूरी तरह AI-जनित कैरेक्टर ऑडियो पाइपलाइन के लिए यह टेक्स्ट-टू-स्पीच टूल्स के साथ अच्छी तरह मेल खाता है।
किसी भी भाषा में कैरेक्टर को कैसे बुलवाएँ
PicassoIA पर HeyGen Video Translate का उपयोग मल्टीलिंगुअल कैरेक्टर डबिंग का सबसे सीधा रास्ता है। यहाँ बताया गया है कि प्रक्रिया ठीक-ठीक कैसे काम करती है।
चरण 1: अपना सोर्स वीडियो तैयार करें
बेहतरीन नतीजों के लिए आपके सोर्स वीडियो को कुछ शर्तें पूरी करनी होंगी:
- कैरेक्टर का चेहरा कम से कम 80% शॉट में साफ़ दिखना चाहिए
- बोलते समय तेज़ कट या भारी मोशन ब्लर से बचें
- ऑडियो साफ़ होना चाहिए, और मिक्स में मुख्य आवाज़ साफ़ तौर पर हावी हो
- मॉडल को कैलिब्रेट करने के लिए बोलते हुए फ़ुटेज के कम से कम 5 से 10 सेकंड पर्याप्त डेटा देते हैं
आपको परफ़ेक्ट लाइट वाले स्टूडियो रिकॉर्डिंग की ज़रूरत नहीं है। ठीक-ठाक रोशनी और काफ़ी साफ़ ऑडियो ट्रैक काफ़ी हैं। बाकी का काम मॉडल संभाल लेता है।
💡 टिप: अगर आपके कैरेक्टर के पास अंग्रेज़ी में पहले से वॉइसओवर है, तो उसे सोर्स के रूप में इस्तेमाल करें। सोर्स भाषा का ऑडियो जितना साफ़ होगा, मॉडल टार्गेट भाषा के लिए फ़ोनीम मैप उतनी ही सटीकता से दोबारा बना पाएगा।
चरण 2: टार्गेट भाषा चुनें
HeyGen Video Translate 150 से ज़्यादा भाषाओं को सपोर्ट करता है, जिनमें स्पैनिश, फ़्रेंच, जर्मन, जापानी, कोरियाई, मैंडरिन, अरबी, हिंदी, पुर्तगाली, इतालवी और दर्जनों अन्य शामिल हैं। चयन इंटरफ़ेस सीधा-सादा है: सोर्स भाषा चुनें, टार्गेट भाषा चुनें, और मॉडल अनुवाद, वॉइस सिंथेसिस और लिप सिंक्रनाइज़ेशन अपने-आप संभाल लेता है।
उन भाषाओं के लिए जिनके फ़ोनीम ढाँचे आपकी सोर्स भाषा से बहुत अलग हैं (जैसे अंग्रेज़ी से अरबी या जापानी), हर मिनट की प्रोसेसिंग पर मॉडल को कुछ अतिरिक्त सेकंड दें। जब दोनों भाषाएँ कम ध्वनियाँ साझा करती हैं, तब फ़ोनीम रीमैपिंग कम्प्यूटेशनल रूप से ज़्यादा भारी होती है।
चरण 3: समीक्षा करें और एक्सपोर्ट करें
प्रोसेसिंग पूरी होने के बाद, तीन खास हिस्सों पर ध्यान देते हुए आउटपुट की समीक्षा करें:
- मुख्य फ़ोनीम: स्वर-प्रधान शब्दों और व्यंजन गुच्छों पर खत्म होने वाले शब्दों की जाँच करें। यहीं सबसे ज़्यादा बेमेल दिखने की संभावना होती है।
- भावनात्मक निरंतरता: क्या कैरेक्टर अब भी उत्साहित और जुड़ा हुआ लगता है, या डब किए गए वर्ज़न में प्रदर्शन सपाट हो गया है?
- विराम का समय: वाक्यों के बीच के स्वाभाविक विराम डब किए गए वर्ज़न में भी स्वाभाविक लगने चाहिए। अगर वे जल्दबाज़ी या खिंचे हुए लगते हैं, तो यह संकेत है कि प्रोसोडी ट्रांसफ़र को समायोजन की ज़रूरत है।
ज़्यादातर नतीजों में कोई सुधार की ज़रूरत नहीं पड़ती। जब सुधार चाहिए होते हैं, तो वे आम तौर पर एक या दो खास वाक्यांशों तक सीमित रहते हैं, जिन्हें अलग से दोबारा प्रोसेस किया जा सकता है।
नतीजे को बनाने या बिगाड़ने वाली 3 बातें
भारी काम मॉडल करता है, लेकिन आपकी तरफ़ की तीन बातों का नतीजे की गुणवत्ता पर बहुत बड़ा असर होता है।
ऑडियो की स्पष्टता
यह अकेला सबसे बड़ा चर है। सोर्स ऑडियो में बैकग्राउंड म्यूज़िक, परिवेश का शोर या रीवर्ब मॉडल को बोली के सिग्नल को अलग करने के लिए ज़्यादा मेहनत करने पर मजबूर करते हैं। शोर वाला सोर्स गड़बड़ फ़ोनीम एक्सट्रैक्शन देता है, जिससे होंठों की हरकत अस्पष्ट हो जाती है। हमेशा अपने सोर्स के रूप में सबसे साफ़ संभव ऑडियो ट्रैक इस्तेमाल करें, भले ही इसके लिए अपलोड से पहले एक त्वरित क्लीनअप करना पड़े।
चेहरे की दृश्यता
लिपसिंक मॉडल को कैरेक्टर का मुँह साफ़ दिखना चाहिए। हाथों, अग्रभूमि की वस्तुओं या अत्यधिक साइड एंगल से आंशिक ढकाव सटीकता को काफ़ी कम कर देता है। वे शॉट जिनमें कैरेक्टर 0 से 45 डिग्री के बीच कैमरे की ओर मुँह करता है, सबसे अच्छे नतीजे देते हैं। 45 डिग्री से ज़्यादा घुमाव पर, ज़्यादातर मॉडल होंठों की स्थिति की सटीक गणना करने के बजाय उसका अनुमान लगाने लगते हैं।
बोलने की रफ़्तार
बहुत तेज़ बोली सिकुड़े हुए फ़ोनीम क्रम बनाती है, जिन्हें सटीकता से रीमैप करना मुश्किल होता है। अगर आपका कैरेक्टर स्वाभाविक, नपी-तुली रफ़्तार से बोलता है, तो मॉडल के पास काम करने के लिए ज़्यादा समय होता है और नतीजे ज़्यादा साफ़ आते हैं। यह खास तौर पर तब सच है जब जर्मन या फ़्रेंच जैसी भाषाओं में जा रहे हों, जहाँ शब्द ध्वन्यात्मक रूप से अपने अंग्रेज़ी समकक्षों से लंबे होते हैं।
इसका असल में उपयोग कौन करता है
AI मल्टीलिंगुअल कैरेक्टर डबिंग के उपयोग उस दायरे से काफ़ी आगे बढ़ चुके हैं, जितना ज़्यादातर लोग शुरू में सोचते हैं।
एनिमेटर और कैरेक्टर क्रिएटर
स्वतंत्र एनिमेटर अब अपने कैरेक्टर का एक मास्टर वर्ज़न बना सकते हैं और स्पैनिश, फ़्रेंच या जापानी दर्शकों के लिए स्थानीय वर्ज़न तैयार कर सकते हैं, हर भाषा के लिए अलग वॉइस टैलेंट रखे बिना। जिस वर्कफ़्लो के लिए पहले हर भाषा का अलग प्रोडक्शन बजट चाहिए था, वह अब एक बैच एक्सपोर्ट है।
अंतरराष्ट्रीय होते YouTuber
ट्यूटोरियल, कमेंटरी या कैरेक्टर-आधारित कहानी सुनाने वाले चैनल AI डबिंग का उपयोग कई भाषाओं में एक साथ प्रकाशित करने के लिए कर रहे हैं। सबटाइटल मैन्युअली जुड़ने का इंतज़ार करने के बजाय, वे मूल वीडियो वाले ही दिन डब किए गए वर्ज़न अपलोड कर देते हैं। बिना अतिरिक्त रिकॉर्डिंग समय के बहुभाषी पहुँच बढ़ते चैनलों के लिए एक बड़ा प्रतिस्पर्धी फ़ायदा है।
शिक्षक और कोर्स क्रिएटर
ऑनलाइन कोर्स प्लेटफ़ॉर्म वैश्विक दर्शकों तक पहुँचने के लिए अपने कंटेंट के बहुभाषी वर्ज़न की ज़रूरत महसूस करने लगे हैं। 3 घंटे की कोर्स लाइब्रेरी जिसकी प्रोफ़ेशनल डबिंग में दसियों हज़ार डॉलर लगते, वह अब घंटों में प्रोसेस हो सकती है। AI अनुवाद, सिंथेसिस और लिपसिंक संभालता है। इंस्ट्रक्टर आउटपुट की समीक्षा करता है और प्रकाशित कर देता है।
💡 टिप: शैक्षिक कंटेंट के लिए, प्रकाशित करने से पहले डब किए गए आउटपुट को टार्गेट भाषा के किसी मूल वक्ता से जाँच करवाएँ। AI अनुवाद बेहद सटीक होता है, पर कभी-कभी ऐसे वाक्य बना देता है जो तकनीकी रूप से सही होते हैं, लेकिन संदर्भ में अटपटे लगते हैं।
अभी आप क्या बना सकते हैं
इस लेख में बताए गए सभी टूल्स आज PicassoIA पर उपलब्ध हैं। आपको प्रोडक्शन स्टूडियो, डबिंग टीम या छह अंकों वाले लोकलाइज़ेशन बजट की ज़रूरत नहीं है। आपको एक वीडियो, एक ऑडियो ट्रैक या सोर्स संवाद, और कुछ मिनट चाहिए।
Omni Human 1.5 आपके कैरेक्टर की एक फ़ोटो को बोलते, एनिमेटेड चेहरे में बदल सकता है। HeyGen Video Translate उस वीडियो को लेकर 150 से ज़्यादा भाषाओं में वर्ज़न बना सकता है। Sync Lipsync 2 Pro सुनिश्चित करता है कि हर फ़ोनीम ठीक उसी जगह पड़े जहाँ उसे होना चाहिए। Kling Lip Sync उन कैरेक्टरों को संभालता है जो फ़्रेम में चलते-फिरते हैं। Fabric 1.0 उन कैरेक्टरों को संभालता है जो सिर्फ़ एक पोर्ट्रेट हैं।
किसी भी कैरेक्टर को सटीक लिपसिंक के साथ किसी भी भाषा में बोलवाने की पूरी पाइपलाइन अभी उपलब्ध है। एक कैरेक्टर चुनें, एक भाषा चुनें, PicassoIA पर अपलोड करें, और देखें कि तकनीक असल में क्या देती है। नतीजे आपके मल्टीलिंगुअल कंटेंट के बारे में सोचने का तरीका बदल देंगे।
आज ही PicassoIA पर जाएँ और लिपसिंक मॉडल आज़माएँ। जिस कैरेक्टर को आप इतने समय से बना रहे हैं, वह हर भाषा में सुने जाने का हक़दार है।


