Imagine que você passou semanas criando um personagem, animando cada expressão e aperfeiçoando sua história de fundo, até bater em um muro no momento em que alguém pergunta "ele consegue falar espanhol?" ou "dá para fazer uma versão em japonês?". Esse muro costumava significar contratar estúdios profissionais de dublagem, dubladores e animadores de sincronização labial. Hoje, a IA reduziu todo esse processo a um único envio. Você pode fazer um personagem falar em qualquer idioma com IA em minutos, com lábios sincronizados, entonação natural e zero horas de estúdio.
Isso não é truque de marketing. Os resultados que saem de modelos como HeyGen Video Translate, Omni Human 1.5 e Sync Lipsync 2 Pro já são usados em produções reais, em canais reais do YouTube e em plataformas educacionais reais. A tecnologia ultrapassou o ponto em que o resultado é convincente o bastante para ir ao ar.
A maioria das pessoas acha que a dublagem com IA é apenas trocar o áudio. Não é. A boca continua se movendo para as palavras erradas se você só trocar o áudio, e isso fica horrível. O lipsync real com IA envolve três processos simultâneos: síntese de fala no idioma de destino, extração de fonemas a partir desse novo áudio e redirecionamento da animação facial, que reposiciona a boca, o maxilar e os músculos faciais ao redor para combinar com esses fonemas quadro a quadro.
Como funciona o mapeamento de fonemas
Um fonema é a menor unidade de som na fala. A palavra "cat" tem três fonemas: /k/, /æ/, /t/. Cada idioma tem seu próprio inventário de fonemas. O espanhol tem sons vocálicos diferentes do inglês. O árabe tem sons que não existem nas línguas românicas.
Os modelos de lipsync com IA são treinados com grandes conjuntos de dados de fala humana, pareados com vídeos de alta velocidade de bocas produzindo esses sons. Quando você alimenta o modelo com uma faixa de áudio de destino, ele extrai a sequência de fonemas e associa cada som ao formato correspondente da boca, chamado viseme. Em seguida, mistura esses visemes ao longo dos quadros, com um ritmo que acompanha os padrões naturais da fala humana.
Por que agora soa natural
A dublagem inicial com IA produzia resultados robóticos porque os modelos eram treinados com fala gravada em estúdio, em ambientes silenciosos. Eles tinham dificuldade com o ritmo natural da fala, em que as palavras se misturam, as vogais são reduzidas e a ênfase muda conforme a posição na frase.
Os modelos atuais são treinados com fala conversacional em dezenas de idiomas, com aumento de dados que simula condições reais de áudio. O resultado é uma fala dublada que carrega a prosódia natural, as subidas e descidas de altura e de velocidade que fazem a fala soar humana e não sintetizada.
💡 Dica: A qualidade do áudio original afeta diretamente a precisão do lipsync. Um áudio limpo, com pouco ruído de fundo, produz movimentos labiais visivelmente mais nítidos.
O custo real da dublagem tradicional
Antes da IA, produzir uma versão multilíngue de um personagem de vídeo exigia um pipeline completo de produção. Veja como era isso comparado ao que a IA possibilita hoje:
| Fator | Dublagem tradicional | Lipsync com IA |
|---|
| Prazo de entrega | 2 a 6 semanas | Minutos a horas |
| Custo por minuto | US$ 500 a US$ 3.000+ | Frações de centavo |
| Idiomas disponíveis | Limitados pela disponibilidade de talentos | 100 a 150+ |
| Qualidade do lipsync | Animação manual quadro a quadro | Correspondência automática de fonemas |
| Escalabilidade | Limitada pela capacidade do estúdio | Processamento paralelo ilimitado |
| Velocidade de revisão | Dias por alteração | Segundos por nova renderização |
A economia, por si só, explica por que criadores de conteúdo, estúdios de jogos e educadores estão adotando o lipsync com IA em ritmo acelerado. A qualidade técnica ultrapassou o ponto em que se torna comercialmente viável, e a diferença de custo não é marginal. É uma diferença de ordem de grandeza.
Os melhores modelos de IA para personagens multilíngues
Nem todos os modelos de lipsync lidam igualmente bem com todos os casos. Alguns são otimizados para rostos reais em vídeo. Outros funcionam a partir de uma única fotografia. Estas são as opções mais capazes disponíveis agora.
HeyGen Video Translate
HeyGen Video Translate é o modelo que a maioria das pessoas escolhe quando precisa de ampla cobertura de idiomas. Ele oferece suporte a mais de 150 idiomas e faz tanto a tradução quanto o lipsync em um único fluxo de trabalho. Você envia um vídeo, seleciona o idioma de destino e o modelo produz uma versão com movimentos labiais sincronizados e fala traduzida.
O que o torna particularmente forte é o tratamento da transferência prosódica, o que significa que o tom emocional do falante original é mantido na versão dublada. Um personagem que soa empolgado em inglês soa empolgado em português, e não plano e mecânico.
HeyGen Lipsync Precision e Lipsync Speed
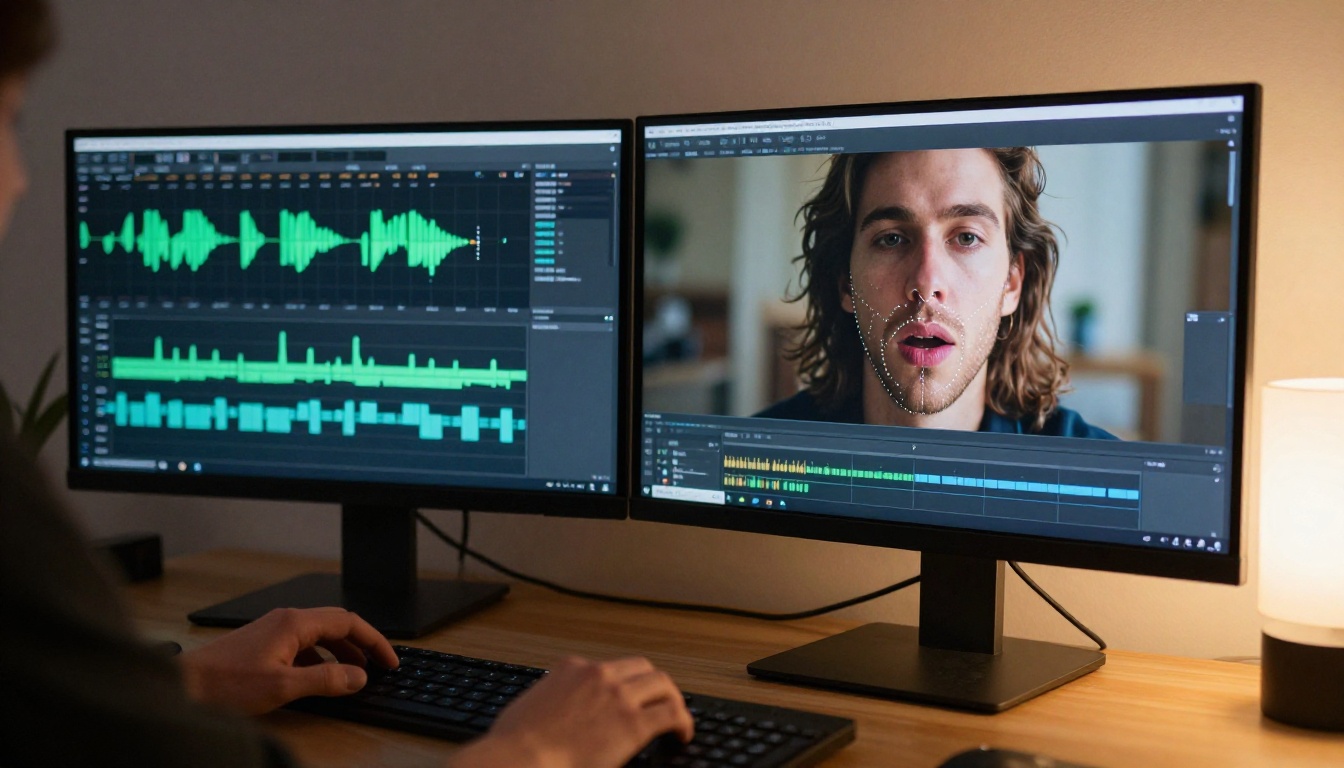
Para os casos em que você já tem uma faixa de áudio traduzida e só precisa que os lábios combinem, Lipsync Precision e Lipsync Speed oferecem soluções específicas. O Precision prioriza a precisão, trabalhando quadro a quadro com ajustes faciais detalhados. O Speed é otimizado para entregas rápidas quando você processa grandes volumes de conteúdo.
A diferença importa conforme o seu pipeline. Para um vídeo principal caprichado, vale a pena o tempo extra de processamento do Precision. Para dublar em lote uma biblioteca de cursos em cinco idiomas, o Speed chega lá sem gargalos.
Omni Human 1.5 da ByteDance
Omni Human 1.5, da ByteDance, segue uma abordagem diferente. Em vez de processar um vídeo existente, ele pode animar uma única fotografia e transformá-la em um vídeo falado completo, com movimento natural da cabeça, piscadas e sincronização labial. Você fornece uma imagem estática de um personagem e um arquivo de áudio, e ele produz uma versão falada convincentemente animada.
Isso é especialmente poderoso para personagens que existem apenas como ilustrações, arte conceitual ou retratos. Você não fica limitado a filmagens de uma pessoa real falando.
Sync Lipsync 2 Pro
Sync Lipsync 2 Pro foi criado especificamente para o desafio de combinar um áudio pré-existente com um vídeo com a máxima fidelidade. Ele lida com um alinhamento preciso entre fonemas e visemes e é particularmente forte com vozes de personagens que têm timbre ou estilo de fala incomuns.
Seu modelo companheiro, Sync Lipsync 2, cuida de casos mais simples e processa mais rápido, o que o torna útil como uma primeira passagem antes de finalizar com a versão Pro.
Kling Lip Sync
Kling Lip Sync, da Kwaivgi, se destaca no processamento de vídeos com movimentos complexos de cabeça. Muitos modelos de lipsync têm dificuldade quando o sujeito vira para o lado ou se move bastante durante a fala. O Kling mantém o posicionamento labial preciso mesmo com rotação moderada da cabeça, o que o torna mais robusto para vídeos de personagens em estilo de ação ou para sujeitos animados que não ficam perfeitamente parados.
Fabric 1.0 da Veed
Fabric 1.0 é otimizado para fazer fotos estáticas falarem. Se você tem um retrato de um personagem, de uma figura histórica ou de um avatar ilustrado, o Fabric gera uma animação de fala de aparência natural diretamente da imagem, sem precisar de vídeo de origem. Ele combina bem com ferramentas de texto para fala para um pipeline de áudio de personagem totalmente gerado por IA.
Como fazer um personagem falar em qualquer idioma
Usar o HeyGen Video Translate no PicassoIA é o caminho mais direto para a dublagem multilíngue de personagens. Veja exatamente como o processo funciona.
Passo 1: prepare seu vídeo de origem
O seu vídeo de origem precisa atender a algumas condições para os melhores resultados:
- O rosto do personagem precisa estar bem visível em pelo menos 80% do plano
- Evite cortes rápidos ou desfoque de movimento intenso durante a fala
- O áudio deve estar limpo, com a voz principal claramente dominante na mixagem
- Um mínimo de 5 a 10 segundos de filmagens com fala dá ao modelo dados suficientes para calibrar
Você não precisa de uma gravação em estúdio perfeitamente iluminado. Uma iluminação razoável e uma faixa de áudio razoavelmente clara bastam. O modelo cuida do resto.
💡 Dica: Se o seu personagem já tem uma narração em inglês, use-a como origem. Quanto mais limpo for o áudio no idioma de origem, com mais precisão o modelo consegue reconstruir o mapa de fonemas para o idioma de destino.
Passo 2: escolha o idioma de destino
O HeyGen Video Translate oferece suporte a mais de 150 idiomas, incluindo espanhol, francês, alemão, japonês, coreano, mandarim, árabe, hindi, português, italiano e dezenas de outros. A interface de seleção é simples: escolha o idioma de origem, escolha o idioma de destino, e o modelo cuida automaticamente da tradução, da síntese de voz e da sincronização labial.
Para idiomas com estruturas fonéticas muito diferentes da sua origem (por exemplo, do inglês para o árabe ou o japonês), dê ao modelo alguns segundos extras por minuto de processamento. O remapeamento de fonemas exige mais cálculo quando os dois idiomas compartilham menos sons.
Passo 3: revise e exporte
Quando o processamento terminar, revise a saída com foco em três pontos específicos:
- Fonemas críticos: verifique palavras com muitas vogais e palavras que terminam em grupos de consoantes. É onde as discrepâncias têm mais chance de aparecer.
- Consistência emocional: o personagem ainda soa e parece engajado, ou a versão dublada perdeu a energia da atuação?
- Tempo das pausas: as pausas naturais entre frases devem continuar naturais na versão dublada. Se parecerem apressadas ou esticadas, é sinal de que a transferência prosódica precisa de ajuste.
A maioria dos resultados não exige nenhuma correção. Quando correções são necessárias, elas costumam se limitar a uma ou duas frases específicas, que podem ser reprocessadas individualmente.
3 coisas que fazem ou desfazem o seu resultado
O modelo faz o trabalho pesado, mas três fatores do seu lado têm um efeito desproporcional na qualidade da saída.
Clareza do áudio
Esta é a variável mais importante. Música de fundo, ruído ambiente ou reverberação no áudio original obrigam o modelo a trabalhar mais para isolar o sinal de fala. Um original ruidoso produz uma extração de fonemas ruidosa, o que resulta em movimentos labiais imprecisos. Sempre use a faixa de áudio mais limpa possível como origem, mesmo que isso signifique fazer uma limpeza rápida antes do envio.
Visibilidade do rosto
O modelo de lipsync precisa ver a boca do personagem com clareza. Oclusão parcial por mãos, objetos em primeiro plano ou ângulos laterais extremos reduz muito a precisão. Planos em que o personagem fica de frente para a câmera entre 0 e 45 graus produzem os melhores resultados. Acima de 45 graus de rotação, a maioria dos modelos passa a aproximar em vez de calcular com precisão a posição dos lábios.
Ritmo da fala
Uma fala muito rápida produz sequências de fonemas comprimidas, mais difíceis de remapear com precisão. Se o seu personagem fala em um ritmo natural e medido, o modelo tem mais espaço temporal para trabalhar e produz resultados mais limpos. Isso vale especialmente para idiomas como alemão ou francês, em que as palavras tendem a ser foneticamente mais longas que os equivalentes em inglês.
Quem realmente usa isso
Os casos de uso da dublagem multilíngue de personagens com IA se expandiram bem além do que a maioria das pessoas imagina no início.
Animadores e criadores de personagens
Animadores independentes agora podem criar uma única versão-mestra do personagem e gerar versões localizadas para públicos de espanhol, francês ou japonês sem contratar talentos de voz para cada idioma. O fluxo de trabalho que antes exigia um orçamento de produção separado para cada idioma agora é uma exportação em lote.
YouTubers em busca de público internacional
Canais focados em tutoriais, comentários ou narrativas com personagens estão usando a dublagem com IA para publicar simultaneamente em vários idiomas. Em vez de esperar que legendas sejam adicionadas manualmente, publicam as versões dubladas no mesmo dia do original. Alcance multilíngue sem tempo adicional de gravação é uma vantagem competitiva significativa para canais em crescimento.
Educadores e criadores de cursos
As plataformas de cursos online começaram a exigir versões multilíngues de seu conteúdo para atender públicos globais. Uma biblioteca de cursos de 3 horas que custaria dezenas de milhares de dólares para ser dublada profissionalmente agora pode ser processada em horas. A IA cuida da tradução, da síntese e do lipsync. O instrutor revisa a saída e publica.
💡 Dica: Para conteúdo educacional, passe a versão dublada por um falante nativo do idioma de destino antes de publicar. A tradução por IA é altamente precisa, mas ocasionalmente produz frases tecnicamente corretas e contextualmente estranhas.
O que você pode criar agora
As ferramentas descritas neste artigo estão todas disponíveis no PicassoIA hoje. Você não precisa de um estúdio de produção, de uma equipe de dublagem ou de um orçamento de localização de seis dígitos. Você precisa de um vídeo, uma faixa de áudio ou um diálogo de origem e alguns minutos.
O Omni Human 1.5 pode transformar uma única fotografia do seu personagem em um rosto animado e falante. O HeyGen Video Translate pode pegar esse vídeo e produzir versões em mais de 150 idiomas. O Sync Lipsync 2 Pro garante que cada fonema caia exatamente onde deve. O Kling Lip Sync cuida de personagens que se movem pelo quadro. O Fabric 1.0 cuida de personagens que são apenas um retrato.
O pipeline completo para fazer qualquer personagem falar qualquer idioma com lipsync preciso está disponível agora. Escolha um personagem, escolha um idioma, envie para o PicassoIA e veja o que a tecnologia realmente produz. Os resultados vão mudar a forma como você pensa a criação de conteúdo multilíngue.
Acesse o PicassoIA e experimente hoje os modelos de lipsync. O personagem que você vem construindo merece ser ouvido em todos os idiomas.


