إن كنت تستخدم Midjourney لتوليد الصور بالذكاء الاصطناعي، فأنت تزداد براعة في توجيه نموذج واحد للحصول على نوع واحد من المخرجات. هذا كل شيء. في المقابل، تقع بقية حزمة الإنتاج الإبداعي بالذكاء الاصطناعي، من فيديو وصوت وتحرير متقدم وأدوات للوجوه وتحويل النص إلى كلام، إضافةً إلى أكثر من 90 بنية مختلفة لتوليد الصور، خارج ما يستطيع Midjourney تقديمه. تملك Picasso AI كل نموذج لا يملكه Midjourney، وهذا فرق ليس بالبسيط. إنه الفرق بين أداة ذات غرض واحد ومنصة إنتاج متكاملة بالذكاء الاصطناعي.
ما يقدمه Midjourney وما يتوقف عنده (ولماذا)
Midjourney عبارة عن نموذج مملوك واحد. تكتب أمرًا نصيًا، فيولّد صورة بأسلوبه المميز. هذا الأسلوب ممتاز فعلًا في جماليات معينة، ولهذا يستخدمه ملايين الأشخاص. لكن قدراته تتوقف عند هذا الحد، وفهم هذا السقف هو الخطوة الأولى لمعرفة ما الذي تفتقده فعلًا.
مخرج واحد وأسلوب واحد
لا يمكنك تبديل النماذج في Midjourney. يمكنك ضبط نسب العرض إلى الارتفاع وأوزان الأسلوب ومعاملات الفوضى، لكنك تعمل دائمًا ضمن النظام الأساسي نفسه. إذا كان أسلوب Midjourney المميز لا يناسب مشروعك، أو طلب منك عميل شيئًا يميل إلى الواقعية الفوتوغرافية بطريقة لا يجيدها Midjourney، فستجد نفسك مضطرًا إلى الالتفاف على قيوده بدلًا من اختيار الأداة المناسبة للمهمة.
لا يوجد تحويل للنص إلى فيديو. لا توجد موسيقى بالذكاء الاصطناعي. لا توجد إزالة للخلفية. لا يوجد تبديل للوجوه. لا توجد مزامنة للشفاه في الفيديوهات الناطقة. لا يوجد رفع للدقة الفائقة. لا يوجد ControlNet للتحكم في الوضعيات أو البنية. لا يوجد تعديل موضعي أو توسيع للصورة يتجاوز التنويعات الأساسية. كلمة "نموذج" في سياق Midjourney تشير إلى أرقام إصدارات البنية الملكية نفسها، لا إلى أنظمة ذكاء اصطناعي مختلفة تقوم بمهام مختلفة جوهريًا.
لا وصول إلى منظومة الذكاء الاصطناعي المفتوحة
أنتجت منظومة الذكاء الاصطناعي الإبداعي الأوسع عشرات البنى القوية في العامين الأخيرين وحدهما. وضعت نماذج Flux من Black Forest Labs معايير جديدة للمخرجات الواقعية كالصور الفوتوغرافية والالتزام بالأمر النصي. وأتاحت إصدارات Stable Diffusion وSDXL ظهور منظومة كاملة من النماذج المضبوطة بدقة لجماليات محددة. وجعل ControlNet التحكم في البنية والوضعية ممكنًا. وأطلقت Google وOpenAI وByteDance وRunway جميعًا أنظمة لتوليد الفيديو تنتج لقطات سينمائية من الأوامر النصية.
لا يتيح Midjourney الوصول إلى أي من هذه. كل أمر ترسله يبقى داخل جدرانه الملكية.
💡 بالنسبة إلى المبدعين الذين يحتاجون إلى مرونة بصرية، فهذا سقف صارم. أما بالنسبة إلى الفرق التي تحتاج إلى حزمة إنتاج كاملة، فهو عائق حاسم.
فارق كتالوج النماذج ضخم جدًا
هنا تصبح المقارنة ملموسة. تعمل Picasso AI بوصفها منصة متعددة النماذج، أي أنها تستضيف عشرات البنى المختلفة للذكاء الاصطناعي وتشغّلها عبر مجالات إبداعية متعددة. أنت تختار النموذج الذي يناسب مهمتك المحددة ومتطلبات مخرجاتك وأهدافك الجمالية.
أكثر من 91 نموذجًا لتوليد الصور في مكان واحد
تضم فئة تحويل النص إلى صورة وحدها أكثر من 91 نموذجًا. وهذا يعني خيارًا حقيقيًا بين البنى، لا مجرد تعديلات في المعاملات داخل نظام واحد:
- Flux Redux Dev لإنشاء تنويعات مضبوطة لصورة مرجعية مع الحفاظ على الدقة البنيوية
- GPT Image 2 لمخرجات واقعية دقيقة تتبع التعليمات وتستجيب بدقة للأوامر المعقدة
- Qwen Image Edit Plus لتحرير الصور ومعالجتها بالذكاء الاصطناعي مباشرةً من أوامر بلغة طبيعية
- نماذج قائمة على ControlNet للتحكم في العمق ومطابقة الوضعيات والحفاظ على البنية
كل واحد من هذه النماذج يؤدي شيئًا مختلفًا بوضوح. بعضها محسّن للواقعية الفوتوغرافية. وبعضها للمخرجات الفنية والمنمّقة. وبعضها للتحكم الصارم في التكوين، بحيث يحافظ على بنية المشهد مع تغيير محتواه. لا يتيح Midjourney أيًا من هذا الخيار.
كل بنية رئيسية في واجهة واحدة
يتلخص الفرق العملي في ما يلي: عندما يصدر نموذج جديد عن Black Forest Labs أو Google أو OpenAI أو أي مختبر كبير للذكاء الاصطناعي، يجري تقييمه ويُضاف إلى المنصة. لست مضطرًا إلى انتظار فريق ملكي واحد ليحسّن نظامًا واحدًا وفق جدوله الزمني. تحصل على الميدان كله من أبحاث توليد الصور بالذكاء الاصطناعي وهو يتطور.
| القدرة | Midjourney | Picasso AI |
|---|
| نماذج الصور | 1 (ملكي) | 91+ |
| توليد الفيديو | لا يوجد | أكثر من 106 نموذج |
| الصوت بالذكاء الاصطناعي | لا يوجد | متاح |
| تحرير الصور | تنويعات أساسية فقط | حزمة كاملة |
| أدوات الوجوه والجسم | لا يوجد | متاح |
| ControlNet | لا يوجد | متاح |
| الدقة الفائقة | لا يوجد | من 2x إلى 4x |
| إزالة الخلفية | لا يوجد | متاح |
| مزامنة الشفاه | لا يوجد | متاح |
توليد الفيديو: الفجوة الأكبر
هذه هي القدرة التي تخلق أوسع مسافة بين المنصتين. لا يملك Midjourney توليدًا للفيديو. ليس توليدًا محدودًا، بل لا شيء على الإطلاق.
106 نماذج فيديو وما زال العدد يتزايد
تضم فئة تحويل النص إلى فيديو في Picasso AI أكثر من 106 نماذج من أكبر الأسماء في إنتاج فيديو الذكاء الاصطناعي. ليست رسومًا متحركة بصيغة GIF ولا مقاطع قصيرة غير واضحة. بل فيديو سينمائي كامل من الأوامر النصية، بدقة تصل إلى 4K، وصوت مدمج في نماذج مختارة.
من أبرز النماذج:
- Veo 3 من Google: تحويل النص إلى فيديو مع توليد صوتي أصلي، ينتج صوتًا متزامنًا مع الصورة
- Sora 2 من OpenAI: فيديو بدقة عالية ومخرجات متزامنة مع الصوت وتماسك سينمائي قوي
- Kling v2.6 من Kwaivgi: مخرجات سينمائية بدقة 1080p من الأوامر النصية ومن صور الإدخال معًا
- Seedance 2.0 من ByteDance: تحويل النص إلى فيديو مع توليد صوتي مدمج في تمريرة توليد واحدة
- Wan 2.7 T2V: فيديو بدقة 1080p من الأوامر النصية مع تماسك قوي في الحركة
- LTX 2 Pro: فيديو بدقة 4K من النص بجودة مخرجات احترافية
- Gen 4.5 من Runway: حركة سينمائية وتحكم في الكاميرا من الإدخال النصي
- Hailuo 02: توليد فيديو بالذكاء الاصطناعي بدقة 1080p واضحة
- Ray من Luma AI: تحويل نص إلى فيديو سريع وعالي الجودة مع حركة سلسة
من الصور الثابتة إلى لقطات متحركة
إلى جانب تحويل النص إلى فيديو، يمكنك أيضًا تحريك الصور الموجودة بدلًا من توليدها من الصفر. تحوّل نماذج مثل Wan 2.7 I2V الصورة الفوتوغرافية إلى حركة فيديو سلسة وطبيعية المظهر. أما Pixverse v5 فيؤدي المهمة نفسها مع أسلوب سينمائي قوي وخيارات لحركة الكاميرا.
بالنسبة إلى صنّاع المحتوى وفرق وسائل التواصل الاجتماعي والمسوّقين ومنتجي الفيديو، تجعل فجوة القدرة هذه Midjourney غير ذي صلة تمامًا بجزء كبير من عملهم اليومي.
الصوت بالذكاء الاصطناعي الذي لم يقترب منه Midjourney قط
لا موسيقى بالذكاء الاصطناعي، ولا تركيب للأصوات، ولا تفريغ نصي. لم يعمل Midjourney في المجال الصوتي قط، ولا توجد خارطة طريق تشير إلى أنه سيفعل ذلك يومًا.
موسيقى من أمر نصي
تتيح فئة توليد الموسيقى بالذكاء الاصطناعي في Picasso AI إنشاء مقاطع صوتية كاملة من أوصاف مكتوبة. صف المزاج أو النوع أو الإيقاع أو الآلات أو مستوى الطاقة، فينتج النموذج مخرجًا صوتيًا أصليًا. ومن حالات الاستخدام العملية:
- محتوى YouTube ووسائل التواصل الذي يحتاج إلى مقاطع خلفية خالية من حقوق الملكية
- الإعلانات وحملات العلامات التجارية التي تحتاج إلى صوت مخصص يتناسب مع إيقاع مرئي محدد
- تطوير الألعاب لتجربة المشاهد الصوتية قبل الالتزام بملحّن
- صناعة الأفلام لاختبار أفكار الموسيقى التصويرية على المونتاج الأولي
- إنتاج البودكاست والفيديو حيث تكون موسيقى المقدمة والانتقالات حاجة دائمة
تحويل النص إلى كلام وتركيب الصوت
تغطي فئة تحويل النص إلى كلام توليد أصوات واقعية للتعليق الصوتي وحوارات الشخصيات والتعليقات الصوتية للعلامات التجارية. ويتولى التحويل من الكلام إلى نص سير عمل التفريغ للبودكاست والمقابلات ومحتوى الفيديو. وإذا كنت تنتج فيديو، فإن وجود توليد التعليق الصوتي وتفريغ الصوت داخل المنصة نفسها التي تعمل فيها على الإنتاج المرئي يزيل عائقًا كبيرًا يتمثل في التنقل بين الأدوات.
💡 الجمع بين توليد الصور وإنتاج الفيديو وإنتاج الموسيقى وتركيب الصوت في منصة واحدة هو ما يفصل المجموعة الإبداعية المتكاملة عن أداة صور ذات غرض واحد.
أدوات تحرير الصور التي لا يستطيع Midjourney مجاراتها
أضاف Midjourney مع الوقت ميزتي "vary" و"remix"، لكن قدرات تحرير الصور فيه تظل تعديلات سطحية داخل المخرجات التي يولّدها بنفسه. تقدم Picasso AI حزمة كاملة لتحرير الصور بالذكاء الاصطناعي تعمل على أي صورة، سواء كانت مولّدة أو مرفوعة.
التعديل الموضعي وتوسيع الصورة واستبدال الكائنات
تشكّل هذه القدرات الثلاث أساس سير عمل تحرير الصور الاحترافي بالذكاء الاصطناعي:
- التعديل الموضعي: حدّد أي منطقة في الصورة واملأها بمحتوى جديد مولّد بالذكاء الاصطناعي ينسجم بسلاسة مع المحيط. أصلح الأخطاء، أو بدّل الكائنات، أو أزل العناصر غير المرغوب فيها، أو أضف عناصر جديدة.
- توسيع الصورة: وسّع اللوحة خارج الإطار الأصلي في أي اتجاه. أضف سماءً في الأعلى، أو مقدمة في الأسفل، أو وسّع الخلفية لإنشاء تكوين أعرض من لقطة أضيق في الأصل.
- استبدال الكائنات: صف ما تريده بدلًا من عنصر موجود، فيستبدله الذكاء الاصطناعي مع الحفاظ على الإضاءة والظلال وكل ما تبقى في المشهد.
هذه ليست ميزات تجريبية. إنها أدوات جاهزة للإنتاج يستخدمها المصممون والمصوّرون وفرق التسويق يوميًا. ولا تتيح منظومة Midjourney المغلقة أيًا من هذه على الصور الخارجية.
الدقة الفائقة واستعادة الصور
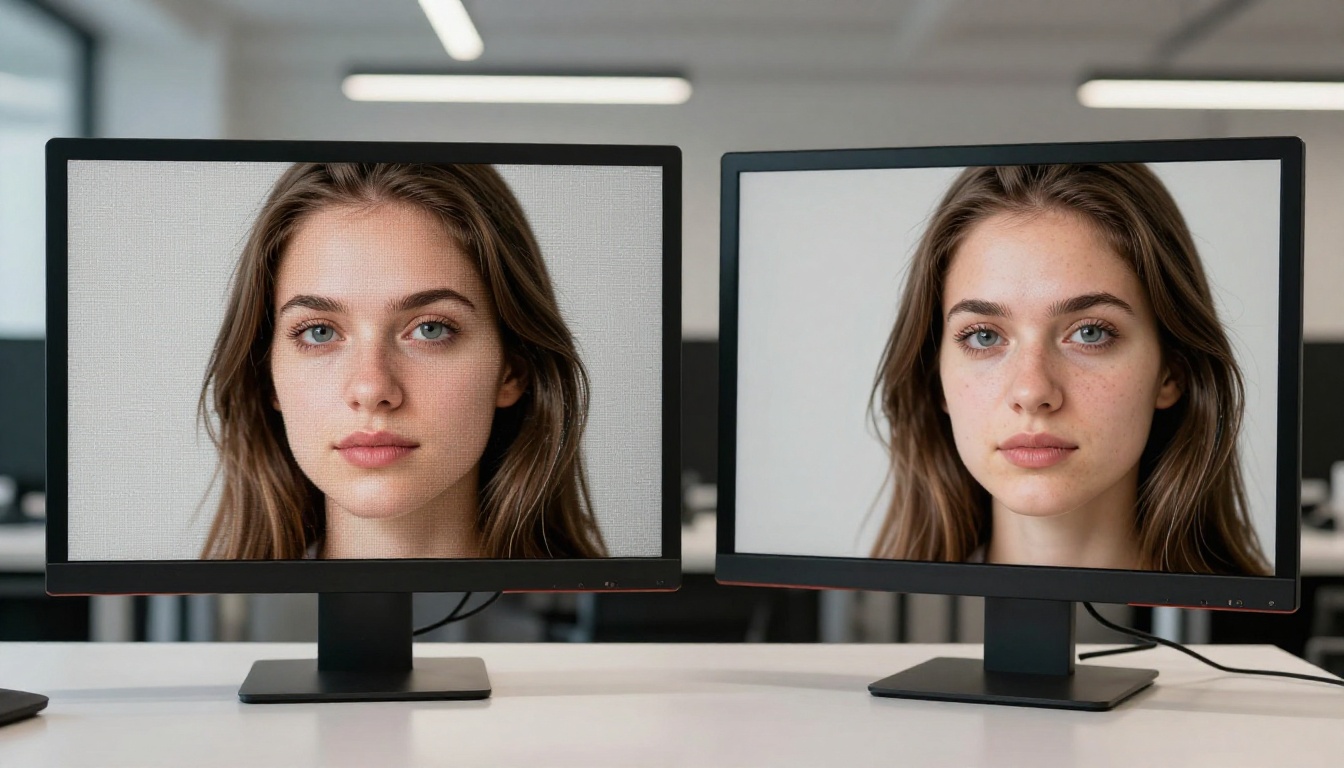
تتولى فئة الدقة الفائقة رفع الدقة من 2x إلى 4x مع إعادة بناء حقيقية للتفاصيل، لا مجرد استيفاء بسيط. تُعاد بناء خصلات الشعر وملمس الأقمشة ومسام الجلد والتفاصيل المعمارية الدقيقة التي تتلاشى في المصادر منخفضة الدقة، بدرجة مقنعة من الدقة. وتعالج أدوات استعادة الصور بالذكاء الاصطناعي الضوضاء والضبابية وتشوهات الضغط والتلف المادي في الصور الموجودة.
بالنسبة إلى المصورين الذين يعملون على مواد منخفضة التعريض أو منخفضة الدقة، وفرق التجارة الإلكترونية التي تعيد تحجيم صور المنتجات لمنصات مختلفة، وأمناء الأرشيف الذين يرقمنون الصور التاريخية، فهذا سير عمل يومي عملي. ولا يقدم Midjourney أيًا منه.
إزالة الخلفية في ثوانٍ
توفر فئة إزالة الخلفيات فصلًا فوريًا ونظيفًا للخلفية باستخدام الذكاء الاصطناعي للتقطيع. ارفع أي صورة منتج أو بورتريه أو مشهد، فيعزل الذكاء الاصطناعي الشخص أو الكائن بدقة حول الشعر والحواف المعقدة والعناصر شبه الشفافة. وهذا سير عمل معتاد لقوائم التجارة الإلكترونية وأصول التسويق وإنتاج المحتوى لوسائل التواصل، وهو أمر لا يتناوله Midjourney ببساطة.
نماذج الذكاء الاصطناعي للوجوه والجسم
لا يقترب Midjourney من أدوات الذكاء الاصطناعي الخاصة بالوجوه. فهو لا يقوم بتبديل الوجوه ولا بتوليد الأفاتار الناطق ولا بمزامنة الشفاه في الفيديو. تتطلب هذه القدرات نماذج متخصصة مبنية للدقة التي يفرضها التركيب الوجهي.
تقنية تبديل الوجوه
تتيح Face Swap AI استبدال الوجوه بين الصور بنتائج واقعية كالصور الفوتوغرافية. يتعامل النموذج مع ظروف الإضاءة ومطابقة لون البشرة والهندسة الوجهية ودمج الحواف لإنتاج مركّبات طبيعية المظهر. ومن التطبيقات المشروعة إنشاء المحتوى، والمعاينة المسبقة للأفلام حين يكون توفر الممثلين عائقًا، وحملات التسويق التي تحتاج إلى ثبات الشخصيات عبر الأصول المرئية.
مزامنة الشفاه للفيديو الناطق
تزامن فئة مزامنة الشفاه حركة الفم مع أي مسار صوتي أو مخرج تحويل نص إلى كلام، مع تحريك واقعي للوجه. وعند دمجها مع قدرات توليد الفيديو وتركيب الصوت داخل المنصة نفسها، تنشأ منظومة متكاملة لإنتاج فيديو ناطق دون تصوير أمام الكاميرا. وبالنسبة إلى الشروحات التجارية وعروض المنتجات والدبلجة متعددة اللغات وإنتاج المحتوى التدريبي، فإن أثر ذلك على سير العمل فوري.
كيفية استخدام Flux Redux Dev على Picasso AI
تتوفر على Picasso AI أداة Flux Redux Dev بوصفها واحدة من أكثر أدوات تنويع الصور مرونةً. يتخصص هذا النموذج في توليد تنويعات مضبوطة لصورة مرجعية مع الحفاظ على الاتساق البنيوي والتكويني، ما يجعله مثاليًا لتكرارات تصوير المنتجات، وجولات تصميم الشخصيات، والاستكشاف الإبداعي انطلاقًا من نقطة بداية واحدة.
الخطوة 1: افتح صفحة النموذج
انتقل إلى Flux Redux Dev على Picasso AI. لا إضافات، ولا خادم Discord، ولا انتظار في طابور. تُحمَّل الواجهة مباشرةً في متصفحك.
الخطوة 2: ارفع صورتك المرجعية
يأخذ النموذج صورة موجودة مدخلًا أساسيًا له. ارفع أي صورة تريد إنشاء تنويعات مضبوطة لها. قد تكون هذه صورة منتج، أو مرجعًا للأزياء، أو صورة مولّدة من جلسة أخرى، أو أي أصل بصري تريد تكراره.
الخطوة 3: اضبط المعاملات
- قوة الصورة: تتحكم في مدى التزام المخرج بالصورة المرجعية. القيم المنخفضة تسمح بانحراف إبداعي أكبر في اللون والتكوين، أما القيم المرتفعة فتُبقي المخرج مرتبطًا بإحكام ببنية الأصل.
- عدد المخرجات: أنشئ تنويعات متعددة في تشغيل واحد لمقارنة الاتجاهات واختيار النتيجة الأقوى.
- توجيه الأمر النصي: أضف نصًا اختياريًا لتوجيه التنويع نحو أسلوب أو ظرف إضاءة أو مكان محدد.
الخطوة 4: وَلّد وراجع
تظهر النتائج خلال 15 إلى 30 ثانية حسب حجم الطلب على النموذج. نزّل التنويعات التي تريدها مباشرةً من الواجهة، أو استخدمها فورًا مدخلات لأدوات أخرى في المنصة.
💡 اجمع بين Flux Redux Dev والتعديل الموضعي لإصلاح المناطق المحددة التي لم يُحسن التنويع التعامل معها، ثم مرّر النتيجة عبر الدقة الفائقة للحصول على مخرج نهائي بدقة مرفوعة وجاهز للإنتاج.
الخطوة 5: ابنِ سير عمل متعدد النماذج
هنا تتجسد ميزة المنصة بوضوح. خذ مخرج Flux Redux Dev، ومرّره عبر نموذج دقة فائقة 4x، وطبّق إزالة الخلفية إن احتجت إليها لصورة منتج، ثم استخدم النتيجة النظيفة صورةً مرجعيةً في نموذج Wan 2.7 I2V لتوليد نسخة فيديو من الأصل نفسه. يتم كامل سير العمل هذا، من تنويع الصورة إلى مخرج الفيديو، داخل منصة واحدة. وفي منظومة Midjourney، لا يمكن تنفيذ ذلك في أي خطوة تتجاوز الأولى.
لماذا تتفوق منصة واحدة على التنقل بين ستة أدوات
تقوم الحجة لصالح Midjourney على جودة الصورة في جماليته المحددة، وهذه الحجة صحيحة في بعض السياقات. لكنها تنهار حين تسأل عما يأتي بعد ذلك، عندما تحتاج إلى تحريك تلك الصورة أو إزالة خلفيتها أو رفع دقتها للطباعة أو إضافة تعليق صوتي أو تحويلها إلى فيديو بصوت متزامن.
يتضمن الإنتاج الإبداعي الحقيقي خطوات متعددة:
- توليد الصور للمفاهيم والمراجع والأصول البصرية
- تحرير الصور لتحسين تلك المرئيات وإصلاحها وتكييفها مع المتطلبات المحددة
- إنتاج الفيديو لتحريك الصور الثابتة أو وضعها في سياق أو إعادة استخدامها كمحتوى متحرك
- إنشاء الصوت للموسيقى والتعليقات الصوتية وتصميم الصوت عبر كل مخرجات الفيديو
- أدوات الوجوه والجسم لثبات الشخصيات وإنتاج الفيديو الناطق
- الرفع والاستعادة لجودة المخرجات والعمل على الأصول البصرية القديمة
يتولى Midjourney الخطوة الأولى، وأحيانًا بإتقان. أما Picasso AI فتتولى الخطوات الست جميعها، مع أكثر من 91 نموذجًا للصور وحدها لتغطية الخطوة الأولى بتنوع معماري أوسع بكثير.
بالنسبة إلى المبدع المستقل، يشكّل التنقل بين ستة أدوات مختلفة وست اشتراكات مختلفة وست واجهات مختلفة احتكاكًا إنتاجيًا يبطئ المخرجات باستمرار. أما بالنسبة إلى الفريق، فهو يضاعف تكلفة التنسيق ويخلق مشكلات في التحكم بالإصدارات حين تمر الأصول عبر خطوط عمل غير متصلة. إن امتلاك 91 نموذجًا للصور و106 نماذج للفيديو وكل فئة داعمة أخرى في منصة واحدة بواجهة متسقة يغيّر اقتصاديات إنتاج المحتوى بالذكاء الاصطناعي.
النماذج التي لا يملكها Midjourney ليست غامضة أو تجريبية. إنها Veo 3 من Google، وSora 2 من OpenAI، وKling v2.6 من Kwaivgi، وSeedance 2.0 من ByteDance. وهي أكثر نماذج توليد الفيديو قدرةً الموجودة حاليًا. وكلها تعمل على Picasso AI، إلى جانب حزمة تحرير الصور الكاملة وأدوات الصوت وأدوات الذكاء الاصطناعي للوجوه التي تكمل الصورة.
ابدأ الإبداع. اختر أي نموذج، واكتب أمرًا نصيًا، وشاهد ما تنتجه منصة إبداعية متكاملة بالذكاء الاصطناعي فعلًا حين تتوقف عن الاقتصار على أداة واحدة ونوع مخرج واحد. سيتضح الفرق في المرة الأولى التي تحتاج فيها إلى أي شيء يتجاوز الصورة الثابتة.


