Si llevas tiempo usando Midjourney para generar imágenes con IA, te estás especializando en escribir prompts para un solo modelo y un solo tipo de resultado. Y ya está. Mientras tanto, el resto del conjunto creativo de IA (video, audio, edición avanzada, herramientas para rostros, síntesis de voz y más de 90 arquitecturas de imagen distintas) queda totalmente fuera de lo que Midjourney puede ofrecer. Picasso AI tiene todos los modelos que Midjourney no tiene, y no es una diferencia pequeña. Es la diferencia entre una herramienta de un solo propósito y una plataforma completa de producción con IA.
Lo que hace Midjourney (y lo que deja de hacer)
Midjourney es un modelo propietario único. Escribes un prompt y obtienes una imagen con su estilo reconocible. Ese estilo es realmente excelente para ciertas estéticas, por eso millones de personas lo usan. Pero ahí terminan sus capacidades, y entender ese límite es el primer paso para saber qué te estás perdiendo.
Un solo resultado, un solo estilo
En Midjourney no puedes cambiar de modelo. Puedes ajustar las relaciones de aspecto, los pesos de estilo y los parámetros de caos, pero siempre trabajas con el mismo sistema subyacente. Si la estética de Midjourney no encaja con tu proyecto, o si un cliente pide algo con un toque fotorrealista que Midjourney no maneja bien, tendrás que sortear sus limitaciones en lugar de elegir la herramienta adecuada para el trabajo.
No hay texto a video. No hay generación de música con IA. No hay eliminación de fondo. No hay intercambio de rostros. No hay sincronización labial para videos con personas hablando. No hay escalado de super resolución. No hay ControlNet para control de pose o estructura. No hay inpainting ni outpainting más allá de variaciones básicas. La palabra "modelo" en el contexto de Midjourney se refiere a números de versión de la misma arquitectura propietaria, no a sistemas de IA distintos que hacen cosas fundamentalmente diferentes.
Sin acceso al ecosistema abierto de IA
El ecosistema más amplio de creación con IA ha producido docenas de arquitecturas potentes solo en los últimos dos años. Los modelos Flux de Black Forest Labs marcaron nuevos benchmarks en resultados fotorrealistas y en adherencia al prompt. Las variantes de Stable Diffusion y SDXL dieron lugar a todo un ecosistema de modelos ajustados para estéticas concretas. ControlNet hizo posible el control de estructura y pose. Google, OpenAI, ByteDance y Runway lanzaron sistemas de generación de video que producen metraje cinematográfico a partir de prompts de texto.
Midjourney no te da acceso a ninguno de ellos. Cada prompt que envías se queda dentro de sus muros propietarios.
💡 Para creadores que necesitan flexibilidad visual, eso es un límite infranqueable. Para equipos que necesitan un conjunto completo de producción, es un obstáculo insalvable.
La diferencia en el catálogo de modelos es enorme
Aquí la comparación se vuelve concreta. Picasso AI funciona como una plataforma multimodelo, lo que significa que aloja y ejecuta decenas de arquitecturas de IA distintas en varios ámbitos creativos. Tú eliges el modelo que encaja con tu tarea concreta, tus requisitos de salida y tus objetivos estéticos.
Más de 91 modelos de imagen en un solo lugar
La categoría de texto a imagen por sí sola incluye más de 91 modelos. Eso significa una elección real entre arquitecturas, no solo ajustes de parámetros dentro de un mismo sistema:
- Flux Redux Dev para crear variaciones controladas de una imagen de referencia con fidelidad estructural
- GPT Image 2 para resultados fotorrealistas precisos que siguen instrucciones y responden con exactitud a prompts complejos
- Qwen Image Edit Plus para editar y manipular fotos con IA directamente a partir de órdenes en lenguaje natural
- Modelos basados en ControlNet para control de profundidad, coincidencia de pose y conservación de la estructura
Cada uno de estos hace algo significativamente distinto. Algunos están optimizados para el fotorrealismo. Otros, para resultados artísticos y estilizados. Otros, para un control compositivo estricto que mantiene intacta la estructura de una escena mientras cambia su contenido. Midjourney no ofrece nada de esta variedad.
Todas las arquitecturas principales, una sola interfaz
La diferencia práctica se resume en esto: cuando un nuevo modelo sale de Black Forest Labs, Google, OpenAI o de cualquier laboratorio importante de IA, se evalúa y se añade a la plataforma. No tienes que esperar a que un único equipo propietario mejore un solo sistema según su propio calendario. Accedes a todo el campo de la investigación en imagen con IA a medida que avanza.
| Capacidad | Midjourney | Picasso AI |
|---|
| Modelos de imagen | 1 (propietario) | 91+ |
| Generación de video | Ninguna | Más de 106 modelos |
| Audio con IA | Ninguno | Disponible |
| Edición de imágenes | Solo variaciones básicas | Flujo completo |
| Herramientas para rostros y cuerpos | Ninguna | Disponible |
| ControlNet | Ninguno | Disponible |
| Super resolución | Ninguna | De 2x a 4x |
| Eliminación de fondo | Ninguna | Disponible |
| Sincronización labial | Ninguna | Disponible |
Generación de video: la mayor brecha
Esta es la capacidad que crea la distancia más amplia entre las dos plataformas. Midjourney no tiene generación de video. Ni limitada: ninguna.
106 modelos de video y sumando
La categoría de texto a video de Picasso AI incluye más de 106 modelos de los nombres más importantes de la producción de video con IA. No son GIF animados ni clips cortos borrosos. Son videos cinematográficos completos a partir de prompts de texto, con resolución de hasta 4K y audio integrado en algunos modelos.
Algunos de los más destacados:
- Veo 3 de Google: texto a video con generación de audio nativa, que produce sonido sincronizado junto con las imágenes
- Sora 2 de OpenAI: video en HD con resultados sincronizados con el audio y una gran coherencia cinematográfica
- Kling v2.6 de Kwaivgi: resultados cinematográficos en 1080p tanto a partir de prompts de texto como de imágenes
- Seedance 2.0 de ByteDance: texto a video con generación de audio integrada en una sola pasada
- Wan 2.7 T2V: video en 1080p a partir de prompts de texto con una coherencia de movimiento sólida
- LTX 2 Pro: video en 4K a partir de texto con una calidad de nivel profesional
- Gen 4.5 de Runway: movimiento cinematográfico y control de cámara a partir de texto
- Hailuo 02: generación de video con IA nítida en 1080p
- Ray de Luma AI: texto a video rápido y de alta calidad con movimiento fluido
De imágenes fijas a metraje en movimiento
Más allá del texto a video, también puedes animar imágenes existentes en lugar de generar desde cero. Modelos como Wan 2.7 I2V toman una foto y la convierten en un movimiento de video suave y de aspecto natural. Pixverse v5 realiza la misma tarea con un fuerte estilo cinematográfico y opciones de movimiento de cámara.
Para creadores de contenido, equipos de redes sociales, profesionales del marketing y productores de video, esta sola brecha de capacidad hace que Midjourney sea completamente irrelevante para una parte importante de su trabajo diario.
La IA de audio que Midjourney nunca ha tocado
Ni música con IA, ni síntesis de voz, ni transcripción. Midjourney nunca ha operado en el ámbito del audio, y no hay ninguna hoja de ruta que sugiera que algún día lo hará.
Música a partir de un prompt de texto
La categoría de generación de música con IA de Picasso AI te permite crear pistas de audio completas a partir de descripciones escritas. Describe un ambiente, un género, un tempo, la instrumentación o el nivel de energía, y el modelo produce un audio original. Algunos casos de uso prácticos son:
- YouTube y contenido para redes sociales que necesitan pistas de fondo libres de derechos
- Publicidad y campañas de marca que requieren audio personalizado que encaje con el ritmo visual de cada pieza
- Desarrollo de videojuegos para prototipar paisajes sonoros antes de contratar a un compositor
- Cine para probar ideas de banda sonora frente a montajes preliminares
- Producción de podcast y video en la que la música de entrada y de transición es una necesidad constante
Texto a voz y síntesis de voz
La categoría de texto a voz cubre la generación de voces realistas para narraciones, diálogos de personajes y locuciones de marca. La conversión de voz a texto se encarga de los flujos de transcripción para podcasts, entrevistas y contenido de video. Si produces video, tener la generación de locuciones y la transcripción de audio dentro de la misma plataforma que tu producción visual elimina un cuello de botella importante al tener que cambiar de herramienta.
💡 La combinación de generación de imágenes, creación de video, producción musical y síntesis de voz en una sola plataforma es lo que separa una suite creativa de una herramienta de imágenes de un solo uso.
Las herramientas de edición de imagen que Midjourney no puede igualar
Midjourney ha añadido funciones de "vary" y "remix" con el tiempo, pero sus capacidades de edición de imagen siguen siendo ajustes superficiales dentro de sus propios resultados generados. Picasso AI ofrece un flujo completo de edición de imágenes con IA que funciona con cualquier imagen, generada o subida.
Inpainting, outpainting y reemplazo de objetos
Estas tres capacidades forman la base de los flujos de trabajo profesionales de edición de imágenes con IA:
- Inpainting: selecciona cualquier región de una imagen y rellénala con contenido nuevo generado por IA que encaje a la perfección con la zona de alrededor. Corrige errores, cambia objetos, elimina elementos no deseados o añade otros nuevos.
- Outpainting: amplía el lienzo más allá del encuadre original en cualquier dirección. Añade cielo arriba, primer plano abajo o extiende el fondo para crear una composición más amplia a partir de una toma original más ajustada.
- Reemplazo de objetos: describe lo que quieres en lugar de un elemento existente, y la IA lo reemplaza conservando la iluminación, las sombras y todo lo demás de la escena.
Estas no son funciones experimentales. Son herramientas listas para producción que usan a diario diseñadores, fotógrafos y equipos de marketing. El ecosistema cerrado de Midjourney no pone ninguna de estas opciones a disposición de imágenes externas.
Super resolución y restauración de imágenes
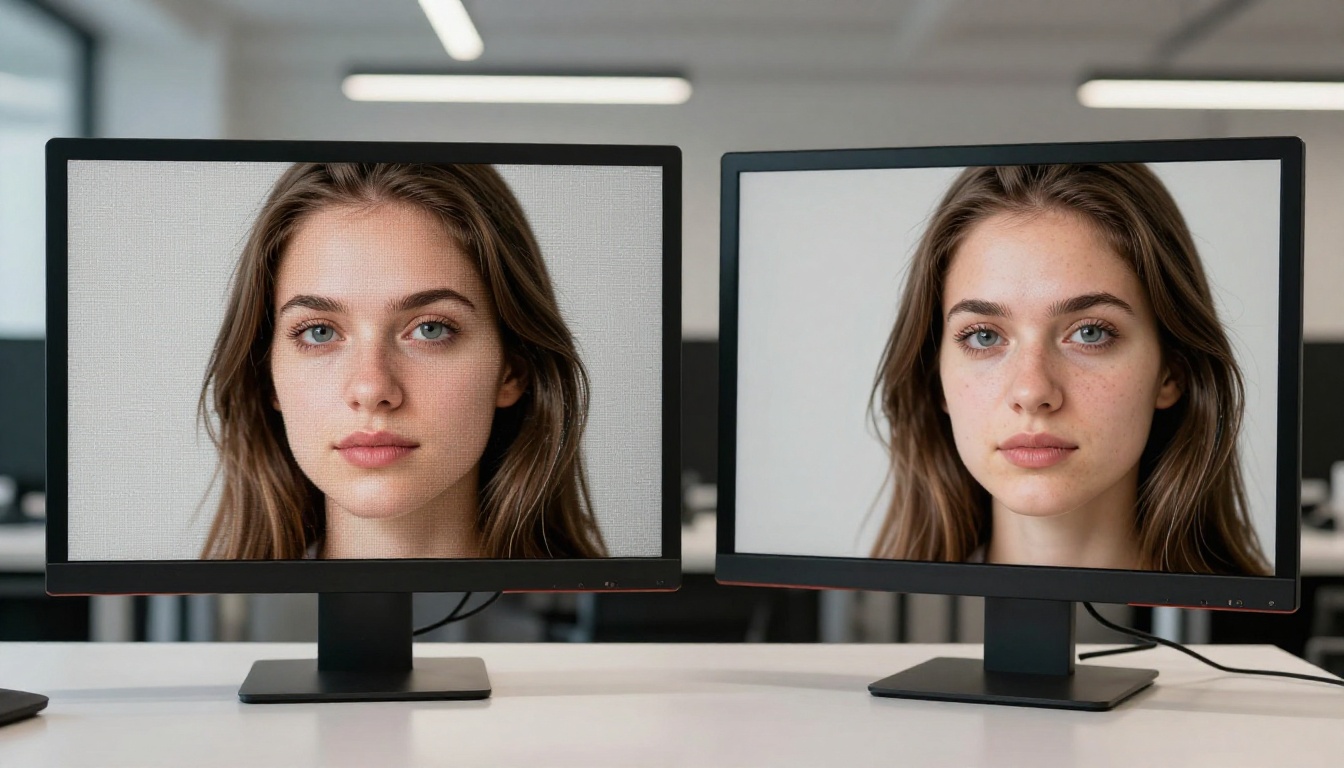
La categoría de super resolución permite el escalado de 2x a 4x con una reconstrucción de detalle auténtica en lugar de una simple interpolación. Los mechones de pelo, la textura de las telas, los poros de la piel y el detalle arquitectónico fino que se difuminan en fuentes de baja resolución se reconstruyen con una fidelidad convincente. Las herramientas de restauración de imagen con IA se ocupan del ruido, el desenfoque, los artefactos de compresión y los daños físicos en fotos existentes.
Para fotógrafos que trabajan con material subexpuesto o de baja resolución, equipos de comercio electrónico que redimensionan imágenes de producto para distintas plataformas y archiveros que digitalizan fotografías históricas, esto es un flujo de trabajo diario y práctico. Midjourney no ofrece nada de eso.
Eliminación de fondo en segundos
La categoría de eliminación de fondos ofrece una separación de fondo instantánea y limpia mediante matting con IA. Sube cualquier foto de producto, retrato o escena, y la IA aísla al sujeto con precisión alrededor del pelo, los bordes complejos y los elementos semitransparentes. Es un flujo de trabajo habitual para fichas de comercio electrónico, recursos de marketing y producción de contenido para redes sociales que Midjourney simplemente no cubre.
Modelos de IA para rostros y cuerpos
Midjourney no toca las herramientas de IA específicas para rostros. No hace intercambios de rostros, generación de avatares parlantes ni videos con sincronización labial. Estas capacidades requieren modelos especializados diseñados para la precisión que exige la estructura facial.
Intercambio de rostros
Face Swap AI te permite reemplazar rostros entre imágenes con resultados fotorrealistas. El modelo gestiona las condiciones de iluminación, la coincidencia del tono de piel, la geometría facial y la fusión de bordes para producir composiciones de aspecto natural. Entre las aplicaciones legítimas están la creación de contenido, la previsualización de películas en las que la disponibilidad de los actores es una limitación y las campañas de marketing que requieren una representación de personajes coherente en todos los recursos visuales.
Sincronización labial para videos con personas hablando
La categoría de sincronización labial sincroniza el movimiento de la boca con cualquier pista de audio o con la salida de texto a voz, con una animación facial realista. Combinada con las capacidades de generación de video y síntesis de voz de la misma plataforma, crea un flujo completo para producir videos con cabeza parlante sin grabar frente a cámara. Para explicativos de marca, demostraciones de producto, doblaje multilingüe y producción de contenido formativo, las implicaciones para el flujo de trabajo son inmediatas.
Cómo usar Flux Redux Dev en Picasso AI
Picasso AI tiene Flux Redux Dev disponible como una de sus herramientas de variación de imagen más versátiles. Este modelo se especializa en generar variaciones controladas de una imagen de referencia manteniendo la coherencia estructural y compositiva, lo que lo hace ideal para iteraciones de fotografía de producto, rondas de diseño de personajes y exploración creativa a partir de un único punto de partida.
Paso 1: abre la página del modelo
Ve a Flux Redux Dev en Picasso AI. Sin complementos, sin servidor de Discord, sin esperar en una cola. La interfaz se carga directamente en tu navegador.
Paso 2: sube tu imagen de referencia
El modelo toma una imagen existente como entrada principal. Sube la foto de la que quieres crear variaciones controladas. Puede ser una toma de producto, una referencia de moda, una imagen generada en otra sesión o cualquier recurso visual que quieras iterar.
Paso 3: ajusta los parámetros
- Intensidad de la imagen: controla cuánto se ajusta el resultado a la referencia. Los valores más bajos permiten más desviación creativa en color y composición; los más altos mantienen el resultado muy anclado a la estructura original.
- Número de resultados: genera varias variaciones en una sola ejecución para comparar direcciones y elegir el resultado más sólido.
- Guía del prompt: añade texto opcional para orientar la variación hacia un estilo, una condición de iluminación o un escenario concreto.
Paso 4: genera y revisa
Los resultados aparecen en 15 a 30 segundos, según la carga del modelo. Descarga directamente desde la interfaz las variaciones que quieras, o úsalas de inmediato como entradas para otras herramientas de la plataforma.
💡 Combina Flux Redux Dev con inpainting para corregir las regiones concretas en las que la variación no acertó y, después, pasa el resultado por la super resolución para obtener una salida final escalada, lista para producción.
Paso 5: crea un flujo de trabajo multimodelo
Aquí es donde la ventaja de la plataforma se vuelve tangible. Toma tu resultado de Flux Redux Dev, pásalo por un modelo de super resolución 4x, aplica la eliminación de fondo si lo necesitas para una foto de producto y, luego, usa el resultado limpio como imagen de referencia para Wan 2.7 I2V y generar una versión en video del mismo recurso. Todo ese flujo, desde la variación de imagen hasta el video final, ocurre dentro de una sola plataforma. En el ecosistema de Midjourney, no es posible en ningún paso más allá del primero.
El argumento a favor de Midjourney se apoya casi por completo en la calidad de imagen de su estética concreta. Ese argumento se sostiene en algunos contextos. Pero se derrumba en cuanto preguntas qué pasa después, cuando necesitas animar esa imagen, eliminar su fondo, escalarla para impresión, añadir una locución o convertirla en un video con audio sincronizado.
La producción creativa real implica varios pasos:
- Generación de imágenes para conceptos, referencias y recursos visuales
- Edición de imágenes para refinar, corregir y adaptar esas imágenes a requisitos concretos
- Producción de video para animar, contextualizar o reutilizar imágenes fijas como contenido en movimiento
- Creación de audio para música, locuciones y diseño de sonido en todos los videos
- Herramientas para rostros y cuerpos para la coherencia de personajes y la producción de videos con cabeza parlante
- Escalado y restauración para la calidad de salida y el trabajo con recursos visuales antiguos
Midjourney se encarga del paso uno, a veces bien. Picasso AI cubre los seis, con más de 91 modelos de imagen solo para el paso uno, con mucha más variedad de arquitecturas.
Para un creador independiente, cambiar entre seis herramientas distintas, seis suscripciones diferentes y seis interfaces diferentes es una fricción de producción que ralentiza el trabajo con regularidad. Para un equipo, multiplica el costo de coordinación y crea problemas de control de versiones cuando los recursos pasan por flujos desconectados. Tener 91 modelos de imagen, 106 modelos de video y todas las categorías de apoyo en una sola plataforma, con una interfaz coherente, cambia la economía de la producción de contenido con IA.
Los modelos que Midjourney no tiene no son poco conocidos ni experimentales. Son Veo 3 de Google, Sora 2 de OpenAI, Kling v2.6 de Kwaivgi y Seedance 2.0 de ByteDance. Estos son los modelos de generación de video más capaces que existen en la actualidad. Todos funcionan en Picasso AI, junto con el conjunto completo de edición de imagen, las herramientas de audio y la IA para rostros que completan el panorama.
Empieza a crear. Elige cualquier modelo, escribe un prompt y mira lo que produce una plataforma creativa de IA completa cuando dejas de estar limitado a un solo tipo de resultado de una sola herramienta. La diferencia se hace evidente la primera vez que necesitas algo más que una imagen fija.


