Si vous utilisez Midjourney pour générer des images par IA, vous devenez de plus en plus habile à saisir des prompts pour un seul modèle, avec un seul type de résultat. C’est tout. Pendant ce temps, le reste de l’ensemble d’outils de création par IA, la vidéo, l’audio, l’édition avancée, les outils de visage, la synthèse vocale et plus de 90 architectures d’images différentes, se trouve entièrement en dehors de ce que Midjourney peut offrir. Picasso AI propose tous les modèles que Midjourney n’a pas, et la différence n’est pas minime. C’est l’écart entre un outil à usage unique et une plateforme de production complète par IA.
Ce que fait Midjourney (et ce qu’il ne fait plus)
Midjourney repose sur un seul modèle propriétaire. Vous saisissez un prompt, et il génère une image dans son style reconnaissable. Ce style est vraiment excellent pour certaines esthétiques, et c’est pour cela que des millions de personnes l’utilisent. Mais ses capacités s’arrêtent là, et comprendre cette limite est la première étape pour savoir ce qui vous manque réellement.
Un seul résultat, un seul style
Vous ne pouvez pas changer de modèle dans Midjourney. Vous pouvez ajuster les formats, les poids de style et les paramètres de chaos, mais vous travaillez toujours avec le même système sous-jacent. Si l’esthétique de Midjourney ne correspond pas à votre projet, ou si un client demande quelque chose de photoréaliste que Midjourney gère mal, vous êtes contraint de contourner ses limites au lieu de choisir l’outil adapté à la tâche.
Il n’existe pas de texte vers vidéo. Pas de génération de musique par IA. Pas de suppression d’arrière-plan. Pas d’échange de visage. Pas de synchronisation labiale pour les vidéos parlées. Pas d’upscaling par super-résolution. Pas de ControlNet pour le contrôle de la pose ou de la structure. Pas d’inpainting ni d’outpainting au-delà de simples variations. Le mot « modèle » dans l’univers de Midjourney désigne des numéros de version d’une même architecture propriétaire, et non des systèmes d’IA différents qui font fondamentalement des choses différentes.
Pas d’accès à l’écosystème ouvert de l’IA
L’écosystème créatif de l’IA a produit des dizaines d’architectures puissantes au cours des deux dernières années seulement. Les modèles Flux de Black Forest Labs ont établi de nouveaux benchmarks pour le rendu photoréaliste et le respect du prompt. Les variantes de Stable Diffusion et SDXL ont donné naissance à tout un écosystème de modèles issus du fine-tuning pour des esthétiques précises. ControlNet a rendu possible le contrôle de la structure et de la pose. Google, OpenAI, ByteDance et Runway ont tous lancé des systèmes de génération de vidéos capables de produire des séquences cinématographiques à partir de prompts textuels.
Midjourney ne vous donne accès à aucun de ces modèles. Chaque prompt que vous envoyez reste enfermé dans ses murs propriétaires.
💡 Pour les créateurs qui ont besoin de souplesse visuelle, c’est un plafond infranchissable. Pour les équipes qui ont besoin d’un ensemble d’outils de production complet, c’est un facteur éliminatoire.
L’écart du catalogue de modèles est énorme
C’est ici que la comparaison devient concrète. Picasso AI fonctionne comme une plateforme multimodèle : elle héberge et exécute des dizaines d’architectures d’IA différentes dans plusieurs domaines créatifs. Vous choisissez le modèle qui correspond à votre tâche précise, à vos exigences de sortie et à vos objectifs esthétiques.
Plus de 91 modèles d’images au même endroit
La catégorie texte vers image seule comprend plus de 91 modèles. Cela signifie un vrai choix entre des architectures, et non de simples réglages de paramètres au sein d’un même système :
- Flux Redux Dev pour créer des variations contrôlées d’une image de référence, avec une fidélité structurelle
- GPT Image 2 pour des rendus photoréalistes précis, qui suivent les instructions et répondent fidèlement à des prompts complexes
- Qwen Image Edit Plus pour la retouche et la manipulation de photos par IA, directement à partir de commandes en langage naturel
- Des modèles basés sur ControlNet pour le contrôle de la profondeur, la correspondance de pose et la préservation de la structure
Chacun de ces modèles produit un résultat sensiblement différent. Certains sont optimisés pour le photoréalisme. D’autres pour des rendus artistiques et stylisés. D’autres encore pour un contrôle compositionnel strict, qui conserve la structure d’une scène tout en changeant son contenu. Midjourney ne propose aucun de ces choix.
Toutes les grandes architectures, une seule interface
La différence concrète tient à ceci : quand un nouveau modèle sort chez Black Forest Labs, Google, OpenAI ou tout autre grand laboratoire d’IA, il est évalué puis ajouté à la plateforme. Vous n’êtes pas condamné à attendre qu’une seule équipe propriétaire améliore un seul système selon son propre calendrier. Vous bénéficiez de l’ensemble de la recherche en génération d’images par IA, au fur et à mesure de son évolution.
| Capacité | Midjourney | Picasso AI |
|---|
| Modèles d’images | 1 (propriétaire) | 91+ |
| Génération de vidéos | Aucune | Plus de 106 modèles |
| Audio IA | Aucun | Disponible |
| Édition d’images | Variations de base uniquement | Chaîne complète |
| Outils de visage et de corps | Aucun | Disponible |
| ControlNet | Aucun | Disponible |
| Super-résolution | Aucune | 2x à 4x |
| Suppression d’arrière-plan | Aucune | Disponible |
| Synchronisation labiale | Aucune | Disponible |
Génération de vidéos : le plus grand écart
C’est la capacité qui creuse le plus grand fossé entre les deux plateformes. Midjourney ne propose aucune génération de vidéos. Pas une génération limitée. Aucune.
106 modèles vidéo, et d’autres à venir
La catégorie texte vers vidéo de Picasso AI comprend plus de 106 modèles, issus des plus grands noms de la production vidéo par IA. Pas de GIF animés ni de courts clips flous. De véritables vidéos cinématographiques à partir de prompts textuels, avec une résolution pouvant atteindre 4K et un audio intégré sur certains modèles.
Quelques modèles phares :
- Veo 3 de Google : texte vers vidéo avec génération audio native, qui produit un son synchronisé avec les images
- Sora 2 d’OpenAI : vidéo HD avec une sortie synchronisée sur l’audio et une forte cohérence cinématographique
- Kling v2.6 de Kwaivgi : rendu cinématographique en 1080p, à partir de prompts textuels comme d’images
- Seedance 2.0 de ByteDance : texte vers vidéo avec génération audio intégrée, en une seule passe de génération
- Wan 2.7 T2V : vidéo en 1080p à partir de prompts textuels, avec une forte cohérence du mouvement
- LTX 2 Pro : vidéo en 4K à partir de texte, avec une qualité de rendu de niveau professionnel
- Gen 4.5 de Runway : mouvement cinématographique et contrôle de la caméra à partir d’un texte
- Hailuo 02 : génération de vidéos IA nette en 1080p
- Ray de Luma AI : texte vers vidéo rapide et de haute qualité, avec des mouvements fluides
Des images fixes aux séquences animées
Au-delà du texte vers vidéo, vous pouvez aussi animer des images existantes plutôt que de tout générer depuis zéro. Des modèles comme Wan 2.7 I2V transforment une photo en un mouvement vidéo fluide et naturel. Pixverse v5 remplit la même tâche, avec un style cinématographique marqué et des options de mouvement de caméra.
Pour les créateurs de contenu, les équipes de réseaux sociaux, les spécialistes du marketing et les producteurs vidéo, cet écart sur une seule capacité rend Midjourney totalement hors sujet pour une part importante de leur travail quotidien.
L’audio IA que Midjourney n’a jamais abordé
Pas de musique IA. Pas de synthèse vocale. Pas de transcription. Midjourney n’a jamais opéré dans le domaine audio, et rien dans sa feuille de route ne laisse penser qu’il le fera un jour.
De la musique à partir d’un prompt textuel
La catégorie de génération de musique par IA de Picasso AI vous permet de créer des pistes audio complètes à partir de descriptions écrites. Décrivez une ambiance, un genre, un tempo, une instrumentation ou un niveau d’énergie, et le modèle produit une sortie audio originale. Voici quelques cas d’usage concrets :
- YouTube et contenus sociaux nécessitant des pistes de fond libres de droits
- Publicité et campagnes de marque ayant besoin d’un audio sur mesure qui suit le rythme des images
- Développement de jeux vidéo pour prototyper des ambiances sonores avant de faire appel à un compositeur
- Cinéma pour tester des idées de bande originale sur des montages provisoires
- Production de podcasts et de vidéos où la musique d’intro et de transition est un besoin constant
Synthèse vocale et voix de synthèse
La catégorie synthèse vocale couvre la génération de voix réalistes pour la narration, les dialogues de personnages et les voix off de marque. La reconnaissance vocale prend en charge la transcription pour les podcasts, les interviews et les contenus vidéo. Si vous produisez une vidéo, disposer de la génération de voix off et de la transcription audio dans la même plateforme que votre production visuelle supprime un obstacle important : le changement constant d’outils.
💡 La combinaison de la génération d’images, de la création de vidéos, de la production musicale et de la synthèse vocale sur une même plateforme fait la différence entre une suite créative et un simple outil d’images.
Les outils d’édition d’images que Midjourney ne peut pas égaler
Midjourney a ajouté au fil du temps les fonctions « vary » et « remix », mais ses capacités d’édition restent des ajustements superficiels sur ses propres résultats générés. Picasso AI propose une chaîne complète d’édition d’images par IA, qui fonctionne sur n’importe quelle image, générée ou importée.
Inpainting, outpainting, remplacement d’objets
Ces trois capacités constituent le socle des flux de travail professionnels d’édition d’images par IA :
- Inpainting : sélectionnez une zone de l’image et remplissez-la avec un contenu généré par IA qui se fond parfaitement dans l’environnement. Corrigez des erreurs, remplacez des objets, supprimez des éléments indésirables ou ajoutez-en de nouveaux.
- Outpainting : élargissez le cadre au-delà de l’image d’origine, dans n’importe quelle direction. Ajoutez du ciel au-dessus, du premier plan en dessous, ou prolongez l’arrière-plan pour créer une composition plus large à partir d’une prise de vue plus serrée.
- Remplacement d’objets : décrivez ce que vous voulez à la place d’un élément existant, et l’IA le remplace tout en préservant l’éclairage, les ombres et le reste de la scène.
Ce ne sont pas des fonctions expérimentales. Ce sont des outils de production utilisés au quotidien par des designers, des photographes et des équipes marketing. L’écosystème fermé de Midjourney ne permet d’en utiliser aucun sur des images externes.
Super-résolution et restauration d’images
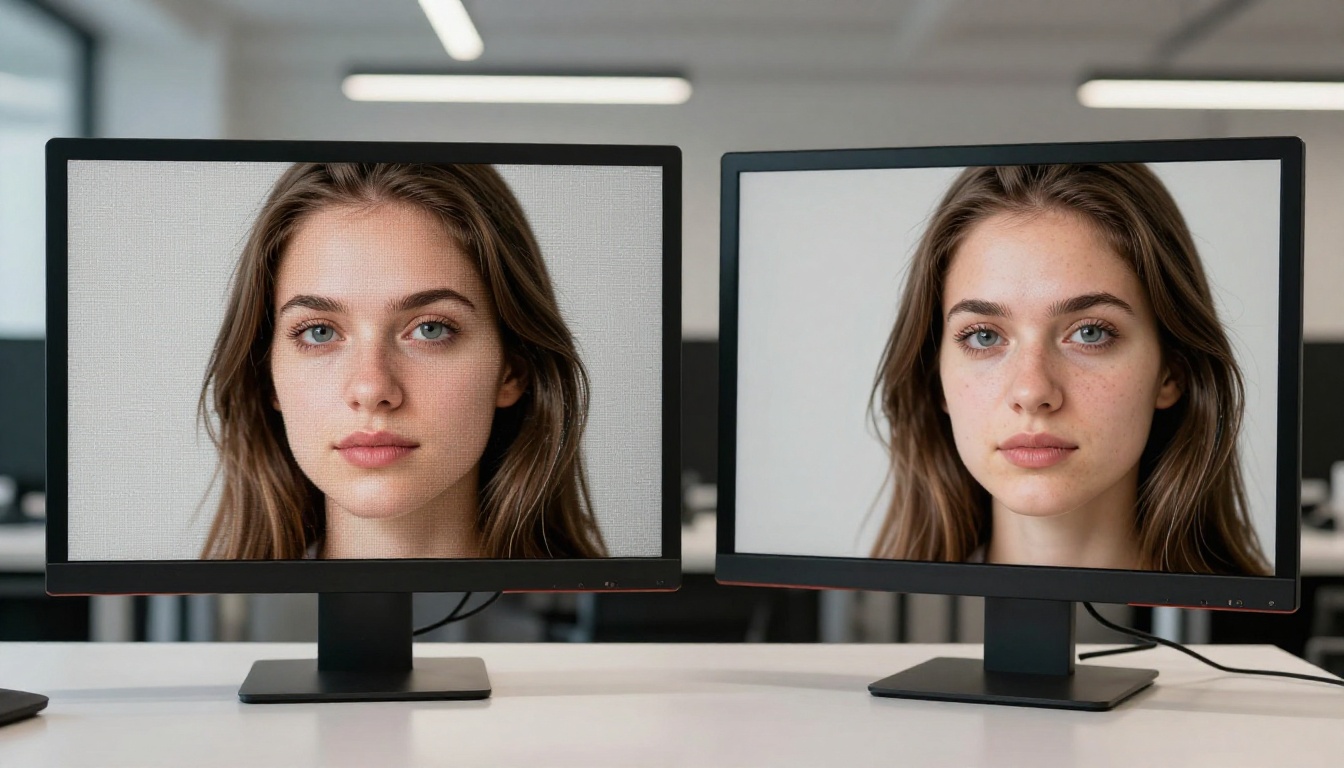
La catégorie super-résolution gère l’upscaling de 2x à 4x avec une reconstruction réelle des détails, et non une simple interpolation. Les mèches de cheveux, la texture des tissus, les pores de la peau et les détails architecturaux fins, qui se brouillent dans les sources basse résolution, sont reconstruits avec une fidélité convaincante. Les outils de restauration d’images par IA traitent le bruit, le flou, les artefacts de compression et les dégradations physiques des photos existantes.
Pour les photographes qui travaillent à partir de matériaux sous-exposés ou de faible résolution, les équipes e-commerce qui redimensionnent des visuels produits pour différentes plateformes, et les archivistes qui numérisent des photographies anciennes, c’est un flux de travail quotidien et concret. Midjourney n’en propose aucun.
Suppression d’arrière-plan en quelques secondes
La catégorie de suppression d’arrière-plan assure une séparation instantanée et propre du sujet grâce au détourage par IA. Importez n’importe quelle photo de produit, de portrait ou de scène, et l’IA isole le sujet avec précision, y compris les cheveux, les contours complexes et les éléments semi-transparents. C’est un flux de travail standard pour les fiches e-commerce, les visuels marketing et la production de contenus sociaux, que Midjourney ne traite tout simplement pas.
Modèles d’IA pour les visages et les corps
Midjourney ne touche pas aux outils d’IA dédiés aux visages. Il ne propose ni échange de visage, ni génération d’avatars parlants, ni synchronisation labiale pour les vidéos. Ces capacités exigent des modèles spécialisés, conçus pour la précision que demande la structure du visage.
Échange de visage
Face Swap AI vous permet de remplacer des visages entre des images, avec des résultats photoréalistes. Le modèle gère les conditions d’éclairage, la correspondance des tons de peau, la géométrie du visage et la fusion des bords pour produire des montages naturels. Les usages légitimes incluent la création de contenus, la prévisualisation de films lorsque la disponibilité des comédiens est une contrainte, et les campagnes marketing qui exigent une représentation cohérente des personnages sur l’ensemble des visuels.
Synchronisation labiale pour les vidéos parlées
La catégorie de synchronisation labiale synchronise les mouvements de la bouche avec n’importe quelle piste audio ou sortie de synthèse vocale, avec une animation faciale réaliste. Associée aux capacités de génération de vidéos et de synthèse vocale de la même plateforme, elle crée une chaîne complète pour produire des vidéos de présentateur sans tournage en face caméra. Pour les vidéos explicatives de marque, les démonstrations de produits, le doublage multilingue et les contenus de formation, les conséquences pratiques sont immédiates.
Picasso AI propose Flux Redux Dev comme l’un de ses outils de variation d’images les plus polyvalents. Ce modèle est spécialisé dans la génération de variations contrôlées d’une image de référence, tout en conservant la cohérence structurelle et compositionnelle. Il convient donc parfaitement aux itérations de photographie produit, aux cycles de conception de personnages et à l’exploration créative à partir d’un point de départ unique.
Étape 1 : ouvrir la page du modèle
Rendez-vous sur Flux Redux Dev sur Picasso AI. Pas d’extensions, pas de serveur Discord, pas d’attente dans une file. L’interface se charge directement dans votre navigateur.
Étape 2 : importer votre image de référence
Le modèle prend une image existante comme entrée principale. Importez la photo dont vous voulez créer des variations contrôlées. Il peut s’agir d’une photo de produit, d’une référence de mode, d’une image générée lors d’une autre session ou de tout visuel que vous souhaitez retravailler.
Étape 3 : ajuster les paramètres
- Force de l’image : contrôle à quel point le résultat suit la référence. Des valeurs basses laissent plus de liberté créative sur la couleur et la composition ; des valeurs élevées maintiennent le résultat étroitement ancré à la structure d’origine.
- Nombre de sorties : générez plusieurs variations en une seule passe pour comparer les directions et sélectionner le meilleur résultat.
- Guidage par prompt : ajoutez un texte facultatif pour orienter la variation vers un style, une condition d’éclairage ou un décor précis.
Étape 4 : générer et vérifier
Les résultats apparaissent en 15 à 30 secondes, selon la charge du modèle. Téléchargez directement depuis l’interface les variations que vous voulez garder, ou utilisez-les immédiatement comme entrées pour d’autres outils de la plateforme.
💡 Combinez Flux Redux Dev avec l’inpainting pour corriger les zones que la variation n’a pas bien rendues, puis passez le résultat en super-résolution pour obtenir une sortie upscalée, prête pour la production.
Étape 5 : construire un flux de travail multimodèle
C’est ici que l’avantage de la plateforme devient tangible. Prenez votre sortie Flux Redux Dev, passez-la dans un modèle de super-résolution 4x, supprimez l’arrière-plan si nécessaire pour une photo de produit, puis utilisez le résultat nettoyé comme image de référence pour Wan 2.7 I2V afin de générer une version vidéo du même visuel. Tout ce parcours, de la variation d’image à la sortie vidéo, se déroule au sein d’une seule plateforme. Dans l’écosystème de Midjourney, ce n’est possible à aucune étape au-delà de la première.
L’argument en faveur de Midjourney repose presque entièrement sur la qualité d’image de son esthétique particulière. Cet argument tient dans certains contextes. Mais il s’effondre dès que vous vous demandez ce qui se passe ensuite, quand il faut animer cette image, supprimer son arrière-plan, l’upscaler pour l’impression, ajouter une voix off ou en faire une vidéo avec un son synchronisé.
La production créative réelle implique plusieurs étapes :
- Génération d’images pour les concepts, les références et les visuels
- Édition d’images pour affiner, corriger et adapter ces visuels à des exigences précises
- Production vidéo pour animer, contextualiser ou réutiliser des images fixes sous forme de contenu en mouvement
- Création audio pour la musique, les voix off et le sound design de toutes les vidéos
- Outils de visage et de corps pour la cohérence des personnages et la production de vidéos de présentateur
- Upscaling et restauration pour la qualité des sorties et le travail sur des visuels anciens
Midjourney couvre la première étape, parfois très bien. Picasso AI couvre les six, avec plus de 91 modèles d’images rien que pour la première étape, pour une variété d’architectures bien plus grande.
Pour un créateur indépendant, passer de six outils, six abonnements et six interfaces différents constitue une friction de production qui ralentit systématiquement le travail. Pour une équipe, cela multiplie les coûts de coordination et crée des problèmes de gestion de versions lorsque les ressources passent par des chaînes déconnectées. Disposer de 91 modèles d’images, de 106 modèles vidéo et de toutes les catégories complémentaires au sein d’une seule plateforme, avec une interface cohérente, change l’économie de la production de contenus assistée par IA.
Les modèles qui manquent à Midjourney ne sont ni obscurs ni expérimentaux. Il s’agit de Veo 3 de Google, Sora 2 d’OpenAI, Kling v2.6 de Kwaivgi et Seedance 2.0 de ByteDance. Ce sont les modèles de génération de vidéos les plus performants qui existent aujourd’hui. Ils fonctionnent tous sur Picasso AI, aux côtés de la chaîne complète d’édition d’images, des outils audio et des outils de visage IA qui complètent le tableau.
Commencez à créer. Choisissez un modèle, saisissez un prompt et découvrez ce que produit réellement une plateforme créative complète par IA, dès que vous cessez de vous limiter à un seul type de résultat issu d’un seul outil. La différence devient évidente la première fois que vous avez besoin de quelque chose de plus qu’une image fixe.


