Se você usa o Midjourney para gerar imagens com IA, está ficando bom em fazer prompts para um único modelo com um único tipo de saída. Só isso. Enquanto isso, o restante do conjunto de ferramentas criativas de IA, com vídeo, áudio, edição avançada, ferramentas de rosto, síntese de fala e mais de 90 arquiteturas diferentes de imagem, existe totalmente fora do que o Midjourney pode oferecer. O Picasso AI tem todos os modelos que o Midjourney não tem, e essa não é uma diferença pequena. É a diferença entre uma ferramenta de uso único e uma plataforma completa de produção com IA.
O que o Midjourney faz (e para de fazer)
O Midjourney é um modelo proprietário único. Você escreve um prompt, e ele gera uma imagem no estilo próprio e reconhecível dele. Esse estilo é genuinamente excelente para certas estéticas, e é por isso que milhões de pessoas o usam. Mas é aí que as capacidades dele terminam, e entender esse limite é o primeiro passo para saber o que você realmente está deixando de fazer.
Uma saída, um estilo
No Midjourney, você não pode trocar de modelo. Dá para ajustar proporções, pesos de estilo e parâmetros de caos, mas você está sempre trabalhando com o mesmo sistema por trás. Se a estética do Midjourney não combina com o seu projeto, ou se um cliente pede algo que tende ao fotorrealismo de um jeito que o Midjourney não lida bem, você fica preso contornando as limitações dele, em vez de escolher a ferramenta certa para o trabalho.
Não existe texto para vídeo. Não há geração de música com IA. Não há remoção de fundo. Não há troca de rosto. Não há sincronização labial para vídeos com pessoas falando. Não há aumento de resolução (super resolution). Não há ControlNet para controle de pose ou estrutura. Não há inpainting nem outpainting além de variações básicas. A palavra "modelo" no contexto do Midjourney se refere a números de versão da mesma arquitetura proprietária, e não a sistemas de IA diferentes fazendo coisas fundamentalmente diferentes.
Sem acesso ao ecossistema de IA de código aberto
O ecossistema criativo de IA mais amplo produziu dezenas de arquiteturas poderosas só nos últimos dois anos. Os modelos Flux, da Black Forest Labs, estabeleceram novos benchmarks para resultados fotorrealistas e aderência ao prompt. As variantes do Stable Diffusion e o SDXL viabilizaram todo um ecossistema de modelos com fine-tuning para estéticas específicas. O ControlNet tornou possível o controle de estrutura e pose. Google, OpenAI, ByteDance e Runway lançaram sistemas de geração de vídeo que produzem filmagens cinematográficas a partir de prompts de texto.
O Midjourney não dá acesso a nenhum deles. Cada prompt que você envia fica dentro dos muros proprietários dele.
💡 Para criadores que precisam de flexibilidade visual, isso é um teto rígido. Para equipes que precisam de um conjunto completo de produção, é um fator decisivo.
A diferença do catálogo de modelos é enorme
É aqui que a comparação fica concreta. O Picasso AI funciona como uma plataforma multimodelo, o que significa que ele hospeda e executa dezenas de arquiteturas de IA diferentes em vários domínios criativos. Você escolhe o modelo que se encaixa na sua tarefa específica, nos seus requisitos de saída e nos seus objetivos estéticos.
Mais de 91 modelos de imagem num só lugar
Só a categoria de texto para imagem inclui mais de 91 modelos. Isso significa escolha real entre arquiteturas, e não apenas ajustes de parâmetros dentro de um único sistema:
- Flux Redux Dev para criar variações controladas de imagem a partir de uma referência, com fidelidade estrutural
- GPT Image 2 para saídas fotorrealistas precisas, que seguem instruções e respondem com exatidão a prompts complexos
- Qwen Image Edit Plus para edição e manipulação de fotos com IA, diretamente a partir de comandos em linguagem natural
- Modelos baseados em ControlNet para controle de profundidade, correspondência de pose e preservação de estrutura
Cada um desses faz algo significativamente diferente. Alguns são otimizados para fotorrealismo. Outros, para saídas artísticas e estilizadas. Outros ainda, para um controle composicional rigoroso, que mantém a estrutura de uma cena intacta enquanto muda o conteúdo. O Midjourney não oferece nenhuma dessas opções.
Todas as grandes arquiteturas, uma só interface
A diferença prática se resume a isto: quando um novo modelo é lançado pela Black Forest Labs, pelo Google, pela OpenAI ou por qualquer grande laboratório de IA, ele é avaliado e adicionado à plataforma. Você não fica preso esperando que uma única equipe proprietária melhore um único sistema no tempo dela. Você acompanha o campo inteiro da pesquisa em geração de imagens conforme ele avança.
| Capacidade | Midjourney | Picasso AI |
|---|
| Modelos de imagem | 1 (proprietário) | 91+ |
| Geração de vídeo | Nenhuma | 106+ modelos |
| Áudio com IA | Nenhum | Disponível |
| Edição de imagem | Apenas variações básicas | Pipeline completo |
| Ferramentas de rosto e corpo | Nenhuma | Disponível |
| ControlNet | Nenhum | Disponível |
| Super resolution | Nenhum | 2x a 4x |
| Remoção de fundo | Nenhum | Disponível |
| Sincronização labial | Nenhum | Disponível |
Geração de vídeo: a maior lacuna
Esta é a capacidade que cria a maior distância entre as duas plataformas. O Midjourney não tem geração de vídeo. Nem limitada. Nenhuma.
106 modelos de vídeo e contando
A categoria de texto para vídeo do Picasso AI inclui mais de 106 modelos dos maiores nomes da produção de vídeo com IA. Nada de GIFs animados ou clipes curtos e borrados. Vídeo cinematográfico completo a partir de prompts de texto, com resolução de até 4K e áudio integrado em modelos selecionados.
Alguns destaques:
- Veo 3, do Google: texto para vídeo com geração de áudio nativa, produzindo som sincronizado com as imagens
- Sora 2, da OpenAI: vídeo em HD com saída sincronizada com áudio e forte consistência cinematográfica
- Kling v2.6, da Kwaivgi: saída cinematográfica em 1080p, a partir de prompts de texto e de imagens
- Seedance 2.0, da ByteDance: texto para vídeo com geração de áudio integrada em uma única passagem
- Wan 2.7 T2V: vídeo em 1080p a partir de prompts de texto, com forte consistência de movimento
- LTX 2 Pro: vídeo em 4K a partir de texto, com qualidade de saída de nível profissional
- Gen 4.5, da Runway: movimento cinematográfico e controle de câmera a partir de texto
- Hailuo 02: geração de vídeo com IA nítida em 1080p
- Ray, da Luma AI: texto para vídeo rápido e de alta qualidade, com movimento suave
De imagens estáticas a imagens em movimento
Além do texto para vídeo, você também pode animar imagens existentes em vez de gerar do zero. Modelos como o Wan 2.7 I2V pegam uma foto e a transformam em movimento de vídeo suave e de aparência natural. O Pixverse v5 faz a mesma tarefa com forte estilo cinematográfico e opções de movimento de câmera.
Para criadores de conteúdo, equipes de redes sociais, profissionais de marketing e produtores de vídeo, essa única lacuna de capacidade torna o Midjourney completamente irrelevante para uma parte significativa do trabalho do dia a dia.
A IA de áudio que o Midjourney nunca tocou
Nada de música com IA. Nada de síntese de voz. Nada de transcrição. O Midjourney nunca atuou no domínio do áudio, e não há nenhum roteiro indicando que vá atuar.
Música a partir de um prompt de texto
A categoria de geração de música com IA do Picasso AI permite criar faixas de áudio completas a partir de descrições escritas. Descreva um clima, gênero, andamento, instrumentação ou nível de energia, e o modelo produz um áudio original. Casos de uso práticos incluem:
- YouTube e conteúdo para redes sociais que precisam de trilhas de fundo livres de royalties
- Publicidade e campanhas de marca que precisam de áudio personalizado que combine com o ritmo visual específico
- Desenvolvimento de jogos para prototipar paisagens sonoras antes de contratar um compositor
- Cinema para testar ideias de trilha sonora contra cortes preliminares
- Produção de podcast e vídeo em que música de abertura e de transição é uma necessidade constante
Texto para fala e síntese de voz
A categoria de texto para fala cobre a geração de voz realista para narração, diálogos de personagens e voz de marca. A fala para texto cuida dos fluxos de transcrição de podcasts, entrevistas e conteúdo em vídeo. Se você produz vídeo, ter a geração de narração e a transcrição de áudio na mesma plataforma da sua produção visual elimina um gargalo significativo de troca de ferramentas.
💡 A combinação de geração de imagens, criação de vídeo, produção musical e síntese de voz numa só plataforma é o que separa uma suíte criativa de uma ferramenta de imagem de uso único.
Ferramentas de edição de imagem que o Midjourney não alcança
O Midjourney acrescentou os recursos "vary" e "remix" ao longo do tempo, mas as capacidades de edição de imagem dele continuam sendo ajustes superficiais dentro das próprias saídas geradas. O Picasso AI oferece um pipeline completo de edição de imagem com IA, que funciona com qualquer imagem, gerada ou enviada.
Inpainting, outpainting, substituição de objetos
Essas três capacidades formam a base dos fluxos profissionais de edição de imagem com IA:
- Inpainting: selecione qualquer região de uma imagem e preencha-a com conteúdo novo gerado por IA que combine perfeitamente com a área ao redor. Corrija erros, troque objetos, remova elementos indesejados ou adicione novos.
- Outpainting: expanda a tela além do quadro original em qualquer direção. Adicione céu acima, primeiro plano abaixo ou estenda o fundo para criar uma composição mais ampla a partir de uma foto original mais fechada.
- Substituição de objetos: descreva o que você quer no lugar de um elemento existente, e a IA o substitui preservando iluminação, sombras e tudo o mais na cena.
Esses não são recursos experimentais. São ferramentas prontas para produção, usadas diariamente por designers, fotógrafos e equipes de marketing. O ecossistema fechado do Midjourney não disponibiliza nenhuma dessas opções em imagens externas.
Super resolution e restauração de imagem
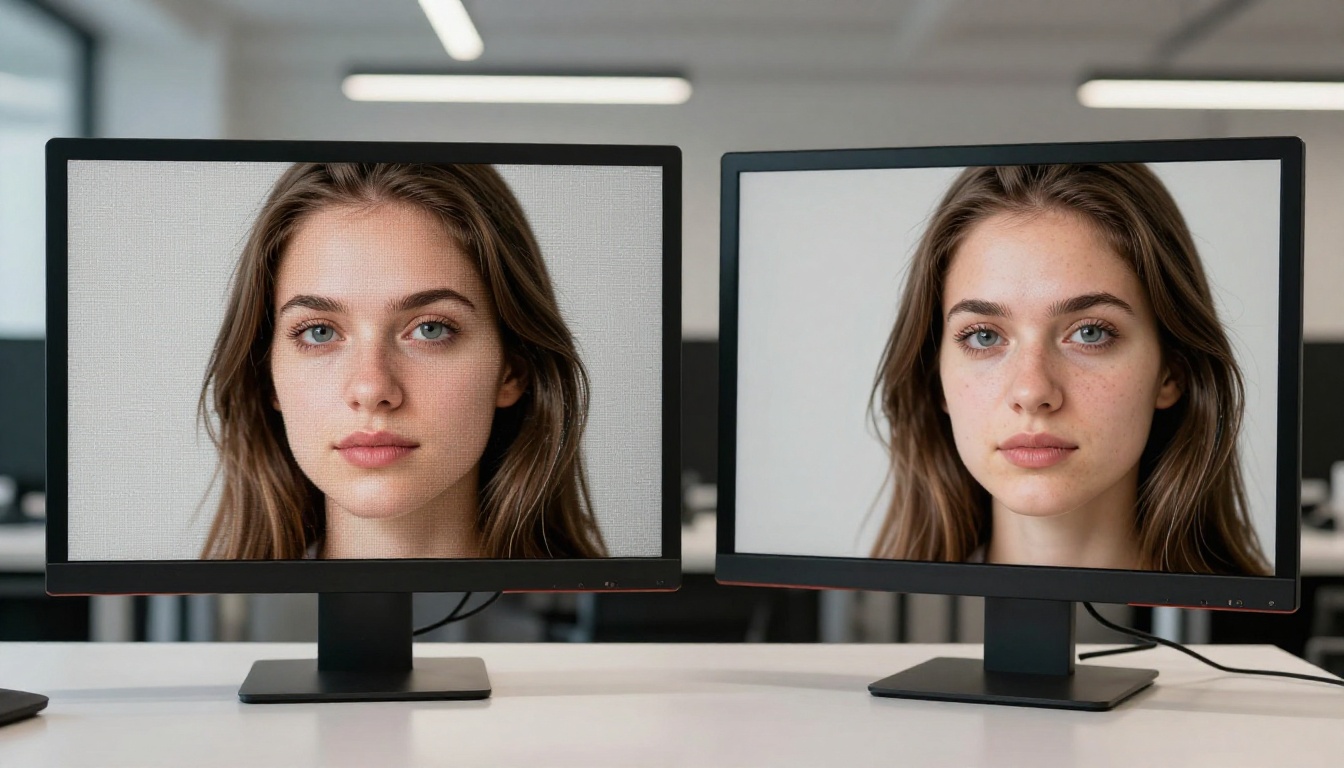
A categoria de super resolution faz aumento de resolução de 2x a 4x com reconstrução real de detalhes, em vez de simples interpolação. Fios de cabelo, textura de tecido, poros da pele e detalhes arquitetônicos finos que ficam borrados em fontes de baixa resolução são reconstruídos com fidelidade convincente. Ferramentas de restauração de imagem com IA tratam ruído, desfoque, artefatos de compressão e danos físicos em fotos existentes.
Para fotógrafos que trabalham com material subexposto ou de baixa resolução, equipes de e-commerce que redimensionam imagens de produtos para diferentes plataformas e arquivistas que digitalizam fotografias históricas, isso é um fluxo prático do dia a dia. O Midjourney não oferece nada disso.
Remoção de fundo em segundos
A categoria de remoção de fundo oferece separação instantânea e limpa do fundo usando matting com IA. Envie qualquer foto de produto, retrato ou cena, e a IA isola o sujeito com precisão em torno de cabelos, bordas complexas e elementos semitransparentes. Isso é um fluxo padrão para anúncios de e-commerce, materiais de marketing e produção de conteúdo para redes sociais, algo que o Midjourney simplesmente não contempla.
Modelos de IA para rosto e corpo
O Midjourney não mexe em ferramentas de IA específicas para rostos. Ele não faz trocas de rosto, geração de avatares falantes nem vídeo com sincronização labial. Essas capacidades exigem modelos especializados, criados para a precisão que a estrutura facial demanda.
Tecnologia de troca de rosto
O Face Swap AI permite trocar rostos entre imagens com resultados fotorrealistas. O modelo lida com condições de iluminação, correspondência de tom de pele, geometria facial e mesclagem de bordas para produzir composições de aparência natural. Aplicações legítimas incluem criação de conteúdo, pré-visualização de filmes em que a disponibilidade de elenco é uma limitação e campanhas de marketing que exigem representação consistente de personagens em diferentes peças visuais.
Sincronização labial para vídeos falados
A categoria de sincronização labial sincroniza o movimento da boca com qualquer faixa de áudio ou saída de texto para fala, com animação facial realista. Combinada com as capacidades de geração de vídeo e síntese de voz na mesma plataforma, isso cria um pipeline completo para produzir vídeos de pessoas falando sem gravar diante da câmera. Para vídeos explicativos de marcas, demonstrações de produtos, dublagem multilíngue e produção de conteúdo de treinamento, as implicações no fluxo de trabalho são imediatas.
Como usar o Flux Redux Dev no Picasso AI
O Picasso AI tem o Flux Redux Dev disponível como uma de suas ferramentas de variação de imagem mais versáteis. Esse modelo é especializado em gerar variações controladas de uma imagem de referência mantendo a consistência estrutural e composicional, o que o torna ideal para iterações de fotografia de produto, rodadas de criação de personagens e exploração criativa a partir de um único ponto de partida.
Passo 1: abra a página do modelo
Acesse o Flux Redux Dev no Picasso AI. Sem plugins, sem servidor no Discord, sem fila de espera. A interface carrega direto no seu navegador.
Passo 2: envie sua imagem de referência
O modelo recebe uma imagem existente como entrada principal. Envie qualquer foto da qual você queira criar variações controladas. Pode ser uma foto de produto, uma referência de moda, uma imagem gerada em outra sessão ou qualquer recurso visual que você queira iterar.
Passo 3: ajuste os parâmetros
- Força da imagem: controla o quanto a saída segue a referência. Valores mais baixos permitem mais desvio criativo em cor e composição; valores mais altos mantêm a saída firmemente ancorada na estrutura original.
- Número de saídas: gere várias variações em uma única execução para comparar direções e escolher o resultado mais forte.
- Orientação do prompt: adicione um texto opcional para direcionar a variação a um estilo, uma condição de iluminação ou um cenário específico.
Passo 4: gere e revise
Os resultados aparecem em 15 a 30 segundos, dependendo da carga do modelo. Baixe as variações que quiser diretamente pela interface ou use-as imediatamente como entradas de outras ferramentas da plataforma.
💡 Combine o Flux Redux Dev com inpainting para corrigir regiões específicas que a variação não acertou, e depois passe o resultado por super resolution para obter uma saída final com aumento de resolução, pronta para produção.
Passo 5: monte um fluxo de trabalho multimodelo
É aqui que a vantagem da plataforma se torna tangível. Pegue a saída do Flux Redux Dev, passe-a por um modelo de super resolution 4x, aplique remoção de fundo se necessário para uma foto de produto e, em seguida, use o resultado limpo como imagem de referência para o Wan 2.7 I2V gerar uma versão em vídeo do mesmo recurso. Todo esse fluxo, da variação de imagem à saída em vídeo, acontece dentro de uma única plataforma. No ecossistema do Midjourney, isso não é possível em nenhuma etapa além da primeira.
O argumento a favor do Midjourney se apoia quase inteiramente na qualidade de imagem para a estética específica dele. Esse argumento se sustenta em alguns contextos. Mas ele desmorona no momento em que você pergunta o que vem depois, quando precisa animar essa imagem, remover o fundo, aumentar a resolução para impressão, adicionar uma narração ou transformá-la em um vídeo com áudio sincronizado.
A produção criativa real envolve várias etapas:
- Geração de imagens para conceitos, referências e recursos visuais
- Edição de imagem para refinar, corrigir e adaptar essas imagens a requisitos específicos
- Produção de vídeo para animar, contextualizar ou reaproveitar imagens estáticas como conteúdo em movimento
- Criação de áudio para música, narrações e design sonoro em todas as saídas de vídeo
- Ferramentas de rosto e corpo para consistência de personagem e produção de vídeos com pessoas falando
- Aumento de resolução e restauração para a qualidade da saída e para trabalhar com materiais visuais antigos
O Midjourney cobre a primeira etapa, às vezes bem. O Picasso AI cobre as seis, com mais de 91 modelos de imagem só para a primeira etapa, com muito mais variedade de arquiteturas.
Para um criador solo, alternar entre seis ferramentas diferentes, seis assinaturas diferentes e seis interfaces diferentes é um atrito de produção que atrasa a entrega de forma constante. Para uma equipe, isso multiplica o custo de coordenação e cria problemas de controle de versão quando os recursos passam por fluxos desconectados. Ter 91 modelos de imagem, 106 modelos de vídeo e todas as categorias de apoio numa única plataforma, com uma interface consistente, muda a economia da produção de conteúdo com IA.
Os modelos que o Midjourney não tem não são obscuros nem experimentais. São o Veo 3, do Google, o Sora 2, da OpenAI, o Kling v2.6, da Kwaivgi, e o Seedance 2.0, da ByteDance. São os modelos de geração de vídeo mais capazes que existem hoje. Todos rodam no Picasso AI, junto com o conjunto completo de edição de imagem, as ferramentas de áudio e a IA para rosto que completam o quadro.
Comece a criar. Escolha qualquer modelo, digite um prompt e veja o que uma plataforma criativa completa com IA realmente produz quando você deixa de ficar limitado a um único tipo de saída de uma única ferramenta. A diferença fica clara na primeira vez que você precisar de algo além de uma imagem estática.


