अगर आप AI-जनरेटेड इमेज के लिए Midjourney इस्तेमाल कर रहे हैं, तो आप एक ही आउटपुट प्रकार के लिए एक ही मॉडल को प्रॉम्प्ट करने में माहिर होते जा रहे हैं। बस इतना ही। इस बीच AI क्रिएटिव स्टैक का बाकी हिस्सा, यानी वीडियो, ऑडियो, एडवांस्ड एडिटिंग, फ़ेस टूल्स, स्पीच सिंथेसिस और 90 से ज़्यादा अलग-अलग इमेज आर्किटेक्चर, Midjourney की पहुँच से पूरी तरह बाहर है। Picasso AI में वह हर मॉडल है जो Midjourney में नहीं है, और यह कोई छोटा फ़र्क नहीं है। यह एक ही उद्देश्य वाले टूल और एक पूरे AI प्रोडक्शन प्लेटफ़ॉर्म के बीच का फ़र्क है।
Midjourney क्या करता है (और कहाँ रुक जाता है)
Midjourney एक एकल मालिकाना मॉडल है। आप प्रॉम्प्ट लिखते हैं, और वह अपनी खास पहचान वाली शैली में इमेज बनाता है। यह शैली कुछ सौंदर्य-दृष्टियों के लिए वाकई बेहतरीन है, इसीलिए लाखों लोग इसे इस्तेमाल करते हैं। लेकिन उसकी क्षमताएँ वहीं खत्म हो जाती हैं, और उस सीमा को समझना यह जानने का पहला कदम है कि आप असल में क्या खो रहे हैं।
एक आउटपुट, एक स्टाइल
Midjourney में आप मॉडल नहीं बदल सकते। आप आस्पेक्ट रेशियो, स्टाइल वेट और केऑस पैरामीटर बदल सकते हैं, लेकिन आप हमेशा एक ही अंतर्निहित सिस्टम के साथ काम करते हैं। अगर Midjourney की शैली आपके प्रोजेक्ट से मेल नहीं खाती, या अगर कोई क्लाइंट ऐसी चीज़ माँगता है जो फ़ोटोरियलिस्टिक झुकाव वाली हो और जिसे Midjourney ठीक से नहीं संभालता, तो आप काम के लिए सही टूल चुनने के बजाय उसकी सीमाओं से जूझते हुए अटके रहते हैं।
Midjourney में टेक्स्ट-टू-वीडियो नहीं है। AI म्यूज़िक जनरेशन नहीं है। बैकग्राउंड हटाना नहीं है। फ़ेस स्वैप नहीं है। बोलते वीडियो के लिए लिप सिंक नहीं है। सुपर रिज़ोल्यूशन अपस्केलिंग नहीं है। पोज़ या स्ट्रक्चर कंट्रोल के लिए ControlNet नहीं है। बुनियादी वेरिएशन से आगे इनपेंटिंग या आउटपेंटिंग नहीं है। Midjourney के संदर्भ में "मॉडल" शब्द एक ही मालिकाना आर्किटेक्चर के वर्ज़न नंबरों को दर्शाता है, न कि ऐसे अलग-अलग AI सिस्टम को जो मूल रूप से अलग-अलग काम करते हैं।
ओपन AI इकोसिस्टम तक कोई पहुँच नहीं
AI क्रिएटिव इकोसिस्टम ने अकेले पिछले दो सालों में ही दर्जनों शक्तिशाली आर्किटेक्चर दिए हैं। Black Forest Labs के Flux मॉडल फ़ोटोरियलिस्टिक आउटपुट और प्रॉम्प्ट अनुपालन के नए बेंचमार्क बने। Stable Diffusion के वेरिएंट और SDXL ने खास सौंदर्य-दृष्टियों के लिए फ़ाइन-ट्यून किए गए मॉडलों का पूरा इकोसिस्टम संभव बनाया। ControlNet ने स्ट्रक्चर और पोज़ कंट्रोल को संभव किया। Google, OpenAI, ByteDance और Runway, सभी ने ऐसे वीडियो जनरेशन सिस्टम लॉन्च किए जो टेक्स्ट प्रॉम्प्ट से सिनेमैटिक फ़ुटेज बनाते हैं।
Midjourney आपको इनमें से किसी तक भी पहुँच नहीं देता। आपका हर प्रॉम्प्ट उनकी मालिकाना दीवारों के भीतर ही रहता है।
💡 जिन क्रिएटर्स को विज़ुअल लचीलापन चाहिए, उनके लिए यह एक कठोर सीमा है। जिन टीमों को पूरा प्रोडक्शन स्टैक चाहिए, उनके लिए यह एक डील-ब्रेकर है।
मॉडल कैटलॉग का फ़र्क बहुत बड़ा है
यहीं तुलना ठोस रूप लेती है। Picasso AI एक मल्टी-मॉडल प्लेटफ़ॉर्म के रूप में काम करता है, यानी यह कई क्रिएटिव डोमेन में दर्जनों अलग-अलग AI आर्किटेक्चर को होस्ट और चलाता है। आप अपने खास काम, अपनी आउटपुट ज़रूरतों और अपने सौंदर्य लक्ष्यों के हिसाब से मॉडल चुनते हैं।
एक ही जगह 91+ इमेज मॉडल
अकेले टेक्स्ट-टू-इमेज कैटेगरी में 91 से ज़्यादा मॉडल हैं। इसका मतलब है आर्किटेक्चर के बीच असली चुनाव, सिर्फ़ एक ही सिस्टम के पैरामीटर बदलने भर से नहीं:
- Flux Redux Dev किसी रेफ़रेंस से स्ट्रक्चरल फ़िडेलिटी के साथ नियंत्रित इमेज वेरिएशन बनाने के लिए
- GPT Image 2 सटीक, निर्देशों का पालन करने वाले फ़ोटोरियलिस्टिक आउटपुट के लिए जो जटिल प्रॉम्प्ट पर सटीक प्रतिक्रिया देते हैं
- Qwen Image Edit Plus प्राकृतिक भाषा के निर्देशों से सीधे AI-संचालित फ़ोटो एडिटिंग और मैनिपुलेशन के लिए
- डेप्थ कंट्रोल, पोज़ मैचिंग और स्ट्रक्चर प्रिज़र्वेशन के लिए ControlNet-आधारित मॉडल
इनमें से हर एक कुछ अर्थपूर्ण रूप से अलग काम करता है। कुछ फ़ोटोरियलिज़्म के लिए अनुकूलित हैं। कुछ कलात्मक और स्टाइलाइज़्ड आउटपुट के लिए। कुछ सख्त कंपोज़ीशनल कंट्रोल के लिए हैं, जो दृश्य का स्ट्रक्चर बनाए रखते हुए उसकी सामग्री बदलते हैं। Midjourney इनमें से किसी भी तरह का चुनाव नहीं देता।
हर बड़ा आर्किटेक्चर, एक इंटरफ़ेस
असली फ़र्क इस पर आता है: जब Black Forest Labs, Google, OpenAI या कोई भी बड़ी AI लैब नया मॉडल लाती है, तो उसे परखा जाता है और प्लेटफ़ॉर्म में जोड़ा जाता है। आप किसी एक मालिकाना टीम के अपने समय पर एक ही सिस्टम सुधारने का इंतज़ार करने के लिए बंधे नहीं रहते। आपको AI इमेज रिसर्च का पूरा क्षेत्र मिलता है, जैसे-जैसे वह विकसित होता है।
| क्षमता | Midjourney | Picasso AI |
|---|
| इमेज मॉडल | 1 (मालिकाना) | 91+ |
| वीडियो जनरेशन | कोई नहीं | 106+ मॉडल |
| AI ऑडियो | कोई नहीं | उपलब्ध |
| इमेज एडिटिंग | केवल बुनियादी वेरिएशन | पूरी पाइपलाइन |
| फ़ेस और बॉडी टूल्स | कोई नहीं | उपलब्ध |
| ControlNet | कोई नहीं | उपलब्ध |
| सुपर रिज़ोल्यूशन | कोई नहीं | 2x से 4x |
| बैकग्राउंड हटाना | कोई नहीं | उपलब्ध |
| लिप सिंक | कोई नहीं | उपलब्ध |
वीडियो जनरेशन: सबसे बड़ा अंतर
यही वह क्षमता है जो दोनों प्लेटफ़ॉर्म के बीच सबसे बड़ी दूरी बनाती है। Midjourney में वीडियो जनरेशन नहीं है। सीमित वीडियो जनरेशन भी नहीं, बिल्कुल भी नहीं।
106 वीडियो मॉडल और बढ़ते हुए
Picasso AI की टेक्स्ट-टू-वीडियो कैटेगरी में AI वीडियो प्रोडक्शन के सबसे बड़े नामों के 106 से ज़्यादा मॉडल हैं। एनिमेटेड GIF या छोटे धुंधले क्लिप नहीं। टेक्स्ट प्रॉम्प्ट से पूरा सिनेमैटिक वीडियो, जिसका रिज़ोल्यूशन 4K तक है और कुछ चुनिंदा मॉडलों पर अंतर्निहित ऑडियो भी है।
कुछ प्रमुख उदाहरण:
- Veo 3 Google की ओर से: नेटिव ऑडियो जनरेशन के साथ टेक्स्ट-टू-वीडियो, जो विज़ुअल्स के साथ सिंक्रोनाइज़्ड साउंड बनाता है
- Sora 2 OpenAI की ओर से: ऑडियो-सिंक्ड आउटपुट और मज़बूत सिनेमैटिक निरंतरता वाला HD वीडियो
- Kling v2.6 Kwaivgi की ओर से: टेक्स्ट प्रॉम्प्ट और इमेज इनपुट दोनों से सिनेमैटिक 1080p आउटपुट
- Seedance 2.0 ByteDance की ओर से: एक ही जनरेशन पास में अंतर्निहित ऑडियो जनरेशन के साथ टेक्स्ट-टू-वीडियो
- Wan 2.7 T2V: मज़बूत मोशन निरंतरता के साथ टेक्स्ट प्रॉम्प्ट से 1080p वीडियो
- LTX 2 Pro: टेक्स्ट से 4K वीडियो, प्रोफ़ेशनल-ग्रेड आउटपुट क्वालिटी के साथ
- Gen 4.5 Runway की ओर से: टेक्स्ट इनपुट से सिनेमैटिक मोशन और कैमरा कंट्रोल
- Hailuo 02: तेज़ 1080p AI वीडियो जनरेशन
- Ray Luma AI की ओर से: स्मूद मोशन के साथ तेज़, उच्च-गुणवत्ता वाला टेक्स्ट-टू-वीडियो
स्थिर इमेज से चलती फ़ुटेज तक
टेक्स्ट-टू-वीडियो के अलावा, आप शुरू से जनरेट करने के बजाय मौजूदा इमेज को एनिमेट भी कर सकते हैं। Wan 2.7 I2V जैसे मॉडल एक फ़ोटो लेकर उसे स्मूथ, प्राकृतिक दिखने वाली वीडियो मोशन में बदल देते हैं। Pixverse v5 वही काम मज़बूत सिनेमैटिक स्टाइल और कैमरा मूवमेंट विकल्पों के साथ करता है।
कंटेंट क्रिएटर्स, सोशल मीडिया टीमों, मार्केटर्स और वीडियो प्रोड्यूसर्स के लिए, यह अकेली क्षमता का अंतर Midjourney को उनके रोज़ के काम के एक बड़े हिस्से के लिए पूरी तरह अप्रासंगिक बना देता है।
ऑडियो AI जिसे Midjourney ने कभी छुआ तक नहीं
कोई AI म्यूज़िक नहीं। कोई वॉइस सिंथेसिस नहीं। कोई ट्रांसक्रिप्शन नहीं। Midjourney ने ऑडियो के क्षेत्र में कभी काम नहीं किया, और कोई रोडमैप ऐसा संकेत नहीं देता कि वह कभी करेगा।
टेक्स्ट प्रॉम्प्ट से म्यूज़िक
Picasso AI की AI म्यूज़िक जनरेशन कैटेगरी आपको लिखित विवरणों से पूरे ऑडियो ट्रैक बनाने देती है। मूड, शैली, टेम्पो, वाद्ययंत्र या ऊर्जा स्तर का वर्णन करें, और मॉडल मौलिक ऑडियो आउटपुट बना देता है। व्यावहारिक उपयोग के मामले ये हैं:
- YouTube और सोशल कंटेंट जिन्हें रॉयल्टी-फ़्री बैकग्राउंड ट्रैक चाहिए
- विज्ञापन और ब्रांड कैंपेन जिन्हें खास विज़ुअल पेसिंग के हिसाब से कस्टम ऑडियो चाहिए
- गेम डेवलपमेंट जहाँ किसी कम्पोज़र पर पैसा लगाने से पहले साउंडस्केप का प्रोटोटाइप बनाना हो
- फ़िल्ममेकिंग जहाँ रफ़ कट्स पर स्कोरिंग के विचारों को परखना हो
- पॉडकास्ट और वीडियो प्रोडक्शन जहाँ इंट्रो और ट्रांज़िशन म्यूज़िक की लगातार ज़रूरत रहती है
टेक्स्ट-टू-स्पीच और वॉइस सिंथेसिस
टेक्स्ट-टू-स्पीच कैटेगरी नरेशन, कैरेक्टर डायलॉग और ब्रांड वॉइसओवर के लिए यथार्थवादी वॉइस जनरेशन को कवर करती है। स्पीच-टू-टेक्स्ट पॉडकास्ट, इंटरव्यू और वीडियो कंटेंट के लिए ट्रांसक्रिप्शन वर्कफ़्लो संभालता है। अगर आप वीडियो बना रहे हैं, तो वॉइसओवर जनरेशन और ऑडियो ट्रांसक्रिप्शन का उसी प्लेटफ़ॉर्म पर होना, जहाँ आपका विज़ुअल प्रोडक्शन होता है, टूल बदलने की एक बड़ी रुकावट को खत्म कर देता है।
💡 एक ही प्लेटफ़ॉर्म पर इमेज जनरेशन, वीडियो क्रिएशन, म्यूज़िक प्रोडक्शन और वॉइस सिंथेसिस का संयोजन ही एक क्रिएटिव सूट को एक ही उद्देश्य वाले इमेज टूल से अलग करता है।
इमेज एडिटिंग टूल्स जिनकी बराबरी Midjourney नहीं कर सकता
Midjourney ने समय के साथ "vary" और "remix" फ़ीचर जोड़े, लेकिन उसकी इमेज एडिटिंग क्षमताएँ अपने ही बनाए आउटपुट के भीतर सतही बदलाव तक सीमित हैं। Picasso AI एक पूरी AI इमेज एडिटिंग पाइपलाइन देता है, जो किसी भी इमेज पर काम करती है, चाहे वह जनरेट की गई हो या अपलोड की गई।
इनपेंटिंग, आउटपेंटिंग, ऑब्जेक्ट रिप्लेसमेंट
ये तीन क्षमताएँ प्रोफ़ेशनल AI इमेज एडिटिंग वर्कफ़्लो की नींव बनाती हैं:
- इनपेंटिंग: इमेज का कोई भी हिस्सा चुनें और उसे नई AI-जनरेटेड सामग्री से भरें जो आसपास के क्षेत्र से सहजता से मेल खाए। गलतियाँ ठीक करें, ऑब्जेक्ट बदलें, अनचाहे तत्व हटाएँ, या नए जोड़ें।
- आउटपेंटिंग: मूल फ़्रेम से आगे किसी भी दिशा में कैनवास फैलाएँ। ऊपर आसमान जोड़ें, नीचे फ़ोरग्राउंड जोड़ें, या बैकग्राउंड बढ़ाकर एक तंग मूल शॉट से चौड़ी कंपोज़ीशन बनाएँ।
- ऑब्जेक्ट रिप्लेसमेंट: किसी मौजूदा तत्व की जगह आप जो चाहते हैं उसका वर्णन करें, और AI उसे बदल देता है, जबकि रोशनी, परछाइयाँ और दृश्य की बाकी सारी चीज़ें बनी रहती हैं।
ये प्रयोगात्मक फ़ीचर नहीं हैं। ये प्रोडक्शन-रेडी टूल हैं, जिनका रोज़ इस्तेमाल डिज़ाइनर, फ़ोटोग्राफ़र और मार्केटिंग टीमें करती हैं। Midjourney का बंद इकोसिस्टम बाहरी इमेज पर इनमें से कोई भी उपलब्ध नहीं कराता।
सुपर रिज़ोल्यूशन और इमेज रिस्टोरेशन
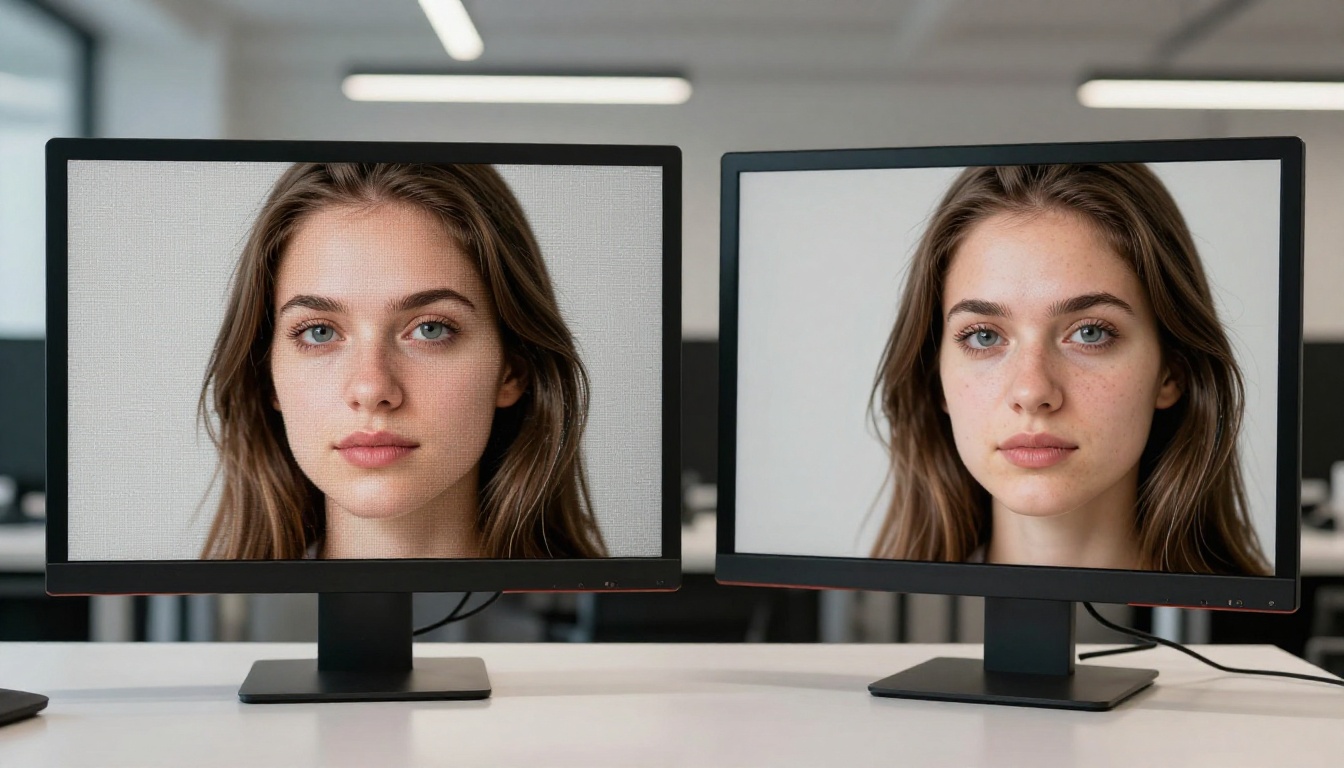
सुपर-रिज़ोल्यूशन कैटेगरी 2x से 4x तक अपस्केलिंग संभालती है, और यह साधारण इंटरपोलेशन के बजाय असली डिटेल रीकंस्ट्रक्शन के साथ काम करती है। बाल की लटें, कपड़े की बनावट, त्वचा के रोम-छिद्र और बारीक वास्तुशिल्प डिटेल, जो कम रिज़ोल्यूशन वाले स्रोतों में धुंधले हो जाते हैं, भरोसेमंद सटीकता के साथ दोबारा बनाए जाते हैं। AI इमेज रिस्टोरेशन टूल मौजूदा फ़ोटो में शोर, धुंधलापन, कम्प्रेशन आर्टिफ़ैक्ट और भौतिक क्षति को संभालते हैं।
ऐसे फ़ोटोग्राफ़रों के लिए जो कम एक्सपोज़र या कम रिज़ोल्यूशन वाली सामग्री के साथ काम करते हैं, ई-कॉमर्स टीमों के लिए जो अलग-अलग प्लेटफ़ॉर्म के लिए प्रोडक्ट इमेज का आकार बदलती हैं, और आर्काइविस्ट के लिए जो ऐतिहासिक फ़ोटो को डिजिटाइज़ करते हैं, यह एक व्यावहारिक रोज़ का वर्कफ़्लो है। Midjourney इनमें से कुछ भी नहीं देता।
सेकंडों में बैकग्राउंड हटाना
रिमूव-बैकग्राउंड कैटेगरी AI मैटिंग का उपयोग करके तुरंत, साफ़ बैकग्राउंड अलगाव देती है। कोई भी प्रोडक्ट फ़ोटो, पोर्ट्रेट या दृश्य अपलोड करें, और AI बाल, जटिल किनारों और अर्ध-पारदर्शी तत्वों की सटीकता के साथ सब्जेक्ट को अलग कर देता है। ई-कॉमर्स लिस्टिंग, मार्केटिंग एसेट्स और सोशल कंटेंट प्रोडक्शन के लिए यह एक मानक वर्कफ़्लो है, जिसे Midjourney बस संबोधित नहीं करता।
फ़ेस और बॉडी AI मॉडल
Midjourney फ़ेस-विशिष्ट AI टूल को छूता तक नहीं। इसमें फ़ेस स्वैप, बोलते अवतार जनरेशन या लिप सिंक वीडियो नहीं है। इन क्षमताओं के लिए उस सटीकता वाले विशेष मॉडल चाहिए जो चेहरे की संरचना की माँग करती है।
फ़ेस स्वैप तकनीक
Face Swap AI आपको फ़ोटोरियलिस्टिक परिणामों के साथ इमेज के बीच चेहरे बदलने देता है। मॉडल रोशनी की स्थितियों, त्वचा के रंग के मिलान, चेहरे की ज्यामिति और किनारों के ब्लेंडिंग को संभालता है, ताकि प्राकृतिक दिखने वाले कंपोज़िट बनें। वैध उपयोगों में कंटेंट क्रिएशन, फ़िल्म प्रीविज़ुअलाइज़ेशन (जहाँ कलाकारों की उपलब्धता एक बाधा है) और मार्केटिंग कैंपेन शामिल हैं जिन्हें विज़ुअल एसेट्स में एक जैसा कैरेक्टर प्रतिनिधित्व चाहिए।
बोलते वीडियो के लिए लिप सिंक
लिप सिंक कैटेगरी किसी भी ऑडियो ट्रैक या टेक्स्ट-टू-स्पीच आउटपुट के साथ मुँह की हरकत को यथार्थवादी चेहरे के एनिमेशन के साथ सिंक्रोनाइज़ करती है। उसी प्लेटफ़ॉर्म पर वीडियो जनरेशन और वॉइस सिंथेसिस क्षमताओं के साथ मिलकर, यह बिना कैमरे के सामने रिकॉर्डिंग किए टॉकिंग-हेड वीडियो बनाने के लिए एक पूरी पाइपलाइन बनाता है। ब्रांड एक्सप्लेनर, प्रोडक्ट डेमो, बहुभाषी डबिंग और ट्रेनिंग कंटेंट प्रोडक्शन के लिए, वर्कफ़्लो पर असर तुरंत दिखता है।
Picasso AI पर Flux Redux Dev कैसे इस्तेमाल करें
Picasso AI पर Flux Redux Dev उसके सबसे बहुमुखी इमेज वेरिएशन टूल में से एक के रूप में उपलब्ध है। यह मॉडल रेफ़रेंस इमेज के नियंत्रित वेरिएशन बनाने में माहिर है, और साथ ही स्ट्रक्चरल और कंपोज़िशनल एकरूपता बनाए रखता है। इसलिए यह प्रोडक्ट फ़ोटोग्राफ़ी के दोहराव, कैरेक्टर डिज़ाइन के राउंड और एक ही शुरुआती बिंदु से रचनात्मक खोज के लिए आदर्श है।
चरण 1: मॉडल पेज खोलें
Picasso AI पर Flux Redux Dev पर जाएँ। कोई प्लगइन नहीं, कोई Discord सर्वर नहीं, कोई कतार का इंतज़ार नहीं। इंटरफ़ेस सीधे आपके ब्राउज़र में लोड हो जाता है।
चरण 2: अपनी रेफ़रेंस इमेज अपलोड करें
मॉडल अपने प्राथमिक इनपुट के रूप में एक मौजूदा इमेज लेता है। कोई भी फ़ोटो अपलोड करें जिसके नियंत्रित वेरिएशन आप बनाना चाहते हैं। यह एक प्रोडक्ट शॉट, फ़ैशन रेफ़रेंस, किसी दूसरे सेशन से बनी इमेज, या कोई भी विज़ुअल एसेट हो सकता है जिस पर आप काम करना चाहते हैं।
चरण 3: पैरामीटर समायोजित करें
- इमेज स्ट्रेंथ: नियंत्रित करता है कि आउटपुट रेफ़रेंस का कितनी करीबी से पालन करता है। कम मान रंग और कंपोज़िशन में ज़्यादा रचनात्मक विचलन देते हैं; ज़्यादा मान आउटपुट को मूल स्ट्रक्चर से कसकर जोड़े रखते हैं।
- आउटपुट की संख्या: दिशाओं की तुलना करने और सबसे मज़बूत परिणाम चुनने के लिए एक ही रन में कई वेरिएशन जनरेट करें।
- प्रॉम्प्ट गाइडेंस: किसी खास स्टाइल, रोशनी की स्थिति या सेटिंग की ओर वेरिएशन को मोड़ने के लिए वैकल्पिक टेक्स्ट जोड़ें।
चरण 4: जनरेट करें और समीक्षा करें
मॉडल लोड के आधार पर परिणाम 15 से 30 सेकंड में दिखते हैं। जो वेरिएशन आपको चाहिए उन्हें सीधे इंटरफ़ेस से डाउनलोड करें, या उन्हें प्लेटफ़ॉर्म के दूसरे टूल्स के लिए तुरंत इनपुट के रूप में इस्तेमाल करें।
💡 Flux Redux Dev को इनपेंटिंग के साथ जोड़ें ताकि वे हिस्से ठीक किए जा सकें जो वेरिएशन में सही नहीं बैठे, फिर परिणाम को सुपर रिज़ोल्यूशन से गुज़ारें ताकि प्रोडक्शन के लिए तैयार अपस्केल्ड आउटपुट मिले।
चरण 5: मल्टी-मॉडल वर्कफ़्लो बनाएँ
यहीं प्लेटफ़ॉर्म का फ़ायदा ठोस रूप लेता है। अपना Flux Redux Dev आउटपुट लें, उसे 4x सुपर-रिज़ोल्यूशन मॉडल से गुज़ारें, प्रोडक्ट शॉट के लिए ज़रूरत हो तो बैकग्राउंड हटाएँ, और फिर साफ़ किए गए परिणाम को Wan 2.7 I2V के लिए रेफ़रेंस इमेज की तरह इस्तेमाल करके उसी एसेट का वीडियो वर्ज़न बनाएँ। इमेज वेरिएशन से वीडियो आउटपुट तक का यह पूरा वर्कफ़्लो एक ही प्लेटफ़ॉर्म के भीतर होता है। Midjourney के इकोसिस्टम में पहले चरण के बाद इनमें से किसी भी कदम पर यह संभव नहीं है।
एक प्लेटफ़ॉर्म क्यों छह टूल्स के झंझट से बेहतर है
Midjourney के पक्ष में दलील लगभग पूरी तरह उसकी खास सौंदर्य-दृष्टि के लिए इमेज क्वालिटी पर टिकी है। यह दलील कुछ संदर्भों में सही बैठती है। लेकिन यह तब बिखर जाती है जब आप पूछते हैं कि उसके बाद क्या होता है, जब आपको उस इमेज को एनिमेट करना हो, उसका बैकग्राउंड हटाना हो, प्रिंट के लिए अपस्केल करना हो, वॉइसओवर जोड़ना हो, या उसे सिंक्रोनाइज़्ड ऑडियो वाले वीडियो में बदलना हो।
असली क्रिएटिव प्रोडक्शन में कई चरण शामिल होते हैं:
- इमेज जनरेशन कॉन्सेप्ट, रेफ़रेंस और विज़ुअल एसेट्स के लिए
- इमेज एडिटिंग उन विज़ुअल्स को परिष्कृत करने, ठीक करने और खास ज़रूरतों के अनुसार ढालने के लिए
- वीडियो प्रोडक्शन स्थिर इमेज को मोशन कंटेंट में एनिमेट करने, संदर्भ देने या दोबारा इस्तेमाल करने के लिए
- ऑडियो निर्माण सभी वीडियो आउटपुट के लिए म्यूज़िक, वॉइसओवर और साउंड डिज़ाइन के लिए
- फ़ेस और बॉडी टूल्स कैरेक्टर की निरंतरता और टॉकिंग-हेड वीडियो प्रोडक्शन के लिए
- अपस्केलिंग और रिस्टोरेशन आउटपुट क्वालिटी और पुराने विज़ुअल एसेट्स के साथ काम करने के लिए
Midjourney पहला चरण संभालता है, कभी-कभी अच्छी तरह। Picasso AI सभी छह चरण संभालता है, और अकेले 91 से ज़्यादा इमेज मॉडल के साथ पहले चरण को कहीं ज़्यादा आर्किटेक्चरल विविधता के साथ कवर करता है।
एक अकेले क्रिएटर के लिए छह अलग-अलग टूल, छह अलग सब्सक्रिप्शन और छह अलग इंटरफ़ेस के बीच स्विच करना ऐसी प्रोडक्शन रुकावट है जो लगातार आउटपुट को धीमा करती है। किसी टीम के लिए यह समन्वय की लागत बढ़ाता है और जब एसेट्स अलग-अलग पाइपलाइनों से गुज़रते हैं तो वर्ज़न कंट्रोल की समस्याएँ पैदा करता है। एक ही प्लेटफ़ॉर्म पर, एक सुसंगत इंटरफ़ेस के साथ, 91 इमेज मॉडल, 106 वीडियो मॉडल और हर सहायक कैटेगरी होने से AI-संचालित कंटेंट प्रोडक्शन का अर्थशास्त्र बदल जाता है।
जो मॉडल Midjourney के पास नहीं हैं, वे न तो अस्पष्ट हैं और न ही प्रयोगात्मक। ये Veo 3 Google से, Sora 2 OpenAI से, Kling v2.6 Kwaivgi से, और Seedance 2.0 ByteDance से हैं। ये इस समय मौजूद सबसे सक्षम वीडियो जनरेशन मॉडल हैं। ये सभी Picasso AI पर चलते हैं, पूरे इमेज एडिटिंग स्टैक, ऑडियो टूल्स और फ़ेस AI के साथ, जो तस्वीर को पूरा करते हैं।
बनाना शुरू करें। कोई भी मॉडल चुनें, एक प्रॉम्प्ट लिखें, और देखें कि जब आप एक टूल के एक आउटपुट प्रकार तक सीमित नहीं रहते, तो एक पूरा AI क्रिएटिव प्लेटफ़ॉर्म असल में क्या बनाता है। फ़र्क तब साफ़ हो जाता है जब आपको पहली बार स्थिर इमेज से आगे कुछ चाहिए।


