كان الفارق بين تسجيل الصوت ومطابقة حركة شفاه الفيديو له يتطلب في السابق استوديو ومتحركًا ماهرًا وأيامًا من العمل الدقيق. يختصر Lipsync بالذكاء الاصطناعي هذا كله في ثوانٍ. تحلل النماذج المدرَّبة على ملايين الساعات من فيديوهات المتحدثين أمام الكاميرا الصوتيات الفونيمية إطارًا بعد إطار، وتعيد تشكيل هندسة الوجه لتطابق كل صوت بدقة دون مستوى البكسل. والنتيجة فيديو لشخص يتحدث يبدو وكأنه صُوّر بهذه الطريقة.
لا تقتصر أهمية هذا على إنشاء المحتوى للتسلية. تقوم فرق المنتجات بدبلجة العروض التوضيحية إلى اثنتي عشرة لغة في فترة ما بعد الظهر. ويترجم المعلمون المحاضرات المسجلة دون إعادة تصوير أي شيء. ويبني صنّاع البودكاست قنوات حديث أمامي من ملفات صوتية فقط، دون الحاجة إلى إعداد كاميرا. وعندما يصبح الجهد المطلوب قريبًا من الصفر، تتراكم حالات الاستخدام بسرعة.
كيف يعمل Lipsync بالذكاء الاصطناعي فعليًا
تستبدل الدبلجة التقليدية مسار الصوت وتأمل أن يتقبل الجمهور عدم التطابق. أما Lipsync بالذكاء الاصطناعي فيفعل العكس: يقرأ الصوت الجديد ويعيد تشكيل الوجه ليطابقه.
تتم العملية في ثلاث مراحل:
- استخراج الفونيمات: يحلل النموذج الصوت إلى وحدات فونيمية متمايزة، وهي أصغر وحدات الصوت في الكلام. ويقابل كل فونيم شكلًا محددًا للفم.
- اكتشاف الوجه ورسم نقاط المعالم: يحدد النموذج نقاط المعالم الوجهية حول الفك والشفاه والأسنان والذقن في كل إطار على حدة.
- التشويه والمزج على مستوى البكسل: يُشوَّه نطاق الشفاه ليطابق شكل الفونيم المستهدف، ثم يُمزج مع الوجه المحيط به، مع الحفاظ على ملمس الجلد والإضاءة والحركة الموجودة.
💡 تتعامل أفضل النماذج مع حركة الرأس، والإخفاء الجزئي (مثل يد تعبر الوجه في منتصف الجملة)، وحتى النظارات أو شعر الوجه، دون أن تفقد دقة المزامنة.
النتيجة فيديو تتطابق فيه كل حركة للفم في كل إطار مع الصوت الجديد، بغض النظر عمّا أظهره الفيديو الأصلي.
سيرا العمل اللذان يستحقان الاهتمام
قبل اختيار أداة، حدد المسار الذي تعمل عليه فعلًا. تختلف النماذج المحسّنة لكل مسار اختلافًا كبيرًا، واختيار المسار الخطأ سيكلفك جودة النتيجة.
المسار أ: استبدال الصوت في فيديو موجود. لديك فيديو يتحدث فيه شخص بالفعل. تريد استبدال الصوت (بلغة مختلفة، أو بمتحدث آخر، أو بصوت مولّد بالذكاء الاصطناعي) وجعل الشفاه تتطابق مع الصوت الجديد. هذا هو مسار الدبلجة الكلاسيكي.
المسار ب: تحريك صورة ثابتة أو فيديو صامت. لديك صورة أو فيديو دون كلام، وتريد إضافة مسار صوتي يجعل الشخص الظاهر يبدو وكأنه يتكلم. هذا هو مسار الأفاتار المتحدث.
| الميزة | استبدال الصوت في الفيديو | الأفاتار المتحدث |
|---|
| المدخلات المطلوبة | ملف فيديو مع صوت جديد | صورة أو فيديو مع صوت |
| تعقيد المعالجة | عالٍ (يجب مطابقة الحركة الموجودة) | متوسط |
| أفضل النماذج | Lipsync 2 Pro، Lipsync Precision | Omni Human 1.5، Fabric 1.0 |
| أكثر حالات الاستخدام شيوعًا | الدبلجة، التوطين | التسويق، المحتوى الاجتماعي، التعليم |
| طابع الناتج | يطابق الفيديو الأصلي | حركة مولّدة بالكامل |
يُدعم المساران في النماذج التي نغطيها هنا. ويؤثر اختيار النموذج في النتيجة أكثر مما يتوقعه معظم الناس عند البداية.
اختر نموذج Lipsync المناسب
تضم فئة Lipsync على PicassoIA اثني عشر نموذجًا، ولكل منها نقطة قوة محددة. إليك كيف تختلف النماذج الرئيسية حتى تتمكن من اتخاذ قرار سريع.
السرعة مقابل الدقة
يعالج Lipsync Speed من HeyGen الفيديو بسرعة، ما يجعله الخيار الأمثل عندما يكون لديك عدد كبير من المقاطع أو تحتاج إلى معاينات سريعة متكررة. يقايض Lipsync Precision من HeyGen وقت المعالجة بدقة أعلى على مستوى الإطار، وهذا أمر حاسم في اللقطات المقرّبة حيث يظهر أي فارق إطار واحد بوضوح.
مزامنة متعددة الأغراض
صُمم Lipsync 2 من Sync خصيصًا لمزامنة الصوت مع الفيديو. يتعامل مع نطاق واسع من جودة الفيديو المدخل، ويحافظ على الاتساق عبر المقاطع الأطول دون انحراف. وللأعمال التي تتطلب أعلى دقة، يضيف Lipsync 2 Pro تصحيحًا أدق على مستوى الفونيم يظهر بوضوح عند التشغيل بدقة كاملة على شاشة كبيرة.
يُعد React 1 من Sync أحدث خيار في هذه العائلة. يتعامل مع الكلام السريع والحوارات المتداخلة وأنماط الإيقاع غير المعتادة بشكل أفضل من الإصدارات السابقة، ما يجعله يستحق التجربة مع المحتوى سريع الإيقاع أو أي محتوى فيه أنماط لهجة متحدث غير أصلي.
متخصصو الأفاتار المتحدث
يتفوق Omni Human 1.5 من ByteDance في تحويل الصور الثابتة إلى فيديوهات حديث واقعية بالكامل. لا يولّد النموذج حركة الشفاه فقط، بل يولّد أيضًا حركة طبيعية للرأس، والرمش، وتعبيرات دقيقة تجعل الناتج يبدو حيًا فعلًا. ويتبع Fabric 1.0 من Veed نهجًا مشابهًا بأسلوب حركة أنعم، ويعمل بشكل جيد بصفة خاصة في المحتوى المهني أو المؤسسي حيث يُفضَّل تحريك دقيق على الحركة التعبيرية.
يتخصص P Video Avatar في إنشاء فيديوهات أفاتار متكررة من صورة مرجعية واحدة، ويفيد في بناء شخصية مقدّم متسقة عبر فيديوهات كثيرة دون إعادة تسجيل أي شيء.
أدوات الدبلجة متعددة اللغات
يدمج Video Translate من HeyGen الترجمة وتوليد الصوت والمزامنة في مسار واحد يغطي أكثر من 150 لغة. أما لاستبدال الصوت البحت عبر اللغات المعقدة صوتيًا، فيتعامل Kling Lip Sync من Kuaishou مع اللغات السريعة والنغمية التي تُربك النماذج المدرَّبة أساسًا على أنماط الفونيمات الإنجليزية. ويُحسَّن Pixverse Lipsync لصيغ الفيديو القصيرة، ويُخرج مباشرة بأبعاد مناسبة للمحتوى العمودي.
ولّد الصوت أولًا
إذا كنت تعمل مع صوت مسجَّل مسبقًا أو ملف صوتي موجود، يمكنك تخطي هذا القسم كليًا. أما إذا احتجت إلى توليد الصوت من نص، فقد بلغ توليد الكلام بالذكاء الاصطناعي مستوى من الجودة يصعب معه تمييز الناتج عن الكلام البشري المسجَّل في بيئة استماع مضبوطة.
المسار بسيط: ولّد الصوت أولًا، ثم أدخله إلى نموذج Lipsync.
ينتج ElevenLabs V3 كلامًا طبيعيًا للغاية مع عاطفة دقيقة وإيقاع متقن. وهو قوي بشكل خاص في السرد المنطوق والحوار الطويل، حيث يجب أن يبدو الإيقاع والتنفس بشريين. وللإخراج متعدد اللغات بجودة ثابتة، يدعم ElevenLabs v2 Multilingual أكثر من 30 لغة مع الحفاظ على هوية الصوت نفسها في جميعها.
يُعد Minimax Speech 2.8 HD الخيار الأمثل عندما تحتاج إلى صوت بجودة استوديو سيُستخدم في فيديو منتَج باحتراف. تلتقط الفئة HD أنماط التنفس الدقيقة والرنين الصوتي التي تسطّحها النماذج الأرخص.
لاستنساخ الصوت، يتيح Qwen3 TTS تزويدك بعينة صوتية قصيرة وتوليد كلام يبدو كأنه للمتحدث نفسه. ويضيف Chatterbox من Resemble AI التحكم في العاطفة، فتحدد ما إذا كان الناتج يبدو متحمسًا أو هادئًا أو حازمًا أو حواريًا، وهذا يغيّر ناتج Lipsync بشكل كبير، لأن الكلام العاطفي له هندسة فم مختلفة تمامًا عن القراءة المسطحة.
وللسرعة على نطاق واسع، يولّد Flash v2.5 من ElevenLabs الصوت تقريبًا في الزمن الفعلي، وهذا مفيد عندما تعالج محتوى بالدفعات أو تكرر عبر نصوص كثيرة بسرعة.
كيفية استخدام Lipsync 2 على PicassoIA
يُعد Lipsync 2 أكثر الأدوات مباشرة للاستخدام الأساسي: خذ فيديو لوجه يتكلم، واستبدل مسار الصوت، واجعل الشفاه تتطابق مع الصوت الجديد بدقة.
الخطوة 1: جهّز الفيديو
يجب أن يكون الوجه في الفيديو المصدر واضحًا مع إضاءة جيدة. يتعامل النموذج مع معظم مستويات الجودة، لكن المدخلات المضغوطة بشدة تقلل من حدة الناتج. والدقة المثالية 720p أو أعلى. إذا كان الفيديو يحتوي على عدة قطعات للكاميرا، فعالج كل مقطع على حدة للحصول على نتائج أنظف.
الخطوة 2: جهّز الصوت
صدّر الصوت كملف WAV أو MP3 نظيف. إذا ولّدت الصوت بنموذج تحويل نص إلى كلام، فنزّل ملف الصوت قبل المتابعة. تأكد من أن طول الصوت يطابق طول الفيديو أو يقترب منه.
الخطوة 3: افتح Lipsync 2
انتقل إلى صفحة نموذج Lipsync 2 على PicassoIA. ستجد حقول الإدخال لملفي الفيديو والصوت.
الخطوة 4: ارفع المدخلات
ارفع الفيديو المصدر وملف الصوت. صيغ الفيديو المقبولة: MP4 وMOV وAVI. صيغ الصوت المقبولة: WAV وMP3 وM4A.
الخطوة 5: اضبط المعاملات
- وضع المزامنة: لوجه واحد يتكلم، استخدم وضع المتحدث الواحد الافتراضي.
- جودة الإخراج: اختر أعلى خيار متاح للنتيجة النهائية. واستخدم إعدادًا أقل للجودة في المعاينات السريعة لتوفير وقت المعالجة.
- مزج نطاق الشفاه: إذا أتاح النموذج هذا الخيار، فإن قيمة حول 0.7 إلى 0.85 تعطي مزجًا طبيعيًا. القيمة المرتفعة جدًا تجعل نطاق الشفاه يبدو مركّبًا، والقيمة المنخفضة جدًا تترك فجوات مزامنة مرئية.
الخطوة 6: ولّد وراجع
اضغط على التوليد. تستغرق المعالجة عادةً من 30 إلى 120 ثانية حسب طول الفيديو وحمل الخادم في ذلك الوقت. نزّل الناتج وراجعه بسرعة التشغيل الكاملة. انتبه بشكل خاص إلى فترات الصمت في الصوت: يجب أن يُنتج الصمت أوضاعًا مغلقة أو شبه مغلقة للفم، لا أفواهًا مفتوحة متجمدة.
💡 في فيديوهات الحديث التي يكون فيها الشخص قريبًا من الكاميرا، استخدم بدلًا من ذلك Lipsync 2 Pro. يظهر التصحيح دون الفونيمات بوضوح في المسافات المقرّبة، ويستحق وقت المعالجة الأطول قليلًا.
Lipsync للدبلجة متعددة اللغات
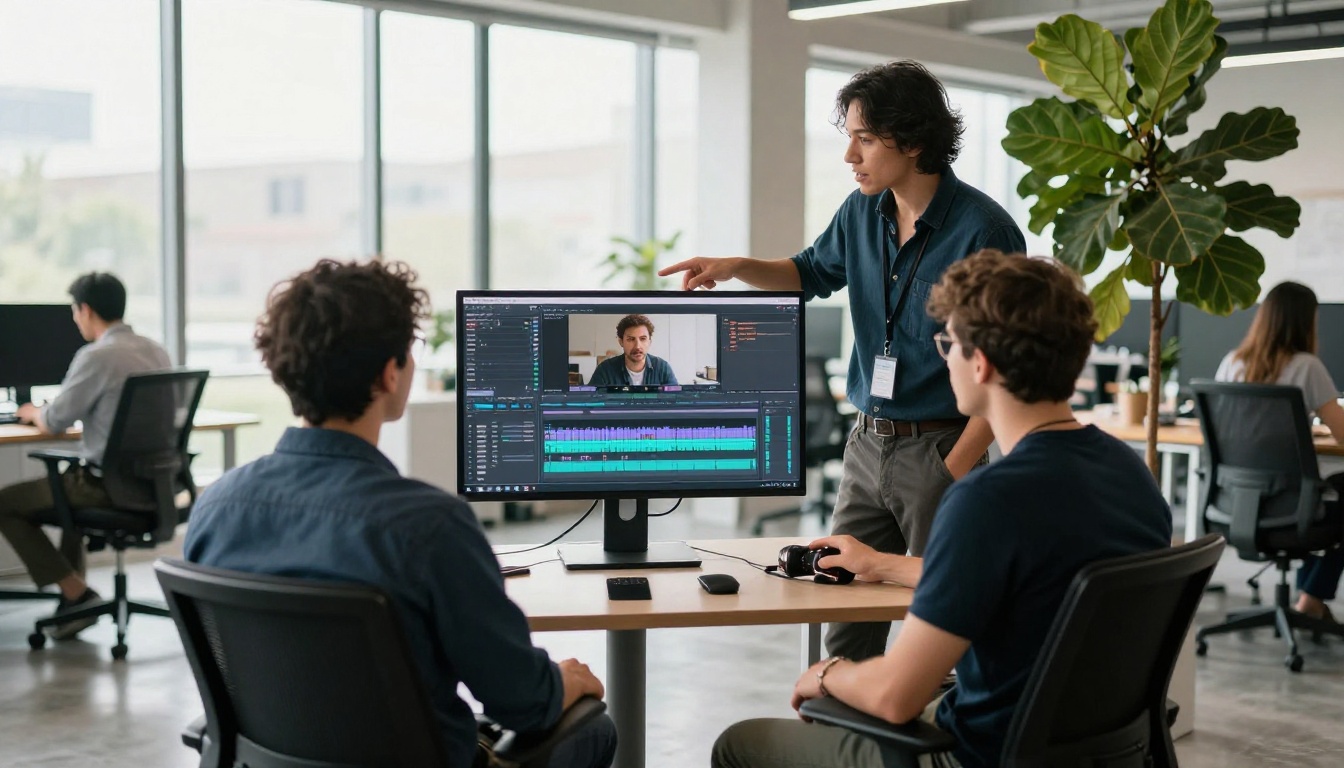
أقوى تطبيق تجاري لـ Lipsync بالذكاء الاصطناعي هو دبلجة محتوى الفيديو إلى لغات أخرى دون إعادة تسجيل أي شيء. يمكن أن يصبح فيديو مصدر واحد أساسًا لنسخ بالإسبانية والفرنسية والبرتغالية واليابانية وأكثر من 100 لغة أخرى، ولكل نسخة شفاه تتطابق مع الصوت المترجم.
يعمل المسار القياسي على النحو التالي:
- انسخ الصوت الأصلي (استخدم نموذج تحويل الكلام إلى نص إذا لم يكن لديك نص مكتوب)
- ترجم النص المنسوخ إلى اللغة المستهدفة
- ولّد الكلام المترجم بنموذج تحويل نص إلى كلام يطابق صوت المتحدث
- شغّل الصوت الجديد عبر نموذج Lipsync مقابل الفيديو الأصلي
يختصر Video Translate هذه الخطوات الأربع في أداة واحدة. ارفع الفيديو، واختر اللغة المستهدفة، وسيتولى النموذج النسخ والترجمة وتوليد الصوت والمزامنة تلقائيًا. وفي الأحجام الكبيرة، أو مع اللغات التي تختلف كثيرًا في توقيت الفونيمات (فالماندرين واليابانية تميل إلى أن تكون أقصر لكل مفهوم من الإنجليزية)، قد يكون الصوت المترجم أقصر من الأصلي أحيانًا. وإبطاء معدل تشغيل الكلام قليلًا أو السماح للنموذج بتمديد التوقيت يمنع انتهاء الفيديو قبل انتهاء الصوت.
وفي اللغات التي تكون فيها دقة الفونيمات بالغة الأهمية، يتعامل Kling Lip Sync مع اللغات النغمية والمعقدة صوتيًا بشكل أفضل من النماذج المدرَّبة أساسًا على الإنجليزية، وهذا فارق مهم بمجرد أن تبدأ بنشر المحتوى بالماندرين أو الفيتنامية أو التايلاندية.
من الصورة إلى أفاتار متحدث
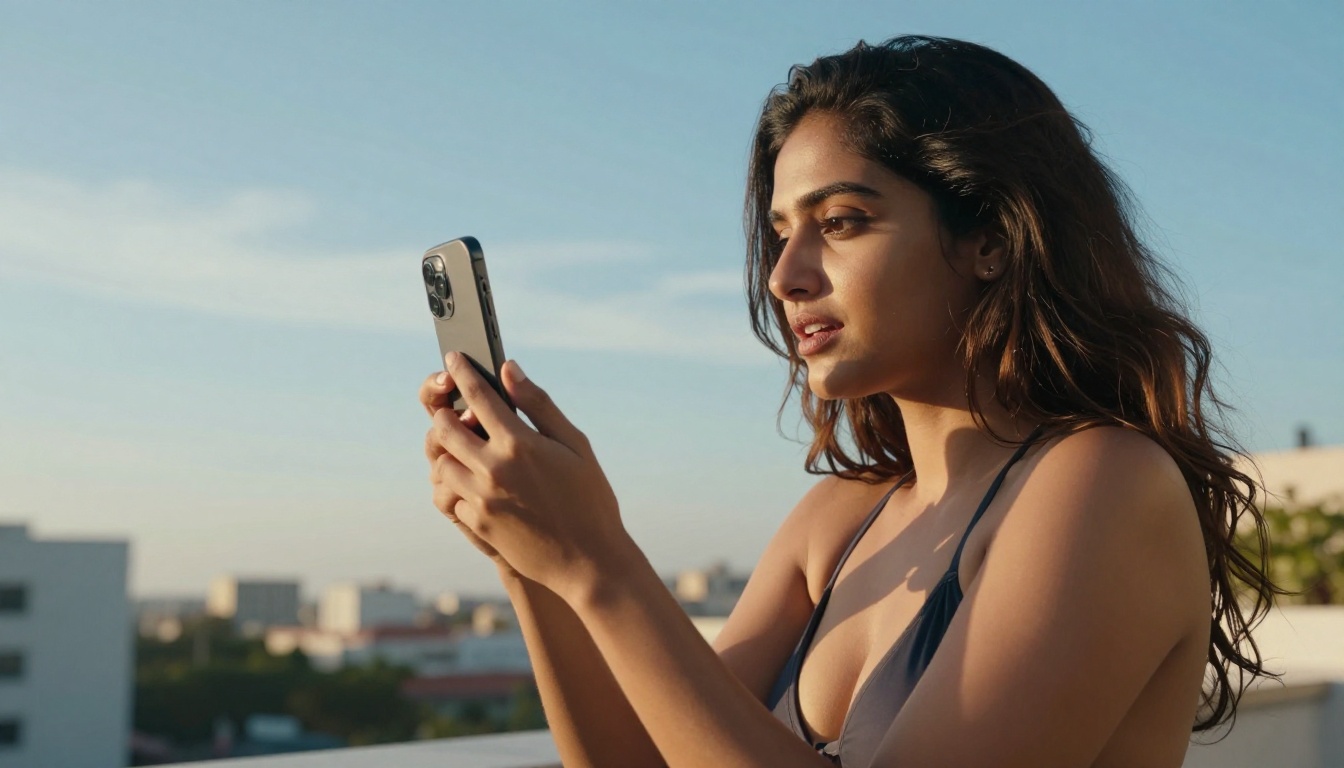
ربما يكون تحريك الصور الثابتة أبرز تطبيقات Lipsync بالذكاء الاصطناعي: ارفع صورة واحدة لشخص، وأضف ملفًا صوتيًا، واحصل على فيديو لذلك الشخص وهو يتكلم بشكل طبيعي. لا كاميرا. لا إعداد. لا استوديو.
يتعامل Omni Human 1.5 مع هذا بمستوى جودة يشمل أنماط رمش واقعية، وحركة رأس دقيقة، وتمايلًا طبيعيًا للكتفين. لا يبدو الناتج كوجه جامد تتحرك شفاهه، بل يبدو كفيديو.
أفضل الممارسات لإدخال الصورة:
- وجه متجه للأمام أو بزاوية 3/4 خفيفة: تحدّ لقطات الجانب المباشرة من قدرة النموذج على توليد هندسة فم طبيعية من جانبي الوجه.
- إضاءة جيدة وظلال قليلة على الوجه: يقرأ النموذج معالم الوجه من بيانات البكسل. الظلال الكثيفة فوق منطقة الفم تُضعف دقة المزامنة.
- تعبير محايد أو معبّر بقدر بسيط في البداية: الوضعية المبالغ فيها بشدة في الصورة الأصلية ستتعارض مع التعبير المولَّد وتخلق تناقضات بصرية.
- دقة عالية: الحد الأدنى لمنطقة الوجه 512 بكسل. وكلما كانت أكبر كان ذلك أفضل بشكل ملحوظ.
يُنتج Fabric 1.0 حركة أنعم قليلًا تعمل بشكل جيد في العروض المهنية أو المؤسسية. ويُعد P Video Avatar الخيار الأمثل إذا احتجت إلى أفاتار متكرر يمكن إعادة استخدامه عبر فيديوهات كثيرة كشخصية مقدّم متسقة دون أن تختلف الحركة بين الجلسات.
يظل النموذج الأساسي Omni Human (الإصدار السابق) خيارًا قويًا إذا احتجت إلى معالجة أسرع وإخراج أكثر أسلوبية قليلًا مقارنة بالإصدار 1.5.
4 مشكلات تفسد جودة المزامنة
حتى مع أفضل نموذج، تؤدي بعض مشكلات المدخلات باستمرار إلى نتائج ضعيفة. إصلاحها قبل تشغيل النموذج أسرع من إعادة المحاولة بعد ذلك.
1. صوت بضوضاء خلفية كثيفة
تقرأ النماذج الصوت لتحديد توقيت الفونيمات. الموسيقى الخلفية أو الصدى أو الضوضاء المحيطة تجعل استخراج الفونيمات أقل دقة، ما يعني أن حركات الشفاه تنحرف قليلًا. شغّل الصوت عبر خطوة تقليل الضوضاء قبل الرفع. حتى تقليل الضوضاء الأساسي يحسّن دقة المزامنة بشكل ملحوظ.
2. متحدثون متعددون في فيديو واحد
تتبع معظم نماذج Lipsync وجهًا واحدًا افتراضيًا. إذا كان شخصان يتحدثان وكلاهما ظاهر، فقد يطبّق النموذج حركة الشفاه على الاثنين معًا أو على الوجه الرئيسي فقط. استخدم نموذجًا يدعم تعدد المتحدثين صراحةً، أو قطّع الفيديو إلى مقاطع لمتحدث واحد قبل المعالجة.
3. زوايا رأس حادة
ستجعل زاوية الجانب، أو إمالة الرأس بشدة، أو وجه محجوب جزئيًا بجسم ما، النموذج يعاني في اكتشاف نقاط المعالم. قد تتشوّه منطقة الشفاه بشكل غير صحيح أو ترتعش بين الإطارات. اقطع هذه اللحظات أو ثبّتها في محرر الفيديو قبل تشغيل نموذج Lipsync.
4. اختلاف طول الصوت والفيديو
إذا كان الصوت أطول بكثير من الفيديو، فلن تكون لنهاية الكلام إطارات تتزامن معها. اقطع الصوت دائمًا ليطابق طول الفيديو (أو العكس) قبل تشغيل النموذج. وعادةً ما تكفي فسحة مدتها ثانيتان في نهاية الفيديو لمنع القطع.
💡 يعمل نهج من مرحلتين جيدًا مع المحتوى الطويل. عالج الفيديو في مقاطع مدة كل منها من 30 إلى 60 ثانية، ثم ادمج مقاطع الناتج معًا. تُعالَج المقاطع القصيرة بسرعة أكبر، وتمنحك تحكمًا أكبر في الأقسام التي تحتاج إلى إعادة تشغيل دون إعادة معالجة المقطع كاملًا.
الجمع بين توليد الصوت ونموذج Lipsync
يجمع النهج الإنتاجي الأكثر مرونة بين نموذج تحويل نص إلى كلام ونموذج Lipsync، بحيث لا يحتاج الصوت ولا الفيديو إلى تسجيل من الصفر. اكتب نصًا. ولّد الصوت. زامنه مع صورة مرجعية أو مقطع من لقطات جاهزة. والنتيجة فيديو حديث متكامل الإنتاج دون كاميرا، ودون إعداد ميكروفون، ودون حجز استوديو.
بالنسبة للمحتوى الإنجليزي، يُنتج الجمع بين ElevenLabs V3 لتوليد الصوت وLipsync 2 Pro للمزامنة حاليًا بعضًا من أكثر النتائج واقعية المتاحة. يلتقط نموذج الصوت التنفس والإيقاع الطبيعيين اللذين يستطيع نموذج Lipsync قراءتهما بوضوح لمحاذاة الفونيمات بدقة.
بالنسبة للمحتوى متعدد اللغات على نطاق واسع، يعمل Minimax Speech 2.8 HD مع Kling Lip Sync معًا بشكل جيد مع اللغات النغمية والمعقدة صوتيًا، دون انحراف التوقيت الذي يظهر في النماذج المدرَّبة أساسًا على اللغات الغربية. وإذا كان الجمهور المستهدف عالميًا وأردت سير عمل واحدًا يغطي الترجمة أيضًا، فإن Video Translate هو الطريق الأسرع من فيديو مصدر واحد إلى ناتج موطّن.
بالنسبة للمحتوى القائم على الأفاتار حيث تتحكم في المرئيات كليًا، يمنحك Chatterbox Pro من Resemble AI تحكمًا دقيقًا في طريقة نطق الصوت، ويغذي Omni Human 1.5 بإشارة صوتية أكثر تعبيرًا لتحريك الأفاتار بما يستجيب للدلالة العاطفية للكلام، لا لتوقيته فقط.
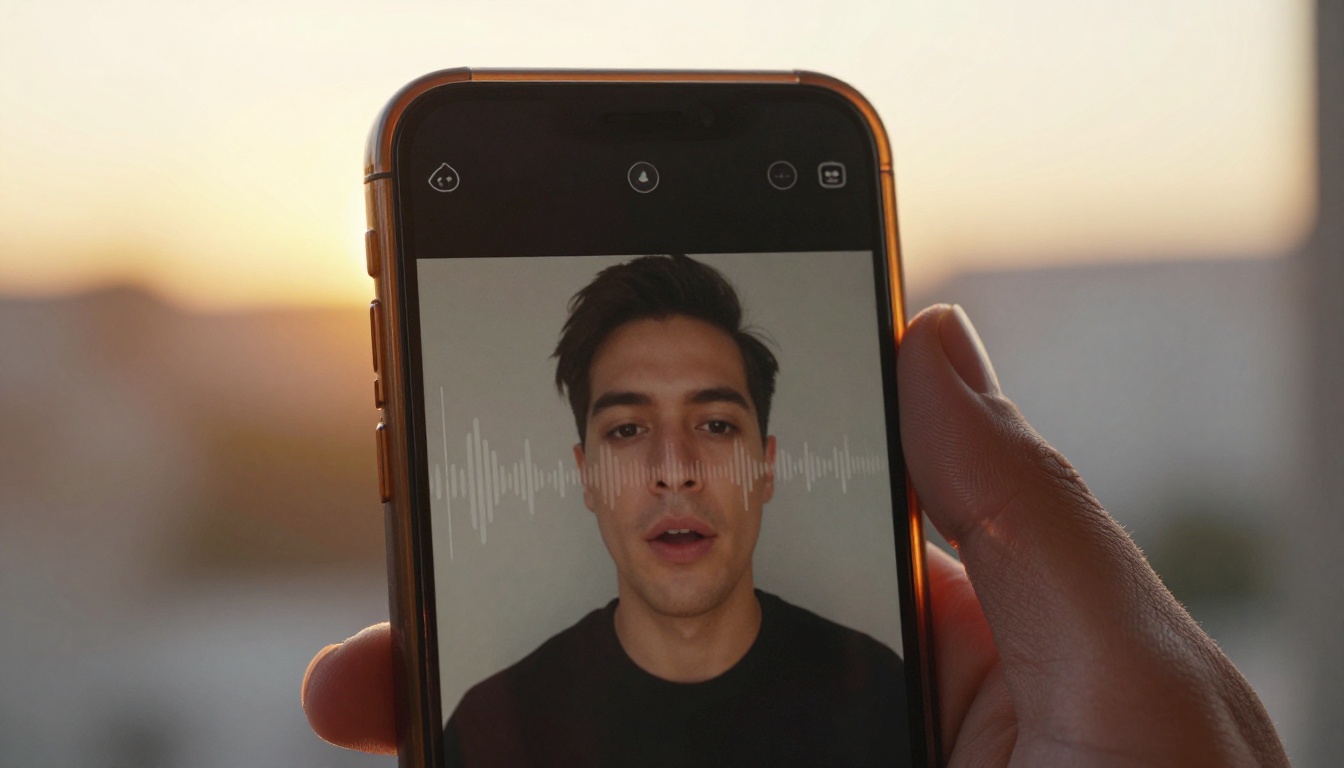
ابدأ مزامنة الصوت مع الفيديو على PicassoIA
كل النماذج المذكورة في هذا المقال، بما في ذلك Lipsync 2، وLipsync 2 Pro، وOmni Human 1.5، وElevenLabs V3، وChatterbox، متاحة على PicassoIA دون أي تثبيت محلي أو إعداد لوحدة GPU. تشغّلها مباشرة في المتصفح.
أسرع طريقة للبدء: اختر صورة لنفسك، واكتب فقرة قصيرة من النص، وولّد الصوت بنموذج تحويل نص إلى كلام، ثم شغّله عبر نموذج Lipsync. عادةً ما يستغرق الناتج الأول أقل من خمس دقائق من البداية إلى النهاية.
بمجرد أن ترى كيف تترابط الأجزاء، تصبح سير العمل الأطول، مثل الدبلجة متعددة اللغات، وتوليد الأفاتار بالدفعات، والشخصيات الصوتية المخصصة عبر سلاسل الفيديو، امتدادات مباشرة للعملية الأساسية نفسها. الحاجز الوحيد هو التجربة لأول مرة.
زامن أول فيديو بصوتك اليوم على PicassoIA.


