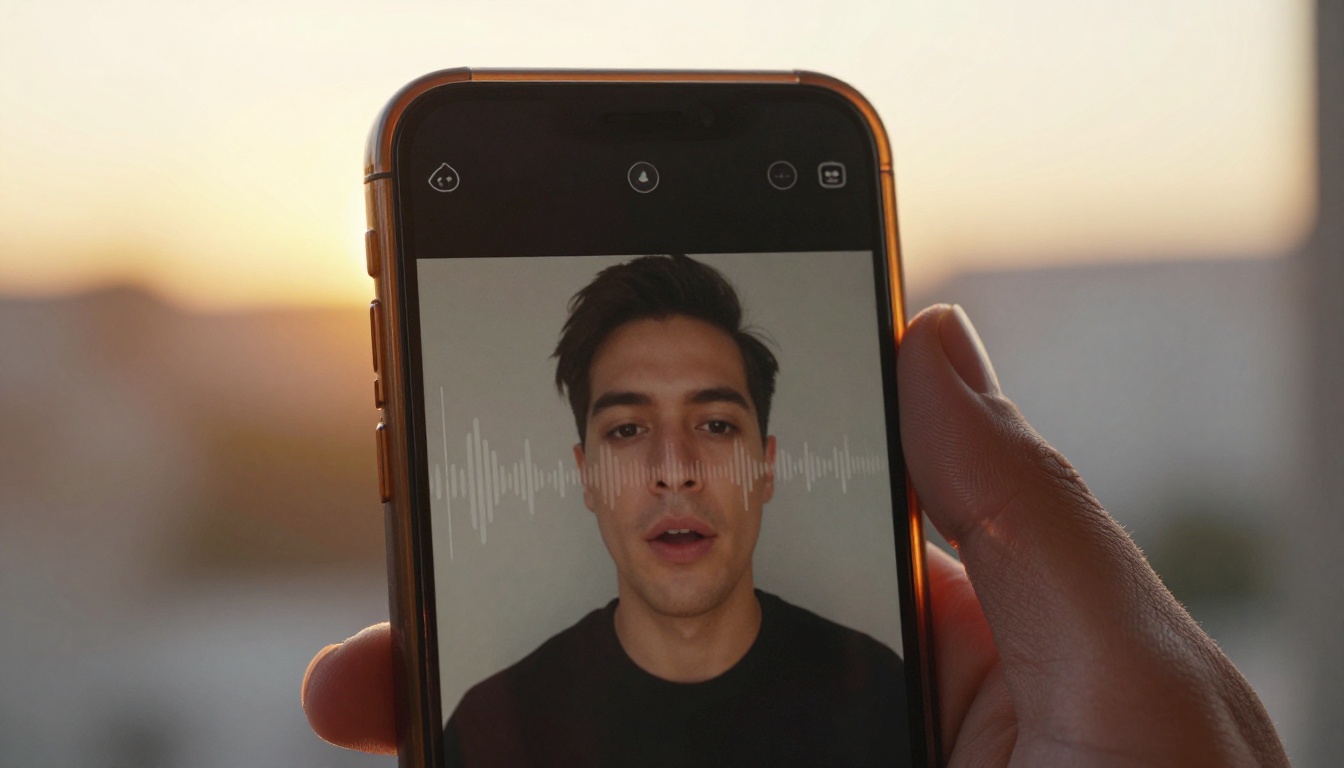
Antes, unir una grabación de voz con el movimiento de los labios en un video requería un estudio, un animador experto y días de trabajo minucioso. El lipsync con IA reduce ese proceso a segundos. Los modelos entrenados con millones de horas de grabaciones de rostros hablando analizan ahora los fonemas del audio fotograma a fotograma, deformando la geometría del rostro para hacer coincidir cada sonido con una precisión de subpíxeles. El resultado es un video en el que la persona habla como si se hubiera grabado así.
Esto va mucho más allá de crear contenido por diversión. Los equipos de producto doblan demos a una docena de idiomas en una tarde. Los educadores traducen clases grabadas sin volver a filmar nada. Los podcasters crean canales con rostros hablantes a partir de simples archivos de audio, sin necesidad de montar una cámara. Cuando la fricción se acerca a cero, los casos de uso se multiplican rápido.
Cómo funciona realmente el lipsync con IA
El doblaje tradicional reemplaza la pista de audio y espera que el público tolere el desajuste. El lipsync con IA hace lo contrario: lee el nuevo audio y remodela el rostro para que coincida con él.
El proceso se divide en tres etapas:
- Extracción de fonemas: el modelo analiza el audio en unidades fonéticas distintas, las unidades de sonido más pequeñas del habla. Cada fonema corresponde a una forma específica de la boca.
- Detección del rostro y mapeo de puntos de referencia: el modelo identifica los puntos faciales alrededor de la mandíbula, los labios, los dientes y la barbilla en cada fotograma.
- Deformación y mezcla a nivel de píxel: la zona de los labios se deforma para igualar la forma del fonema objetivo y se mezcla con el resto del rostro, conservando la textura de la piel, la iluminación y el movimiento existente.
💡 Los mejores modelos manejan los movimientos de la cabeza, las oclusiones parciales (una mano que cruza el rostro a mitad de frase) e incluso las gafas o la barba sin perder precisión en la sincronización.
El resultado es un video en el que cada fotograma del movimiento de la boca coincide con el nuevo audio, independientemente de lo que mostrara originalmente el video.
Los dos flujos de trabajo que importan
Antes de elegir una herramienta, decide qué flujo de trabajo vas a usar realmente. Los modelos optimizados para cada uno son lo bastante distintos como para que elegir mal te cueste calidad.
Flujo A: cambio de voz en un video existente. Tienes un video en el que alguien ya habla. Quieres reemplazar la voz (otro idioma, otro hablante o una voz generada con IA) y que los labios coincidan con el nuevo audio. Es el proceso clásico de doblaje.
Flujo B: animar una imagen fija o un video sin voz. Tienes una foto o un video en el que nadie habla y quieres añadir una pista de voz que haga que el sujeto parezca hablar. Es el proceso del avatar parlante.
| Característica | Cambio de voz en video | Avatar parlante |
|---|
| Entrada necesaria | Archivo de video más audio nuevo | Imagen o video más audio |
| Complejidad del procesamiento | Alta (debe coincidir con el movimiento existente) | Moderada |
| Mejores modelos | Lipsync 2 Pro, Lipsync Precision | Omni Human 1.5, Fabric 1.0 |
| Caso de uso más común | Doblaje, localización | Marketing, contenido para redes sociales, educación |
| Aspecto del resultado | Coincide con el video original | Movimiento totalmente generado |
Ambos flujos son compatibles con los modelos que se tratan aquí. La elección del modelo importa más de lo que la mayoría espera al principio.
Elige el modelo de lipsync adecuado
La categoría de lipsync en PicassoIA cuenta con doce modelos, cada uno con una fortaleza específica. Estas son las diferencias de los principales, para que puedas decidir rápido.
Velocidad frente a precisión
Lipsync Speed de HeyGen procesa video rápido, por lo que es la mejor opción cuando tienes muchos clips o necesitas iteraciones de vista previa rápidas. Lipsync Precision de HeyGen sacrifica tiempo de procesamiento a cambio de una precisión más ajustada a nivel de fotograma, algo crítico en planos cercanos donde un solo fotograma desincronizado se nota de inmediato.
Sincronización de uso general
Lipsync 2 de Sync está diseñado específicamente para sincronizar voz y video. Gestiona un amplio rango de calidad de video de entrada y mantiene la coherencia en clips largos sin desfasarse. Para trabajos que exigen la máxima precisión, Lipsync 2 Pro añade una corrección sub-fonémica que se aprecia al reproducir a resolución completa en una pantalla grande.
React 1 de Sync es la opción más nueva de esta familia. Maneja mejor el habla rápida, los diálogos superpuestos y los ritmos de habla poco habituales que las versiones anteriores, lo que lo hace valioso para contenido de ritmo rápido o para cualquier caso con patrones de acento de hablantes no nativos.
Especialistas en avatares parlantes
Omni Human 1.5 de ByteDance destaca al animar fotos fijas hasta convertirlas en videos parlantes totalmente realistas. El modelo genera no solo el movimiento de los labios, sino también el balanceo natural de la cabeza, el parpadeo y las microexpresiones que hacen que el resultado parezca genuinamente vivo. Fabric 1.0 de Veed sigue un enfoque parecido con un estilo de movimiento más suave, especialmente útil en contenido profesional o corporativo donde se prefiere una animación sutil a un movimiento expresivo.
P Video Avatar se especializa en crear videos de avatar en bucle a partir de una sola imagen de referencia, útil para mantener un mismo presentador en muchos videos sin volver a grabar nunca.
Herramientas de doblaje multilingüe
Video Translate de HeyGen integra traducción, generación de voz y lipsync en un solo flujo que cubre más de 150 idiomas. Para el simple reemplazo de audio en idiomas fonéticamente complejos, Kling Lip Sync de Kuaishou maneja idiomas rápidos y tonales que desconciertan a los modelos entrenados principalmente con patrones fonéticos del inglés. Pixverse Lipsync está optimizado para formatos de video breves y genera directamente en dimensiones adecuadas para contenido vertical.
Genera primero la voz
Si trabajas con una voz grabada previamente o con un archivo de audio existente, puedes saltarte esta sección por completo. Pero si necesitas generar la voz a partir de texto, la conversión de texto a voz con IA ha alcanzado un nivel de calidad en el que el audio resulta realmente difícil de distinguir de una voz humana grabada en un entorno de escucha controlado.
El flujo es sencillo: genera primero el audio y luego envíalo al modelo de lipsync.
ElevenLabs V3 produce voces muy naturales, con emoción y ritmo precisos. Destaca especialmente en narraciones habladas y diálogos de mayor duración, donde el ritmo y las pausas para respirar deben sonar humanos. Para un resultado multilingüe con calidad constante, ElevenLabs v2 Multilingual admite más de 30 idiomas manteniendo la misma identidad de voz en todos ellos.
Minimax Speech 2.8 HD es la opción cuando necesitas audio de calidad de estudio para un video con producción profesional. El nivel HD capta sutiles patrones de respiración y la resonancia vocal que los modelos más económicos aplanan.
Para la clonación de voz, Qwen3 TTS te permite aportar una muestra de voz corta y generar un habla que suene como el mismo hablante. Chatterbox de Resemble AI añade control de emoción, lo que te permite indicar si la salida debe sonar entusiasta, tranquila, autoritaria o conversacional. Esto cambia de forma notable el resultado del lipsync, porque el habla emocional tiene una geometría de la boca muy distinta a la de una lectura plana.
Para velocidad a gran escala, Flash v2.5 de ElevenLabs genera audio casi en tiempo real, lo que resulta útil cuando procesas lotes de contenido o pruebas muchas variantes de guion de forma rápida.
Cómo usar Lipsync 2 en PicassoIA
Lipsync 2 es la herramienta más directa para el caso de uso principal: tomar un video con un rostro que habla, reemplazar la pista de voz y lograr que los labios coincidan con precisión con el nuevo audio.
Paso 1: prepara tu video
Tu video de origen debe tener un rostro claramente visible y buena iluminación. El modelo admite la mayoría de los niveles de calidad, pero una entrada muy comprimida reducirá la nitidez del resultado. La resolución ideal es 720p o superior. Si tu video tiene varios cortes de cámara, procesa cada segmento por separado para obtener resultados más limpios.
Paso 2: prepara tu audio
Exporta el audio como archivo WAV o MP3 limpio. Si generaste la voz con un modelo de texto a voz, descarga el archivo de audio antes de continuar. Asegúrate de que la duración del audio coincida con la del video o sea muy cercana.
Paso 3: abre Lipsync 2
Ve a la página del modelo Lipsync 2 en PicassoIA. Verás los campos para subir los archivos de video y audio.
Paso 4: sube tus archivos
Sube tu video de origen y tu archivo de audio. Formatos de video aceptados: MP4, MOV, AVI. Formatos de audio aceptados: WAV, MP3, M4A.
Paso 5: ajusta los parámetros
- Modo de sincronización: para un solo rostro que habla, usa el modo de un solo hablante que viene por defecto.
- Calidad de salida: selecciona la opción más alta disponible para el resultado final. Usa una calidad más baja para las vistas previas rápidas y ahorrar tiempo de procesamiento.
- Mezcla de la zona de los labios: si el modelo ofrece esta opción, un valor entre 0,7 y 0,85 da una mezcla natural. Si es demasiado alto, la zona de los labios parecerá superpuesta; si es demasiado bajo, quedarán huecos visibles en la sincronización.
Paso 6: genera y revisa
Pulsa generar. El procesamiento suele tardar entre 30 y 120 segundos, según la duración del video y la carga actual del servidor. Descarga el resultado y revísalo a velocidad de reproducción completa. Presta especial atención a las pausas del audio: el silencio debe producir posiciones de boca cerradas o ligeramente cerradas, no bocas abiertas congeladas.
💡 Para videos de rostro cercano donde el sujeto está cerca de la cámara, usa Lipsync 2 Pro en su lugar. La corrección sub-fonémica se aprecia claramente a distancias cortas y compensa el tiempo de procesamiento algo mayor.
Lipsync para doblaje multilingüe
La aplicación comercialmente más potente del lipsync con IA es doblar contenido de video a otros idiomas sin volver a grabar nada. Un solo video de origen puede servir de base para versiones en español, francés, portugués, japonés y más de otros 100 idiomas, cada una con labios que coinciden con el audio traducido.
El flujo estándar funciona así:
- Transcribe el audio original (usa un modelo de voz a texto si no tienes guion)
- Traduce la transcripción al idioma de destino
- Genera el habla traducida con un modelo de texto a voz adaptado a la voz del hablante
- Pasa el nuevo audio por un modelo de lipsync sobre el video original
Video Translate reúne esos cuatro pasos en una sola herramienta. Sube el video, selecciona el idioma de destino y el modelo se encarga automáticamente de la transcripción, la traducción, la generación de voz y el lipsync. Para grandes volúmenes o para idiomas con una temporización fonética muy distinta (el mandarín y el japonés tienden a ser más breves por concepto que el inglés), el audio traducido a veces es más corto que el original. Ralentizar ligeramente la velocidad de reproducción de la voz o permitir que el modelo ajuste la temporización puede evitar que el video termine antes que el audio.
Para los idiomas en los que la precisión fonética es crítica, Kling Lip Sync maneja mejor los idiomas tonales y fonéticamente complejos que los modelos entrenados principalmente en inglés, una distinción importante cuando empiezas a publicar contenido en mandarín, vietnamita o tailandés.
De foto a avatar parlante
La animación de imágenes fijas es, posiblemente, la aplicación más llamativa del lipsync con IA: subes una sola foto de una persona, aportas un archivo de audio y recibes un video de esa persona hablando con naturalidad. Sin cámara. Sin configuración. Sin estudio.
Omni Human 1.5 lo resuelve con una calidad que incluye patrones de parpadeo realistas, movimientos sutiles de la cabeza y un balanceo natural de los hombros. El resultado no parece un rostro rígido con labios que se mueven. Parece un video.
Buenas prácticas para la foto de entrada:
- Rostro mirando al frente o con un ángulo de 3/4 leve: Las tomas de perfil directo limitan la capacidad del modelo para generar una geometría natural de la boca desde ambos lados del rostro.
- Buena iluminación, sombras mínimas en el rostro: El modelo lee los puntos de referencia faciales a partir de los datos de píxeles. Las sombras intensas sobre la zona de la boca degradan la precisión de la sincronización.
- Expresión inicial neutra o levemente expresiva: Una pose muy exagerada en la foto original chocará con la expresión generada y creará incoherencias visuales.
- Alta resolución: Mínimo 512px en la zona del rostro. Más es significativamente mejor.
Fabric 1.0 produce un movimiento algo más suave que funciona bien en presentaciones profesionales o corporativas. P Video Avatar es la opción si necesitas un avatar en bucle que se pueda reutilizar en muchos videos como un presentador coherente, sin que el movimiento varíe entre sesiones.
El modelo base Omni Human (versión anterior) sigue siendo una opción sólida si necesitas un procesamiento más rápido y un resultado algo más estilizado en comparación con la versión 1.5.
4 problemas que arruinan la calidad de la sincronización
Incluso con el mejor modelo, ciertos problemas en la entrada siempre producen malos resultados. Corregirlos antes de ejecutar el modelo es más rápido que repetir el proceso después.
1. Audio con mucho ruido de fondo
Los modelos leen el audio para calcular la temporización de los fonemas. La música de fondo, el eco o el ruido ambiental hacen que la extracción de fonemas sea menos precisa, lo que provoca que los movimientos de los labios se desvíen ligeramente. Pasa tu audio por un paso de reducción de ruido antes de subirlo. Incluso una reducción de ruido básica mejora notablemente la precisión de la sincronización.
2. Varios hablantes en un mismo video
La mayoría de los modelos de lipsync siguen por defecto un solo rostro. Si dos personas hablan y ambas son visibles, el modelo puede aplicar el movimiento de labios a las dos a la vez o limitarse al rostro principal. Usa un modelo con soporte explícito para varios hablantes o corta en segmentos de un solo hablante antes de procesar.
3. Ángulos extremos de la cabeza
Un perfil, una cabeza muy inclinada o un rostro parcialmente tapado por un objeto harán que el modelo tenga dificultades para detectar los puntos de referencia. La zona de los labios puede deformarse de forma incorrecta o parpadear entre fotogramas. Recorta o estabiliza esos momentos en tu editor de video antes de ejecutar el modelo de lipsync.
4. Diferencia de duración entre audio y video
Si el audio es bastante más largo que el video, el final del habla no tendrá fotogramas con los que sincronizarse. Recorta siempre el audio para que coincida con la duración del video (o al revés) antes de ejecutar el modelo. Un margen de dos segundos al final del video suele bastar para evitar que el audio se corte.
💡 Un enfoque de dos pasadas funciona bien con contenido largo. Procesa el video en segmentos de 30 a 60 segundos y luego une los clips resultantes. Los segmentos más cortos se procesan más rápido y te dan más control sobre qué secciones necesitan repetirse sin reprocesar todo el clip.
Combinar la generación de voz y el lipsync
El enfoque de producción más flexible combina un modelo de texto a voz con un modelo de lipsync para que ni el audio ni el video tengan que grabarse desde cero. Escribe un guion. Genera la voz. Aplica el lipsync sobre una imagen de referencia o un clip de material de archivo. El resultado es un video de rostro parlante totalmente producido, sin cámara, sin configuración de micrófono y sin reservar un estudio.
Para contenido en inglés, la combinación de ElevenLabs V3 para la generación de voz y Lipsync 2 Pro para la sincronización labial produce actualmente algunos de los resultados más realistas disponibles. El modelo de voz captura la respiración y el ritmo naturales que el modelo de lipsync puede leer con limpieza para alinear los fonemas con precisión.
Para contenido multilingüe a gran escala, Minimax Speech 2.8 HD combinado con Kling Lip Sync maneja bien los idiomas tonales y fonéticamente complejos, sin el desfase temporal que aparece en los modelos entrenados principalmente con idiomas occidentales. Si tu audiencia es global y quieres un único flujo que cubra también la traducción, Video Translate es el camino más rápido de un solo video de origen a una versión localizada.
Para el contenido con avatares, en el que controlas por completo lo visual, Chatterbox Pro de Resemble AI te da un control detallado sobre cómo suena la voz, y alimenta una señal de audio más expresiva en Omni Human 1.5 para una animación del avatar que responde al matiz emocional del habla, no solo a su temporización.
Empieza a sincronizar voz con video en PicassoIA
Todos los modelos mencionados en este artículo, incluidos Lipsync 2, Lipsync 2 Pro, Omni Human 1.5, ElevenLabs V3 y Chatterbox, están disponibles en PicassoIA sin instalación local ni configuración de GPU. Los ejecutas directamente en el navegador.
La forma más rápida de empezar: elige una foto tuya, escribe un párrafo corto de texto, genera el audio con un modelo de texto a voz y pásalo por un modelo de lipsync. El primer resultado suele tardar menos de cinco minutos de principio a fin.
Cuando veas cómo encajan las piezas, los flujos más largos (el doblaje multilingüe, la generación de avatares por lotes, las personalidades de voz personalizadas en series de video) se convierten en extensiones sencillas del mismo proceso básico. La barrera está en probarlo la primera vez.
Sincroniza tu primera voz con video hoy mismo en PicassoIA.


