A distância entre gravar uma voz e fazer os lábios de um vídeo se mexerem em sincronia costumava exigir um estúdio, um animador especializado e dias de trabalho minucioso. O lipsync de IA reduz isso a segundos. Modelos treinados com milhões de horas de imagens de rostos falando agora analisam os fonemas do áudio quadro a quadro, deformando a geometria do rosto para casar cada som com precisão de subpixel. O resultado é um vídeo falado que parece ter sido filmado assim.
Isso vai muito além da criação de conteúdo por diversão. Equipes de produto estão dublando demonstrações para uma dúzia de idiomas em uma tarde. Educadores traduzem aulas gravadas sem refilmar nada. Podcasters montam canais com apresentadores falando só a partir de arquivos de áudio, sem nenhuma configuração de câmera. Quando o atrito cai para quase zero, os casos de uso se acumulam rapidamente.
Como o lipsync de IA realmente funciona
A dublagem tradicional substitui a faixa de áudio e torce para que o público tolere a discrepância. O lipsync de IA faz o oposto: lê o novo áudio e remodela o rosto para combiná-lo.
O processo se divide em três etapas:
- Extração de fonemas: o modelo separa o áudio em unidades fonéticas distintas, as menores unidades de som da fala. Cada fonema corresponde a um formato específico da boca.
- Detecção do rosto e mapeamento de pontos de referência: o modelo identifica pontos de referência faciais ao redor da mandíbula, dos lábios, dos dentes e do queixo em cada quadro.
- Deformação e mesclagem em nível de pixel: a região dos lábios é deformada para corresponder ao formato do fonema alvo e mesclada de volta ao rosto ao redor, preservando a textura da pele, a iluminação e o movimento existente.
💡 Os melhores modelos lidam com o movimento da cabeça, com oclusão parcial (uma mão cruzando o rosto no meio da frase) e até com óculos ou pelos faciais sem perder a precisão da sincronia.
O resultado é um vídeo em que cada quadro do movimento da boca corresponde ao novo áudio, independentemente do que o vídeo original mostrava.
Os dois fluxos de trabalho que importam
Antes de escolher uma ferramenta, decida qual fluxo de trabalho você está realmente executando. Os modelos otimizados para cada um são diferentes o suficiente para que escolher o errado custe qualidade.
Fluxo A: troca de voz em vídeo existente. Você tem um vídeo em que alguém já está falando. Quer substituir a voz (outro idioma, outro locutor ou uma voz gerada por IA) e fazer os lábios acompanharem o novo áudio. Esse é o pipeline clássico de dublagem.
Fluxo B: animar uma imagem fixa ou um vídeo sem fala. Você tem uma foto ou um vídeo sem ninguém falando e quer adicionar uma faixa de voz que faça o sujeito parecer falar. Esse é o pipeline do avatar falante.
| Recurso | Troca de voz em vídeo | Avatar falante |
|---|
| Entrada necessária | Arquivo de vídeo mais novo áudio | Imagem ou vídeo mais áudio |
| Complexidade de processamento | Alta (precisa acompanhar o movimento existente) | Moderada |
| Melhores modelos | Lipsync 2 Pro, Lipsync Precision | Omni Human 1.5, Fabric 1.0 |
| Caso de uso mais comum | Dublagem, localização | Marketing, conteúdo para redes sociais, educação |
| Sensação do resultado | Acompanha o vídeo original | Movimento totalmente gerado |
Os dois fluxos são compatíveis com os modelos abordados aqui. A escolha do modelo importa mais do que a maioria das pessoas espera quando está começando.
Escolha o modelo de lipsync certo
A categoria de lipsync no PicassoIA tem doze modelos, cada um com um ponto forte específico. Veja como os principais se diferenciam para que você possa decidir rapidamente.
Velocidade ou precisão
Lipsync Speed, da HeyGen, processa vídeos rapidamente, o que o torna a escolha certa quando você tem um grande volume de clipes ou precisa de iterações rápidas de pré-visualização. Lipsync Precision, da HeyGen, troca tempo de processamento por uma precisão mais apertada quadro a quadro, o que se torna essencial em planos fechados, onde até um único quadro fora de sincronia fica imediatamente visível.
Sincronia de uso geral
Lipsync 2, da Sync, foi criado especificamente para a sincronização de voz com vídeo. Ele lida com uma ampla variedade de qualidade de vídeo de entrada e mantém a consistência em clipes mais longos sem sair do compasso. Para trabalhos que exigem a maior precisão, o Lipsync 2 Pro acrescenta uma correção sub-fonema que se torna visível ao reproduzir em resolução total em uma tela grande.
O React 1, da Sync, é a opção mais nova dessa família. Ele lida melhor com fala rápida, diálogos sobrepostos e ritmos de fala incomuns do que as versões anteriores, o que vale a pena testar em conteúdos de ritmo acelerado ou em qualquer coisa com padrões de sotaque de falantes não nativos.
Especialistas em avatares falantes
O Omni Human 1.5, da ByteDance, se destaca ao animar fotos fixas em vídeos falantes totalmente realistas. O modelo gera não apenas o movimento dos lábios, mas também o balanço natural da cabeça, piscadas e microexpressões que fazem o resultado parecer genuinamente vivo. O Fabric 1.0, da Veed, segue uma abordagem parecida, com um estilo de movimento mais suave que funciona especialmente bem em conteúdos profissionais ou corporativos, nos quais uma animação sutil é preferível a movimentos expressivos.
O P Video Avatar é especializado em criar vídeos de avatar em loop a partir de uma única imagem de referência, útil para construir uma persona de apresentador consistente em muitos vídeos sem nunca regravar.
Ferramentas de dublagem multilíngue
O Video Translate, da HeyGen, integra tradução, geração de voz e lipsync em um único pipeline que cobre mais de 150 idiomas. Para a simples substituição de áudio em idiomas foneticamente complexos, o Kling Lip Sync, da Kuaishou, lida com idiomas tonais e rápidos que tropeçam em modelos treinados principalmente com padrões fonéticos do inglês. O Pixverse Lipsync é otimizado para formatos de vídeo curtos e gera saídas diretamente em dimensões adequadas a conteúdos verticais.
Gere a voz primeiro
Se você trabalha com uma voz pré-gravada ou um arquivo de áudio existente, pode pular esta seção por completo. Mas, se precisar gerar a voz a partir de texto, a conversão de texto para fala por IA chegou a um nível de qualidade em que o resultado é genuinamente difícil de distinguir de uma fala humana gravada em um ambiente de escuta controlado.
O fluxo de trabalho é simples: gere o áudio primeiro e depois o envie ao modelo de lipsync.
O ElevenLabs V3 produz uma fala extremamente natural, com emoção e ritmo precisos. É especialmente forte em narração falada e diálogos mais longos, nos quais o ritmo e os padrões de respiração precisam soar humanos. Para uma saída multilíngue com qualidade consistente, o ElevenLabs v2 Multilingual oferece suporte a mais de 30 idiomas mantendo a mesma identidade de voz em todos eles.
O Minimax Speech 2.8 HD é a escolha quando você precisa de áudio com qualidade de estúdio que será usado em um vídeo produzido profissionalmente. A versão HD captura padrões sutis de respiração e ressonância vocal que modelos mais baratos achatam.
Para clonagem de voz, o Qwen3 TTS permite fornecer uma amostra curta de voz e gerar uma fala que soa como o mesmo locutor. O Chatterbox, da Resemble AI, adiciona controle de emoção, permitindo especificar se a saída deve soar animada, calma, autoritária ou conversacional, o que muda significativamente o resultado do lipsync, porque a fala emocional tem uma geometria da boca muito diferente da leitura monótona.
Para velocidade em escala, o Flash v2.5, da ElevenLabs, gera áudio em tempo quase real, o que é útil quando você está processando conteúdos em lote ou testando rapidamente muitas variações de roteiro.
Como usar o Lipsync 2 no PicassoIA
O Lipsync 2 é a ferramenta mais direta para o caso de uso central: pegue um vídeo com um rosto falando, substitua a faixa de voz e faça os lábios acompanharem o novo áudio com precisão.
Passo 1: prepare seu vídeo
O vídeo de origem deve ter um rosto claramente visível e boa iluminação. O modelo lida com a maioria dos níveis de qualidade, mas uma entrada muito comprimida reduzirá a nitidez do resultado. A resolução ideal é 720p ou superior. Se o vídeo tiver vários cortes de câmera, processe cada segmento separadamente para obter resultados mais limpos.
Passo 2: prepare seu áudio
Exporte seu áudio como arquivo WAV ou MP3 limpo. Se você gerou a voz com um modelo de texto para fala, baixe o arquivo de áudio antes de continuar. Certifique-se de que a duração do áudio seja igual ou próxima à duração do vídeo.
Passo 3: abra o Lipsync 2
Acesse a página do modelo Lipsync 2 no PicassoIA. Você verá os campos de entrada para os arquivos de vídeo e áudio.
Passo 4: envie suas entradas
Envie seu vídeo de origem e seu arquivo de áudio. Formatos de vídeo aceitos: MP4, MOV, AVI. Formatos de áudio aceitos: WAV, MP3, M4A.
Passo 5: defina os parâmetros
- Modo de sincronia: para um único rosto falante, use o modo padrão de um locutor.
- Qualidade de saída: selecione a opção mais alta disponível para a saída final. Use uma configuração de qualidade mais baixa para iterações rápidas de pré-visualização e economizar tempo de processamento.
- Mesclagem da região dos lábios: se o modelo expuser essa opção, um valor em torno de 0,7 a 0,85 oferece uma mesclagem natural. Um valor alto demais faz a região dos lábios parecer colada; um valor baixo demais deixa falhas de sincronia visíveis.
Passo 6: gere e revise
Clique em gerar. O processamento normalmente leva de 30 a 120 segundos, dependendo da duração do vídeo e da carga atual do servidor. Baixe o resultado e revise em velocidade normal de reprodução. Preste atenção especial às pausas no áudio: o silêncio deve produzir posições de boca fechada ou levemente fechada, e não bocas abertas congeladas.
💡 Para vídeos de cabeça falante em que o sujeito está perto da câmera, use o Lipsync 2 Pro no lugar. A correção sub-fonema é claramente visível em distâncias de close e vale o tempo de processamento um pouco maior.
Lipsync para dublagem multilíngue
A aplicação mais poderosa do lipsync de IA do ponto de vista comercial é dublar conteúdo de vídeo para outros idiomas sem regravar nada. Um único vídeo de origem pode se tornar a base de versões em espanhol, francês, português, japonês e mais de 100 outros idiomas, cada um com lábios que acompanham o áudio traduzido.
O pipeline padrão funciona assim:
- Transcreva o áudio original (use um modelo de fala para texto se você não tiver um roteiro)
- Traduza a transcrição para o idioma-alvo
- Gere a fala traduzida com um modelo de texto para fala compatível com a voz do locutor
- Passe o novo áudio por um modelo de lipsync sobre o vídeo original
O Video Translate reúne essas quatro etapas em uma única ferramenta. Envie o vídeo, selecione o idioma-alvo, e o modelo cuida automaticamente da transcrição, da tradução, da geração de voz e do lipsync. Para grandes volumes de conteúdo, ou para idiomas com tempos fonéticos muito diferentes (o mandarim e o japonês tendem a ser mais curtos por conceito do que o inglês), o áudio traduzido às vezes fica mais curto que o original. Reduzir um pouco a velocidade de reprodução da fala ou permitir que o modelo estique o tempo pode evitar que o vídeo termine antes do áudio.
Para idiomas em que a precisão fonética é crítica, o Kling Lip Sync lida melhor com idiomas tonais e foneticamente complexos do que modelos treinados principalmente em inglês, o que é uma distinção importante quando você começa a publicar conteúdo em mandarim, vietnamita ou tailandês.
De foto a avatar falante
A animação a partir de imagens fixas é, talvez, a aplicação mais impressionante do lipsync de IA: envie uma única foto de uma pessoa, forneça um arquivo de áudio e receba um vídeo dessa pessoa falando naturalmente. Sem câmera. Sem configuração. Sem estúdio.
O Omni Human 1.5 faz isso com uma qualidade que inclui padrões realistas de piscada, movimento sutil da cabeça e balanço natural dos ombros. O resultado não parece um rosto rígido com lábios se mexendo. Parece um vídeo.
Boas práticas para a foto de entrada:
- Rosto virado para a frente ou em um ângulo leve de 3/4: Fotos de perfil completo limitam a capacidade do modelo de gerar uma geometria natural da boca vista dos dois lados do rosto.
- Boa iluminação, com sombras mínimas no rosto: O modelo lê os pontos de referência faciais a partir dos dados de pixel. Sombras fortes sobre a região da boca reduzem a precisão da sincronização.
- Expressão inicial neutra ou levemente expressiva: Uma pose muito exagerada na foto de origem vai brigar com a expressão gerada e criar inconsistências visuais.
- Alta resolução: Mínimo de 512 px na região do rosto. Quanto maior, significativamente melhor.
O Fabric 1.0 produz um movimento um pouco mais suave, que funciona bem em apresentações profissionais ou corporativas. O P Video Avatar é a escolha se você precisa de um avatar em loop que possa ser reutilizado em muitos vídeos como uma persona de apresentador consistente, sem que o movimento varie entre sessões.
O modelo base do Omni Human (versão anterior) continua sendo uma opção sólida se você precisa de um processamento mais rápido e de uma saída um pouco mais estilizada em comparação com a versão 1.5.
4 problemas que arruínam a qualidade da sincronia
Mesmo com o melhor modelo, certos problemas na entrada produzem resultados ruins de forma consistente. Corrigi-los antes de rodar o modelo é mais rápido do que tentar de novo depois.
1. Áudio com muito ruído de fundo
Os modelos leem o áudio para determinar o tempo dos fonemas. Música de fundo, eco ou ruído ambiente tornam a extração de fonemas menos precisa, o que faz os movimentos dos lábios saírem levemente do compasso. Passe seu áudio por uma etapa de redução de ruído antes de enviá-lo. Até uma redução de ruído básica melhora perceptivelmente a precisão da sincronia.
2. Vários locutores no mesmo vídeo
A maioria dos modelos de lipsync rastreia um rosto por padrão. Se duas pessoas estiverem falando e ambas estiverem visíveis, o modelo pode aplicar o movimento dos lábios a ambas ao mesmo tempo ou apenas ao rosto principal. Use um modelo com suporte explícito a vários locutores ou corte para segmentos de um único locutor antes de processar.
3. Ângulos extremos da cabeça
Uma vista de perfil, uma cabeça muito inclinada ou um rosto parcialmente bloqueado por um objeto farão o modelo ter dificuldade na detecção de pontos de referência. A região dos lábios pode deformar incorretamente ou oscilar entre os quadros. Corte ou estabilize esses momentos no seu editor de vídeo antes de rodar o modelo de lipsync.
4. Diferença de duração entre áudio e vídeo
Se o áudio for significativamente mais longo que o vídeo, o final da fala não terá quadros para sincronizar. Sempre corte o áudio para igualar a duração do vídeo (ou o contrário) antes de rodar o modelo. Uma margem de dois segundos no fim do vídeo geralmente basta para evitar cortes.
💡 Uma abordagem em duas passagens funciona bem para conteúdos longos. Processe o vídeo em segmentos de 30 a 60 segundos e depois una os clipes resultantes. Segmentos menores são processados mais rápido e dão mais controle sobre quais trechos precisam de uma nova execução, sem reprocessar o clipe inteiro.
Combinando geração de voz e lipsync
A abordagem de produção mais flexível combina um modelo de texto para fala com um modelo de lipsync para que nem o áudio nem o vídeo precisem ser gravados do zero. Escreva um roteiro. Gere a voz. Faça o lipsync sobre uma imagem de referência ou um clipe de banco de imagens. O resultado é um vídeo falado totalmente produzido, sem câmera, sem configuração de microfone e sem reserva de estúdio.
Para conteúdo em inglês, a combinação do ElevenLabs V3 para geração de voz e do Lipsync 2 Pro para a sincronia labial produz atualmente alguns dos resultados mais realistas disponíveis. O modelo de voz captura respiração e ritmo naturais que o modelo de lipsync consegue ler com clareza para um alinhamento preciso de fonemas.
Para conteúdo multilíngue em escala, o Minimax Speech 2.8 HD combinado com o Kling Lip Sync lida bem com idiomas tonais e foneticamente complexos, sem a defasagem de tempo que aparece em modelos treinados principalmente com idiomas ocidentais. Se o público-alvo é global e você quer um único fluxo de trabalho que também cubra a tradução, o Video Translate é o caminho mais rápido de um único vídeo de origem até uma saída localizada.
Para conteúdo baseado em avatar, em que você controla totalmente o visual, o Chatterbox Pro, da Resemble AI, oferece controle refinado sobre como a voz soa, alimentando um sinal de áudio mais expressivo no Omni Human 1.5 para uma animação de avatar que responde à nuance emocional da fala, e não apenas ao seu tempo.
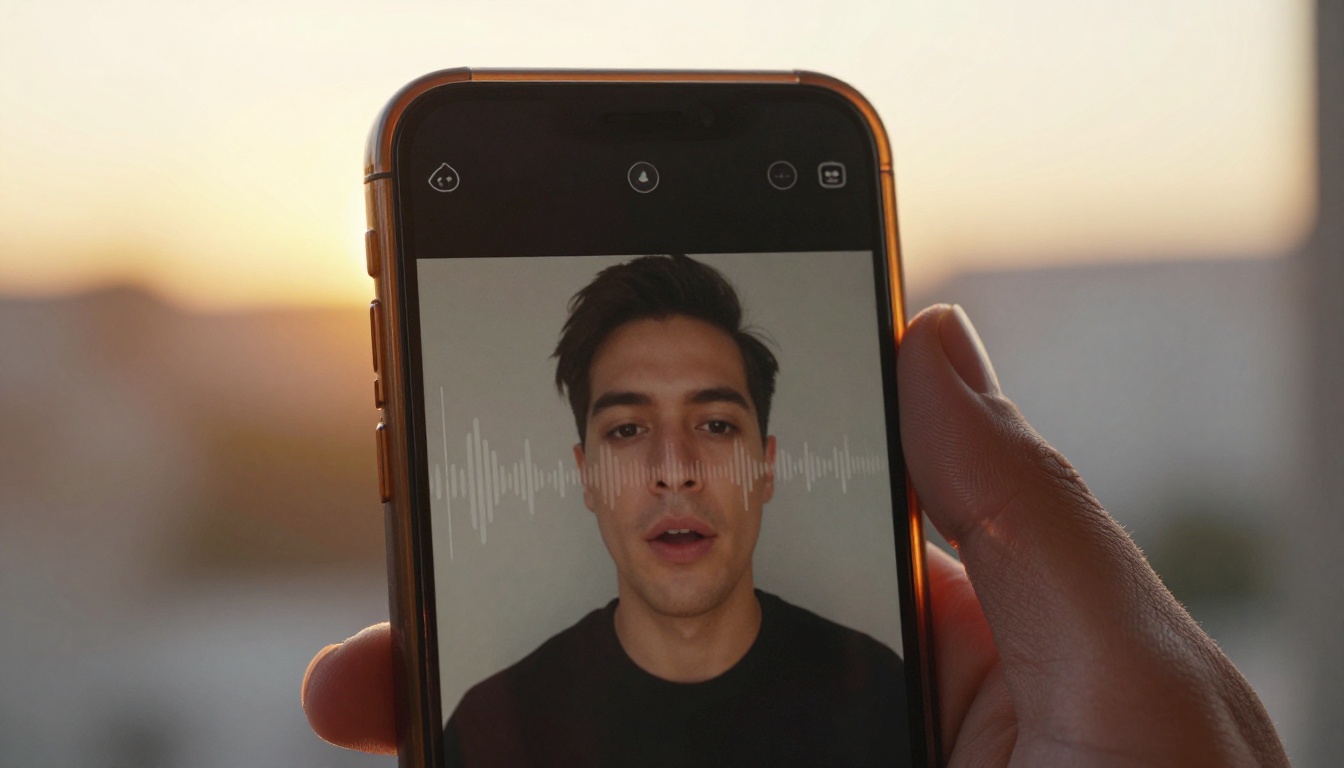
Todos os modelos citados neste artigo, incluindo o Lipsync 2, o Lipsync 2 Pro, o Omni Human 1.5, o ElevenLabs V3 e o Chatterbox, estão disponíveis no PicassoIA sem nenhuma instalação local ou configuração de GPU. Você os executa diretamente no navegador.
A forma mais rápida de começar: escolha uma foto sua, escreva um parágrafo curto de texto, gere o áudio com um modelo de texto para fala e rode tudo por um modelo de lipsync. O primeiro resultado normalmente leva menos de cinco minutos do início ao fim.
Quando você entender como as peças se conectam, os fluxos mais longos, a dublagem multilíngue, a geração de avatares em lote e as personas de voz personalizadas em séries de vídeo, se tornam extensões diretas do mesmo processo básico. A barreira é experimentar pela primeira vez.
Sincronize sua primeira voz com vídeo hoje mesmo no PicassoIA.


