يصل كل مستخدم لتوليد الصور بالذكاء الاصطناعي إلى لحظة معينة عاجلًا أم آجلًا. تكتب أمرًا نصيًا مفصلًا بعناية، وتضغط على التوليد، فيبدو شيء ما خاطئًا قليلًا. الأيدي بها ستة أصابع، ولافتة في الخلفية تحمل كلامًا غير مفهوم، والشخصية التي بنيتها عبر ثلاثة أوامر نصية دقيقة تبدو في الصورة التالية كأنها شخص مختلف تمامًا. هذه ليست أعطالًا عشوائية، بل نقاط عمياء بنيوية مدمجة في طريقة عمل نماذج توليد الصور الحالية فعلًا، ومعرفة كل واحدة منها هي الفرق بين هدر النقاط وبين إنتاج إبداعي فعّال ومقصود.
هذا عرض مباشر لما لا يستطيع نموذج توليد الصور بالذكاء الاصطناعي فعله بعد، ولماذا توجد كل قيود منه على المستوى التقني، وأي الأدوات الفعلية تساعد في سد كل فجوة.
مشكلة النصوص أسوأ مما تظن
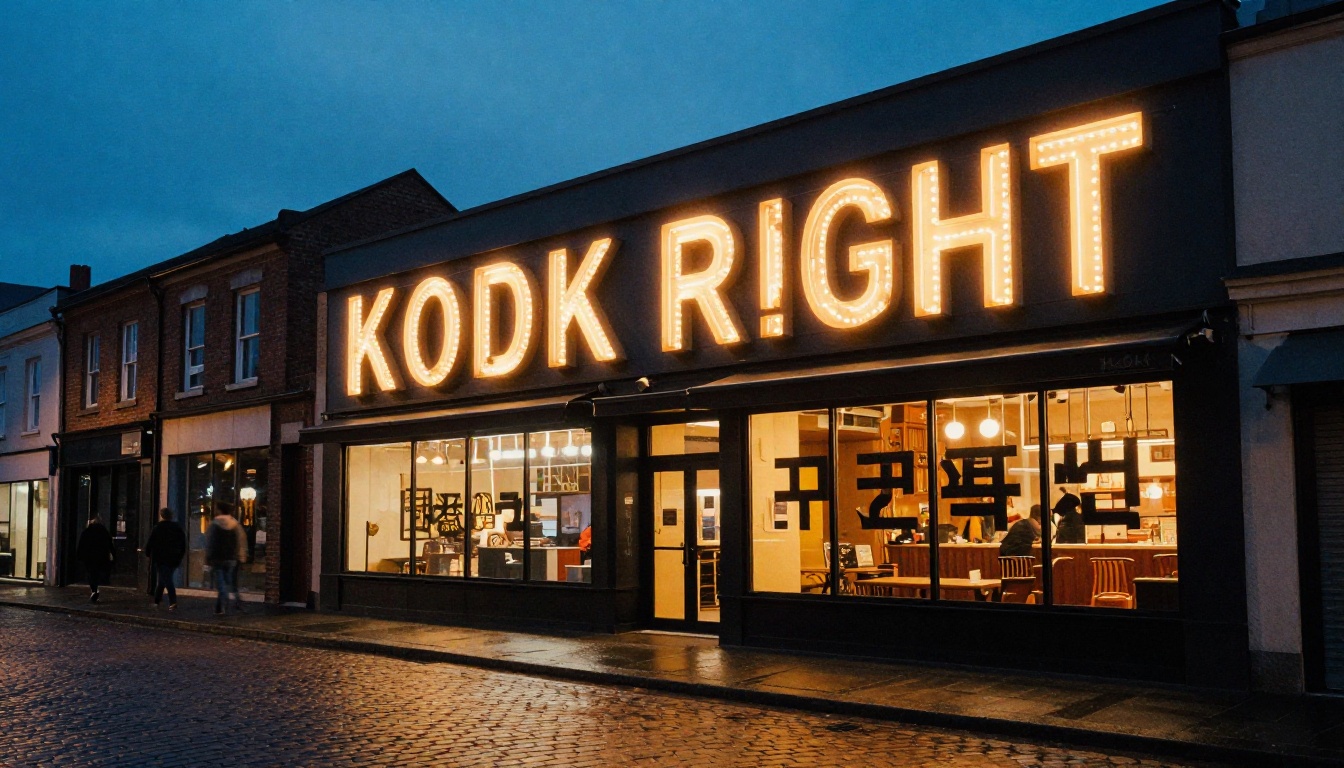
لا تكتب نماذج توليد الصور النصوص بالمعنى الحرفي. فهي لا تملك مفهومًا للحروف بوصفها رموزًا منفصلة تحمل معنى. بدلًا من ذلك، تتعلم أن أنماطًا بكسلية معينة تظهر قرب كلمات معينة في أوصاف الصور ضمن بيانات التدريب، ثم تعيد إنتاج تلك الملامس البصرية. والنتيجة شيء يبدو مقنعًا كنص حتى تقرأه عن قرب، وعندها ينهار إلى أشكال بلا معنى وخطوط متداخلة.
لماذا تنهار الحروف
عندما تطلب من نموذج الانتشار القياسي إظهار نص مقروء على لافتة أو غلاف كتاب أو ملصق مطبوع، يسحب النموذج من الارتباطات الإحصائية بين كلمات الوصف وأنماط البكسل. الكلمات القصيرة والشائعة تنجو أحيانًا كما هي. أما أي كلمة أطول، أو أي نص يتطلب تباعدًا دقيقًا بين الحروف وهندسة ثابتة، فيتدهور بسرعة. لا يملك النموذج قاموسًا داخليًا، ولا مفهومًا لأشكال الحروف بوصفها وحدات رمزية، ولا آلية للتحقق من أن ما صيّره قابل للقراءة فعلًا.
لهذا السبب تحتوي الصور المولّدة للمطاعم والواجهات وملصقات المنتجات والقوائم والكتب والصحف دائمًا تقريبًا على نصوص مشوهة. النموذج لا يرتكب خطأ وفق معاييره الخاصة، بل يطابق المظهر البصري للنص دون أن يرمّز أي معنى لغوي على الإطلاق.
تتفاقم المشكلة مع الأبجديات غير اللاتينية. فالنماذج المدربة في معظمها على بيانات إنجليزية تؤدي أداءً ضعيفًا بوجه خاص مع العربية والصينية والكورية والتايلاندية والسيريلية، فتنتج أشكالًا تذكّر بعائلة الكتابة بصريًا لكنها غير مقروءة إطلاقًا لمن يتحدث اللغة.
Riverflow 2.0 Pro هو الاستثناء
لا تشترك كل النماذج في هذا القيد بالدرجة نفسها. صُمم Riverflow 2.0 Pro خصيصًا مع التحكم في الخط الطباعي، ويتيح لك تضمين الخطوط وتحديد موضع نص مقروء بدقة أكبر بكثير من نماذج الانتشار القياسية. يقدم Riverflow 2.0 Fast الإمكانية الطباعية نفسها ضمن سير عمل أسرع للمشاريع الحساسة للوقت. وإذا كان النص الدقيق شرطًا صارمًا في مخرجاتك، فهذه النماذج هي الحل المباشر لا مجرد حل بديل.
💡 نصيحة: اجعل أي نص في أمرك النصي قصيرًا. ضع الكلمة المحددة بين علامتي اقتباس (مثلًا "SALE") واستخدم نموذجًا يفهم الطباعة. تفشل نماذج الانتشار القياسية باستمرار مع السلاسل النصية الأطول من كلمتين أو ثلاث كلمات شائعة.
الأيدي ما زالت كابوسًا متكررًا
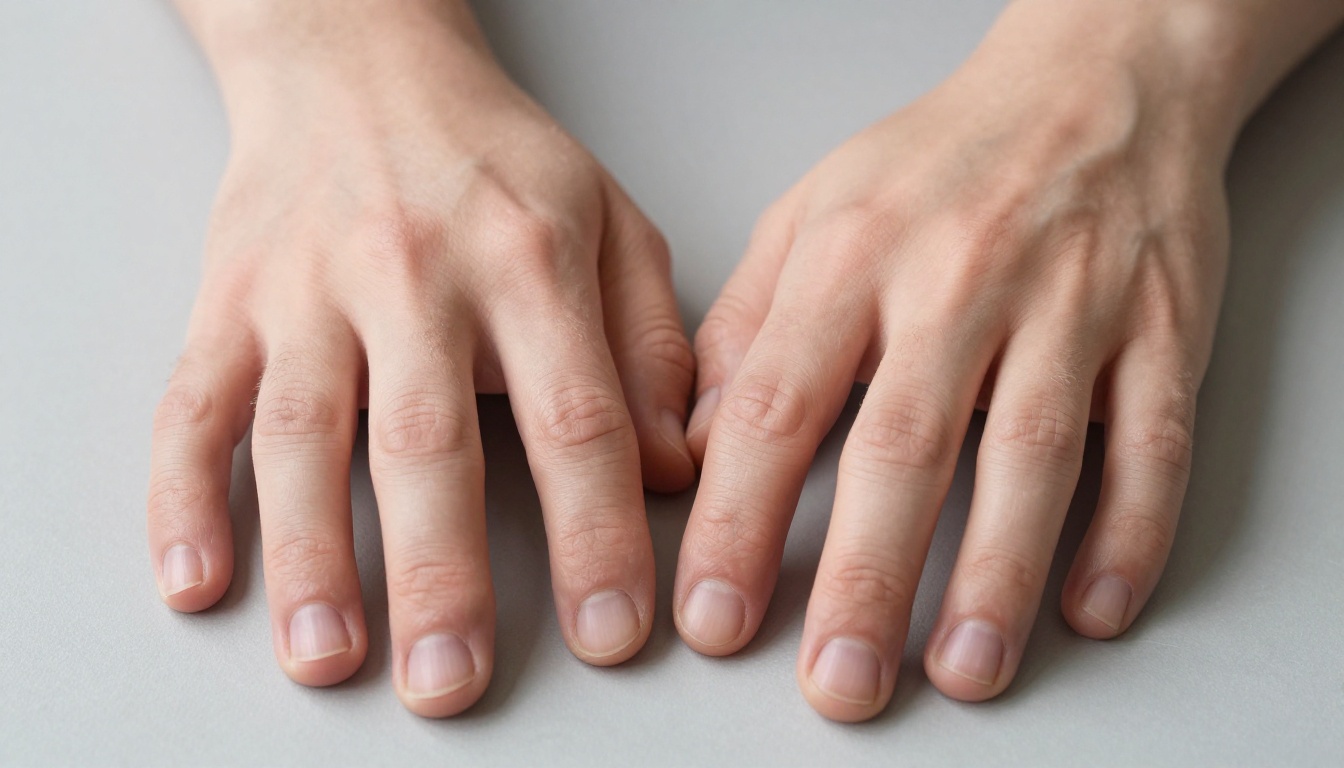
الأيدي هي الإخفاق الأكثر ذكرًا في توليد الصور بالذكاء الاصطناعي، والمشكلة عميقة الجذور. فبنية اليد البشرية معقدة: 27 عظمة، وتشكيلات وضعيات متغيرة، وتنوع هائل في الإضاءة والزوايا والإخفاء الجزئي. تحتوي بيانات التدريب على أيدٍ في ملايين التشكيلات، لكن النماذج فشلت باستمرار في استخلاص بنية تشريحية موثوقة من كل هذا التنوع.
لماذا يعدّ النموذج بشكل خاطئ
نماذج الانتشار لا تعدّ. لا توجد عملية حسابية تجري عندما يصيّر النموذج يدًا. عدد الأصابع الظاهر في المخرجات احتمال إحصائي يعتمد على الأنماط البكسلية التي تناسب التكوين المحيط، وليس قرارًا مقصودًا. وعندما تكون الأيدي مخفية جزئيًا، أو في وضعيات غير مألوفة، أو قرب أشياء معقدة أخرى، يوزّع النموذج أنماطًا شبيهة بالأصابع على المساحة المتاحة دون قيد تشريحي. ستة أصابع أمر شائع، والمفاصل المندمجة، وراحات اليد التي تبدو بلا عظام، والأيدي دون اتصال واضح بالمعصم، كلها تحدث بانتظام.
أسهمت البنى الأحدث المدربة على بيانات عالية الدقة ومنتقاة بعناية في تقليل هذه المشكلة بشكل ملحوظ. لكن حتى أقوى النماذج الحالية تنتج أخطاء في الأيدي تحت ظروف تكوين معينة، خاصة عندما تتفاعل الأيدي مع أشياء صغيرة، أو تمسك بأشياء، أو تكون في زوايا غير مألوفة.
إصلاح الأيدي بالتعديل الموضعي
نادرًا ما يحل تشديد الأمر النصي المشكلة. أكثر الحلول البديلة موثوقية هو التعديل الموضعي: توليد الصورة كاملة أولًا، ثم وضع قناع على منطقة اليد وإعادة توليدها تحديدًا بأمر نصي تشريحي مركّز. يجعل PicassoIA Image Editor Pro هذا السير مباشرًا، إذ يتيح لك رسم قناع حول المنطقة المشكلة وإعادة توليدها بينما يبقى باقي الصورة سليمًا. ويقدم Qwen Image Edit Plus دقة مشابهة في التعديل الموضعي مع حفاظ قوي على التفاصيل عند حواف القناع.
💡 نصيحة: أضف "خمسة أصابع، تشريح بشري صحيح، فصل طبيعي بين الأصابع، بلا أصابع إضافية" إلى أي أمر نصي يُظهر أيدي في المقدمة. لا يلغي ذلك المشكلة، لكنه يقلل نسبة الإخفاق بشكل ملموس.
الشخصية نفسها، ووجه مختلف
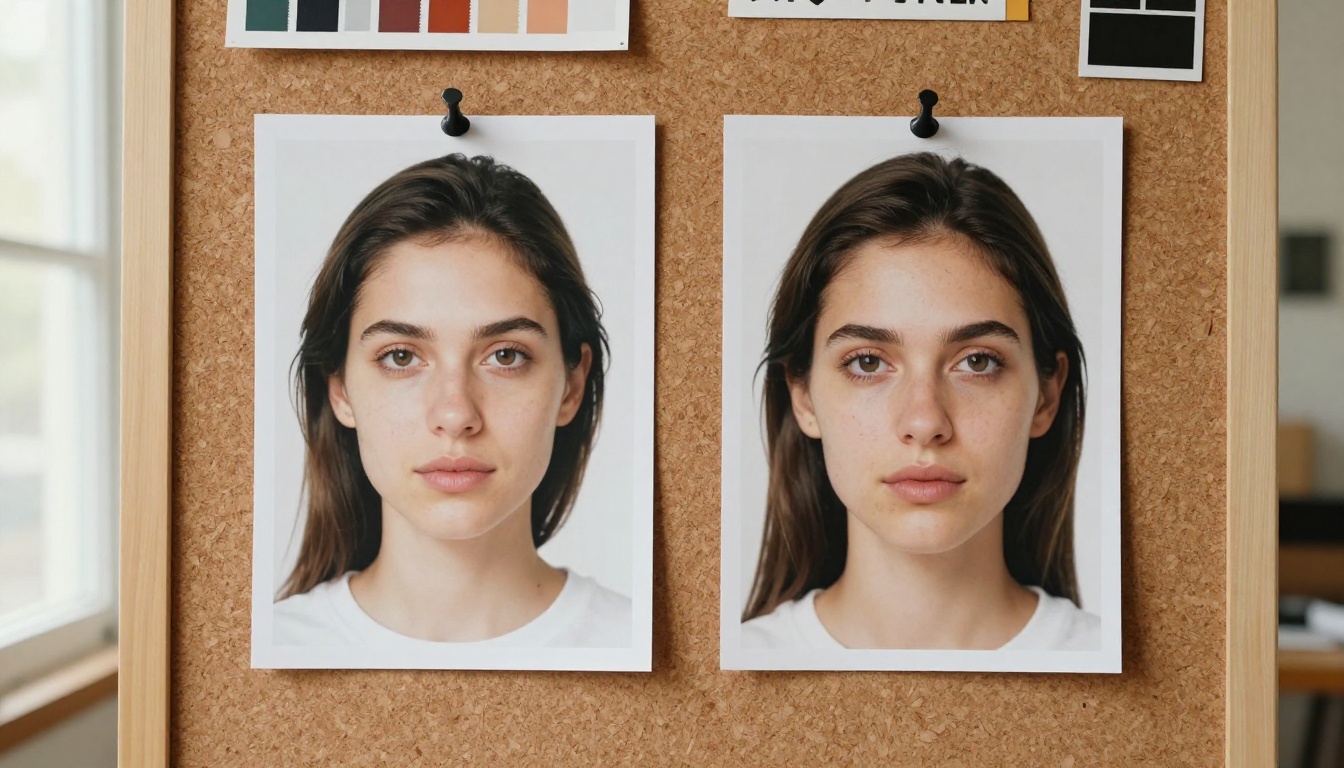
يُعد توليد الشخصية نفسها القابلة للتعرف عليها عبر صور متعددة من أكثر القدرات طلبًا في توليد الصور بالذكاء الاصطناعي، ومن أصعبها تحقيقًا بنماذج تحويل النص إلى صورة القياسية. اكتب الوصف الجسدي نفسه مرتين، وستحصل على شخصين مختلفين. غيّر صفة واحدة، وسيتغير الوجه مرة أخرى. هذه ليست مشكلة في مهارة كتابة الأوامر، بل خاصية بنيوية في طريقة توليد نماذج الانتشار لكل صورة بشكل مستقل من البداية.
مشكلة انجراف الهوية
تبدأ كل صورة يُنتجها نموذج الانتشار من ضجيج عشوائي. لا توجد ذاكرة للشخصية بين عمليات التوليد. حتى مع أوصاف جسدية شديدة التحديد (لون عينين دقيق، وشكل فك مميز، وملمس شعر محدد، وندبة فريدة)، يأخذ النموذج عينات من توزيع احتمالي وينتج تنويعة ضمن ذلك النطاق، لا استنساخًا لفرد ثابت. وكلما زادت عمليات التوليد، ابتعد الوجه أكثر عن القصد الأصلي.
يخلق هذا مشكلات ملموسة لحملات المنتجات، وسرد القصص البصرية، والشخصيات الخاصة بالعلامات التجارية، وأي سير عمل يتطلب شخصًا متكررًا قابلًا للتعرف عليه. فسلسلة صور عن "المرأة نفسها" تُنتج بالكامل عبر الأوامر النصية ستبدو كأنها اختبار أداء للممثلين، لا شخصية متسقة عبر المشاهد.
Flux Redux Dev للتنويعات المستقرة
يتعامل Flux Redux Dev مع هذه المشكلة بطريقة مختلفة. يأخذ صورة موجودة كمرجع له، ويولّد تنويعات بصرية متماسكة تحافظ على الهوية الأساسية للشخص وتكوينه وأسلوبه. وهذا أيسر طريق لتوليد شخصية متسقة دون تدريب LoRA مخصص من الصفر. وبالنسبة للحملات التي تتطلب وجهًا قابلًا للتعرف عليه عبر مشاهد متعددة، فإن استخدام Redux Dev مع صورة مرجعية واحدة قوية للوجه يقلل انجراف الهوية بين عمليات التوليد بشكل ملموس.
💡 نصيحة: ولّد أولًا صورة مثالية واحدة للشخصية باستخدام أعلى نموذج جودة لديك. ثم استخدم Flux Redux Dev لكل تنويعات المشاهد انطلاقًا من تلك الصورة المرجعية، بدلًا من إعادة كتابة الأمر النصي من الوصف في كل مرة.
الشعارات والعلامات التجارية الحقيقية
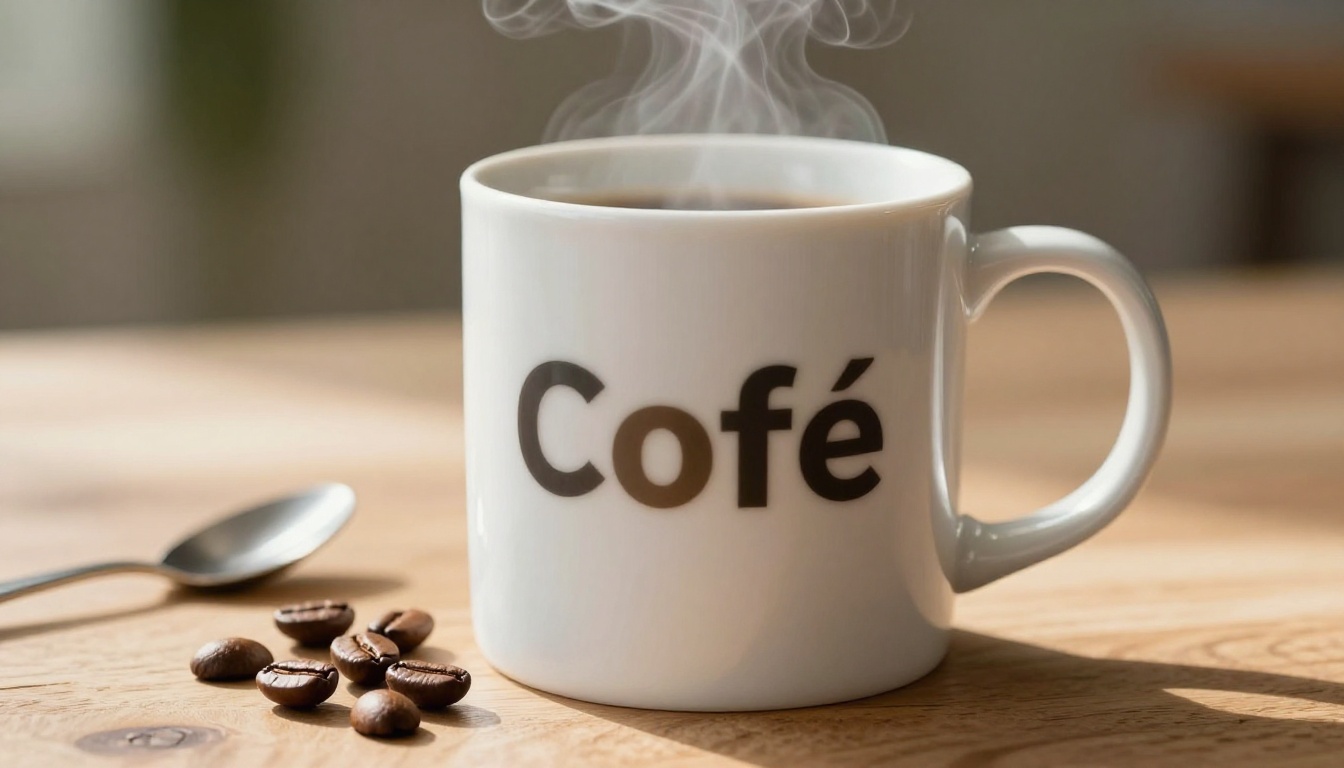
لا تستطيع نماذج توليد الصور إعادة إنتاج الشعارات المسجلة أو علامات العلامات التجارية المحددة بدقة. يعكس ذلك قيدًا قانونيًا مدمجًا في إجراءات التدريب، وقيدًا تقنيًا في الوقت نفسه: تعتمد الشعارات على نسب هندسية دقيقة، وقيم لونية محددة، وتباعد دقيق بين الحروف، وهذا ما لا يستطيع أخذ العينات في الانتشار إعادة بنائه بأمانة.
ماذا يحدث مع العلامات التجارية المسجلة
عندما تطلب منتجًا يحمل شعار علامة تجارية حقيقية، ينتج النموذج تقريبًا جماليًا. يبدو الشكل واللون صحيحين عند النظرة الأولى. أشكال الحروف تبدو قريبة من الصحة. لكن الحروف تتداخل، والنسب تنحرف، والدقة الهندسية اللازمة لدقة العلامة التجارية غائبة. دُرّبت النماذج على ملايين الصور التي تحتوي على علامات تجارية حقيقية، لكنها وُجِّهت أثناء التدريب لتجنب الاستنساخ الحرفي، لأسباب تتعلق بحقوق النشر، ولأن الدقة الهندسية المثالية على مستوى البكسل ليست ما يُحسّن له أخذ العينات في الانتشار.
الحل البديل لصور المنتجات
أنظف حل هو فصل خطوة التوليد عن خطوة العلامة التجارية تمامًا.
| السيناريو | أفضل نهج |
|---|
| نموذج أولي لمنتج بعلامة تجارية | ولّد شكل المنتج والإضاءة، وأضف الشعار في برنامج التصميم |
| لقطة لأسلوب الحياة تتضمن منتجًا بعلامة تجارية | استخدم نسخة عامة من المنتج في الأمر النصي |
| تغليف يحمل نص ملصق | ولّد الشكل والمادة، وأنشئ نص الملصق بشكل منفصل |
| صور حملة بمنتج حقيقي | استخدم الذكاء الاصطناعي للبيئة والجو، وادمج صورة المنتج الحقيقية فوقها |
يتفوق Seedream 4.5 في توليد أسطح منتجات نظيفة بدقة 4K، مع ملمس مواد دقيق وإضاءة مضبوطة. استخدمه لإنشاء البيئة البصرية، ثم أضف العلامة التجارية الدقيقة في Photoshop أو Figma أو أي برنامج تركيب بعد ذلك. ستبدو النتيجة مطابقة تمامًا لصورة مولّدة بالكامل بالذكاء الاصطناعي، لكن مع طباعة دقيقة للعلامة التجارية.
المنطق المكاني معطّل
ضع كرة حمراء إلى يسار مكعب أزرق. أظهر شخصين مع شخص ثالث يقف بينهما. ضع جسمًا في المقدمة بينما يقع آخر خلفه مباشرة بزاوية محددة. تفشل نماذج الانتشار القياسية في كل هذه الحالات بانتظام مُحبط. أخطاء الاستدلال المكاني منهجية لا عرضية.
الخلط بين اليمين واليسار
تعمل نماذج الانتشار عبر إزالة الضجيج على مستوى البكسل، لا عبر الاستدلال المكاني. "اليسار" و"اليمين" مفهومان علائقيان مجردان لا تربطهما النماذج إلا جزئيًا بالإحصاءات التكوينية التي اكتسبتها من بيانات التدريب. الارتباط الإحصائي حقيقي لكنه ضعيف. عمليًا، تتبادل المواضع اليسرى واليمنى أو تبقى غامضة نحو نصف المرات تقريبًا.
تميل اللغة المرتبطة بالكاميرا إلى الأداء بشكل أفضل من المصطلحات الاتجاهية. فعبارات مثل "جسم في المقدمة"، و"عنصر في الخلفية"، و"قريب من الكاميرا"، و"بعيد عن المشاهد"، و"الركن العلوي الأيمن من الإطار" ترتبط بأنماط التكوين التي استوعبها النموذج بشكل أكثر موثوقية. تتفوق الكلمات المفتاحية الموضعية المرتبطة بالإطار على الاتجاهات العلائقية المرتبطة بالموضوعات داخل الصورة.
العد والتموضع
العد غير موثوق بالقدر نفسه. "ثلاثة كلاب" كثيرًا ما تعطي اثنين أو أربعة. "خمسة أشخاص في مجموعة" نادرًا ما تنتج خمسة بالضبط. "شجرة واحدة على الجانب الأيمن" قد تصبح شجرتين أو لا شيء أحيانًا. لا يملك النموذج خطوة تحقق حسابية، لذلك يوزّع أنماط الموضوعات على المساحة المتاحة بناءً على ما يبدو معقولًا تكوينيًا وفق توزيعه المتعلَّم، لا وفق ما حدّده الرقم في الأمر النصي.
ما يساعد فعلًا:
- صِف العلاقات المكانية بدلًا من المواضع المطلقة: "الشخص A يقف أمام الشخص B، مع ظهور B خلف كتف A مباشرة"
- استخدم مصطلحات مرتبطة بالإطار: "منتصف الإطار"، و"الركن العلوي الأيمن"، و"الركن السفلي الأيسر"، و"يملأ المقدمة"
- ولّد تنويعات متعددة واختر ما يطابق الترتيب المقصود
- للتكوينات الحساسة للدقة، استخدم التحكم الهيكلي القائم على ControlNet المتاح عبر PicassoIA Image لتحديد المواضع الدقيقة للأجسام باستخدام هيكل مرجعي أو خريطة عمق
التفاصيل الثقافية والإقليمية
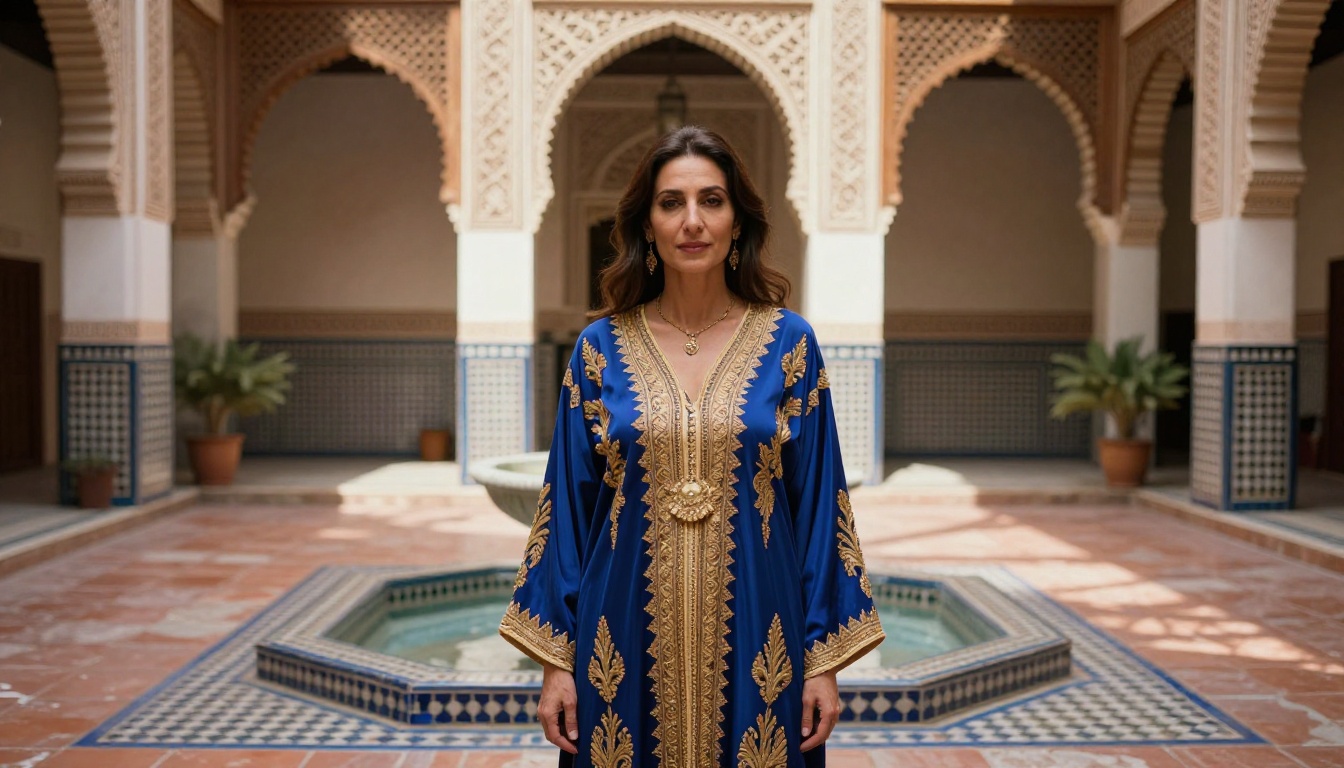
تحمل النماذج المدربة في الغالب على بيانات الإنترنت الغربية هذا الانحياز إلى كل مخرجاتها. اطلب "ملابس تقليدية" وسيميل الناتج نحو الأزياء الشعبية الأوروبية. وتُصوَّر العمارة الإقليمية والأدوات الاحتفالية والكتابات غير الغربية والأطعمة ذات الطابع الثقافي المحدد بتقريبات نمطية، أو بتفاصيل تبدو معقولة بصريًا لكنها لا وجود لها فعلًا في الثقافة المشار إليها.
الانحياز الغربي في بيانات التدريب
تميل معظم مجموعات الصور الضخمة المستخدمة لتدريب نماذج الذكاء الاصطناعي بشدة نحو محتوى الويب الإنجليزي، ومكتبات الصور الجاهزة التي يهيمن عليها أشخاص وأماكن أوروبية وأمريكية، ووسائل التواصل الاجتماعي من أسواق ذات دخل مرتفع ناطقة بالإنجليزية. والنتيجة العملية هي نموذج شاهد أمثلة أقل بكثير للأزياء الاحتفالية في غرب أفريقيا، والعمارة الريفية في شرق آسيا، وأنماط النسيج الأنديزية، ومشاهد الأسواق في أمريكا الوسطى، مما شاهده لشقة استوديو في نيويورك أو مقهى على رصيف في باريس.
النتيجة المرئية: دقة أقل، وتقريبات بصرية عامة، وأحيانًا تفاصيل بصرية غير صحيحة من حيث الوقائع عندما تخرج الأوامر النصية عن المناطق الكثيفة التمثيل في النموذج. قد يبدو الثوب التقليدي صحيحًا إلى حد كبير في الشكل واللون، لكنه يعرض أنماط تطريز تنتمي إلى ثقافة أخرى أو فترة زمنية مختلفة تمامًا.
ما يستطيع الأمر النصي إصلاحه وما لا يستطيعه
الدقة تساعد كثيرًا. فتسمية القطعة بدقة (قفطان، وهانبوك، وقماش كينتي، وهويبيل، وآو داي)، وتحديد المنطقة والفترة، وإضافة تفاصيل بصرية ملموسة (بلاط الزليج، وتطريز النيلة، ونمط النسيج الإيكات، وتقنية صباغة محددة) تنقل النموذج نحو منطقة أدق من المسميات الثقافية العامة. لكن لا يوجد أمر نصي يعوّض فجوة جوهرية في حجم بيانات التدريب. فالنموذج الذي رأى أمثلة قليلة جدًا لقطعة إقليمية محددة سيقع في الهلوسة ويُنتج تفاصيل بصرية معقولة الشكل لكنها خاطئة ببساطة.
بالنسبة للمشاريع التي تهم فيها الدقة الثقافية، تحقق من مخرجات الذكاء الاصطناعي بمقارنتها بمراجع فوتوغرافية قبل استخدامها في عمل موجّه للجمهور. يُظهر GPT Image 2 تغطية ثقافية أوسع بشكل ملحوظ بفضل بيانات تدريب متنوعة، ويؤدي أداءً أفضل نسبيًا مع الموضوعات غير الغربية مقارنةً بالنماذج المدربة على مجموعات بيانات أكثر تجانسًا.
ما تُجيده أفضل النماذج الحالية فعلًا
القيود المذكورة أعلاه حقيقية، لكنها تتعايش مع قدرات استثنائية فعلًا. نماذج توليد الصور الحالية ليست أدوات متوسطة لها بعض اللحظات الجيدة. إنها أدوات قوية لها نقاط عمياء بنيوية محددة، وهذه النقاط العمياء قابلة للتوقع.
حيث تؤدي النماذج الحالية أداءً استثنائيًا:
| القدرة | مستوى القوة |
|---|
| الإضاءة الجوية والجو العام | استثنائي |
| ملمس البشرة والأقمشة والمعادن الواقعي | استثنائي |
| الطبيعة والمناظر الطبيعية والبيئات المفتوحة | ممتاز |
| تصوير الأشخاص الفردي | ممتاز |
| التصميم الداخلي والعمارة | قوي |
| عزل المنتجات على خلفيات نظيفة | قوي |
| الصور المجردة والمفاهيمية | قوي |
| طباعة النصوص والشعارات | ضعيف |
| الترتيبات المكانية المعقدة | ضعيف |
| ثبات الشخصية عبر الجلسات | ضعيف |
يعتمد سير العمل الإنتاجي الأقوى على هذه النقاط القوية، مع تفادي نقاط الضعف في كل مرحلة.
يغطي PicassoIA Image Editor Pro طبقة التصحيح: التعديل الموضعي لأيدٍ مشوهة، وتوسيع الصورة لتمديد الإطار، واستبدال أجسام محددة في صورة جيدة بخلاف ذلك، واستعادة جودة التفاصيل في المناطق الإشكالية. وعند إقرانه بنموذج Hunyuan Image 2.1 لتوليد الأساس، تحصل على مسودات عالية الدقة بدقة 2K مع تفاصيل ملمس قوية، ثم إصلاحات مستهدفة للمناطق المحددة التي تخرج خاطئة.
سير العمل الذي ينجح فعلًا
محاولة إنتاج صورة مثالية في تمريرة واحدة تنجح أحيانًا وتفشل كثيرًا. نهج أكثر موثوقية يفصل بين التوليد والتحرير كمرحلتين منفصلتين:
- ولّد صورة أساس قوية بالنموذج الذي تختاره
- حدد المناطق الإشكالية: الأيدي، والنصوص، والأخطاء المكانية، وانجراف الشخصية
- استخدم التعديل الموضعي لعزل كل منطقة مشكلة وإصلاحها بشكل مستقل بأمر نصي مستهدف
- طبّق رفع الدقة الفائق إذا كان مخرجك النهائي يتطلب أبعاد طباعة أكبر
- ركّب أي علامات تجارية أو نصوص دقيقة أو شعارات محددة في برنامج تصميم خارجي بعد ذلك
هذا يتوافق مع طريقة عمل التقنية فعليًا، بدلًا من مقاومة خصائصها البنيوية.
ابدأ الإبداع مع وضع الحدود الحقيقية في الاعتبار
معرفة ما لا يستطيع نموذج توليد الصور فعله بعد ليست سببًا لاستخدامه بقدر أقل. إنها سبب لاستخدامه بسرعة أكبر وإحباط أقل بكثير. تُغلق الفجوة بين "ما وصفه الأمر النصي" و"ما قدّمه النموذج" بسرعة عندما تعرف أين تتوقع الانجراف، وأي الأدوات تلجأ إليها في كل مرحلة.
يجمع PicassoIA أكثر من 90 نموذجًا لتحويل النص إلى صورة إلى جانب أدوات التحرير ورفع الدقة الفائق وإمكانات تبديل الوجوه وتوليد الفيديو في منصة واحدة. سواء كنت تصحح التشريح باستخدام PicassoIA Image Editor Pro، أو تضع نصوصًا مقروءة باستخدام Riverflow 2.0 Pro، أو تحافظ على ثبات الشخصية باستخدام Flux Redux Dev، أو تولّد بورتريهات بدقة 4K باستخدام Seedream 4.5، فالأداة المناسبة لكل قيد محدد متاحة بالفعل.
نماذج توليد الصور بالذكاء الاصطناعي ليست بعد في مرحلة المخرجات المثالية والمضبوطة بالكامل لكل أمر نصي. لكنها قادرة بما يكفي الآن، بحيث يجعل إدراك سقفها كل سير عمل إبداعي أسرع، لا أبطأ.
اختر أمرًا نصيًا، واختر نموذجًا، وابدأ التوليد. الحلول البديلة أسهل مما تبدو.