Todo usuário de IA para imagens acaba chegando a um momento assim. Você escreve um prompt cuidadoso e detalhado, clica em gerar e algo sai levemente errado. As mãos têm seis dedos. Uma placa no fundo mostra letras sem sentido. O personagem que você construiu ao longo de três prompts precisos parece uma pessoa completamente diferente na imagem seguinte. Não são falhas aleatórias. São pontos cegos estruturais, embutidos no funcionamento atual dos modelos de imagem por IA, e reconhecer cada um deles é o que separa créditos desperdiçados de uma produção criativa eficiente e intencional.
A seguir, uma visão direta do que um modelo de imagem por IA ainda não consegue fazer, por que cada limitação existe em nível técnico e quais ferramentas reais ajudam a fechar cada lacuna.
O problema do texto é pior do que você imagina
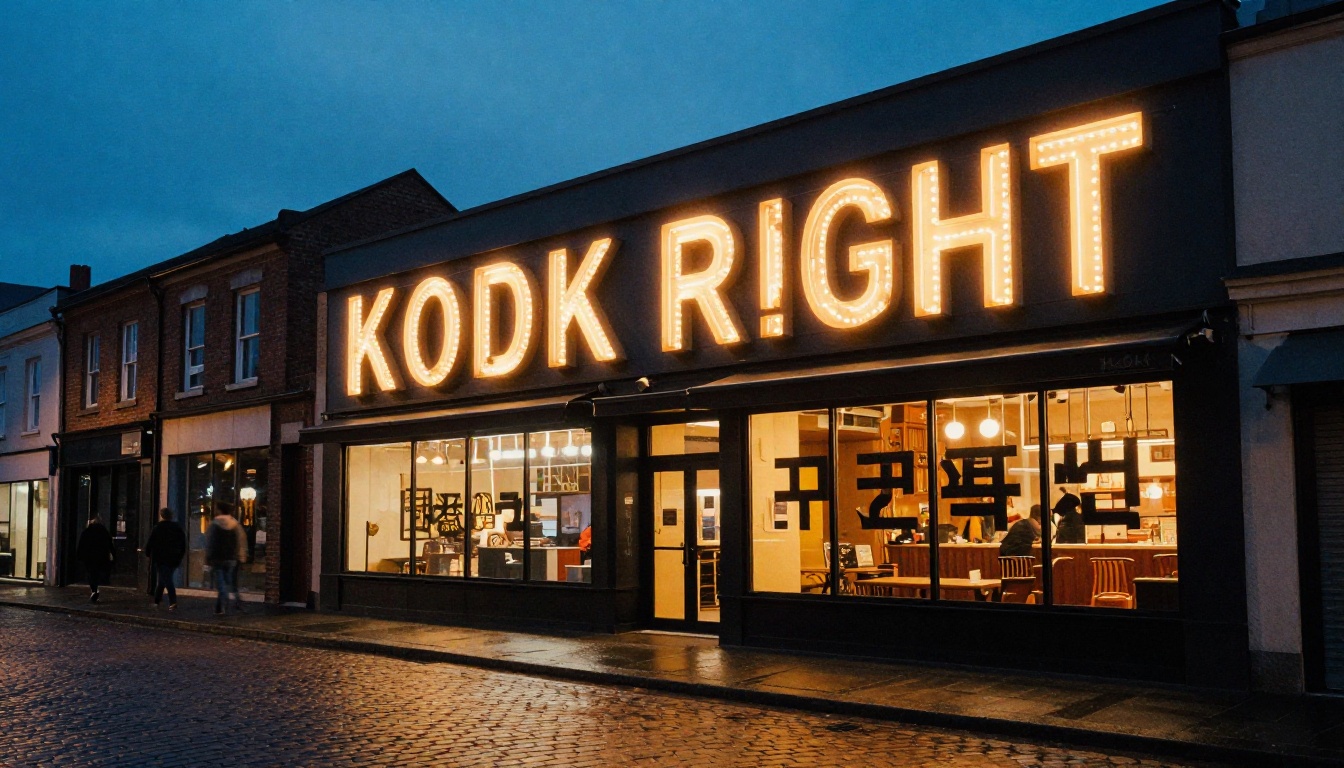
Modelos de imagem por IA não "escrevem" texto. Eles não têm o conceito de letras como símbolos discretos que carregam significado. Em vez disso, aprendem que certos padrões de pixels aparecem perto de certas palavras de legenda nos dados de treinamento, e reproduzem essas texturas visuais. O resultado parece convincentemente texto, até você ler com atenção, momento em que se desfaz em formas sem sentido e traços sobrepostos.
Por que as letras se desfazem
Quando você pede a um modelo de difusão padrão que mostre um texto legível em uma placa, na capa de um livro ou em um rótulo impresso, o modelo recorre a associações estatísticas entre palavras da legenda e padrões de pixels. Palavras curtas e comuns às vezes sobrevivem intactas. Qualquer coisa mais longa, ou qualquer texto que exija espaçamento preciso entre letras e geometria consistente, degrada rapidamente. O modelo não tem dicionário interno, nem conceito de formas de letras como unidades simbólicas, nem mecanismo para verificar se o que renderizou é de fato legível.
É por isso que imagens geradas por IA de restaurantes, fachadas de lojas, rótulos de produtos, cardápios, livros e jornais quase sempre trazem texto embaralhado. O modelo não está cometendo um erro segundo os próprios critérios. Ele está reproduzindo a aparência visual de texto sem codificar nenhum significado linguístico.
O problema se agrava com escritas não latinas. Modelos treinados principalmente com dados em inglês têm desempenho especialmente ruim com caracteres árabes, chineses, coreanos, tailandeses ou cirílicos, produzindo texturas que lembram visualmente a família da escrita, mas são totalmente ilegíveis para quem fala o idioma.
O Riverflow 2.0 Pro é a exceção
Nem todos os modelos compartilham essa limitação na mesma medida. O Riverflow 2.0 Pro foi projetado especificamente com controle tipográfico em mente, permitindo incorporar fontes e definir a posição do texto legível com precisão muito maior do que os modelos de difusão padrão. O Riverflow 2.0 Fast oferece a mesma capacidade tipográfica em um fluxo de trabalho mais rápido, para projetos com prazo apertado. Se texto preciso é um requisito obrigatório para o seu resultado, esses modelos são a solução direta, não um contorno.
💡 Dica: Mantenha curto qualquer texto no seu prompt. Coloque a palavra exata entre aspas (por exemplo, "SALE") e use um modelo que entenda tipografia. Modelos de difusão padrão falham de forma consistente com strings mais longas que duas ou três palavras comuns.
As mãos continuam sendo um pesadelo recorrente
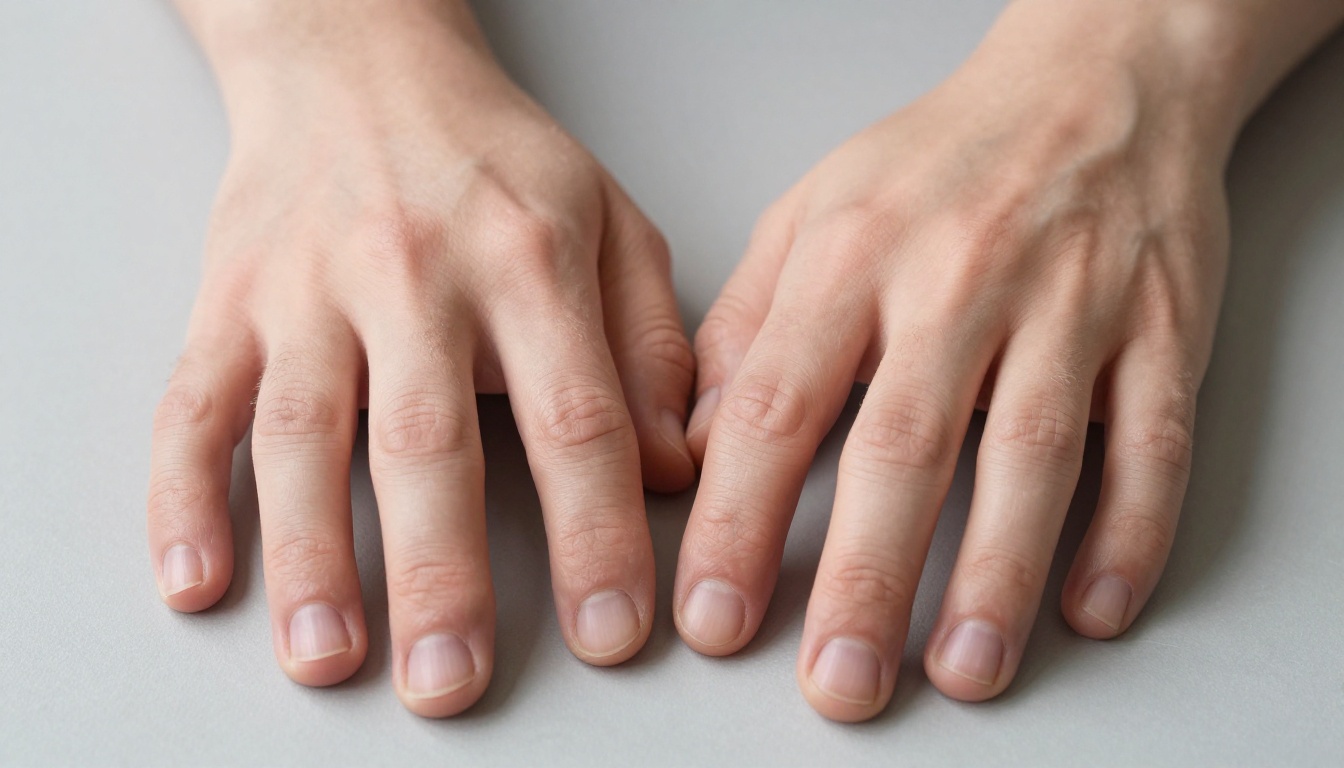
As mãos são a falha mais citada na geração de imagens por IA, e o problema é profundo. Mãos humanas são estruturalmente complexas: 27 ossos, configurações de pose variáveis e uma enorme variabilidade de iluminação, ângulo e oclusão parcial. Os conjuntos de dados de treinamento contêm mãos em milhões de configurações, mas os modelos têm falhado de forma consistente em generalizar uma estrutura anatômica confiável a partir de toda essa variação.
Por que o modelo conta errado
Modelos de difusão não contam. Não há aritmética acontecendo quando um modelo renderiza uma mão. O número de dedos que aparece na saída é uma probabilidade estatística baseada em quais padrões de pixels se encaixam na composição ao redor, e não uma decisão deliberada. Quando as mãos estão parcialmente ocultas, em poses incomuns ou perto de outros objetos complexos, o modelo distribui padrões em forma de dedos pelo espaço disponível, sem nenhuma restrição anatômica. Seis dedos são comuns. Juntas fundidas, palmas que parecem não ter ossos e mãos sem uma conexão clara com o punho acontecem com regularidade.
Arquiteturas mais novas, treinadas com dados de alta resolução e cuidadosamente selecionados, reduziram bastante esse problema. Mas mesmo os modelos atuais mais fortes produzem falhas nas mãos sob certas condições de composição, especialmente quando as mãos interagem com objetos pequenos, seguram coisas ou estão posicionadas em ângulos incomuns.
Corrigindo mãos com inpainting
Pedir com mais insistência raramente resolve o problema. O contorno mais confiável é o inpainting: gere a imagem completa primeiro, depois aplique uma máscara e regenere especificamente a região da mão com um prompt anatômico focado. O PicassoIA Image Editor Pro torna esse fluxo direto, permitindo desenhar uma máscara ao redor da área problemática e gerá-la novamente enquanto o restante da imagem permanece intacto. O Qwen Image Edit Plus oferece precisão semelhante de inpainting, com forte preservação de detalhes na borda da máscara.
💡 Dica: Adicione "cinco dedos, anatomia humana correta, separação natural dos dedos, sem dígitos extras" a qualquer prompt que mostre mãos em primeiro plano. Isso não elimina o problema, mas reduz de forma mensurável a taxa de falhas.
Mesmo personagem, rosto diferente
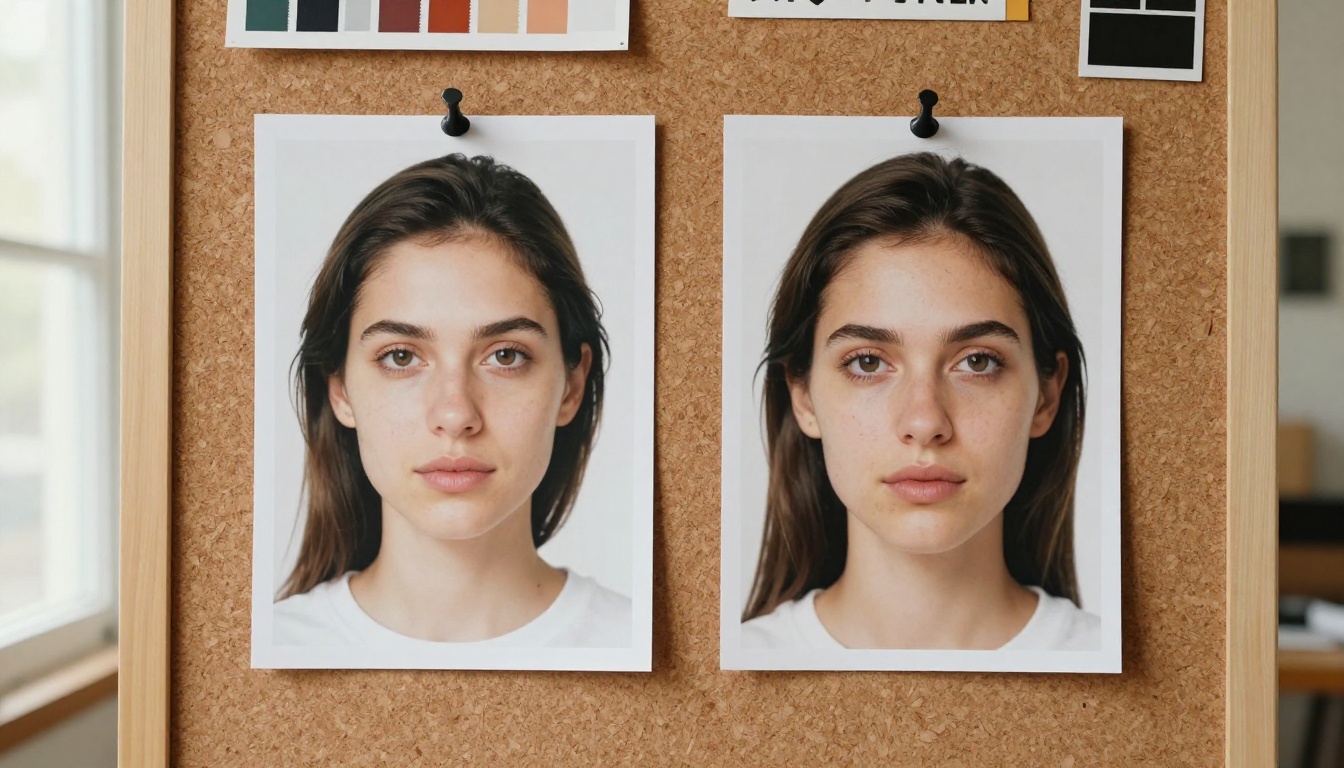
Gerar o mesmo personagem reconhecível em várias imagens está entre as capacidades mais pedidas na geração de imagens por IA e uma das mais difíceis de alcançar com modelos padrão de texto para imagem. Peça a mesma descrição física duas vezes e você terá duas pessoas diferentes. Mude um único adjetivo e o rosto muda de novo. Não se trata de uma questão de habilidade de prompt. É uma propriedade estrutural de como os modelos de difusão geram cada imagem de forma independente, do zero.
O problema da deriva de identidade
Cada imagem que um modelo de difusão produz começa de um ruído aleatório. Não existe memória de personagem entre as gerações. Mesmo com descritores físicos muito específicos (cor exata dos olhos, formato distintivo da mandíbula, textura de cabelo específica, uma cicatriz única), o modelo amostra de uma distribuição de probabilidade e produz uma variação dentro desse intervalo, em vez de reproduzir um indivíduo fixo. Quanto mais gerações você faz, mais o rosto se afasta da intenção original.
Isso cria problemas concretos para campanhas de produtos, narrativas visuais, personagens de marca e qualquer fluxo de trabalho que exija um sujeito recorrente reconhecível. Uma série de imagens de "a mesma mulher" produzida apenas com prompts de texto vai parecer um teste de elenco, não um personagem consistente em cenas diferentes.
Flux Redux Dev para variações estáveis
O Flux Redux Dev aborda esse problema de outra forma. Ele usa uma imagem existente como referência e gera variações visuais coerentes que preservam a identidade central, a composição e o estilo do sujeito. Esse é o caminho mais acessível para geração consistente de personagens sem treinar um LoRA personalizado do zero. Para campanhas que exigem um rosto reconhecível em várias cenas, usar o Redux Dev com um único retrato de referência forte reduz de forma significativa a deriva de identidade entre as gerações.
💡 Dica: Gere primeiro um retrato ideal do personagem com o seu modelo de maior qualidade. Depois use o Flux Redux Dev para todas as variações de cena a partir dessa imagem âncora, em vez de reescrever o prompt a partir de uma descrição em texto a cada vez.
Logotipos e marcas do mundo real
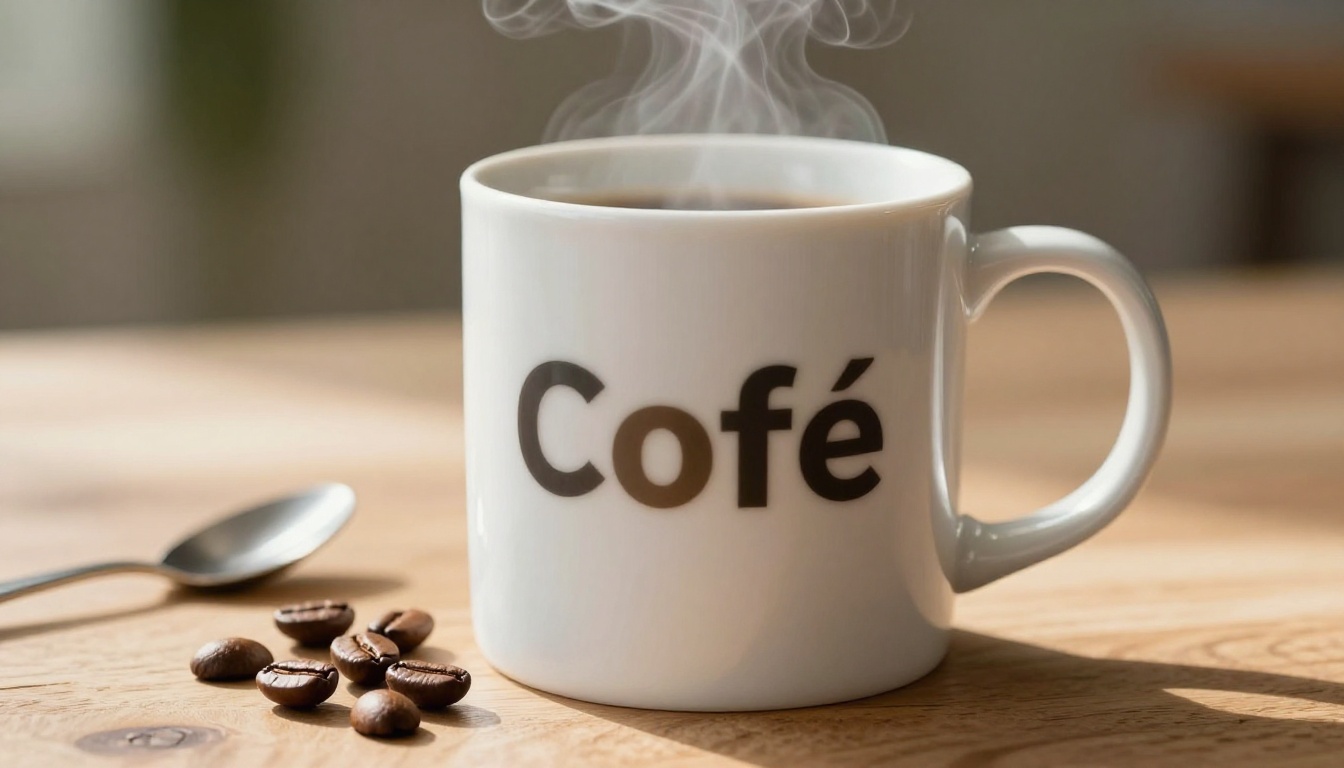
Modelos de imagem por IA não conseguem reproduzir com precisão logotipos registrados como marcas ou marcas específicas de empresas reais. Isso reflete tanto uma restrição legal incorporada aos procedimentos de treinamento quanto uma restrição técnica: logotipos dependem de proporções geométricas exatas, valores de cor específicos e espaçamento preciso entre letras, que a amostragem por difusão não consegue reconstruir fielmente.
O que acontece com as marcas registradas
Quando você pede um produto com o logotipo de uma marca real, o modelo produz uma aproximação estética. A forma e a cor parecem corretas à primeira vista. As formas das letras são reconhecíveis, quase certas. Mas os caracteres se fundem, as proporções se desviam e a precisão geométrica exigida para a fidelidade da marca não existe. Os modelos foram treinados com milhões de imagens contendo marcas reais, mas foram orientados durante o treinamento a evitar a reprodução exata, tanto por razões de direitos autorais quanto porque a fidelidade geométrica pixel a pixel não é aquilo que a amostragem por difusão otimiza.
O contorno para foto de produto
A solução mais limpa é separar completamente a etapa de geração da etapa de identidade visual.
| Cenário | Melhor abordagem |
|---|
| Mockup de produto com marca | Gere o formato do produto e a iluminação, adicione o logotipo em software de design |
| Foto de estilo de vida com item de marca | Use uma versão genérica do produto no prompt |
| Embalagem com texto no rótulo | Gere a forma e o material, diagrame o rótulo separadamente |
| Imagem de campanha com produto real | Use IA para o ambiente e o clima, sobreponha a foto do produto real |
O Seedream 4.5 se destaca na geração de superfícies de produto limpas em 4K, com texturas de material precisas e iluminação controlada. Use-o para estabelecer o ambiente visual e depois adicione a marca correta no Photoshop, no Figma ou em qualquer compositor. O resultado parece idêntico a uma imagem totalmente gerada por IA, mas com tipografia de marca fiel.
A lógica espacial está quebrada
Coloque uma bola vermelha à esquerda de um cubo azul. Mostre duas pessoas com uma terceira em pé entre elas. Posicione um objeto em primeiro plano enquanto outro fica diretamente atrás dele em um ângulo específico. Os modelos de difusão padrão falham em todos esses casos com uma regularidade frustrante. Os erros de raciocínio espacial são sistemáticos, não ocasionais.
Confusão entre esquerda e direita
Modelos de difusão funcionam por meio de remoção de ruído em nível de pixel, não por raciocínio espacial. "Esquerda" e "direita" são conceitos relacionais abstratos que os modelos só mapeiam parcialmente para estatísticas de composição absorvidas dos dados de treinamento. A associação estatística é real, mas fraca. Na prática, as posições esquerda-direita são trocadas ou ambíguas cerca de metade das vezes.
Linguagem relativa à câmera tende a funcionar melhor do que termos direcionais. "Objeto em primeiro plano", "elemento de fundo", "perto da câmera", "longe do espectador" e "canto superior direito do quadro" se conectam de forma mais confiável aos padrões de composição que o modelo internalizou. Palavras-chave de posição ancoradas no quadro superam direções relacionais ancoradas em sujeitos dentro da imagem.
Contagem e posicionamento
A contagem também é pouco confiável. "Três cachorros" muitas vezes resulta em dois ou quatro. "Cinco pessoas em um grupo" raramente produz exatamente cinco. "Uma única árvore do lado direito" às vezes vira duas árvores ou nenhuma. O modelo não tem uma etapa de verificação aritmética, então distribui padrões de sujeitos pelo espaço disponível com base no que parece compositivamente plausível para sua distribuição aprendida, e não no que o número do prompt especificava.
O que realmente ajuda:
- Descreva relações espaciais em vez de posições absolutas: "Pessoa A fica na frente da Pessoa B, com B visível logo atrás do ombro de A"
- Use termos ancorados no quadro: "centro do quadro", "superior direito", "canto inferior esquerdo", "ocupando o primeiro plano"
- Gere várias variações e selecione a que corresponde ao arranjo pretendido
- Para composições em que a precisão é crítica, use o controle estrutural baseado em ControlNet disponível no PicassoIA Image para definir posições exatas dos objetos com um esqueleto de referência ou um mapa de profundidade
Detalhes culturais e regionais
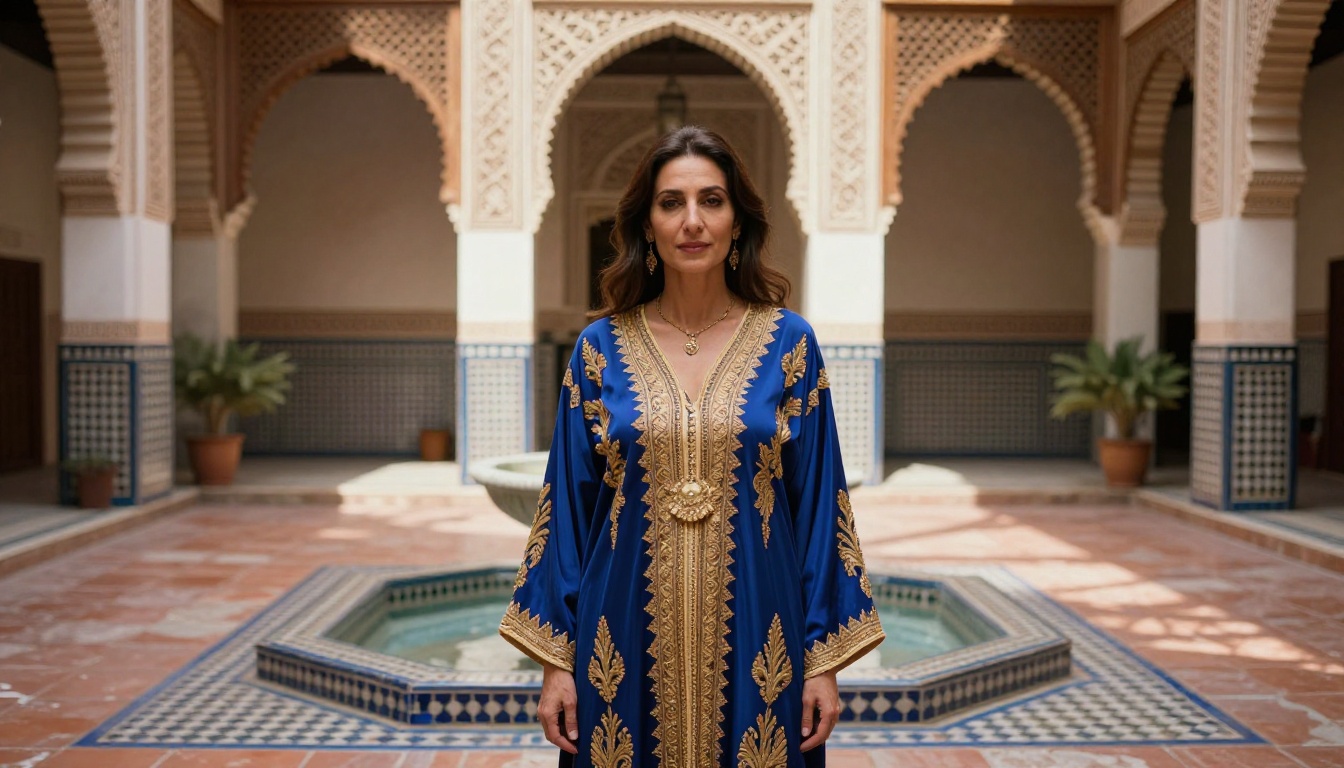
Modelos treinados predominantemente com dados da internet ocidental levam esse viés para cada geração. Peça "roupas tradicionais" e a saída tende para trajes folclóricos europeus. Arquitetura regional, objetos cerimoniais, escritas não ocidentais e alimentos de cultura específica são renderizados com aproximações estereotipadas ou, em alguns casos, com detalhes visualmente plausíveis que não existem de fato na cultura referida.
O viés ocidental nos dados de treinamento
A maioria dos grandes conjuntos de imagens usados para treinar modelos de IA tende fortemente para conteúdo da web em inglês, bibliotecas de fotos de estoque dominadas por sujeitos e cenários euro-americanos e redes sociais de mercados de alta renda de língua inglesa. A consequência prática é um modelo que encontrou muito menos exemplos de trajes cerimoniais da África Ocidental, arquitetura rural do Leste Asiático, padrões de tecelagem andinos ou cenas de mercado da América Central do que de imagens de um apartamento de estúdio em Nova York ou de um café de rua em Paris.
O resultado visível: precisão reduzida, aproximações visuais genéricas e, às vezes, detalhes visuais factualmente incorretos quando os prompts saem das zonas densamente representadas do modelo. Uma peça de roupa tradicional pode parecer amplamente correta em silhueta e cor, mas exibir padrões de bordado que pertencem a outra cultura ou a outro período.
O que os prompts podem e não podem corrigir
A especificidade ajuda muito. Nomear a peça exata de roupa (caftã, hanbok, tecido kente, huipil, ao dai), especificar a região e a época e incluir detalhes visuais concretos (azulejo zellige, bordado em índigo, padrão de tecelagem ikat, técnica de tingimento específica) leva o modelo a um território mais preciso do que rótulos culturais genéricos. Mas nenhum prompt consegue compensar uma lacuna fundamental no volume dos dados de treinamento. Um modelo que viu poucos exemplos de um artefato regional específico vai alucinar detalhes visuais plausíveis que simplesmente estão errados.
Para projetos em que a precisão cultural importa, valide o resultado da IA com referências fotográficas antes de usá-lo em trabalhos voltados ao público. O GPT Image 2 demonstra uma cobertura cultural notavelmente mais ampla, graças a dados de treinamento diversos, e tem desempenho comparativamente melhor em temas não ocidentais do que modelos treinados com conjuntos de dados mais homogêneos.
O que os melhores modelos atuais realmente fazem bem
As limitações acima são reais, mas convivem com capacidades genuinamente excepcionais. Os modelos atuais de imagem por IA não são ferramentas medíocres com alguns bons momentos. São ferramentas poderosas com pontos cegos estruturais específicos, e esses pontos cegos são previsíveis.
Onde os modelos atuais têm desempenho excepcional:
| Capacidade | Nível de força |
|---|
| Iluminação atmosférica e clima | Excepcional |
| Pele, tecido e texturas de metal fotorrealistas | Excepcional |
| Natureza, paisagem e ambientes abertos | Excelente |
| Fotografia de retrato com um único sujeito | Excelente |
| Design de interiores e arquitetura | Forte |
| Isolamento de produto em fundos limpos | Forte |
| Imagens abstratas e conceituais | Forte |
| Reprodução de tipografia e logotipos | Fraco |
| Arranjos espaciais complexos | Fraco |
| Consistência de personagem entre sessões | Fraco |
O fluxo de produção mais forte aproveita essas forças e contorna as fraquezas em cada etapa.
O PicassoIA Image Editor Pro cobre a camada de correção: inpainting de mãos com falhas, outpainting de composições para ampliar o quadro, substituição de objetos específicos em uma imagem que está boa no geral e restauração da qualidade de detalhes em áreas problemáticas. Combiná-lo com o Hunyuan Image 2.1 para a geração base oferece rascunhos em 2K de alta resolução com forte detalhe de textura, seguidos de correções pontuais nas regiões que saírem erradas.
O fluxo de trabalho que realmente funciona
Tentar criar uma imagem perfeita em uma única passada funciona de vez em quando e falha com frequência. Uma abordagem mais confiável trata a geração e a edição como duas fases separadas:
- Gere uma imagem base forte com o modelo escolhido
- Identifique áreas problemáticas específicas: mãos, texto, erros espaciais, deriva de personagem
- Use inpainting para isolar e corrigir cada região problemática de forma independente, com um prompt direcionado
- Aplique upscaling (aumento de resolução) por super-resolução se a saída final exigir dimensões maiores para impressão
- Depois, componha quaisquer marcas, textos precisos ou logotipos específicos em um software de design externo
Isso acompanha a forma como a tecnologia realmente funciona, em vez de lutar contra suas propriedades estruturais.
Saber o que um modelo de imagem por IA ainda não consegue fazer não é motivo para usá-lo menos. É motivo para usá-lo mais rápido e com bem menos frustração. A distância entre "o que o prompt descreveu" e "o que o modelo entregou" diminui rapidamente quando você sabe onde esperar a deriva e quais ferramentas usar em cada etapa.
O PicassoIA reúne mais de 90 modelos de texto para imagem junto com ferramentas de edição, upscaling, recursos de troca de rosto e geração de vídeo em uma única plataforma. Seja para corrigir anatomia com o PicassoIA Image Editor Pro, posicionar tipografia legível com o Riverflow 2.0 Pro, manter a consistência de personagem com o Flux Redux Dev ou gerar retratos em 4K com o Seedream 4.5, a ferramenta certa para cada limitação específica já está disponível.
Os modelos de imagem por IA ainda não chegaram lá para saídas impecáveis e perfeitamente controladas em todo prompt. Mas já são capazes o bastante agora para que reconhecer o seu teto torne cada fluxo de trabalho criativo mais rápido, e não mais lento.
Escolha um prompt, escolha um modelo e comece a gerar. Os contornos são mais fáceis do que parecem.