हर AI इमेज यूज़र आख़िरकार एक ऐसे पल तक पहुँचता है। आप एक सावधानी से लिखा विस्तृत प्रॉम्प्ट डालते हैं, जनरेट दबाते हैं, और कुछ थोड़ा गलत निकलता है। हाथों में छह उंगलियाँ होती हैं। बैकग्राउंड का एक बोर्ड अर्थहीन अक्षर दिखाता है। जिस कैरेक्टर को आपने तीन सटीक प्रॉम्प्ट में गढ़ा था, वह अगली इमेज में बिल्कुल अलग इंसान लगता है। ये यादृच्छिक गड़बड़ियाँ नहीं हैं। ये मौजूदा AI इमेज मॉडल के काम करने के तरीके में बनी संरचनात्मक अंधी जगहें हैं, और हर एक को पहचानना ही बर्बाद क्रेडिट और कुशल, सोच-समझकर किए गए रचनात्मक आउटपुट के बीच का फर्क है।
यह लेख बताता है कि AI इमेज मॉडल अभी क्या नहीं कर सकता, हर कमी तकनीकी स्तर पर क्यों मौजूद है, और कौन-से असली टूल हर अंतर को भरने में मदद करते हैं।
टेक्स्ट की समस्या जितनी आप सोचते हैं, उससे ज़्यादा गंभीर है
AI इमेज मॉडल टेक्स्ट "लिखते" नहीं हैं। उनके पास अक्षरों की वह अवधारणा नहीं है जो अलग-अलग प्रतीक हों और अर्थ रखें। इसके बजाय वे ट्रेनिंग डेटा में सीखते हैं कि कुछ पिक्सल पैटर्न कुछ कैप्शन शब्दों के आसपास दिखते हैं, और फिर वे उन्हीं विज़ुअल बनावटों को दोबारा बनाते हैं। नतीजा देखने में टेक्स्ट जैसा लगता है, जब तक आप उसे ध्यान से नहीं पढ़ते। तब वह बेमतलब आकृतियों और आपस में उलझी रेखाओं में बिखर जाता है।
अक्षर क्यों बिगड़ते हैं
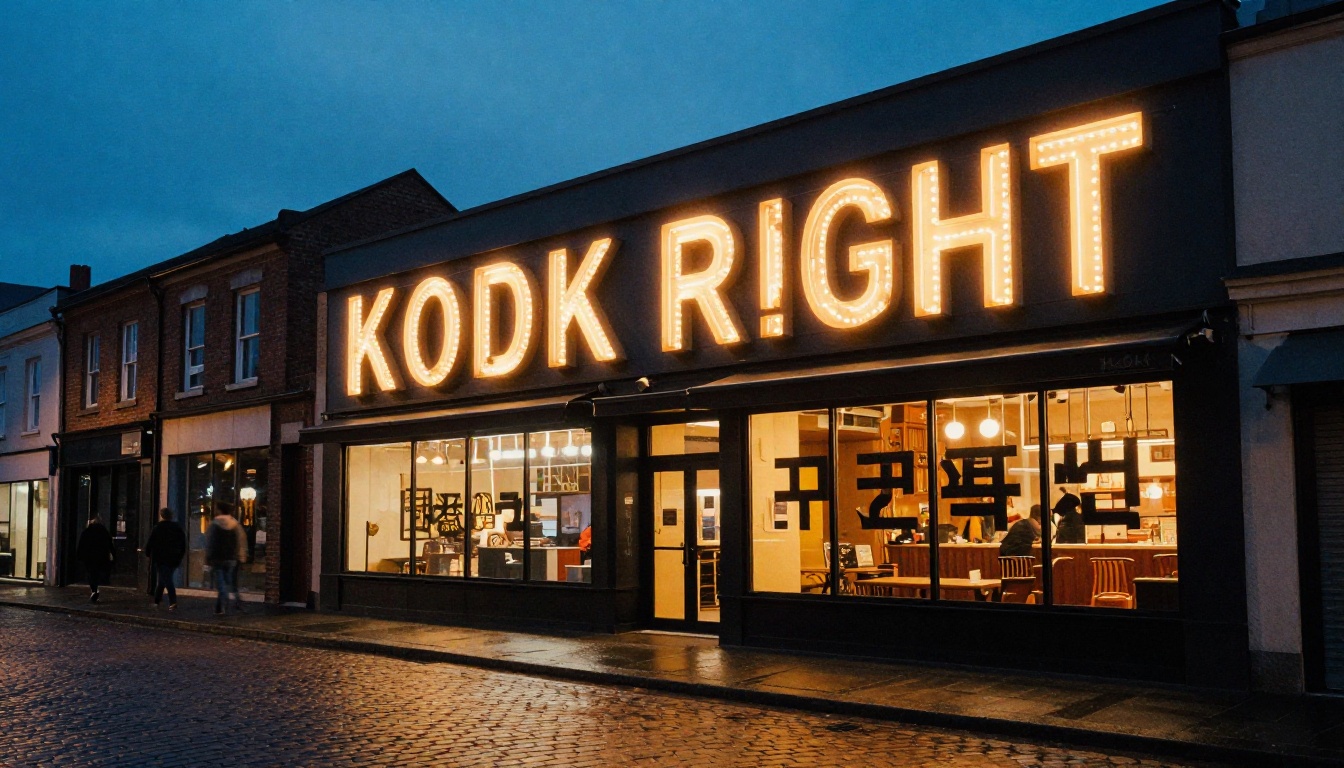
जब आप किसी स्टैंडर्ड डिफ़्यूज़न मॉडल से साइनबोर्ड, किताब के कवर या छपे लेबल पर पढ़ने लायक टेक्स्ट माँगते हैं, तो मॉडल कैप्शन शब्दों और पिक्सल पैटर्न के बीच के सांख्यिकीय संबंधों से काम लेता है। छोटे, आम शब्द कभी-कभी सही बच जाते हैं। लेकिन लंबे शब्द, या ऐसा टेक्स्ट जिसमें अक्षरों के बीच सटीक दूरी और एक-सी ज्यामिति चाहिए, तेज़ी से बिगड़ते हैं। मॉडल के पास कोई आंतरिक शब्दकोश नहीं है, अक्षर-रूपों को प्रतीकात्मक इकाइयों के रूप में समझने की क्षमता नहीं है, और यह जाँचने का कोई तरीका नहीं है कि जो उसने बनाया वह सच में पढ़ा जा सकता है या नहीं।
इसीलिए रेस्टोरेंट, दुकानों के सामने, प्रोडक्ट लेबल, मेन्यू, किताबों और अख़बारों की AI इमेज में लगभग हमेशा गड़बड़ टेक्स्ट होता है। मॉडल अपने ही पैमाने पर कोई गलती नहीं करता। वह टेक्स्ट के विज़ुअल रूप का पैटर्न मिलाता है, बिना किसी भाषाई अर्थ को एन्कोड किए।
गैर-लैटिन लिपियों के साथ यह समस्या और बढ़ जाती है। ज़्यादातर अंग्रेज़ी डेटा पर ट्रेन हुए मॉडल अरबी, चीनी, कोरियाई, थाई या सिरिलिक अक्षरों पर खास तौर पर कमज़ोर प्रदर्शन करते हैं। वे ऐसी बनावटें बनाते हैं जो लिपि-परिवार की याद दिलाती हैं, लेकिन जो भाषा बोलने वाला कोई व्यक्ति पढ़े तो उसे पूरी तरह अपाठ्य लगती हैं।
Riverflow 2.0 Pro अपवाद है
हर मॉडल इस सीमा से बराबर नहीं जूझता। Riverflow 2.0 Pro खास तौर पर टाइपोग्राफ़ी नियंत्रण को ध्यान में रखकर बनाया गया था, जिससे आप फ़ॉन्ट एम्बेड कर सकते हैं और पढ़ने लायक टेक्स्ट की जगह स्टैंडर्ड डिफ़्यूज़न मॉडल से कहीं ज़्यादा सटीकता से तय कर सकते हैं। Riverflow 2.0 Fast समय-संवेदी प्रोजेक्ट के लिए तेज़ वर्कफ़्लो में वही टाइपोग्राफ़ी क्षमता देता है। अगर आउटपुट में सटीक टेक्स्ट एक अनिवार्य ज़रूरत है, तो ये मॉडल कोई वर्कअराउंड नहीं, सीधा समाधान हैं।
💡 Tip: अपने प्रॉम्प्ट में टेक्स्ट छोटा रखें। सटीक शब्द को उद्धरण चिह्नों में लपेटें (जैसे "SALE") और टाइपोग्राफ़ी-समझ वाला मॉडल इस्तेमाल करें। स्टैंडर्ड डिफ़्यूज़न मॉडल दो-तीन आम शब्दों से लंबी स्ट्रिंग पर भरोसेमंद रूप से असफल होते हैं।
हाथ अब भी एक बार-बार होने वाला दुःस्वप्न हैं
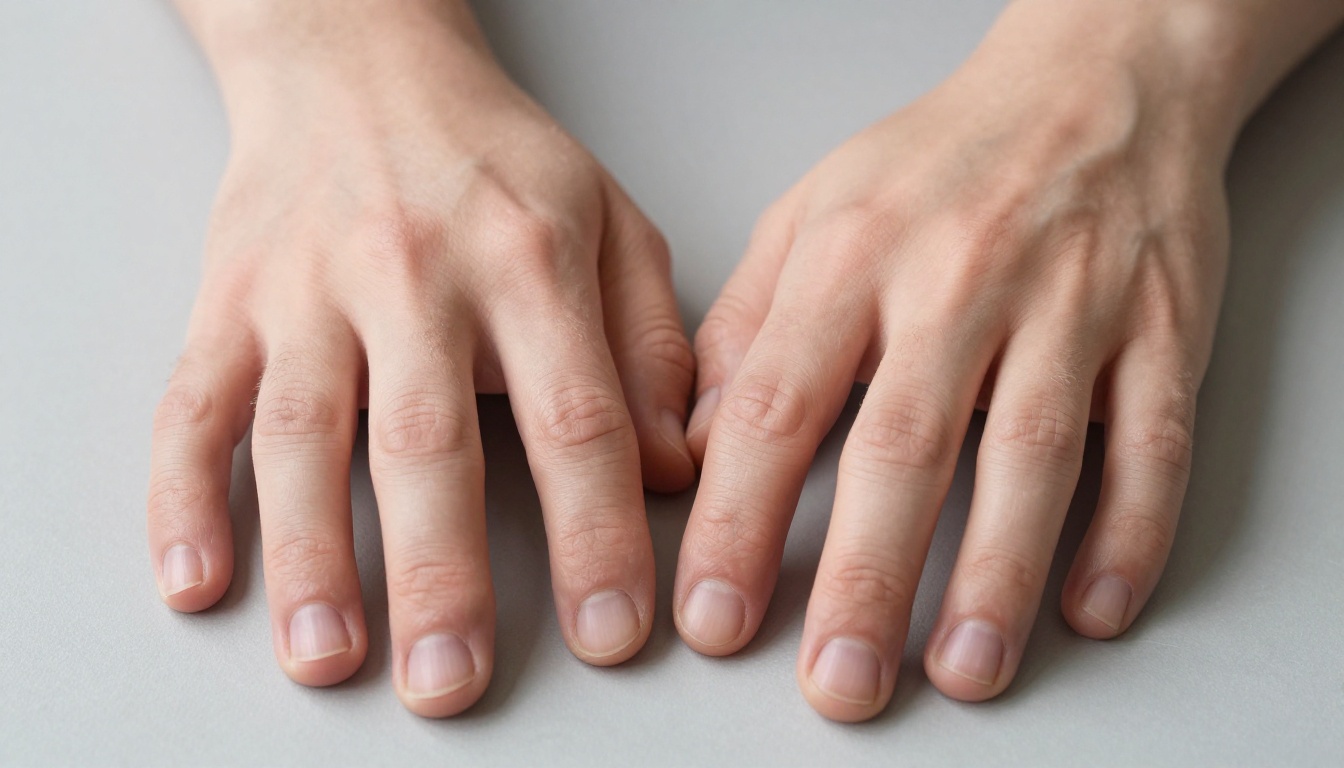
AI इमेज जनरेशन में हाथों की गड़बड़ी सबसे ज़्यादा बताई जाने वाली विफलता है, और समस्या गहरी है। इंसानी हाथ संरचना में जटिल होते हैं: 27 हड्डियाँ, पोज़ के बदलते रूप, और रोशनी, कोण और आंशिक ओक्लूज़न में भारी विविधता। ट्रेनिंग डेटासेट में हाथ लाखों रूपों में मौजूद हैं, फिर भी मॉडल उस पूरी विविधता से एक भरोसेमंद शारीरिक ढाँचा सामान्यीकृत करने में लगातार असफल रहे हैं।
मॉडल गिनती गलत क्यों करता है
डिफ़्यूज़न मॉडल गिनते नहीं हैं। जब मॉडल हाथ रेंडर करता है, तब कोई अंकगणित नहीं होता। आउटपुट में जितनी उंगलियाँ दिखती हैं, वह एक सांख्यिकीय संभावना है जो आसपास की कंपोज़िशन में फिट बैठने वाले पिक्सल पैटर्न पर आधारित है, कोई सोचा-समझा निर्णय नहीं। जब हाथ आंशिक रूप से ढके हों, असामान्य पोज़ में हों, या दूसरी जटिल चीज़ों के पास हों, तो मॉडल उंगली-जैसे पैटर्न बिना शारीरिक बंधन के उपलब्ध जगह में फैला देता है। छह उंगलियाँ आम हैं। आपस में मिले जोड़, बिना हड्डी वाली लगती हथेलियाँ, और कलाई से साफ़ न जुड़े हाथ भी नियमित रूप से होते हैं।
उच्च-रिज़ॉल्यूशन और सावधानी से क्यूरेट किए गए डेटासेट पर ट्रेन हुए नए आर्किटेक्चर ने इस समस्या को काफ़ी कम किया है। लेकिन सबसे मज़बूत मौजूदा मॉडल भी कुछ कंपोज़िशनल स्थितियों में हाथ की गड़बड़ी पैदा करते हैं, खासकर जब हाथ छोटी चीज़ों के साथ इंटरैक्ट कर रहे हों, कुछ पकड़ रहे हों, या असामान्य कोणों पर हों।
इनपेंटिंग से हाथ ठीक करना
प्रॉम्प्ट में और ज़ोर डालने से शायद ही समस्या हल होती है। सबसे भरोसेमंद वर्कअराउंड इनपेंटिंग है: पहले पूरी इमेज जनरेट करें, फिर हाथ वाले हिस्से पर मास्क लगाकर उसे एक केंद्रित शारीरिक प्रॉम्प्ट के साथ अलग से दोबारा बनाएँ। PicassoIA Image Editor Pro इस वर्कफ़्लो को सीधा बनाता है। आप समस्या वाले हिस्से के चारों ओर मास्क बना सकते हैं और उसे दोबारा जनरेट कर सकते हैं, जबकि बाकी इमेज बरकरार रहती है। Qwen Image Edit Plus मास्क की सीमा पर मज़बूत डिटेल संरक्षण के साथ समान इनपेंटिंग सटीकता देता है।
💡 Tip: जिस भी प्रॉम्प्ट में अग्रभूमि में हाथ हों, उसमें "five fingers, correct human anatomy, natural finger separation, no extra digits" जोड़ें। इससे समस्या खत्म नहीं होती, लेकिन विफलता की दर साफ़ तौर पर कम होती है।
वही कैरेक्टर, अलग चेहरा
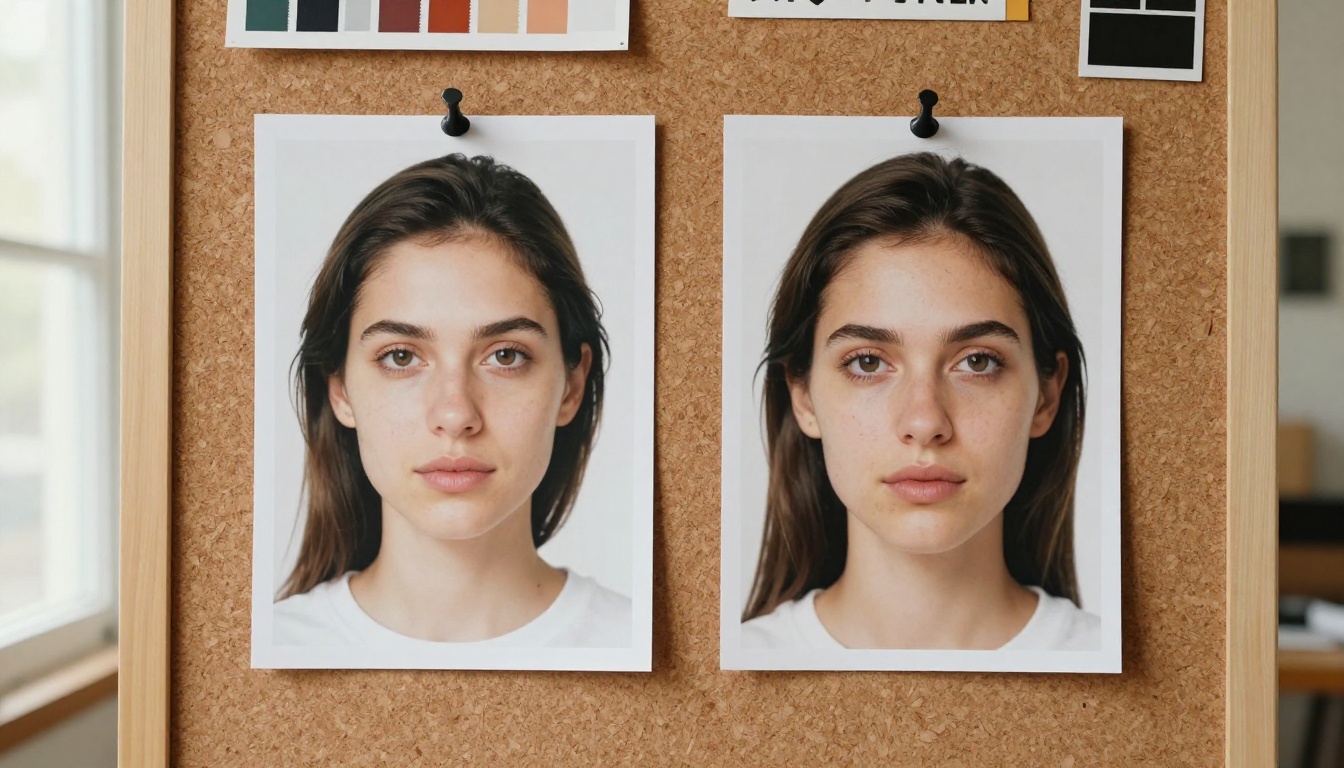
कई इमेज में एक ही पहचाना जाने वाला कैरेक्टर बनाना AI इमेज जनरेशन की सबसे ज़्यादा माँगी जाने वाली क्षमताओं में से एक है, और स्टैंडर्ड टेक्स्ट-टू-इमेज मॉडल के साथ इसे हासिल करना सबसे कठिन चीज़ों में से एक है। एक ही शारीरिक विवरण दो बार डालें तो दो अलग इंसान मिलते हैं। एक विशेषण बदलें तो चेहरा फिर बदल जाता है। यह प्रॉम्प्टिंग कौशल की समस्या नहीं है। यह इस बात की संरचनात्मक विशेषता है कि डिफ़्यूज़न मॉडल हर इमेज को शुरू से, स्वतंत्र रूप से जनरेट करते हैं।
आइडेंटिटी ड्रिफ़्ट की समस्या
डिफ़्यूज़न मॉडल की हर इमेज यादृच्छिक नॉइज़ से शुरू होती है। जनरेशन के बीच कोई कैरेक्टर मेमोरी नहीं होती। यहाँ तक कि बहुत विशिष्ट शारीरिक विवरणों (आँखों का सटीक रंग, जबड़े का खास आकार, बालों की विशेष बनावट, एक अनोखा निशान) के साथ भी मॉडल एक प्रायिकता वितरण से सैंपल लेता है और उस सीमा के भीतर एक भिन्नता बनाता है, न कि किसी एक तय व्यक्ति का पुनरुत्पादन। जितनी ज़्यादा जनरेशन चलाएँगे, चेहरा मूल इरादे से उतना ही दूर खिसकेगा।
इससे प्रोडक्ट कैंपेन, विज़ुअल स्टोरीटेलिंग, ब्रांड कैरेक्टर और किसी भी ऐसे वर्कफ़्लो में ठोस समस्याएँ आती हैं जिसमें एक पहचाना जाने वाला दोहराया जाने वाला सब्जेक्ट चाहिए। केवल टेक्स्ट प्रॉम्प्टिंग से बनाई गई "उसी औरत" की इमेज की सीरीज़ किसी कास्टिंग कॉल जैसी लगेगी, विभिन्न दृश्यों में एक सुसंगत कैरेक्टर जैसी नहीं।
स्थिर वेरिएशन के लिए Flux Redux Dev
Flux Redux Dev इस समस्या को अलग तरीके से लेता है। यह एक मौजूदा इमेज को संदर्भ के रूप में लेता है और ऐसे सुसंगत विज़ुअल वेरिएशन बनाता है जो सब्जेक्ट की मूल पहचान, कंपोज़िशन और स्टाइल बनाए रखते हैं। बिना शुरू से कस्टम LoRA ट्रेन किए, सुसंगत कैरेक्टर जनरेशन का यह सबसे आसान रास्ता है। कई दृश्यों में पहचाने जाने लायक चेहरा चाहने वाले कैंपेन के लिए, एक मज़बूत संदर्भ पोर्ट्रेट के साथ Flux Redux Dev इस्तेमाल करने से जनरेशन के बीच आइडेंटिटी ड्रिफ़्ट काफ़ी घटता है।
💡 Tip: पहले अपने सबसे उच्च-गुणवत्ता वाले मॉडल से एक आदर्श कैरेक्टर पोर्ट्रेट जनरेट करें। फिर हर बार टेक्स्ट विवरण से दोबारा प्रॉम्प्ट लिखने के बजाय, उसी एंकर इमेज से सभी दृश्य वेरिएशन के लिए Flux Redux Dev इस्तेमाल करें।
लोगो और असली दुनिया के ब्रांड
AI इमेज मॉडल असली दुनिया के ट्रेडमार्क वाले लोगो या खास ब्रांड चिह्नों को सटीक रूप से दोबारा नहीं बना सकते। यह एक कानूनी बाधा को भी दर्शाता है, जो ट्रेनिंग प्रक्रियाओं में बनी है, और एक तकनीकी बाधा को भी: लोगो सटीक ज्यामितीय अनुपात, खास रंग-मानों और सटीक अक्षर-दूरी पर निर्भर करते हैं, जिन्हें डिफ़्यूज़न सैंपलिंग विश्वसनीय रूप से दोबारा नहीं बना सकती।
ट्रेडमार्क के साथ क्या होता है
जब आप असली ब्रांड लोगो वाले प्रोडक्ट का प्रॉम्प्ट देते हैं, तो मॉडल एक सौंदर्यात्मक अनुमान बनाता है। आकार और रंग पहली नज़र में सही लगते हैं। अक्षर-रूप लगभग-सही पहचाने जाते हैं। लेकिन अक्षर आपस में मिल जाते हैं, अनुपात बिगड़ते हैं, और ब्रांड सटीकता के लिए ज़रूरी ज्यामितीय सटीकता गायब रहती है। मॉडल असली ब्रांड वाली लाखों इमेज पर ट्रेन हुए हैं, लेकिन ट्रेनिंग के दौरान उन्हें सटीक पुनरुत्पादन से बचने का मार्गदर्शन दिया गया है, कॉपीराइट कारणों से भी और इसलिए भी कि डिफ़्यूज़न सैंपलिंग का लक्ष्य पिक्सल-परफ़ेक्ट ज्यामितीय निष्ठा नहीं है।
प्रोडक्ट फ़ोटो का वर्कअराउंड
सबसे साफ़ समाधान है कि जनरेशन के चरण को ब्रांडिंग के चरण से पूरी तरह अलग रखा जाए।
| स्थिति | सबसे अच्छा तरीका |
|---|
| ब्रांड के साथ प्रोडक्ट मॉकअप | प्रोडक्ट का आकार और लाइटिंग जनरेट करें, डिज़ाइन सॉफ़्टवेयर में लोगो जोड़ें |
| ब्रांडेड आइटम वाली लाइफ़स्टाइल शॉट | प्रॉम्प्ट में एक जेनेरिक प्रोडक्ट वर्ज़न इस्तेमाल करें |
| लेबल टेक्स्ट वाली पैकेजिंग | फ़ॉर्म और मटीरियल जनरेट करें, लेबल की टाइपसेटिंग अलग से करें |
| असली प्रोडक्ट वाली कैंपेन इमेज | वातावरण और मूड के लिए AI इस्तेमाल करें, उसके ऊपर असली प्रोडक्ट फ़ोटो कंपोज़िट करें |
Seedream 4.5 सटीक मटीरियल टेक्सचर और नियंत्रित लाइटिंग के साथ साफ़ 4K प्रोडक्ट सतहें बनाने में उत्कृष्ट है। इसका इस्तेमाल विज़ुअल वातावरण तय करने के लिए करें, फिर बाद में Photoshop, Figma या किसी भी कंपोज़िटर में सटीक ब्रांड मार्क जोड़ें। नतीजा पूरी तरह AI से बनी इमेज जैसा ही दिखेगा, लेकिन ब्रांड-सटीक टाइपोग्राफ़ी के साथ।
स्पेशियल लॉजिक टूटा हुआ है
एक लाल गेंद को नीले क्यूब के बाईं ओर रखें। दो लोग दिखाएँ और उनके बीच एक तीसरा व्यक्ति खड़ा हो। एक वस्तु को अग्रभूमि में रखें जबकि दूसरी उसके ठीक पीछे एक खास कोण पर हो। स्टैंडर्ड डिफ़्यूज़न मॉडल इन सभी में निराशाजनक नियमितता के साथ असफल होते हैं। स्पेशियल रीज़निंग की गलतियाँ कभी-कभार नहीं, व्यवस्थित होती हैं।
बाएँ-दाएँ का भ्रम
डिफ़्यूज़न मॉडल पिक्सल-स्तर के डिनॉइज़िंग से काम करते हैं, स्पेशियल रीज़निंग से नहीं। "बाएँ" और "दाएँ" अमूर्त संबंधात्मक अवधारणाएँ हैं जिन्हें मॉडल ट्रेनिंग डेटा से अवशोषित कंपोज़िशनल सांख्यिकी से केवल आंशिक रूप से जोड़ पाते हैं। सांख्यिकीय संबंध असली है, लेकिन कमज़ोर है। व्यवहार में, बाएँ-दाएँ की स्थितियाँ लगभग आधी बार उलट जाती हैं या अस्पष्ट रहती हैं।
कैमरा-सापेक्ष भाषा दिशा-सूचक शब्दों से आमतौर पर बेहतर काम करती है। "अग्रभूमि की वस्तु," "बैकग्राउंड का तत्व," "कैमरे के पास," "दर्शक से दूर," और "फ़्रेम का ऊपरी दायाँ कोना" उन कंपोज़िशनल पैटर्न से ज़्यादा भरोसेमंद रूप से जुड़ते हैं जिन्हें मॉडल ने आत्मसात किया है। फ़्रेम से जुड़े पोज़िशनल कीवर्ड, इमेज के भीतर सब्जेक्ट्स से जुड़ी संबंधात्मक दिशाओं से बेहतर प्रदर्शन करते हैं।
गिनती और स्थान
गिनती भी उतनी ही अविश्वसनीय है। "तीन कुत्ते" अक्सर दो या चार बनाते हैं। "समूह में पाँच लोग" शायद ही कभी ठीक पाँच बनाता है। "दाईं ओर एक पेड़" कभी दो पेड़ बन जाता है, या कोई भी नहीं। मॉडल के पास कोई अंकगणितीय सत्यापन चरण नहीं है, इसलिए वह विषय-पैटर्न को उपलब्ध जगह में इस आधार पर फैलाता है कि उसके सीखे वितरण के हिसाब से कंपोज़िशनल रूप से क्या संभव लगता है, न कि प्रॉम्प्ट में लिखी संख्या क्या माँगती है।
वास्तव में क्या मदद करता है:
- पूर्ण स्थितियों के बजाय स्पेशियल संबंध बताएँ: "Person A stands in front of Person B, with B visible just behind A's shoulder"
- फ़्रेम-आधारित शब्दों का इस्तेमाल करें: "center frame," "upper right," "lower left corner," "filling the foreground"
- कई वेरिएशन जनरेट करें और वह चुनें जो इच्छित व्यवस्था से मेल खाए
- सटीक-ज़रूरी कंपोज़िशन के लिए, PicassoIA Image के माध्यम से उपलब्ध ControlNet-आधारित स्ट्रक्चरल कंट्रोल इस्तेमाल करें, जिससे रेफ़रेंस स्केलेटन या डेप्थ मैप के साथ वस्तुओं की सटीक स्थिति तय की जा सके
सांस्कृतिक और क्षेत्रीय डिटेल
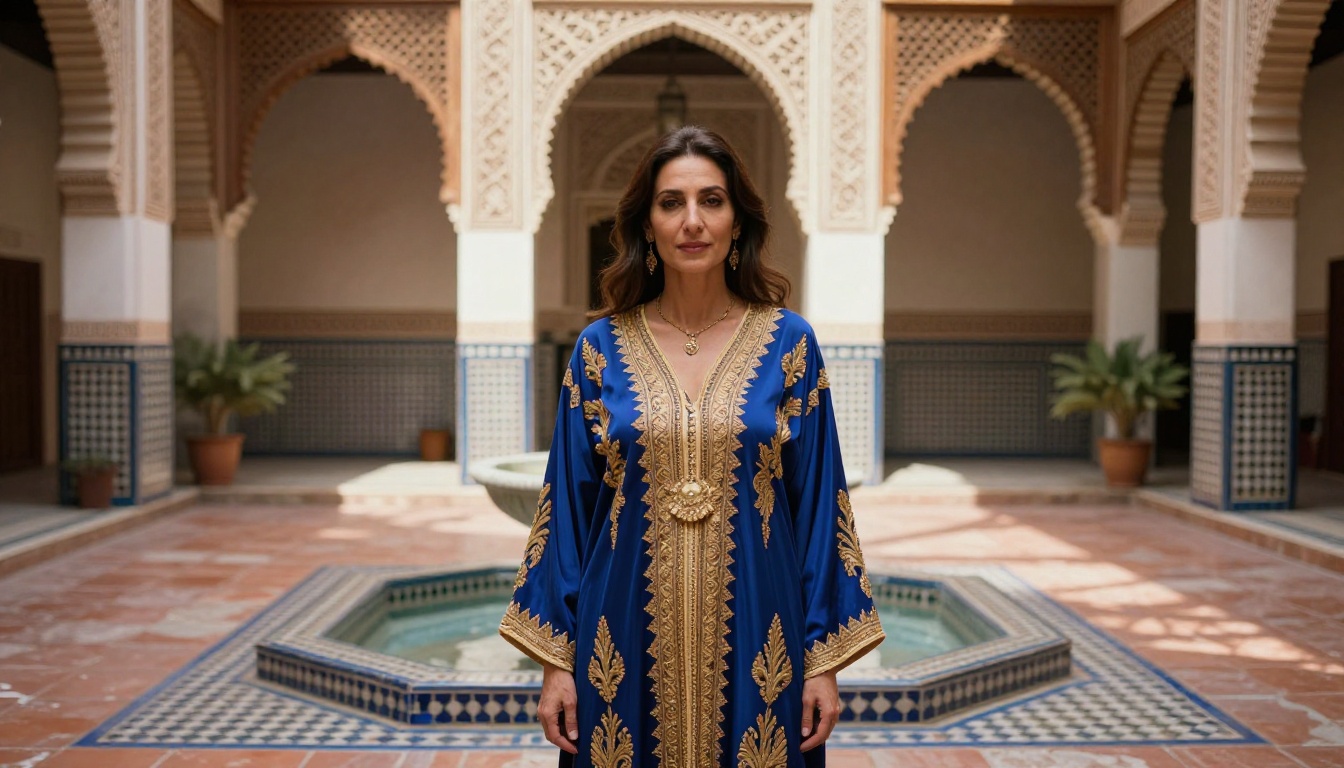
मुख्य रूप से पश्चिमी इंटरनेट डेटा पर ट्रेन हुए मॉडल इस झुकाव को हर जनरेशन में ले जाते हैं। "पारंपरिक पोशाक" का प्रॉम्प्ट दें तो आउटपुट यूरोपीय लोक-पोशाक की ओर झुक जाता है। क्षेत्रीय वास्तुकला, धार्मिक-अनुष्ठान की वस्तुएँ, गैर-पश्चिमी लिपियाँ और सांस्कृतिक रूप से खास खाना रूढ़िगत अनुमानों से दिखाए जाते हैं, या कुछ मामलों में ऐसी विज़ुअल डिटेल के साथ जो उस संस्कृति में असल में मौजूद ही नहीं हैं।
ट्रेनिंग डेटा में पश्चिमी झुकाव
AI मॉडल को ट्रेन करने में इस्तेमाल होने वाले ज़्यादातर बड़े पैमाने के इमेज डेटासेट अंग्रेज़ी-भाषा की वेब सामग्री, ऐसे स्टॉक फ़ोटो लाइब्रेरी जिनमें यूरो-अमेरिकी विषय और सेटिंग हावी हैं, और उच्च-आय वाले अंग्रेज़ी-भाषी बाज़ारों के सोशल मीडिया की ओर भारी झुके होते हैं। इसका व्यावहारिक नतीजा यह है कि मॉडल ने पश्चिम अफ़्रीकी अनुष्ठानिक पोशाक, पूर्वी एशियाई ग्रामीण वास्तुकला, एंडियन बुनाई के पैटर्न या मध्य अमेरिकी बाज़ार के दृश्यों के उदाहरण न्यूयॉर्क के स्टूडियो अपार्टमेंट या पेरिस की सड़क के कैफ़े की तुलना में कहीं कम देखे हैं।
इसका दिखने वाला नतीजा: कम सटीकता, सामान्य विज़ुअल अनुमान, और कभी-कभी तथ्यात्मक रूप से गलत विज़ुअल डिटेल, जब प्रॉम्प्ट मॉडल के घने प्रतिनिधित्व वाले क्षेत्रों से बाहर जाते हैं। कोई पारंपरिक परिधान सिल्हूट और रंग में मोटे तौर पर सही दिख सकता है, लेकिन उस पर कढ़ाई के ऐसे पैटर्न हो सकते हैं जो किसी दूसरी संस्कृति या पूरी तरह दूसरे काल के हों।
प्रॉम्प्ट क्या ठीक कर सकते हैं और क्या नहीं
विशिष्टता से काफ़ी मदद मिलती है। सटीक परिधान का नाम लेना (kaftan, hanbok, kente cloth, huipil, ao dai), क्षेत्र और काल बताना, और ठोस विज़ुअल डिटेल जोड़ना (zellige tile, indigo needlework, ikat weave pattern, खास रंगाई की तकनीक) मॉडल को सामान्य सांस्कृतिक लेबल की तुलना में ज़्यादा सटीक क्षेत्र की ओर ले जाता है। लेकिन कोई भी प्रॉम्प्ट ट्रेनिंग डेटा की मात्रा में मूल कमी की भरपाई नहीं कर सकता। जिस मॉडल ने किसी खास क्षेत्रीय कलाकृति के बहुत कम उदाहरण देखे हैं, वह ऐसी विज़ुअल डिटेल का हैलुसिनेशन करेगा जो देखने में विश्वसनीय लगें, लेकिन सीधे-सीधे गलत हों।
जिन प्रोजेक्ट में सांस्कृतिक सटीकता मायने रखती है, वहाँ सार्वजनिक-उपयोग के काम में AI आउटपुट इस्तेमाल करने से पहले उसे फ़ोटोग्राफ़िक संदर्भों से जाँच लें। GPT Image 2 विविध ट्रेनिंग डेटा के कारण उल्लेखनीय रूप से व्यापक सांस्कृतिक कवरेज दिखाता है, और उन मॉडलों की तुलना में गैर-पश्चिमी विषयों पर तुलनात्मक रूप से बेहतर प्रदर्शन करता है जो अधिक समरूप डेटासेट पर ट्रेन हुए हैं।
आज के सबसे अच्छे मॉडल वास्तव में क्या अच्छा करते हैं
ऊपर बताई सीमाएँ असली हैं, लेकिन वे असाधारण क्षमताओं के साथ मौजूद हैं। मौजूदा AI इमेज मॉडल ऐसे औसत टूल नहीं हैं जिनमें कुछ अच्छे पल हों। वे शक्तिशाली टूल हैं जिनमें खास संरचनात्मक अंधी जगहें हैं, और वे अंधी जगहें अनुमान लगाने लायक हैं।
जहाँ मौजूदा मॉडल असाधारण प्रदर्शन करते हैं:
| क्षमता | मज़बूती का स्तर |
|---|
| वातावरणीय लाइटिंग और मूड | असाधारण |
| फ़ोटोरियलिस्टिक त्वचा, कपड़ा, धातु की बनावट | असाधारण |
| प्रकृति, लैंडस्केप और खुला वातावरण | उत्कृष्ट |
| सिंगल-सब्जेक्ट पोर्ट्रेट फ़ोटोग्राफ़ी | उत्कृष्ट |
| इंटीरियर डिज़ाइन और आर्किटेक्चर | मज़बूत |
| साफ़ बैकग्राउंड पर प्रोडक्ट आइसोलेशन | मज़बूत |
| अमूर्त और संकल्पनात्मक इमेज | मज़बूत |
| टाइपोग्राफ़ी और लोगो प्रजनन | कमज़ोर |
| जटिल स्पेशियल व्यवस्थाएँ | कमज़ोर |
| सत्रों के बीच कैरेक्टर कंसिस्टेंसी | कमज़ोर |
सबसे मज़बूत प्रोडक्शन वर्कफ़्लो इन मज़बूतियों का लाभ उठाता है और हर चरण पर कमज़ोरियों से बचकर रास्ता निकालता है।
PicassoIA Image Editor Pro करेक्शन परत संभालता है: टूटे हाथों की इनपेंटिंग, फ़्रेम बढ़ाने के लिए आउटपेंटिंग, किसी अच्छी इमेज में खास वस्तुओं की अदला-बदली, और समस्या वाले हिस्सों में डिटेल की गुणवत्ता बहाल करना। इसे बेस जनरेशन के लिए Hunyuan Image 2.1 के साथ जोड़ने पर आपको मज़बूत टेक्सचर डिटेल वाले उच्च-रिज़ॉल्यूशन 2K ड्राफ़्ट मिलते हैं, और फिर जो भी विशेष हिस्सा गलत आए, उसके लिए लक्षित क्षेत्र-सुधार।
वह वर्कफ़्लो जो सच में काम करता है
एक ही पास में परफ़ेक्ट इमेज प्रॉम्प्ट करने की कोशिश कभी-कभार काम करती है और अक्सर विफल होती है। एक अधिक भरोसेमंद तरीका जनरेशन और एडिटिंग को दो अलग चरणों की तरह लेता है:
- अपने चुने मॉडल से एक मज़बूत बेस इमेज जनरेट करें
- खास समस्या वाले हिस्से पहचानें: हाथ, टेक्स्ट, स्पेशियल गलतियाँ, कैरेक्टर ड्रिफ़्ट
- हर समस्या वाले क्षेत्र को अलग-अलग और स्वतंत्र रूप से एक लक्षित प्रॉम्प्ट के साथ इनपेंटिंग से ठीक करें
- अगर आपके अंतिम आउटपुट को बड़े प्रिंट आयाम चाहिए, तो सुपर-रेज़ोल्यूशन अपस्केलिंग लागू करें
- किसी भी ब्रांड मार्क, सटीक टेक्स्ट या खास लोगो को बाद में बाहरी डिज़ाइन सॉफ़्टवेयर में कंपोज़िट करें
यह तरीका उस तकनीक के असली प्रदर्शन से मेल खाता है, बजाय इसकी संरचनात्मक विशेषताओं से लड़ने के।
असली सीमाओं को ध्यान में रखकर बनाना शुरू करें
यह जानना कि AI इमेज मॉडल अभी क्या नहीं कर सकता, उसे कम इस्तेमाल करने का कारण नहीं है। यह उसे तेज़ी से और काफ़ी कम निराशा के साथ इस्तेमाल करने का कारण है। "प्रॉम्प्ट ने जो वर्णन किया" और "मॉडल ने जो दिया" के बीच का अंतर तब तेज़ी से कम हो जाता है, जब आप जानते हैं कि कहाँ ड्रिफ़्ट की उम्मीद करनी है और हर चरण पर किन टूल्स तक पहुँचना है।
PicassoIA एक ही प्लेटफ़ॉर्म पर 90 से ज़्यादा टेक्स्ट-टू-इमेज मॉडल के साथ एडिटिंग टूल, सुपर-रेज़ोल्यूशन, फ़ेस-स्वैप क्षमताएँ और वीडियो जनरेशन लाता है। चाहे आप PicassoIA Image Editor Pro से शरीर-रचना ठीक कर रहे हों, Riverflow 2.0 Pro से पढ़ने लायक टाइपोग्राफ़ी रख रहे हों, Flux Redux Dev से कैरेक्टर कंसिस्टेंसी बनाए रख रहे हों, या Seedream 4.5 से 4K पोर्ट्रेट बना रहे हों, हर खास सीमा के लिए सही टूल पहले से उपलब्ध है।
AI इमेज मॉडल हर प्रॉम्प्ट पर निर्दोष, पूरी तरह नियंत्रित आउटपुट के लिए अभी वहाँ नहीं पहुँचे हैं। लेकिन ये अभी इतने सक्षम हैं कि उनकी सीमा को पहचानने से हर रचनात्मक वर्कफ़्लो तेज़ होता है, धीमा नहीं।
एक प्रॉम्प्ट चुनें, एक मॉडल चुनें और जनरेट करना शुरू करें। वर्कअराउंड दिखने से कहीं आसान हैं।