Tous les utilisateurs d’IA finissent par atteindre ce moment. Vous rédigez un prompt soigneux et détaillé, lancez la génération, et quelque chose cloche légèrement. Les mains ont six doigts. Un panneau en arrière-plan affiche un charabia. Le personnage que vous avez construit à travers trois prompts précis ressemble à une autre personne sur l’image suivante. Ce ne sont pas des bugs aléatoires. Ce sont des angles morts structurels, inscrits dans le fonctionnement même des modèles d’image IA actuels, et savoir les reconnaître fait la différence entre des crédits gaspillés et une création efficace et maîtrisée.
Voici un regard direct sur ce qu’un modèle d’image IA ne sait pas encore faire, pourquoi chaque limite existe sur le plan technique, et quels outils concrets permettent de combler chaque lacune.
Le problème du texte est pire que vous ne le pensez
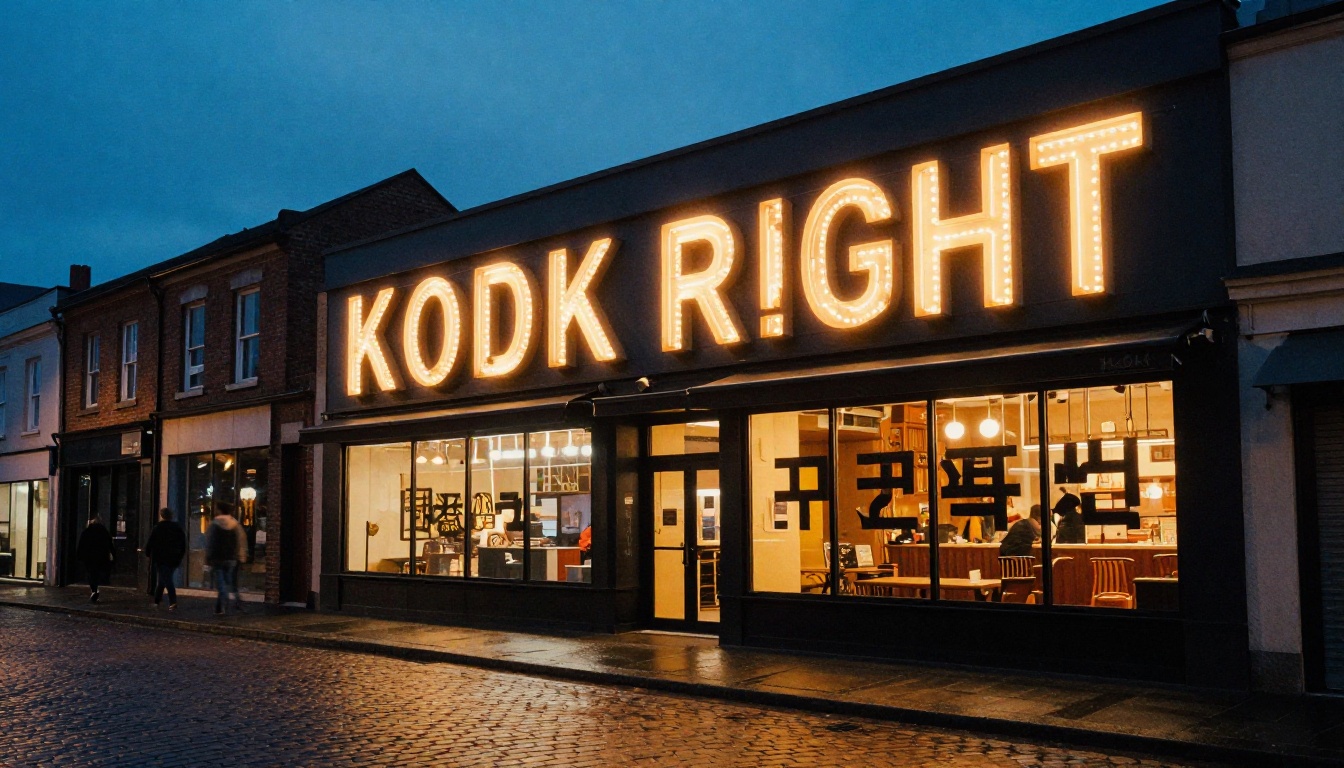
Les modèles d’image IA n’« écrivent » pas de texte. Ils n’ont aucune notion de lettres en tant que symboles discrets porteurs de sens. Ils apprennent plutôt que certains motifs de pixels apparaissent près de certains mots de légende dans les données d’entraînement, et reproduisent ces textures visuelles. Le résultat ressemble à s’y méprendre à du texte, jusqu’à ce qu’on le lise de près : il se désagrège alors en formes dénuées de sens et en traits qui se chevauchent.
Pourquoi les lettres se déforment
Quand vous demandez à un modèle de diffusion standard d’afficher un texte lisible sur un panneau, une couverture de livre ou une étiquette imprimée, le modèle puise dans les associations statistiques entre les mots de la légende et les motifs de pixels. Les mots courts et courants survivent parfois intacts. Tout ce qui est plus long, ou tout texte exigeant un espacement précis des lettres et une géométrie constante, se dégrade vite. Le modèle n’a pas de dictionnaire interne, aucune notion de caractères comme unités symboliques, et aucun mécanisme pour vérifier que ce qu’il a rendu est réellement lisible.
C’est pourquoi les images générées par IA de restaurants, de vitrines, d’étiquettes de produits, de menus, de livres et de journaux contiennent presque toujours un texte déformé. Le modèle ne commet pas d’erreur selon ses propres critères. Il reproduit l’apparence visuelle du texte sans encoder le moindre sens linguistique.
Le problème s’aggrave avec les écritures non latines. Les modèles entraînés surtout sur des données en anglais réussissent particulièrement mal avec l’arabe, le chinois, le coréen, le thaï ou le cyrillique. Ils produisent des textures qui évoquent visuellement la famille d’écriture, mais qui restent totalement illisibles pour quelqu’un qui parle la langue.
Riverflow 2.0 Pro fait figure d’exception
Tous les modèles ne partagent pas cette limite au même degré. Riverflow 2.0 Pro a été conçu spécifiquement pour le contrôle typographique : il permet d’intégrer des polices et de définir le placement d’un texte lisible avec une précision bien supérieure à celle des modèles de diffusion standard. Riverflow 2.0 Fast propose la même capacité typographique dans un flux de travail plus rapide, pour les projets à délais serrés. Si un texte exact est une exigence impérative pour votre rendu, ces modèles sont la solution directe, et non un pis-aller.
💡 Astuce : Gardez tout texte de votre prompt court. Placez le mot exact entre guillemets (par exemple "SALE") et utilisez un modèle sensible à la typographie. Les modèles de diffusion standard échouent de manière fiable sur les chaînes de plus de deux ou trois mots courants.
Les mains restent un cauchemar récurrent
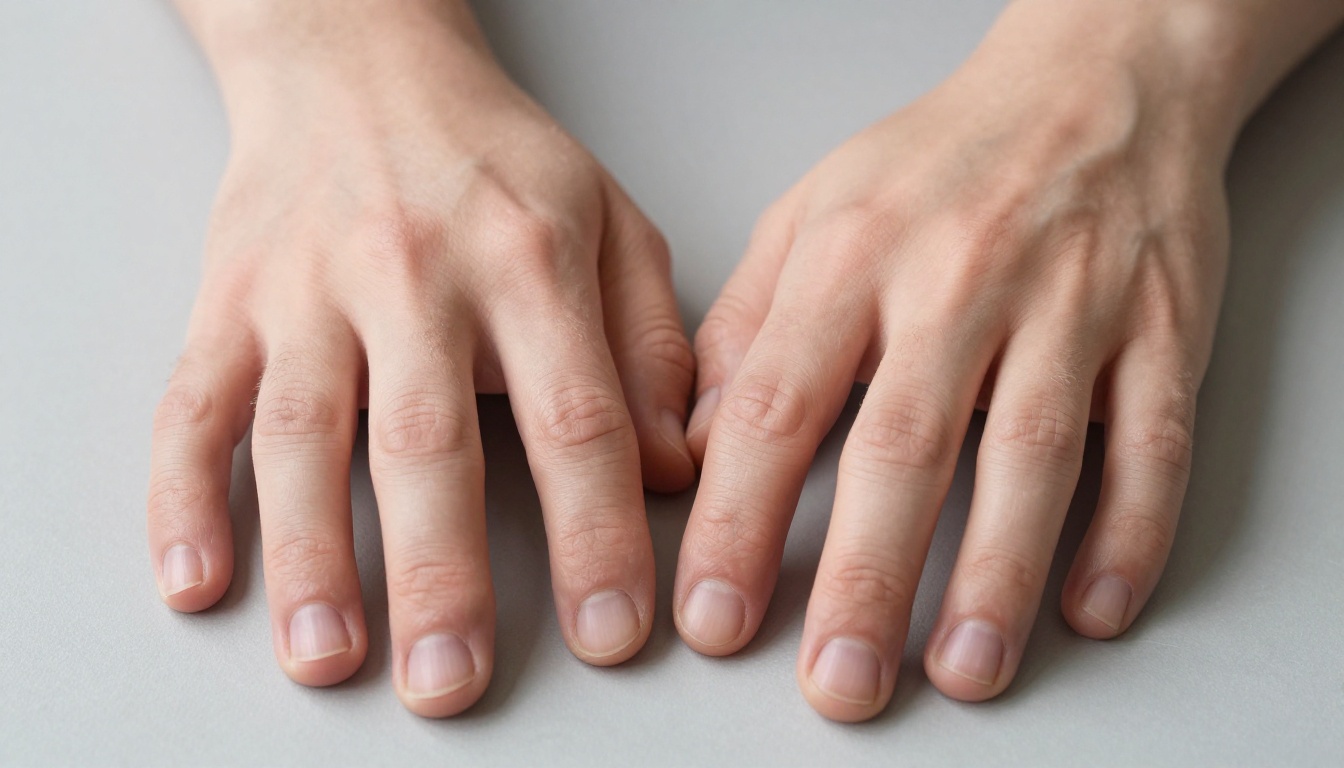
Les mains constituent l’échec le plus souvent cité de la génération d’images IA, et le problème est profond. Les mains humaines sont structurellement complexes : 27 os, des configurations de pose variables et une grande diversité d’éclairage, d’angle et d’occultation partielle. Les jeux de données d’entraînement contiennent des mains dans des millions de configurations, mais les modèles ont systématiquement échoué à généraliser une structure anatomique fiable à partir de toute cette variété.
Pourquoi le modèle compte mal
Les modèles de diffusion ne comptent pas. Aucun calcul n’intervient quand un modèle rend une main. Le nombre de doigts qui apparaît dans le rendu est une probabilité statistique fondée sur les motifs de pixels qui s’accordent avec la composition environnante, et non une décision délibérée. Quand les mains sont partiellement masquées, dans des poses inhabituelles ou près d’autres objets complexes, le modèle répartit des motifs en forme de doigts sur l’espace disponible, sans contrainte anatomique. Six doigts sont fréquents. Les jointures fusionnées, les paumes sans ossature apparente et les mains sans attache claire au poignet surviennent régulièrement.
Les architectures récentes, entraînées sur des jeux de données à plus haute résolution et soigneusement sélectionnés, ont nettement réduit ce problème. Mais même les modèles actuels les plus performants produisent des défauts de mains dans certaines configurations de composition, notamment lorsque les mains interagissent avec de petits objets, saisissent des choses ou sont placées selon des angles inhabituels.
Corriger les mains par inpainting
Insister dans le prompt règle rarement le problème. Le contournement le plus fiable est l’inpainting : générez d’abord l’image complète, puis masquez la zone de la main et régénérez-la spécifiquement avec un prompt anatomique ciblé. PicassoIA Image Editor Pro simplifie ce flux de travail : vous dessinez un masque autour de la zone problématique et la régénérez, pendant que le reste de l’image demeure intact. Qwen Image Edit Plus offre une précision d’inpainting comparable, avec une bonne préservation des détails à la limite du masque.
💡 Astuce : Ajoutez « cinq doigts, anatomie humaine correcte, séparation naturelle des doigts, aucun doigt supplémentaire » à tout prompt qui montre des mains au premier plan. Cela n’élimine pas le problème, mais réduit nettement le taux d’échec.
Le même personnage, un autre visage
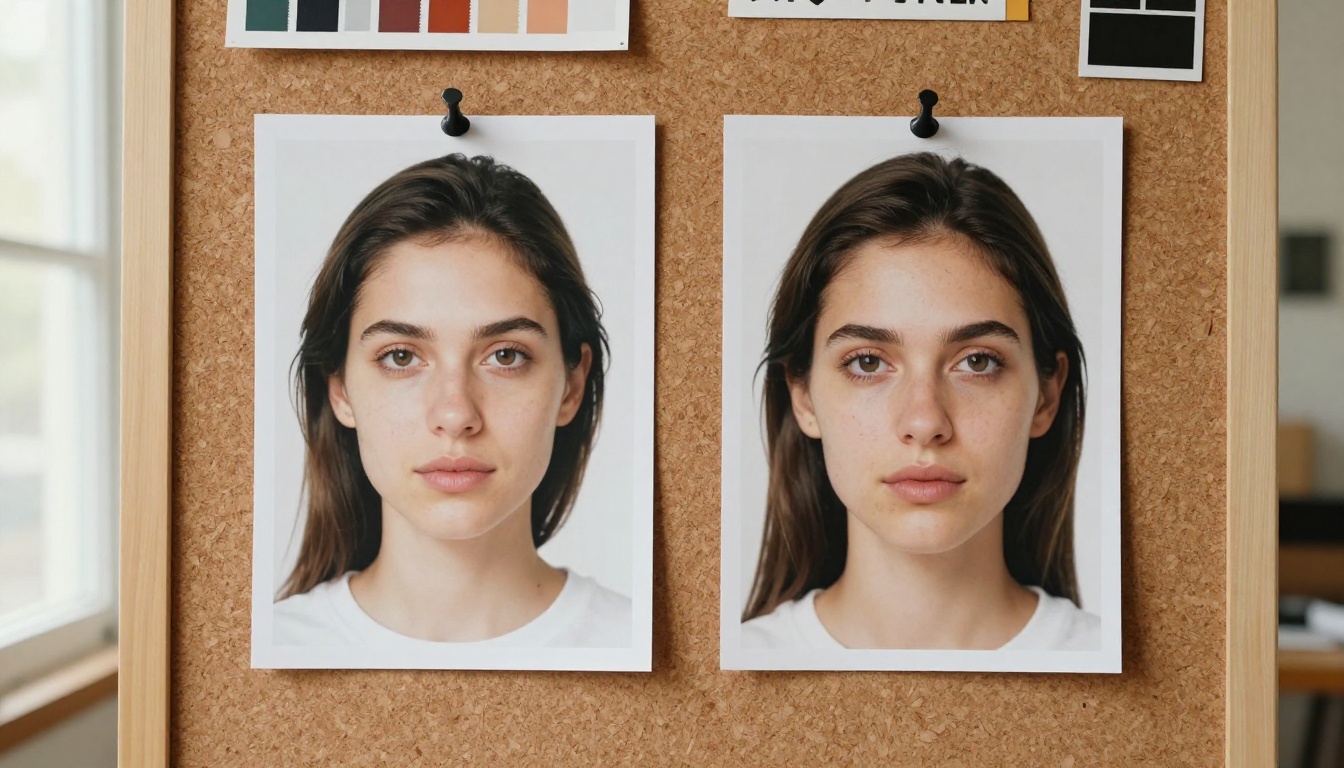
Générer le même personnage reconnaissable sur plusieurs images figure parmi les fonctions les plus demandées de la génération d’images IA, et l’une des plus difficiles à obtenir avec les modèles texte vers image standard. Demandez deux fois la même description physique et vous obtenez deux personnes différentes. Changez un seul adjectif et le visage change de nouveau. Il ne s’agit pas d’un problème de savoir-faire en rédaction de prompts, mais d’une propriété structurelle : les modèles de diffusion génèrent chaque image indépendamment, à partir de zéro.
Le problème de la dérive d’identité
Chaque image produite par un modèle de diffusion part d’un bruit aléatoire. Il n’existe aucune mémoire du personnage d’une génération à l’autre. Même avec des descripteurs physiques très précis (couleur exacte des yeux, forme particulière de la mâchoire, texture de cheveux spécifique, cicatrice unique), le modèle tire un échantillon d’une distribution de probabilités et produit une variation dans cette plage, plutôt qu’une reproduction d’un individu fixe. Plus vous lancez de générations, plus le visage s’éloigne de l’intention de départ.
Cela crée des problèmes concrets pour les campagnes de produits, la narration visuelle, les personnages de marque et tout flux de travail qui exige un sujet récurrent et reconnaissable. Une série d’images de « la même femme » produite uniquement par prompts textuels ressemblera à un casting, et non à un personnage cohérent d’une scène à l’autre.
Flux Redux Dev pour des variations stables
Flux Redux Dev aborde ce problème autrement. Il prend une image existante comme référence et génère des variations visuelles cohérentes qui préservent l’identité, la composition et le style du sujet. C’est la voie la plus accessible vers une génération de personnages cohérents, sans avoir à entraîner un LoRA sur mesure. Pour les campagnes qui exigent un visage reconnaissable sur plusieurs scènes, utiliser Redux Dev avec un seul portrait de référence de bonne qualité réduit nettement la dérive d’identité entre les générations.
💡 Astuce : Commencez par générer un portrait idéal de votre personnage avec votre modèle le plus performant. Utilisez ensuite Flux Redux Dev pour toutes les variations de scène à partir de cette image d’ancrage, plutôt que de reformuler une description textuelle à chaque fois.
Logos et marques du monde réel
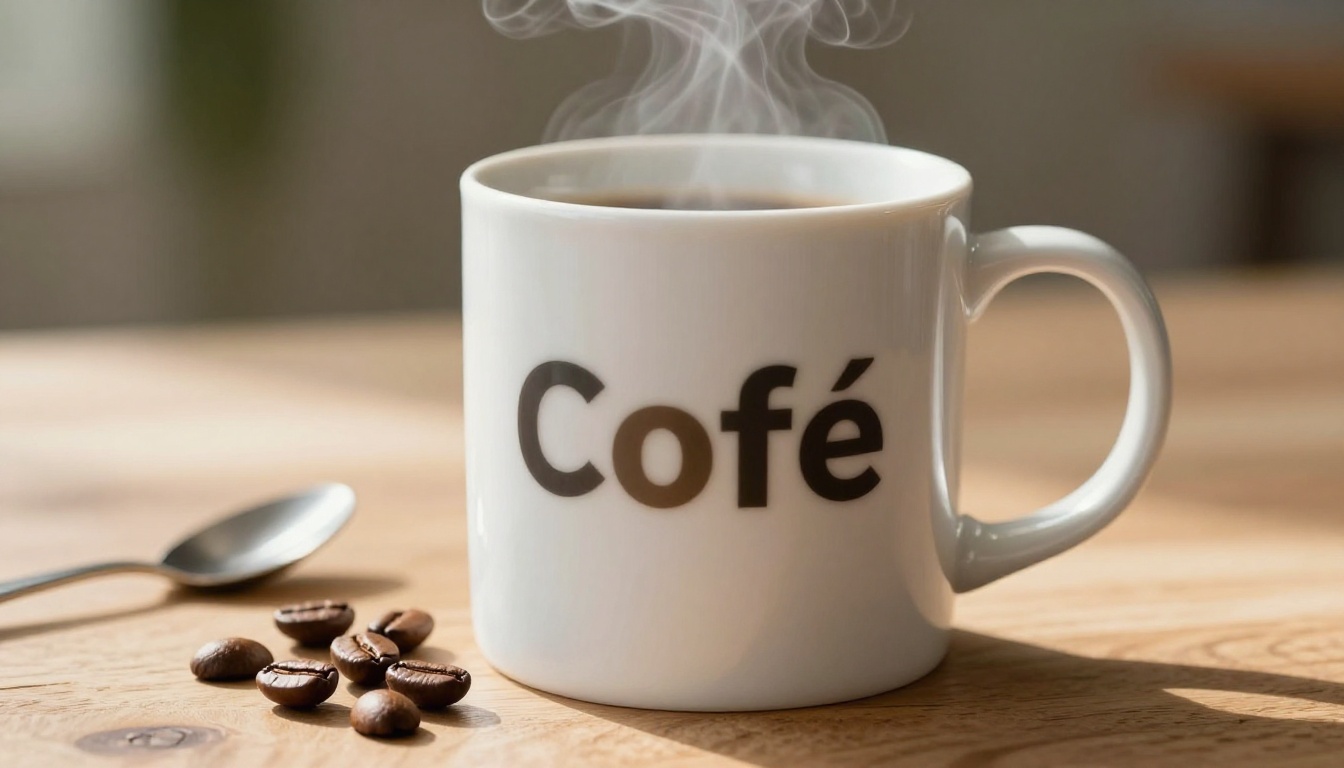
Les modèles d’image IA ne peuvent pas reproduire avec exactitude les logos de marques déposées ou les signes distinctifs réels. Cela tient à la fois à une contrainte juridique intégrée aux procédures d’entraînement et à une contrainte technique : les logos dépendent de proportions géométriques exactes, de valeurs de couleur précises et d’un espacement des lettres rigoureux, que l’échantillonnage par diffusion ne peut pas reconstituer fidèlement.
Ce qui se passe avec les marques déposées
Quand vous demandez un produit avec un vrai logo de marque, le modèle produit une approximation esthétique. La forme et la couleur paraissent correctes au premier coup d’œil. Les lettres ressemblent à peu près à ce qu’elles devraient être, mais les caractères fusionnent, les proportions dérivent, et la précision géométrique nécessaire à l’exactitude de la marque fait défaut. Les modèles ont été entraînés sur des millions d’images contenant de vraies marques, mais ils ont été orientés pendant l’entraînement pour éviter la reproduction exacte, à la fois pour des raisons de droit d’auteur et parce que la fidélité géométrique au pixel près n’est pas ce que l’échantillonnage par diffusion optimise.
Le contournement pour les photos de produits
La solution la plus propre consiste à séparer entièrement l’étape de génération de l’étape d’ajout de la marque.
| Scénario | Meilleure approche |
|---|
| Maquette de produit avec marque | Générer la forme du produit et l’éclairage, ajouter le logo dans un logiciel de design |
| Photo de style de vie avec article de marque | Utiliser une version générique du produit dans le prompt |
| Emballage avec texte d’étiquette | Générer la forme et le matériau, composer l’étiquette séparément |
| Visuel de campagne avec produit réel | Utiliser l’IA pour l’environnement et l’ambiance, superposer une vraie photo du produit |
Seedream 4.5 excelle dans la génération de surfaces de produits nettes en 4K, avec des textures de matière précises et un éclairage maîtrisé. Utilisez-le pour établir l’environnement visuel, puis ajoutez la marque exacte dans Photoshop, Figma ou n’importe quel logiciel de composition. Le résultat paraît identique à une image entièrement générée par IA, mais avec une typographie de marque fidèle.
La logique spatiale est défaillante
Placez une boule rouge à gauche d’un cube bleu. Montrez deux personnes avec une troisième debout entre elles. Positionnez un objet au premier plan pendant qu’un autre se trouve juste derrière, selon un angle précis. Les modèles de diffusion standard échouent sur tous ces cas avec une régularité frustrante. Les erreurs de raisonnement spatial sont systématiques, et non occasionnelles.
Confusion gauche-droite
Les modèles de diffusion fonctionnent par débruitage au niveau des pixels, et non par raisonnement spatial. « Gauche » et « droite » sont des notions relationnelles abstraites que les modèles ne rattachent que partiellement aux statistiques de composition absorbées pendant l’entraînement. L’association statistique existe, mais elle est faible. En pratique, les positions gauche-droite sont inversées ou ambiguës à peu près une fois sur deux.
Le langage centré sur la caméra fonctionne généralement mieux que les termes directionnels. « Objet au premier plan », « élément en arrière-plan », « près de la caméra », « loin du spectateur » et « coin supérieur droit du cadre » se rattachent plus fiablement aux schémas de composition que le modèle a intériorisés. Les repères de position ancrés dans le cadre donnent de meilleurs résultats que les directions relationnelles ancrées aux sujets présents dans l’image.
Comptage et placement
Le comptage est tout aussi peu fiable. « Trois chiens » donne souvent deux ou quatre chiens. « Cinq personnes dans un groupe » produit rarement exactement cinq personnes. « Un seul arbre sur la droite » devient parfois deux arbres, ou aucun. Le modèle ne dispose d’aucune étape de vérification arithmétique : il répartit donc les motifs de sujets sur l’espace disponible selon ce qui paraît plausible pour la composition d’après sa distribution apprise, et non selon le nombre indiqué dans le prompt.
Ce qui aide réellement :
- Décrivez les relations spatiales plutôt que des positions absolues : « La personne A se tient devant la personne B, et B est visible juste derrière l’épaule de A »
- Utilisez des termes ancrés dans le cadre : « centre du cadre », « en haut à droite », « coin inférieur gauche », « occupant le premier plan »
- Générez plusieurs variantes et sélectionnez celle qui correspond à la disposition voulue
- Pour les compositions où la précision est critique, utilisez le contrôle structurel basé sur ControlNet disponible via PicassoIA Image pour définir des positions d’objets exactes à partir d’un squelette de référence ou d’une carte de profondeur
Détails culturels et régionaux
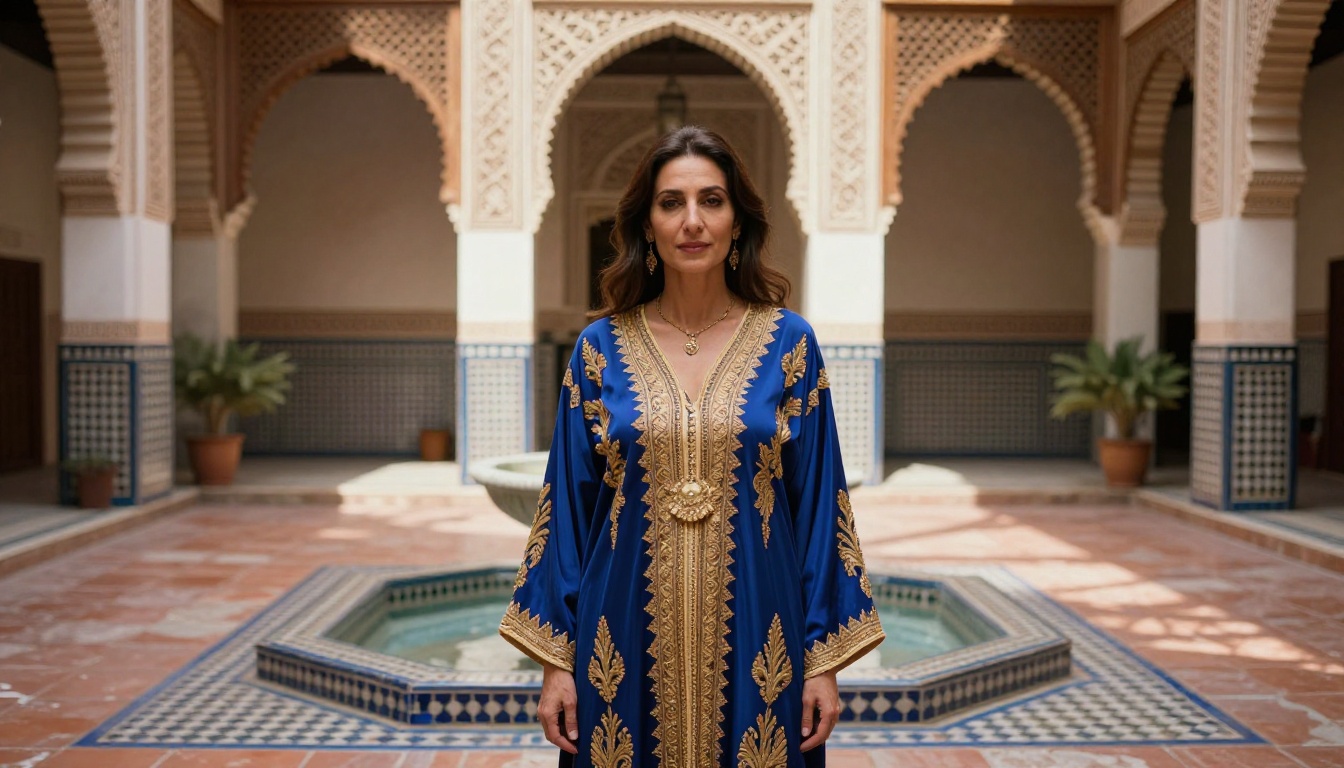
Les modèles entraînés majoritairement sur des données Internet occidentales transmettent ce biais à chaque génération. Demandez des « vêtements traditionnels » et le résultat penche par défaut vers les costumes folkloriques européens. L’architecture régionale, les objets de cérémonie, les écritures non occidentales et les aliments propres à une culture sont rendus avec des approximations stéréotypées ou, parfois, avec des détails visuellement plausibles qui n’existent pas réellement dans la culture évoquée.
Le biais occidental des données d’entraînement
La plupart des grands jeux de données d’images utilisés pour entraîner les modèles d’IA penchent fortement vers le contenu web en anglais, les banques d’images dominées par des sujets et des décors euro-américains, et les réseaux sociaux des marchés anglophones à hauts revenus. La conséquence concrète est un modèle qui a rencontré beaucoup moins d’exemples de costumes de cérémonie d’Afrique de l’Ouest, d’architecture rurale d’Asie de l’Est, de motifs de tissage andins ou de scènes de marché d’Amérique centrale qu’il n’en a vu d’un studio new-yorkais ou d’une terrasse de café parisienne.
Le résultat visible : une précision réduite, des approximations visuelles génériques et parfois des détails visuels factuellement erronés dès que les prompts sortent des zones densément représentées dans le modèle. Un vêtement traditionnel peut paraître globalement juste dans sa silhouette et ses couleurs, tout en affichant des motifs de broderie qui appartiennent entièrement à une autre culture ou à une autre époque.
Ce que les prompts peuvent et ne peuvent pas corriger
La précision aide beaucoup. Nommer le vêtement exact (caftan, hanbok, tissu kente, huipil, ao dai), préciser la région et la période, et ajouter des détails visuels concrets (carreaux de zellige, broderie à l’indigo, motif de tissage ikat, technique de teinture spécifique) rapproche le modèle d’un territoire plus fidèle que les simples étiquettes culturelles génériques. Mais aucun prompt ne peut compenser un manque fondamental de volume de données d’entraînement. Un modèle qui a vu très peu d’exemples d’un artefact régional précis inventera des détails visuels plausibles mais simplement faux.
Pour les projets où l’exactitude culturelle compte, vérifiez les rendus de l’IA par rapport à des références photographiques avant de les utiliser dans des travaux destinés au public. GPT Image 2 présente une couverture culturelle nettement plus large grâce à des données d’entraînement diversifiées, et se montre comparativement plus performant sur des sujets non occidentaux que les modèles entraînés sur des jeux de données plus homogènes.
Ce que les meilleurs modèles actuels font réellement bien
Les limites évoquées plus haut sont réelles, mais elles coexistent avec des capacités véritablement exceptionnelles. Les modèles d’image IA actuels ne sont pas des outils médiocres qui réussissent par moments. Ce sont des outils puissants avec des angles morts structurels précis, et ces angles morts sont prévisibles.
Là où les modèles actuels excellent :
| Capacité | Niveau de performance |
|---|
| Éclairage atmosphérique et ambiance | Exceptionnel |
| Peau, tissus et textures métalliques photoréalistes | Exceptionnel |
| Nature, paysages et environnements ouverts | Excellent |
| Photographie de portrait d’un seul sujet | Excellent |
| Design d’intérieur et architecture | Solide |
| Isolation de produits sur fonds épurés | Solide |
| Imagerie abstraite et conceptuelle | Solide |
| Typographie et reproduction de logos | Faible |
| Agencements spatiaux complexes | Faible |
| Cohérence des personnages entre sessions | Faible |
Le flux de production le plus efficace exploite ces points forts tout en contournant les faiblesses à chaque étape.
PicassoIA Image Editor Pro couvre la couche de correction : inpainting des mains défaillantes, outpainting des compositions pour étendre le cadre, remplacement d’objets précis dans une image par ailleurs réussie, et restauration de la qualité de détail dans les zones problématiques. En le combinant avec Hunyuan Image 2.1 pour la génération de base, vous obtenez des ébauches en 2K à haute résolution, avec une bonne richesse de texture, puis des corrections ciblées sur les zones précises qui ressortent faussées.
Le flux de travail qui fonctionne vraiment
Tenter d’obtenir une image parfaite en un seul passage fonctionne parfois et échoue souvent. Une approche plus fiable sépare la génération et la retouche en deux phases distinctes :
- Générez une image de base solide avec le modèle de votre choix
- Repérez les zones problématiques : mains, texte, erreurs spatiales, dérive du personnage
- Utilisez l’inpainting pour isoler et corriger chaque zone problématique séparément, avec un prompt ciblé
- Appliquez un upscaling (augmentation de la résolution) si votre rendu final exige des dimensions d’impression plus grandes
- Composez ensuite les marques, les textes précis ou les logos spécifiques dans un logiciel de design externe
Cela correspond à la manière dont la technologie fonctionne réellement, au lieu de lutter contre ses propriétés structurelles.
Commencez à créer en gardant les limites réelles à l’esprit
Savoir ce qu’un modèle d’image IA ne sait pas encore faire n’est pas une raison de l’utiliser moins. C’est une raison de l’utiliser plus vite et avec beaucoup moins de frustration. L’écart entre « ce que le prompt décrivait » et « ce que le modèle a livré » se réduit rapidement quand vous savez où attendre une dérive et quels outils employer à chaque étape.
PicassoIA réunit plus de 90 modèles texte vers image, avec des outils d’édition, de super-résolution, d’échange de visage et de génération de vidéos, dans une seule plateforme. Que vous corrigiez l’anatomie avec PicassoIA Image Editor Pro, placiez un texte lisible avec Riverflow 2.0 Pro, maintenez la cohérence des personnages avec Flux Redux Dev, ou que vous génériez des portraits 4K avec Seedream 4.5, l’outil adapté à chaque limite précise est déjà disponible.
Les modèles d’image IA ne sont pas encore au point pour un rendu parfait et entièrement maîtrisé à chaque prompt. Mais ils sont aujourd’hui assez capables pour que reconnaître leur plafond rende chaque flux de travail créatif plus rapide, et non plus lent.
Choisissez un prompt, choisissez un modèle, et lancez la génération. Les contournements sont plus simples qu’ils n’en ont l’air.