Todo usuario de IA para imágenes acaba llegando a un momento así. Escribes un prompt cuidadoso y detallado, pulsas generar y algo no encaja. Las manos tienen seis dedos. Un letrero del fondo muestra un galimatías. El personaje que construiste a lo largo de tres prompts precisos aparece como una persona completamente distinta en la siguiente imagen. No son fallos aleatorios. Son puntos ciegos estructurales propios de cómo funcionan los modelos de imágenes con IA actuales, y reconocer cada uno marca la diferencia entre gastar créditos en vano y obtener un resultado creativo eficiente y deliberado.
Este artículo analiza qué no puede hacer todavía un modelo de imágenes con IA, por qué existe cada limitación a nivel técnico y qué herramientas reales ayudan a cerrar cada brecha.
El problema del texto es peor de lo que crees
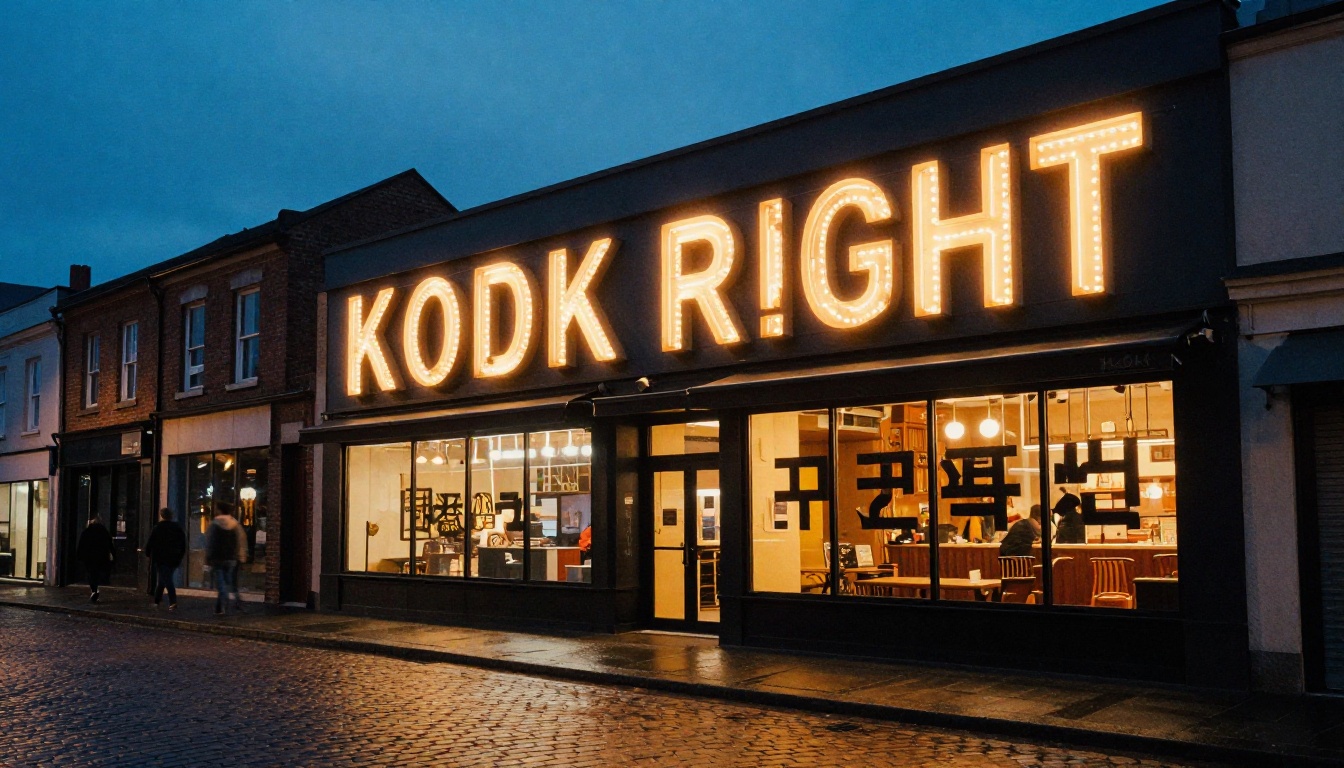
Los modelos de imágenes con IA no "escriben" texto. No tienen ningún concepto de las letras como símbolos discretos que transmiten un significado. En su lugar, aprenden que ciertos patrones de píxeles aparecen cerca de determinadas palabras de los pies de foto en los datos de entrenamiento, y reproducen esas texturas visuales. El resultado se parece convincentemente a un texto hasta que lo lees con atención, momento en el que se desmorona en formas sin sentido y trazos superpuestos.
Por qué las letras se deshacen
Cuando pides a un modelo de difusión estándar que muestre texto legible en un letrero, la portada de un libro o una etiqueta impresa, el modelo recurre a asociaciones estadísticas entre las palabras del pie de foto y los patrones de píxeles. Las palabras cortas y comunes a veces salen intactas. Cualquier palabra más larga, o cualquier texto que requiera un espaciado preciso entre letras y una geometría coherente, se degrada rápidamente. El modelo no tiene un diccionario interno, ni un concepto de las letras como unidades simbólicas, ni un mecanismo para comprobar si lo que ha renderizado se puede leer de verdad.
Por eso las imágenes generadas con IA de restaurantes, escaparates, etiquetas de productos, menús, libros y periódicos casi siempre contienen texto ilegible. El modelo no comete un error según sus propios criterios. Está emparejando la apariencia visual del texto sin codificar ningún significado lingüístico.
El problema se agrava con los alfabetos no latinos. Los modelos entrenados sobre todo con datos en inglés funcionan especialmente mal con caracteres árabes, chinos, coreanos, tailandeses o cirílicos, y producen texturas que recuerdan visualmente a la familia de escritura pero que resultan totalmente ilegibles para alguien que hable ese idioma.
Riverflow 2.0 Pro es la excepción
No todos los modelos comparten esta limitación por igual. Riverflow 2.0 Pro se diseñó específicamente pensando en el control tipográfico, y permite incrustar fuentes y definir la colocación del texto con mucha más precisión que los modelos de difusión estándar. Riverflow 2.0 Fast ofrece la misma capacidad tipográfica en un flujo de trabajo más rápido, pensado para proyectos con plazos ajustados. Si necesitas texto exacto como requisito indispensable, estos modelos son la solución directa, no un parche.
💡 Consejo: Mantén el texto de tu prompt corto. Escribe la palabra exacta entre comillas (por ejemplo, "SALE") y usa un modelo que domine la tipografía. Los modelos de difusión estándar fallan de forma sistemática con cadenas de más de dos o tres palabras comunes.
Las manos siguen siendo una pesadilla recurrente
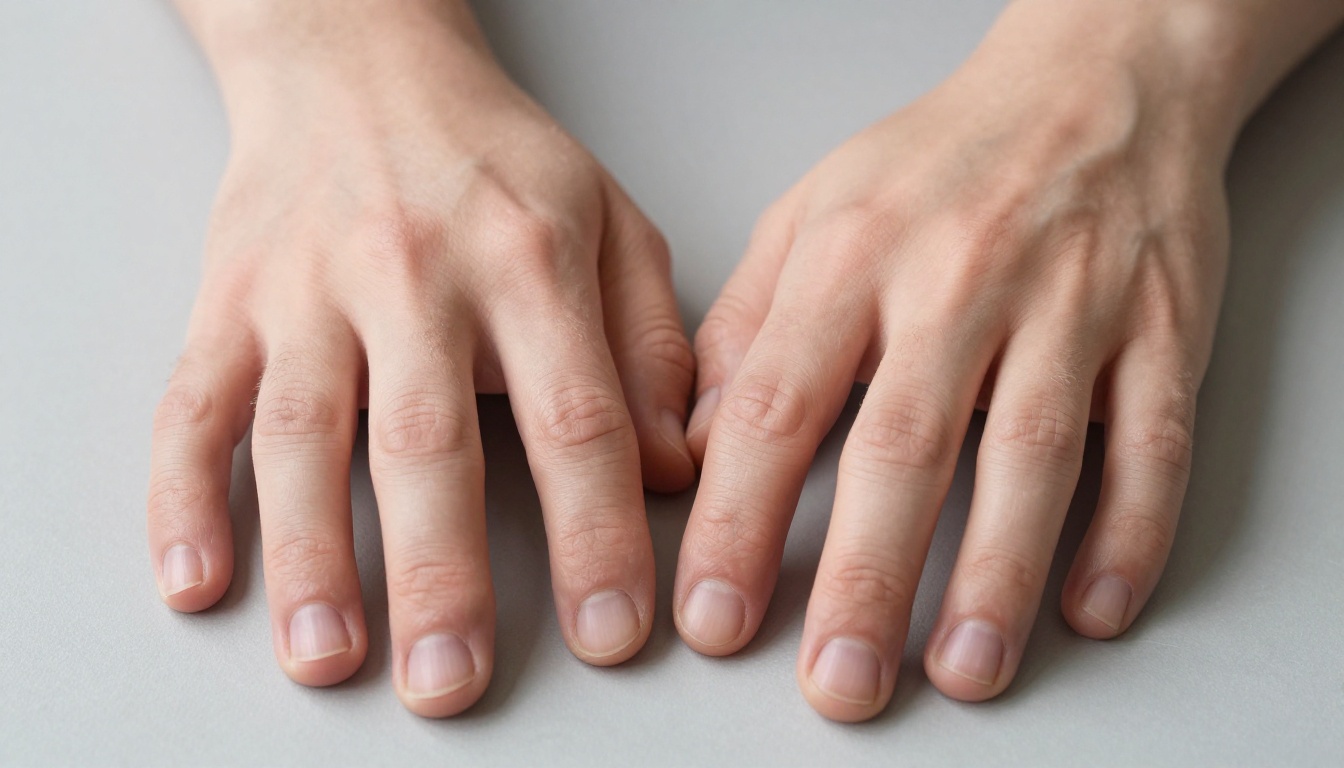
Las manos son el fallo más citado en la generación de imágenes con IA, y el problema es profundo. Las manos humanas son estructuralmente complejas: 27 huesos, configuraciones de pose muy variadas y una enorme variabilidad de iluminación, ángulo y oclusión parcial. Los conjuntos de datos de entrenamiento contienen manos en millones de configuraciones, pero los modelos no han logrado generalizar de forma fiable una estructura anatómica a partir de toda esa variedad.
Por qué el modelo cuenta mal
Los modelos de difusión no cuentan. No hay ninguna aritmética en juego cuando un modelo renderiza una mano. El número de dedos que aparece en el resultado es una probabilidad estadística basada en qué patrones de píxeles encajan con la composición que lo rodea, no una decisión deliberada. Cuando las manos están parcialmente ocultas, en poses poco habituales o cerca de otros objetos complejos, el modelo reparte patrones con forma de dedo por el espacio disponible sin ninguna restricción anatómica. Seis dedos es algo frecuente. Nudillos fusionados, palmas que parecen sin huesos y manos sin una muñeca clara también aparecen con regularidad.
Las arquitecturas más recientes, entrenadas con conjuntos de datos de mayor resolución y cuidadosamente seleccionados, han reducido bastante este problema. Pero incluso los modelos más potentes actuales producen fallos en las manos bajo ciertas condiciones de composición, sobre todo cuando las manos interactúan con objetos pequeños, sujetan cosas o aparecen en ángulos poco habituales.
Arreglar las manos con inpainting
Insistir más con el prompt rara vez soluciona el problema. La solución más fiable es el inpainting: generas primero la imagen completa y luego enmascaras la zona de la mano y la regeneras con un prompt anatómico concreto. PicassoIA Image Editor Pro hace que este flujo sea directo, ya que dibujas una máscara sobre la zona problemática y la vuelves a generar mientras el resto de la imagen se mantiene intacto. Qwen Image Edit Plus ofrece una precisión de inpainting similar, con una buena conservación del detalle en el borde de la máscara.
💡 Consejo: Añade "cinco dedos, anatomía humana correcta, separación natural entre los dedos, sin dígitos extra" a cualquier prompt que muestre manos en primer plano. No elimina el problema, pero reduce de forma medible la tasa de fallos.
El mismo personaje, otra cara
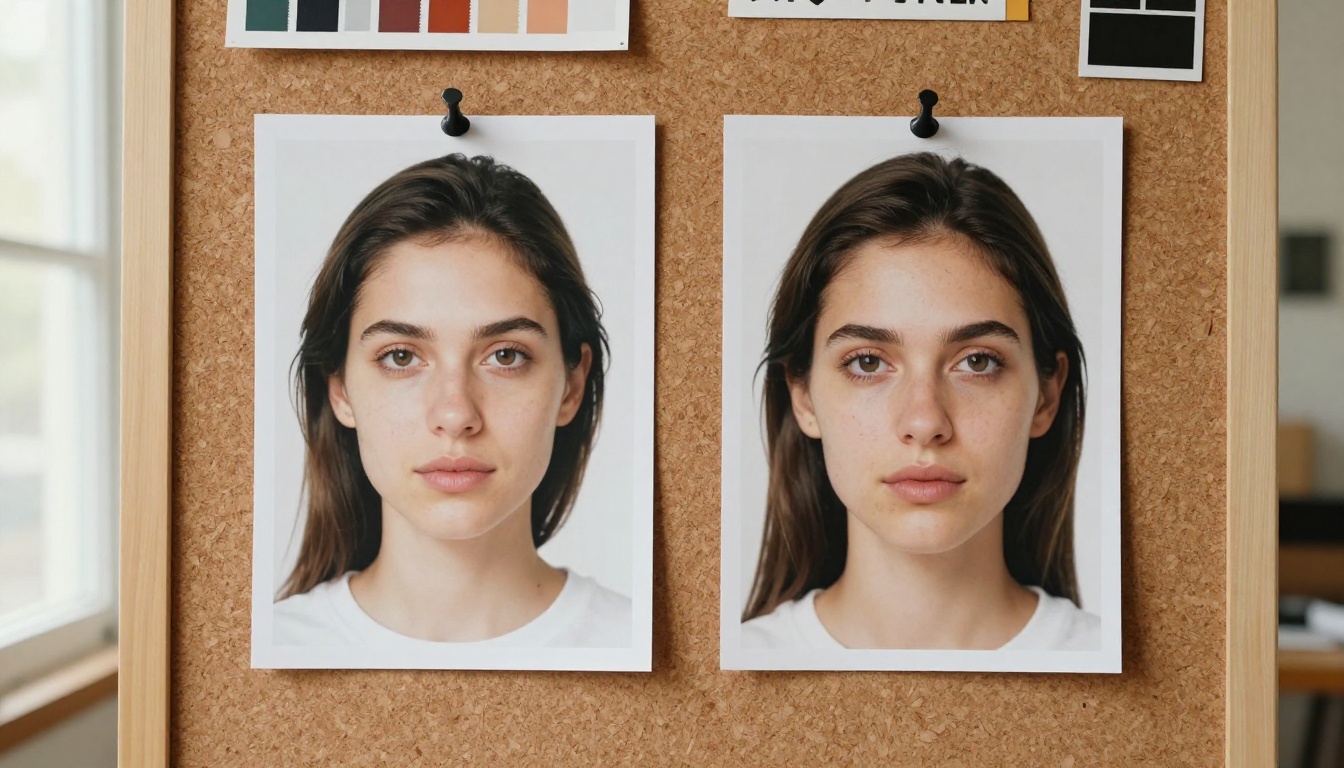
Generar el mismo personaje reconocible en varias imágenes es una de las capacidades más solicitadas en la generación de imágenes con IA, y una de las más difíciles de lograr con los modelos estándar de texto a imagen. Si escribes dos veces la misma descripción física obtienes dos personas distintas. Si cambias un solo adjetivo, el rostro vuelve a cambiar. No es un problema de habilidad al escribir prompts. Es una propiedad estructural de cómo los modelos de difusión generan cada imagen de forma independiente, desde cero.
El problema de la deriva de identidad
Cada imagen que produce un modelo de difusión parte de ruido aleatorio. No hay memoria de personajes entre generaciones. Incluso con descriptores físicos muy concretos (color exacto de los ojos, forma distintiva de la mandíbula, textura específica del cabello, una cicatriz única), el modelo muestrea de una distribución de probabilidad y produce una variación dentro de ese rango, en lugar de reproducir a un individuo fijo. Cuantas más generaciones hagas, más se aleja el rostro de la intención original.
Esto genera problemas concretos en campañas de producto, narrativa visual, personajes de marca y cualquier flujo de trabajo que necesite un sujeto recurrente reconocible. Una serie de imágenes de "la misma mujer" producida solo con prompts de texto parecerá un casting, no un personaje coherente a lo largo de las escenas.
Flux Redux Dev para variaciones estables
Flux Redux Dev aborda el problema de otra forma. Toma una imagen existente como referencia y genera variaciones visuales coherentes que conservan la identidad central del sujeto, su composición y su estilo. Es la vía más accesible para generar personajes coherentes sin entrenar un LoRA personalizado desde cero. En campañas que necesitan un rostro reconocible en varias escenas, usar Redux Dev con un único retrato de referencia sólido reduce de forma notable la deriva de identidad entre generaciones.
💡 Consejo: Genera primero un retrato ideal del personaje con tu modelo de mayor calidad. Después usa Flux Redux Dev para todas las variaciones de escena a partir de esa imagen ancla, en lugar de volver a escribir el prompt desde una descripción de texto cada vez.
Logotipos y marcas reales
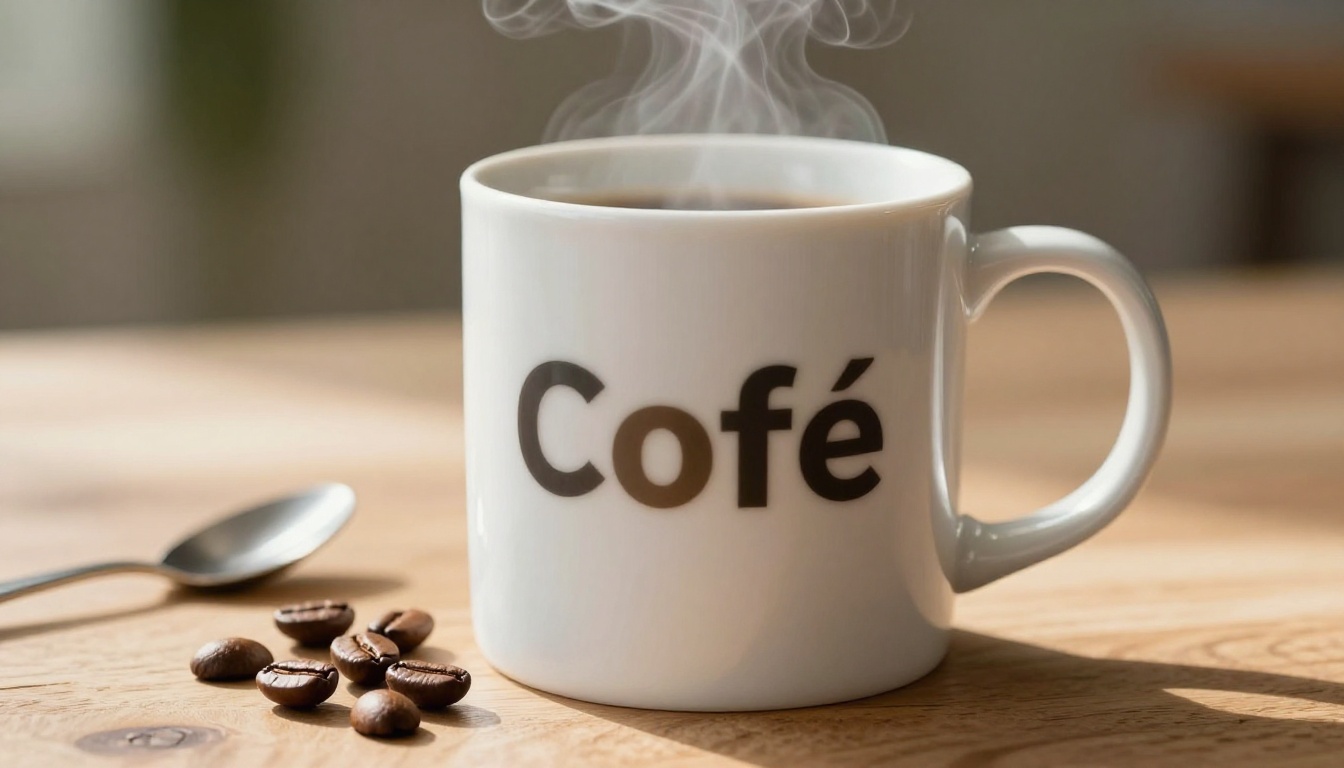
Los modelos de imágenes con IA no pueden reproducir con precisión logotipos registrados ni marcas comerciales reales. Esto refleja tanto una limitación legal incorporada en los procedimientos de entrenamiento como una técnica: los logotipos dependen de proporciones geométricas exactas, valores de color precisos y un espaciado de letras muy concreto, algo que el muestreo por difusión no puede reconstruir fielmente.
Qué pasa con las marcas registradas
Cuando pides un producto con un logotipo de marca real, el modelo produce una aproximación estética. La forma y el color parecen correctos a simple vista. Las letras se reconocen como casi correctas. Pero los caracteres se fusionan, las proporciones se desvían y falta la precisión geométrica que exige la fidelidad de marca. Los modelos se han entrenado con millones de imágenes que contienen marcas reales, pero durante el entrenamiento se han orientado para evitar la reproducción exacta, tanto por razones de derechos de autor como porque la fidelidad geométrica al píxel no es lo que optimiza el muestreo por difusión.
La solución para fotos de producto
La solución más limpia es separar por completo el paso de generación del paso de marca.
| Escenario | Mejor enfoque |
|---|
| Maqueta de producto con marca | Genera la forma del producto y la iluminación, y añade el logotipo en un programa de diseño |
| Foto de estilo de vida con un artículo de marca | Usa en el prompt una versión genérica del producto |
| Envase con texto en la etiqueta | Genera la forma y el material, y compón la etiqueta por separado |
| Imagen de campaña con producto real | Usa la IA para el entorno y el ambiente, y superpón una foto real del producto |
Seedream 4.5 destaca al generar superficies de producto limpias en 4K, con texturas de material precisas e iluminación controlada. Úsalo para establecer el entorno visual y después añade la marca exacta en Photoshop, Figma o cualquier otro programa de composición. El resultado parece idéntico a una imagen totalmente generada con IA, pero con una tipografía de marca fiel.
La lógica espacial no funciona
Coloca una pelota roja a la izquierda de un cubo azul. Muestra a dos personas con una tercera de pie entre ellas. Sitúa un objeto en primer plano mientras otro está justo detrás, en un ángulo concreto. Los modelos de difusión estándar fallan en todos estos casos con una regularidad frustrante. Los errores de razonamiento espacial son sistemáticos, no ocasionales.
Confusión entre izquierda y derecha
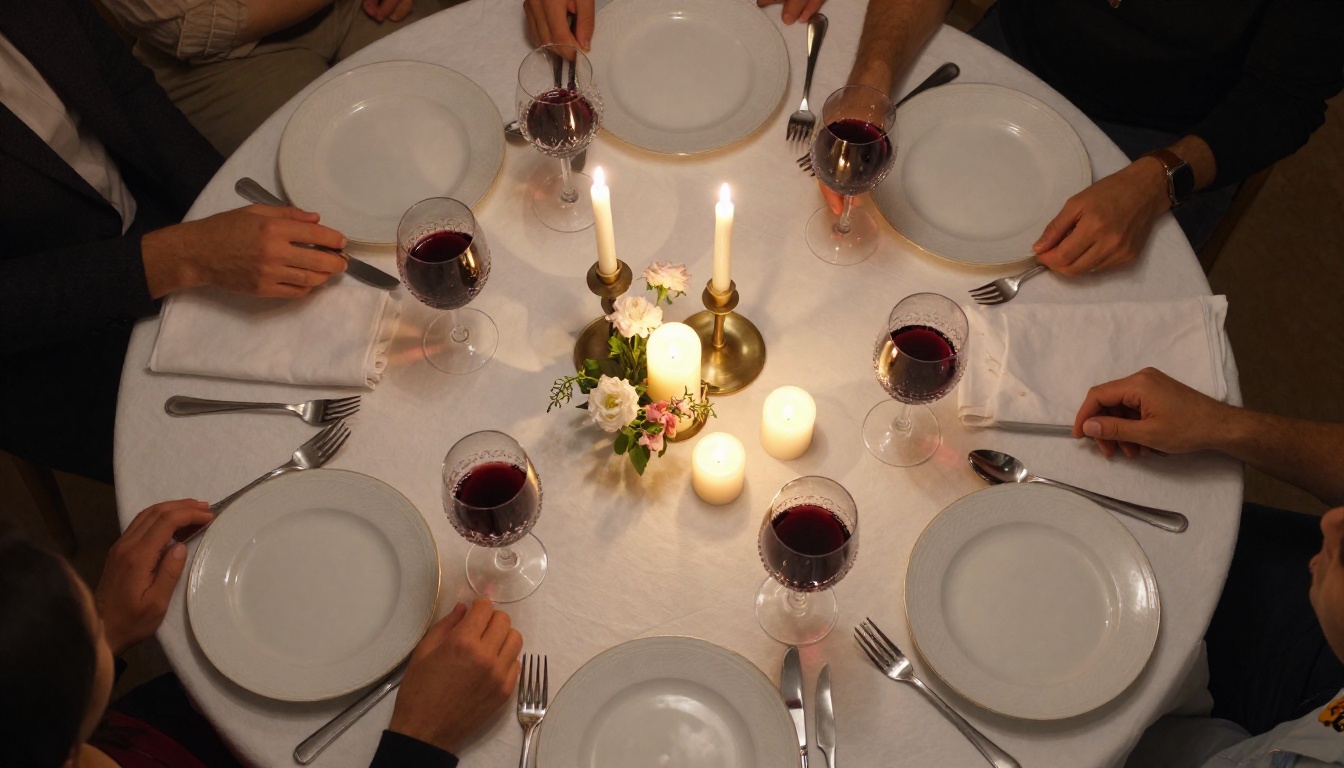
Los modelos de difusión funcionan mediante la eliminación de ruido a nivel de píxel, no mediante razonamiento espacial. "Izquierda" y "derecha" son conceptos relacionales abstractos que los modelos solo asocian en parte con estadísticas de composición absorbidas de los datos de entrenamiento. La asociación estadística existe, pero es débil. En la práctica, las posiciones izquierda-derecha se intercambian o quedan ambiguas aproximadamente la mitad de las veces.
El lenguaje relativo a la cámara suele funcionar mejor que los términos direccionales. "Objeto en primer plano", "elemento de fondo", "cerca de la cámara", "lejos del espectador" y "esquina superior derecha del encuadre" se conectan con más fiabilidad con los patrones de composición que el modelo ha interiorizado. Las palabras de posición ancladas al encuadre superan a las direcciones relacionales ancladas a sujetos dentro de la imagen.
Conteo y colocación
Contar es igual de poco fiable. "Tres perros" suele dar dos o cuatro. "Cinco personas en un grupo" rara vez produce exactamente cinco. "Un solo árbol a la derecha" a veces se convierte en dos árboles o en ninguno. El modelo no tiene ningún paso de verificación aritmética, así que reparte patrones de sujetos por el espacio disponible según lo que parezca compositivamente plausible con su distribución aprendida, no según el número que indicaba el prompt.
Lo que realmente ayuda:
- Describe las relaciones espaciales en lugar de posiciones absolutas: "La persona A está delante de la persona B, con B visible justo detrás del hombro de A"
- Usa términos anclados al encuadre: "centro del encuadre", "arriba a la derecha", "esquina inferior izquierda", "ocupando el primer plano"
- Genera varias variaciones y elige la que coincida con la disposición que buscabas
- Para composiciones en las que la precisión es crítica, usa el control estructural basado en ControlNet que ofrece PicassoIA Image para definir posiciones exactas de los objetos con un esqueleto de referencia o un mapa de profundidad
Detalle cultural y regional
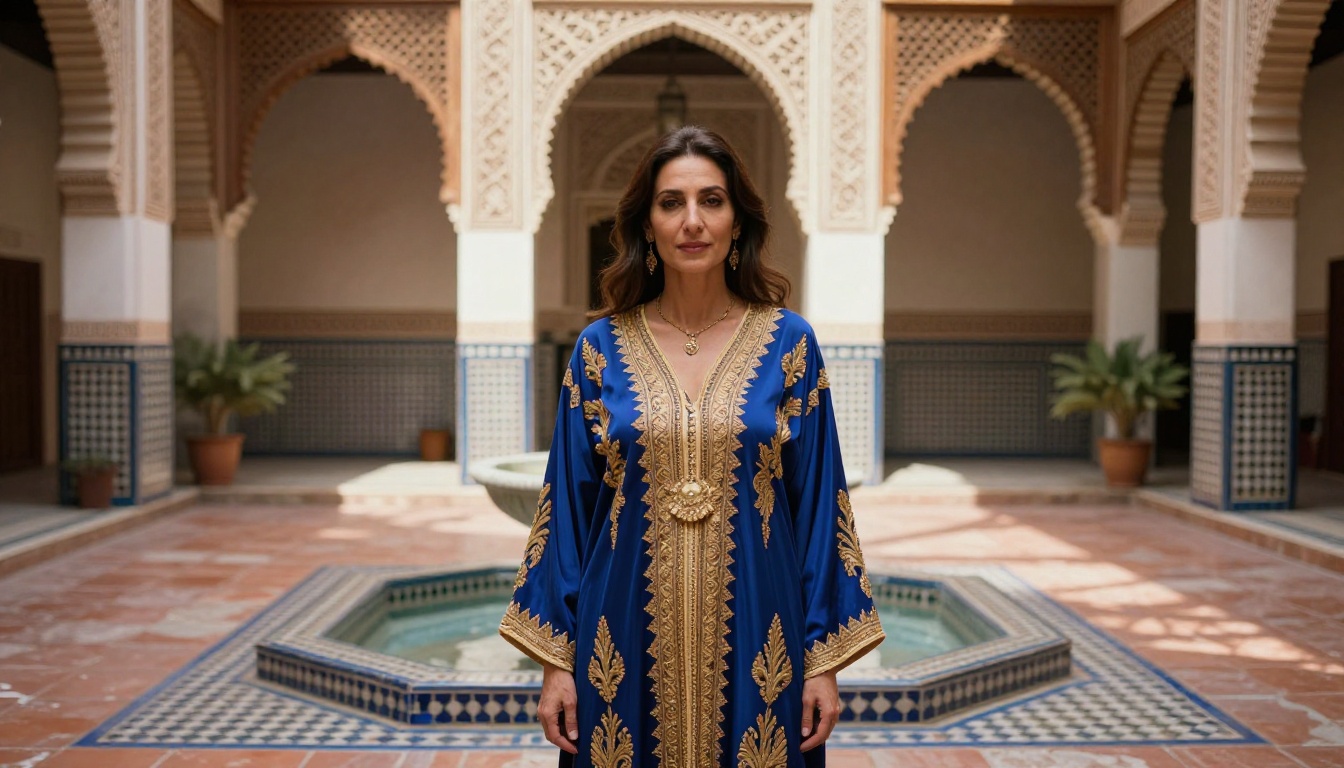
Los modelos entrenados sobre todo con datos de internet de Occidente trasladan ese sesgo a cada generación. Si pides "ropa tradicional", el resultado tiende al traje popular europeo. La arquitectura regional, los objetos ceremoniales, las escrituras no occidentales y los alimentos de cada cultura se representan con aproximaciones estereotipadas o, en algunos casos, con detalles visualmente verosímiles que en realidad no existen en la cultura de referencia.
El sesgo occidental en los datos de entrenamiento
La mayoría de los conjuntos de datos de imágenes a gran escala que se usan para entrenar modelos de IA se inclinan con fuerza hacia el contenido web en inglés, hacia bancos de fotos de stock dominados por sujetos y escenarios euroamericanos, y hacia redes sociales de mercados angloparlantes de altos ingresos. La consecuencia práctica es un modelo que ha visto muchos menos ejemplos de vestimenta ceremonial del África occidental, arquitectura rural del este de Asia, tejidos andinos o escenas de mercado centroamericanas que de un apartamento-estudio de Nueva York o un café callejero de París.
El resultado visible: menor precisión, aproximaciones visuales genéricas y, a veces, detalles visuales objetivamente incorrectos cuando los prompts salen de las zonas que el modelo tiene muy representadas. Una prenda tradicional puede parecer en líneas generales correcta en silueta y color, pero mostrar bordados que pertenecen a otra cultura o a otra época.
Lo que los prompts pueden y no pueden arreglar
La especificidad ayuda mucho. Nombrar la prenda exacta (caftán, hanbok, tela kente, huipil, ao dai), indicar la región y la época, e incluir detalles visuales concretos (azulejo zellige, bordado en índigo, patrón de tejido ikat, técnica de teñido específica) acerca el modelo a un terreno más preciso que las etiquetas culturales genéricas. Pero ningún prompt puede compensar una laguna fundamental en el volumen de datos de entrenamiento. Un modelo que ha visto muy pocos ejemplos de un objeto regional concreto alucinará detalles visuales verosímiles que simplemente son incorrectos.
En proyectos en los que la precisión cultural importa, contrasta el resultado de la IA con referencias fotográficas antes de usarlo en trabajos de cara al público. GPT Image 2 muestra una cobertura cultural notablemente más amplia gracias a sus datos de entrenamiento diversos, y funciona comparativamente mejor con temas no occidentales que los modelos entrenados con conjuntos de datos más homogéneos.
Lo que hacen realmente bien los mejores modelos actuales
Las limitaciones anteriores son reales, pero conviven con capacidades excepcionales de verdad. Los modelos de imágenes con IA actuales no son herramientas mediocres con unos cuantos buenos momentos. Son herramientas potentes con puntos ciegos estructurales concretos, y esos puntos ciegos son predecibles.
Donde los modelos actuales rinden de forma excepcional:
| Capacidad | Nivel de fortaleza |
|---|
| Iluminación y ambiente atmosférico | Excepcional |
| Piel, tejidos y texturas metálicas fotorrealistas | Excepcional |
| Naturaleza, paisajes y entornos abiertos | Excelente |
| Retrato fotográfico de un solo sujeto | Excelente |
| Diseño de interiores y arquitectura | Sólido |
| Aislamiento de productos sobre fondos limpios | Sólido |
| Imágenes abstractas y conceptuales | Sólido |
| Reproducción de tipografía y logotipos | Débil |
| Disposiciones espaciales complejas | Débil |
| Coherencia de personajes entre sesiones | Débil |
El flujo de trabajo de producción más sólido aprovecha estas fortalezas y rodea las debilidades en cada etapa.
PicassoIA Image Editor Pro cubre la capa de corrección: inpainting de manos defectuosas, outpainting de composiciones para ampliar el encuadre, sustitución de objetos concretos en una imagen por lo demás buena y recuperación de la calidad de detalle en las zonas problemáticas. Combinarlo con Hunyuan Image 2.1 para la generación base te da borradores de 2K de alta resolución con una textura detallada, y después correcciones puntuales en las zonas concretas que salgan mal.
El flujo de trabajo que realmente funciona
Intentar obtener una imagen perfecta con un solo prompt funciona de vez en cuando y falla a menudo. Un enfoque más fiable trata la generación y la edición como dos fases separadas:
- Genera una imagen base sólida con el modelo que elijas
- Identifica las zonas problemáticas: manos, texto, errores espaciales, deriva del personaje
- Usa inpainting para aislar y corregir cada zona problemática por separado, con un prompt específico
- Aplica escalado con superresolución si tu resultado final necesita dimensiones de impresión más grandes
- Compón después las marcas, el texto exacto o los logotipos específicos en un programa de diseño externo
Así se ajusta a cómo funciona la tecnología en realidad, en lugar de luchar contra sus propiedades estructurales.
Empieza a crear teniendo en cuenta los límites reales
Saber lo que un modelo de imágenes con IA todavía no puede hacer no es un motivo para usarlo menos. Es un motivo para usarlo más rápido y con bastante menos frustración. La distancia entre "lo que describía el prompt" y "lo que entregó el modelo" se cierra rápido cuando sabes dónde esperar la deriva y qué herramienta usar en cada etapa.
PicassoIA reúne más de 90 modelos de texto a imagen junto con herramientas de edición, escalado con superresolución, intercambio de rostros y generación de video en una misma plataforma. Ya sea que estés corrigiendo la anatomía con PicassoIA Image Editor Pro, colocando tipografía legible con Riverflow 2.0 Pro, manteniendo la coherencia del personaje con Flux Redux Dev o generando retratos en 4K con Seedream 4.5, la herramienta adecuada para cada limitación concreta ya está disponible.
Los modelos de imágenes con IA todavía no llegan a un resultado impecable y totalmente controlado en cada prompt. Pero hoy son lo bastante capaces como para que reconocer su límite haga que cada flujo de trabajo creativo sea más rápido, no más lento.
Elige un prompt, elige un modelo y empieza a generar. Las soluciones son más fáciles de lo que parecen.