आपके पास दादी की एक फ़ोटो है जिसमें वे 1994 की एक शादी में खिलखिलाकर हँस रही हैं, और आपके पास उनका पसंदीदा गाना है। कुछ साल पहले इन दोनों को जोड़ने के लिए एक वीडियो एडिटर, बहुत धैर्य चाहिए था, और नतीजा अक्सर ऐसा होता था जो किसी फिरौती वाले नोट जैसा जीवंत होकर दिखता था। आज एक मुफ़्त में ऑनलाइन आज़माने वाला AI लिप सिंक वीडियो जनरेटर ऑडियो को पढ़ता है, चेहरे का अध्ययन करता है और होंठ, गाल और भौहें इस तरह हिलाता है कि तस्वीर वाला व्यक्ति हर शब्द गाता हुआ लगे। यह लेख बताता है कि कौन से मॉडल यह सबसे अच्छा करते हैं, फ़ोटो और गाने को कैसे तैयार करें, और उन गड़बड़ियों को कैसे ठीक करें जो ज़्यादातर पहली कोशिशों को बिगाड़ देती हैं।
💡 छोटा तरीका: एक साफ़, सामने से ली गई फ़ोटो चुनें, ऑडियो को 35 सेकंड से छोटा रखें, और दोनों को PicassoIA पर Omni Human 1.5 या Fabric 1.0 से चलाएँ। नीचे की हर बात इसी पहली कोशिश को अच्छा बनाने के बारे में है।
लिप सिंक जनरेटर क्या करता है
एक लिप सिंक जनरेटर एक इमेज-टू-वीडियो मॉडल है, जिसमें एक अतिरिक्त खूबी है: वह सुनता है। आप उसे एक स्थिर तस्वीर और एक ऑडियो फ़ाइल देते हैं, और वह एक छोटा क्लिप बनाता है जिसमें मुँह के आकार बोले जा रहे अक्षरों से मेल खाते हैं, जबड़ा और गाल लय के साथ चलते हैं, और सिर छोटी-छोटी स्वाभाविक हरकतें करता है। कुछ टूल्स पलकें झपकाना, भौंहें उठाना और कंधों की हरकत भी जोड़ते हैं, ताकि क्लिप कठपुतली जैसा न लगे।
एक फ़ोटो, एक ऑडियो फ़ाइल
इसकी विधि हमेशा दो सामग्रियों से बनती है। फ़ोटो पहचान देती है: चेहरे का आकार, त्वचा, बाल, कपड़े, बैकग्राउंड। ऑडियो प्रस्तुति देता है: समय, आवाज़ का उतार-चढ़ाव, साँस। इन दोनों के बीच का कठिन काम मॉडल ही करता है, यानी यह अनुमान लगाता है कि वही चेहरा ठीक उसी ध्वनि के साथ कैसे हिलेगा।
इसीलिए एक ही टूल से दादी लोरी गा सकती हैं, कंपनी का मैस्कॉट किसी उत्पाद की घोषणा पढ़ सकता है, या कोई पुरानी पारिवारिक तस्वीर स्पैनिश में जन्मदिन की शुभकामनाएँ दे सकती है। उदाहरण के लिए, Omni Human 1.5 अंग्रेज़ी, स्पैनिश, जापानी, कोरियाई, चीनी और इंडोनेशियाई में वॉइसओवर स्वीकार करता है, और यह चेहरों, पूरे शरीर वाली तस्वीरों और यहाँ तक कि इलस्ट्रेटेड किरदारों के साथ भी काम करता है।
"मुफ़्त" असल में कहाँ लागू होता है
इस श्रेणी में मुफ़्त का मतलब लगातार बदलता रहता है। PicassoIA Fabric 1.0 को ऑनलाइन आज़माने के लिए मुफ़्त बताता है, और इसमें कोडिंग या कैमरा सेटअप की ज़रूरत नहीं होती। मुफ़्त उपयोग की सीमाएँ बदलती रहती हैं, इसलिए किसी बड़े बैच की योजना बनाने से पहले मॉडल पेज देख लें। जो स्थिर रहता है वह है इसका आर्थिक गणित: एक गाती हुई फ़ोटो में फ़िल्म क्रू की जगह बस कुछ मिनटों का इंतज़ार लगता है, और आपका असली खर्च सिर्फ़ एक अच्छी मूल फ़ोटो और एक अच्छी ऑडियो फ़ाइल होता है।
लोग गाती हुई फ़ोटो क्यों बनाते हैं
गाने वाले पोर्ट्रेट कोई ऐसा दिखावा नहीं हैं जो एक हफ़्ते बाद फीका पड़ जाए। वे तीन अलग समूहों की तीन अलग समस्याएँ हल करते हैं, और हर समूह इस टूल को थोड़े अलग ढंग से इस्तेमाल करता है।
जन्मदिन और उपहार
एक निजी उपहार इसलिए काम करता है क्योंकि उसमें ऐसे ब्योरे होते हैं जिन्हें कोई और नहीं दोहरा सकता। शादी की पारिवारिक फ़ोटो लीजिए, पूरे परिवार के गाने की रिकॉर्डिंग जोड़िए, और नतीजा एक ऐसी क्लिप होगी जो पूरी शाम बार-बार चलाई जाएगी। स्मृति-वीडियो भी इसी तरह काम करते हैं: किसी पसंदीदा गाने के साथ जोड़ा गया पोर्ट्रेट, जिसे धीरे-धीरे एनिमेट किया गया हो, अक्सर स्लाइडशो से ज़्यादा असर करता है।
⚠️ अनुमति मायने रखती है। केवल उन्हीं चेहरों को एनिमेट करें जिनके इस्तेमाल का अधिकार आपके पास हो, और उन्हें केवल ऐसे संगीत के साथ जोड़ें जो आपका अपना हो या जिसे आपने खुद बनाया हो। परिवार के किसी सदस्य के लिए बनाई गई सम्मानजनक क्लिप और किसी अजनबी के मुँह में शब्द डालना बिल्कुल अलग बातें हैं।
कंटेंट क्रिएटर
शॉर्ट-फ़ॉर्म वीडियो नयेपन को इनाम देता है, और एक फ़ोटो जो अचानक गाने लगे, वह अब भी स्क्रॉल रोकने वाली चीज़ है। क्रिएटर इसे इंट्रो स्टिंगर, किरदार वाले चैनल, म्यूज़िक टीज़र और रिएक्शन फ़ॉर्मैट के लिए इस्तेमाल करते हैं। सबसे बड़ा फ़ायदा दोहराव का है: एक बार जब आपको कोई किरदार-पोर्ट्रेट पसंद आ जाए, तो आप ऑडियो बदलकर हर दिन नई क्लिप बना सकते हैं, बिना कुछ फ़िल्माए।
संगीतकार और डेमो
स्वतंत्र कलाकार शूट पर पैसा खर्च करने से पहले गाने का पूर्वावलोकन दिखाने के लिए गाती हुई फ़ोटो का इस्तेमाल करते हैं। एल्बम का पोर्ट्रेट, कोई स्टाइलाइज़्ड किरदार या मैस्कॉट टीज़र के तौर पर कोरस गा सकता है। यह सस्ता और तेज़ है, और जब तक असली म्यूज़िक वीडियो सिर्फ़ योजना में है, तब तक यह प्रशंसकों को गाने से जोड़ने के लिए एक चेहरा देता है।
शिक्षक और भाषा ट्यूटर भी कुछ ऐसा ही करने लगे हैं। एक छोटी तुकबंदी या शब्दावली वाला गाना रिकॉर्ड करें, एक दोस्ताना किरदार-पोर्ट्रेट को एनिमेट करें, और छात्रों को एक ऐसा गाने वाला शिक्षक मिल जाता है जो कभी थकता नहीं। ऑडियो को दूसरी भाषा में बदलने से वही चेहरा दोबारा काम आता है, इसलिए एक ही पोर्ट्रेट अलग-अलग स्तर के छात्रों वाली पूरी कक्षा को सेवा दे सकता है।
सही मॉडल चुनें
PicassoIA पर 12 लिपसिंक मॉडल सूचीबद्ध हैं, और वे दो खेमों में बँटते हैं: वे टूल जो एक फ़ोटो से शुरू होते हैं, और वे जो एक मौजूदा वीडियो से शुरू होते हैं। गाती हुई फ़ोटो के लिए आपको पहला खेमा चाहिए।
फ़ोटो से गाने वाले मॉडल
| मॉडल | आप क्या देते हैं | किसके लिए सबसे अच्छा | उल्लेखनीय सेटिंग्स |
|---|
| Omni Human 1.5 | फ़ोटो + 35 सेकंड से छोटा ऑडियो | यथार्थवादी चेहरे, गाना, पूरे शरीर वाले शॉट | वैकल्पिक प्रॉम्प्ट, फ़ास्ट मोड, सीड |
| Fabric 1.0 | फ़ोटो + ऑडियो | तेज़ स्पोकपर्सन और गाने वाली क्लिप | 480p या 720p |
| P Video Avatar | फ़ोटो + टाइप की हुई स्क्रिप्ट या ऑडियो | बिल्ट-इन आवाज़ों वाले बोलते अवतार | 30+ आवाज़ें, 10 भाषाएँ, 1080p तक |
| Omni Human | फ़ोटो + ऑडियो | एक फ़ोटो से बोलते वीडियो | मूल Omni Human मॉडल |
अगर आपका मुख्य उद्देश्य वह मुख्य उपयोग है, यानी एक चेहरा जो असली गाना गाए, तो Omni Human 1.5 से शुरू करें। इसके प्रकाशित उदाहरणों में "A woman sings and strums her guitar" जैसा सीधा प्रॉम्प्ट है, जो एक WAV फ़ाइल के साथ जोड़ा गया है, और प्रॉम्प्ट फ़ील्ड से आप दृश्य, कैमरा और शरीर की हरकत को दिशा दे सकते हैं। Fabric 1.0 तब तेज़ रास्ता है जब आपको केवल इतना चाहिए कि मुँह ऑडियो का पालन करे, और आपको एक साफ़ 720p फ़ाइल चाहिए।
P Video Avatar अलग है: आप सटीक शब्द टाइप कर सकते हैं और आवाज़ चुन सकते हैं, या अपना ऑडियो अपलोड कर सकते हैं। गानों की तुलना में बोलने वाली क्लिप के लिए यह बेहतर विकल्प है, लेकिन इसका video_prompt फ़ील्ड यह बताने में काम आता है कि बोलते समय व्यक्ति कैसा दिखे।
वीडियो से वीडियो के विकल्प
अगर आपके पास पहले से उस व्यक्ति की क्लिप है और आप केवल ऑडियो बदलना चाहते हैं, तो ये मॉडल स्थिर तस्वीर की जगह वीडियो पर काम करते हैं:
💡 मोटा नियम: स्थिर फ़ोटो इनपुट, गाती क्लिप आउटपुट के लिए Omni Human 1.5 या Fabric 1.0 लें। चलता वीडियो इनपुट, नया ऑडियो आउटपुट के लिए Sync, Kling या HeyGen मॉडल में से कोई एक लें।
एक मज़बूत फ़ोटो से शुरुआत करें
स्रोत फ़ोटो ज़्यादातर नतीजा तय करती है। कमज़ोर फ़ोटो को बेहतर ऑडियो फ़ाइल नहीं बचा सकती, इसलिए जनरेट दबाने से पहले यहाँ पाँच मिनट लगाएँ।
चेहरा अच्छी तरह सिंक कैसे होता है
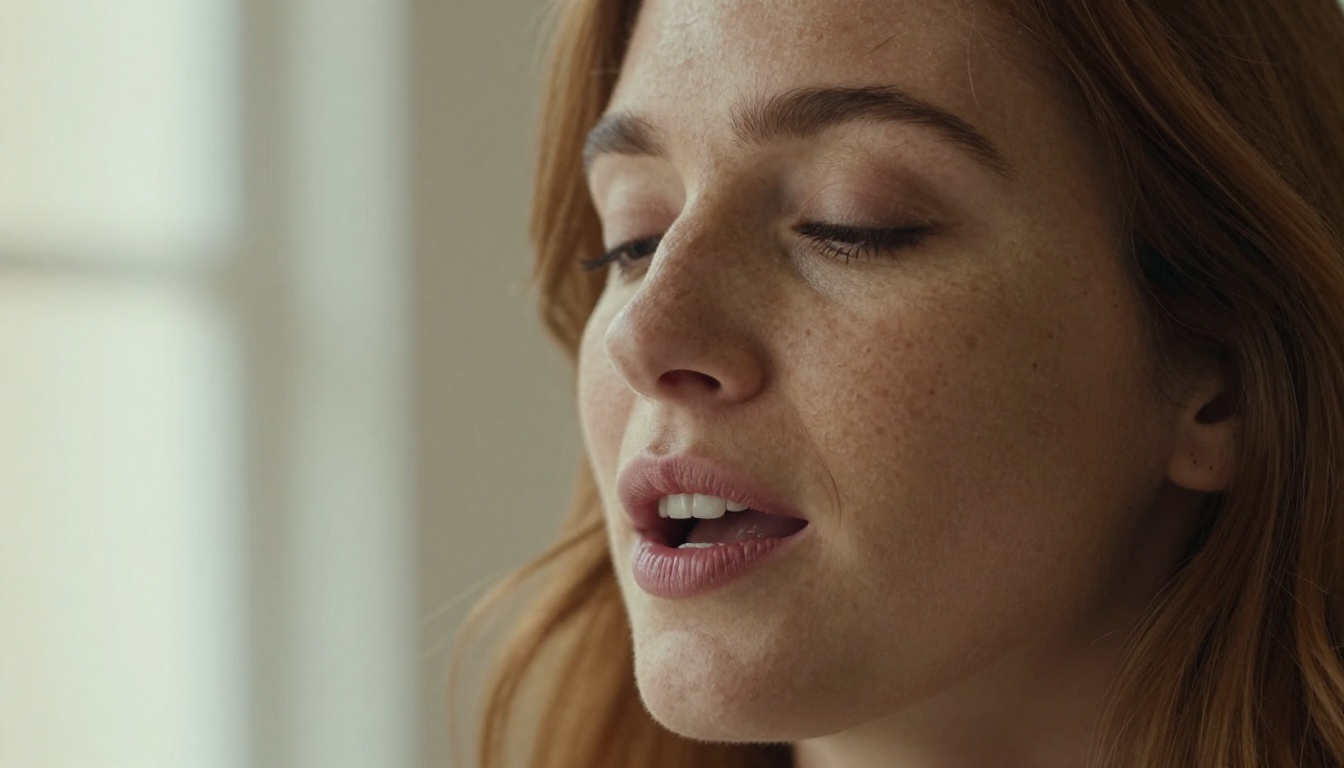
- सामने से या हल्के तीन-चौथाई कोण से। मॉडल को मुँह के दोनों कोने देखने होते हैं।
- दिखते होंठ और दाँत। थोड़ा खुला, आराम वाला मुँह मॉडल को कसे हुए, बंद होंठों से ज़्यादा सामग्री देता है।
- चेहरे पर समान रोशनी। नरम खिड़की की रोशनी उन कठोर ऊपरी छायाओं से बेहतर है जो जबड़े को छिपा देती हैं।
- आँखों और मुँह पर तेज़ फ़ोकस। अगर चेहरा केवल 80 पिक्सेल चौड़ा है, तो नतीजा धुंधला दिखेगा।
- सिर के चारों ओर साफ़ जगह। बाल, हाथ और माइक्रोफ़ोन जो ठुड्डी पर आ जाएँ, मुँह के क्षेत्र को उलझा देते हैं।
जो फ़ोटो असफल होती हैं
ग्रुप शॉट जिनमें हर चेहरा छोटा हो, धूप के चश्मे जो आधा चेहरा छिपा दें, हाथ जो मुँह को ढकें, बहुत तिरछी साइड प्रोफ़ाइल और भारी कंप्रेस्ड स्क्रीनशॉट, ये सब रबर जैसे नतीजे देते हैं। अगर आपके पास केवल कम रिज़ॉल्यूशन वाला पारिवारिक स्कैन है, तो पहले उसे सुपर-रिज़ॉल्यूशन मॉडल से चलाएँ। जितना तेज़ चेहरा अंदर जाए, उतना ही तेज़ बाहर आता है।
पुरानी ब्लैक-एंड-व्हाइट पोर्ट्रेट का अलग ज़िक्र ज़रूरी है। ये अक्सर बहुत अच्छी तरह सिंक होती हैं, क्योंकि कॉन्ट्रास्ट ज़्यादा होता है और रोशनी सरल होती है, लेकिन फ़िल्म का दाना और खरोंचें शोर की तरह दिख सकती हैं। धूल हटाने और आँखों को तेज़ करने वाला एक त्वरित रेस्टोरेशन पास लिप सिंक मॉडल को एनिमेट करने के लिए शांत सतह देता है, और अंतिम क्लिप कहीं कम झटकेदार लगती है।
गाना या आवाज़ बनाएँ
ऑडियो फ़ाइल रेसिपी का दूसरा हिस्सा है, और यही वह हिस्सा है जिसमें ज़्यादातर लोग जल्दबाज़ी करते हैं। साफ़ वोकल्स से साफ़ मुँह के आकार बनते हैं। तेज़ ड्रम और दबे हुए गायक वाला गंदा मिक्स मॉडल को पालन करने के लिए बहुत कम देता है।
गाना लिखें
आपको रिकॉर्डिंग स्टूडियो की ज़रूरत नहीं है, और आवाज़ की भी नहीं। PicassoIA पर संगीत मॉडलों का पूरा परिवार है जो टेक्स्ट प्रॉम्प्ट से ट्रैक बनाते हैं:
छोटे बोल लिखें, शैली और मूड बताएँ, और दो या तीन वर्ज़न बनाएँ। वह चुनें जिसमें वोकल वाद्यों से साफ़ ऊपर सुनाई दे।
आवाज़ रिकॉर्ड करें या बनाएँ
अगर आप गाने के बजाय बोलना चाहते हैं, तो स्टूडियो-क्वालिटी वॉइसओवर के लिए Speech 2.8 HD जैसा टेक्स्ट-टू-स्पीच मॉडल, 70+ भाषाओं में 30 आवाज़ों के लिए Gemini 3.1 Flash TTS, या प्राकृतिक अदायगी के लिए ElevenLabs v3 इस्तेमाल करें। शांत कमरे में फ़ोन से की गई रिकॉर्डिंग भी काम करती है, बशर्ते उसमें गूंज या पृष्ठभूमि की बातचीत न हो।
अपलोड से पहले काटें। Omni Human 1.5 35 सेकंड से लंबा ऑडियो स्वीकार नहीं करता, इसलिए अपने ट्रैक को सबसे अच्छे 20 से 30 सेकंड तक काटें, आमतौर पर कोरस। लंबे गाने के लिए उसे टुकड़ों में बाँटें, हर टुकड़े को एक ही फ़ोटो और एक ही सीड के साथ जनरेट करें, और क्लिप्स को किसी भी वीडियो एडिटर में जोड़ दें।
Omni Human 1.5 कैसे इस्तेमाल करें
यह रहा खाली पन्ने से लेकर तैयार गाती क्लिप तक का पूरा वर्कफ़्लो। यही पैटर्न बाकी फ़ोटो मॉडलों पर भी लागू होता है, बस सेटिंग्स बदलती हैं।
PicassoIA पर छह चरण
- PicassoIA पर Omni Human 1.5 पेज खोलें।
- अपनी इमेज अपलोड करें: दिखते चेहरे वाला एक साफ़ पोर्ट्रेट।
- अपना ऑडियो अपलोड करें: 35 सेकंड से छोटी MP3 या WAV फ़ाइल।
- दृश्य को दिशा देने के लिए एक वैकल्पिक प्रॉम्प्ट जोड़ें, जैसे "She sings softly with a warm smile, slight head movement, camera holds steady."
- फ़ास्ट मोड तय करें। त्वरित ड्राफ़्ट के लिए इसे चालू करें, सबसे अच्छे डिटेल के लिए बंद।
- जनरेशन चलाएँ, क्लिप देखें और डाउनलोड करें। अगर नतीजा पसंद है पर एक छोटा बदलाव चाहिए, तो सीड दोबारा इस्तेमाल करें ताकि बाकी हिस्सा स्थिर रहे।
चरण 4 में आज़माने के लिए प्रॉम्प्ट के विचार:
- "She sings the chorus with her eyes closed, small nods on the beat, camera slowly pushes in."
- "A man sings to the camera with a relaxed smile, shoulders swaying gently, soft indoor light."
- "The child laughs between lines and sings with big expressions, handheld camera feel."
- "Calm, steady shot, minimal head movement, natural blinking." (गंभीर या स्मृति वाली क्लिप के लिए सबसे अच्छा)
प्रॉम्प्ट को एक या दो वाक्यों तक रखें। अदायगी, शरीर की हरकत और कैमरा बताएँ, और मुँह को ऑडियो के हवाले छोड़ दें। प्रॉम्प्ट को ज़रूरत से ज़्यादा निर्देश देने से वह लिप सिंक की मदद करने के बजाय उससे लड़ने लगता है।
कुछ सेकंड नहीं, कुछ मिनट इंतज़ार की उम्मीद रखें। मॉडल पेज पर प्रकाशित उदाहरण जनरेशन में फ़ास्ट मोड चालू होने पर लगभग तीन से छह मिनट लगे, इसलिए अपनी कोशिशों को कतार में लगाएँ और रेंडर होने के दौरान कोई और काम करें।
त्वरित क्लिप के लिए Fabric 1.0
Fabric 1.0 का एक और भी छोटा रूप है: इमेज अपलोड करें, ऑडियो अपलोड करें, और गति के लिए 480p या अंतिम संस्करण के लिए 720p चुनें। लिखने के लिए कोई प्रॉम्प्ट नहीं है, जो इसे तब अच्छा विकल्प बनाता है जब आपको भरोसेमंद मुँह सिंक चाहिए और उसके अलावा कुछ नहीं। इसके मॉडल पेज के अनुसार यह ऑडियो को शब्दांश-दर-शब्दांश पढ़ता है, और एक प्रकाशित उदाहरण लगभग तीन मिनट में रेंडर हुआ।
टाइप की हुई स्क्रिप्ट के लिए P Video Avatar
P Video Avatar ऑडियो वाले चरण को छोड़ देता है। वॉइस स्क्रिप्ट टाइप करें, 30+ आवाज़ों में से एक चुनें, उपलब्ध दस भाषाओं में से एक भाषा चुनें, और रिज़ॉल्यूशन 720p या 1080p रखें। स्वर और गति के लिए वॉइस प्रॉम्प्ट का इस्तेमाल करें ("warm, slow, cheerful"), और बोलते समय व्यक्ति कैसा बर्ताव करे, इसके लिए वीडियो प्रॉम्प्ट। अगर आपके पास इसकी जगह कोई रिकॉर्डिंग है, तो उसे अपलोड करें, और बिल्ट-इन आवाज़ को दरकिनार कर दिया जाएगा।
आम समस्याएँ ठीक करें
लगभग हर खराब नतीजा कुछ गिने-चुने कारणों में से किसी एक तक जाता है। दोबारा चलाने से पहले यह तालिका देखें।
| समस्या | संभावित कारण | समाधान |
|---|
| मुँह मुश्किल से हिलता है | फ़ोटो में होंठ छिपे, छोटे या छायादार हैं | मुँह दिखने वाली तेज़ फ़ोटो का इस्तेमाल करें |
| जनरेशन तुरंत विफल हो जाता है | Omni Human 1.5 पर 35 सेकंड से लंबा ऑडियो | ऑडियो काटें या बाँटें |
| होंठ बीट से भटकते हैं | तेज़ वाद्यों वाला घना मिक्स | साफ़ वोकल या गाने का दूसरा वर्ज़न इस्तेमाल करें |
| सिर घूमने पर चेहरा टेढ़ा हो जाता है | बहुत तिरछा कोण या ढका हुआ चेहरा | सामने से लिया पोर्ट्रेट इस्तेमाल करें |
| क्लिप कठोर लगती है | हरकत के लिए कोई निर्देश नहीं | अदायगी और सिर की हरकत बताने वाला छोटा प्रॉम्प्ट जोड़ें |
| दाँत या होंठ अजीब लगते हैं | कम रिज़ॉल्यूशन वाला स्रोत | पहले फ़ोटो अपस्केल करें, फिर दोबारा कोशिश करें |
💡 पहले छोटा टेस्ट करें। पहले 10 सेकंड का अंश फ़ास्ट मोड में या 480p पर चलाएँ। अगर मुँह अच्छी तरह ट्रैक हो रहा है और चेहरा स्थिर रहता है, तभी पूरे 30 सेकंड को ऊँची क्वालिटी में लंबा रेंडर करें। हर असफल कोशिश पर आपका समय बचेगा।
कुछ आदतें उस क्लिप में फ़र्क डालती हैं जो ठीक लगती है और उसमें जो लोग शेयर करते हैं:
- हर प्रोजेक्ट के लिए एक किरदार की फ़ोटो रखें। क्लिप्स में एकरूपता पहचान बनाती है।
- मूड को संगीत से मिलाएँ। मुस्कुराते पोर्ट्रेट पर दुखद बैलेड अजीब लगता है, इसलिए ऐसी फ़ोटो चुनें जिसका भाव मेल खाए।
- ऑडियो में हल्का पॉलिश जोड़ें। सूखे वोकल पर थोड़ा रीवर्ब अंतिम क्लिप को असली प्रदर्शन जैसा महसूस कराता है।
- पहले और आखिरी सेकंड पर ध्यान दें। अपने एडिटर में किसी भी अजीब शुरुआत या अंत को काट दें।
आज ही अपनी फ़ोटो को गाने दें
इस लेख में बताई हर चीज़ में आपके सोचे हुए समय से कम समय लगता है। एक पोर्ट्रेट चुनें, 20 सेकंड का कोरस लिखें या जनरेट करें, और दोनों को Omni Human 1.5 या Fabric 1.0 से चलाएँ। आपकी पहली क्लिप परफ़ेक्ट नहीं होगी, और यह ठीक है। दूसरी, बेहतर फ़ोटो और काटे गए गाने के साथ, आमतौर पर अच्छी बन जाती है।
PicassoIA पूरी श्रृंखला को एक जगह देता है: पोर्ट्रेट के लिए इमेज जनरेशन, आवाज़ के लिए म्यूज़िक और टेक्स्ट-टू-स्पीच मॉडल, और चेहरे में जान डालने के लिए लिपसिंक मॉडल। पोर्ट्रेट बनाएँ, उसे एक गाना दें, और नतीजा उस व्यक्ति तक पहुँचाएँ जिसके लिए वह बनाया गया था। हर मॉडल picassoia.com/en/all-models पर देखें और जानें कि आपकी पसंदीदा फ़ोटो कैसी आवाज़ में गाती है।


