A maioria das pessoas digita uma descrição, clica em gerar e torce para dar certo. Assim não se chega a resultados dignos de serem compartilhados. O verdadeiro poder de qualquer gerador de imagens com IA está em recursos que nunca aparecem nos tutoriais básicos, escondidos em menus de configuração ou dentro de uma sintaxe que parece confusa à primeira vista. Este artigo explica os truques que separam imagens esquecíveis de imagens que param as pessoas no meio da rolagem.
Prompts negativos não são opcionais
A maioria dos usuários pula os prompts negativos por completo. Isso é um erro. Prompts negativos dizem ao modelo o que excluir e, usados corretamente, eliminam os artefatos mais comuns da IA antes que eles tenham chance de aparecer.
As frases que realmente funcionam
Prompts negativos genéricos como "qualidade ruim" quase não fazem efeito. Os que funcionam são específicos. Aqui está uma base comprovada:
💡 Copie este prompt negativo: deformed hands, extra fingers, blurry face, oversaturated, flat lighting, cartoon, illustration, painting, low resolution, watermark, text overlay, noise, grain artifacts, overexposed
Cada modelo responde de um jeito. O Flux 1.1 Pro lida com prompts negativos de forma diferente do Stable Diffusion 3.5 Large. Com modelos baseados em Flux, o prompt positivo carrega a maior parte do peso. Com modelos derivados do SDXL, como o SDXL, o prompt negativo tem muito mais influência no resultado final. A regra prática: escreva prompts negativos mais curtos para o Flux e mais longos e explícitos para o SDXL e o Stable Diffusion.
A sintaxe de atenção muda tudo
A maioria dos geradores aceita uma sintaxe de ponderação dentro do próprio prompt. Em vez de escrever "uma mulher com cabelo ruivo", você escreve a woman with (red hair:1.5) para dar ênfase, ou (red hair:0.6) para reduzir a ênfase. O número ajusta a atenção do modelo sobre aquela expressão.
É assim que prompters profissionais controlam iluminação, traços faciais e detalhes do fundo sem reescrever a cena inteira. Um prompt como:
(cinematic lighting:1.4), a woman in a café, (blurred background:1.2), (sharp face detail:1.5), natural skin texture
produz resultados consistentemente melhores do que a mesma frase escrita de forma plana, sem nenhuma ponderação de atenção. O modelo não está apenas lendo suas palavras, ele está lendo a importância relativa delas.
Os números de seed são sua ferramenta mais subutilizada
Toda imagem gerada tem um seed: um número que controla o padrão de ruído aleatório com que o modelo começa. Mude o seed e você obtém outra imagem. Mantenha o mesmo seed, altere apenas uma palavra do prompt, e você terá uma variação controlada da mesma composição.
Reutilize seeds para personagens consistentes
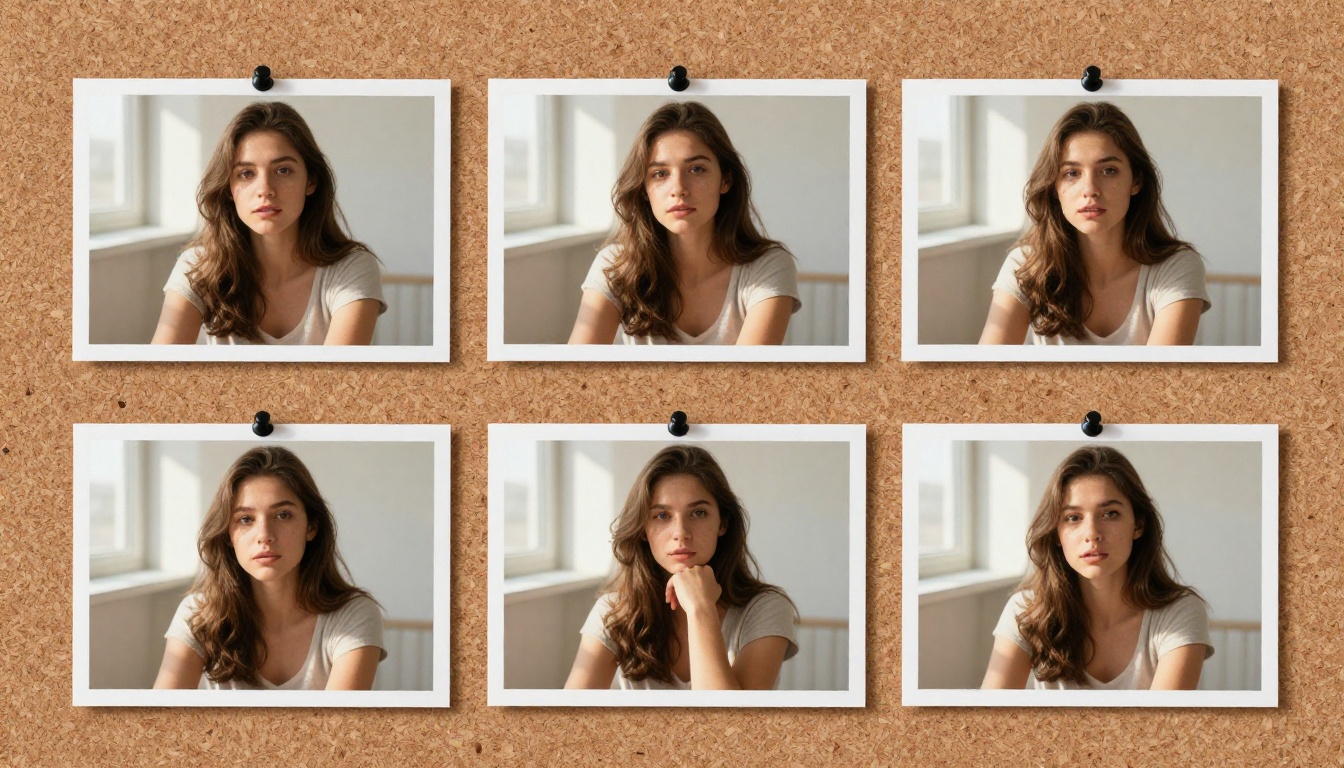
É esse truque que está por trás da maioria dos fluxos de trabalho de "folha de personagem" e "persona consistente". Veja como funciona:
- Gere uma imagem de que você goste. Anote o seed imediatamente.
- Use esse mesmo seed com um prompt modificado: fundo diferente, pose diferente, a mesma descrição central do personagem.
- O modelo ancora muitos traços de identidade ao seed, produzindo uma consistência reconhecível entre os resultados.
Não é perfeito, mas, combinado com uma descrição de personagem travada, traz a consistência dos resultados perto o bastante para narrativas sequenciais, maquetes de produtos ou identidades visuais de marca. Modelos como o Flux 1.1 Pro Ultra e o GPT Image 1.5 apresentam um comportamento de consistência por seed especialmente forte em comparação com arquiteturas mais antigas.
💡 Dica de ouro: copie o seed de um ótimo resultado imediatamente. A maioria das interfaces o exibe só por um instante. Se você perdê-lo, não conseguirá recriar a imagem exata.
Variação de seed: encontre novos estilos rapidamente
Em vez de reescrever o prompt repetidamente, mantenha-o fixo e itere pelos seeds em lotes: 1, 2, 3, 1000, 2000. Cada seed mostra uma interpretação diferente da mesma descrição. É mais rápido do que reescrever o prompt e revela composições, tratamentos de luz e paletas de cor inesperados, que você nunca pensaria em descrever manualmente.
Modelos como o Flux 2 Pro e o Imagen 4 respondem fortemente à variação de seed, fazendo o mesmo prompt produzir atmosferas e cenários radicalmente diferentes sem esforço extra.
O ControlNet muda o que é possível
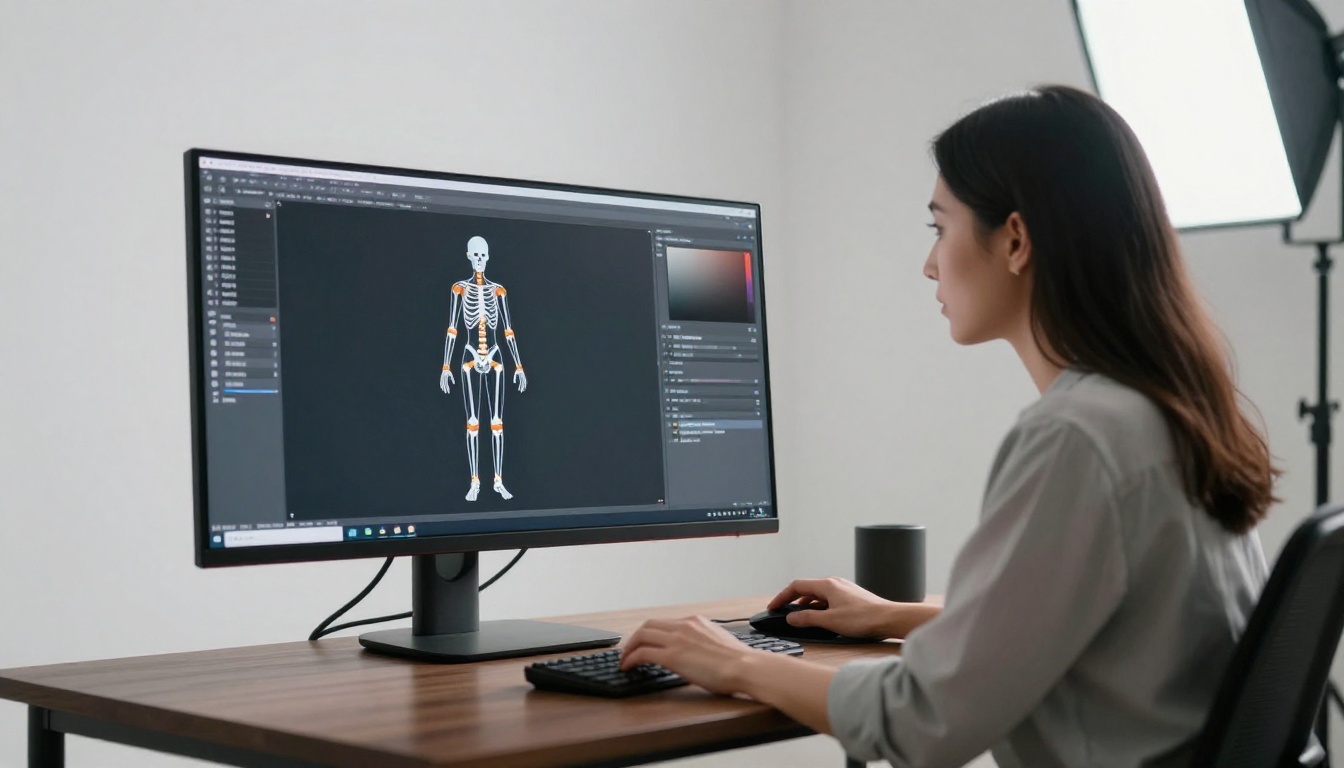
O ControlNet não é apenas um recurso. É uma forma fundamentalmente diferente de gerar. Em vez de o texto ser sua única entrada, você adiciona um guia estrutural: um esqueleto de pose, um mapa de bordas, um mapa de profundidade ou um simples rabisco. O modelo então gera dentro dessas restrições.
Travamento de pose com mapas de esqueleto
O uso mais comum é o controle de pose. Você envia uma imagem de referência mostrando a posição de um corpo, o ControlNet extrai um esqueleto, e a nova geração herda essa pose exata enquanto aplica seu prompt de texto por cima. O resultado: controle criativo total sobre aparência e linguagem corporal ao mesmo tempo.
O SDXL Multi ControlNet LoRA no PicassoIA permite empilhar várias entradas de ControlNet ao mesmo tempo. Você pode travar pose, profundidade e detecção de bordas de uma só vez, o que reduz bastante o número de tentativas necessárias para chegar a uma composição específica. O que antes levava vinte gerações para ficar certo pode acertar na segunda ou terceira tentativa.
Do rabisco à imagem estruturada
O ControlNet Scribble é a variante mais criativa da família ControlNet. Você desenha uma forma aproximada com o mouse ou uma caneta digital. O modelo interpreta o desenho como uma planta estrutural e preenche com detalhes fotorrealistas de acordo com seu prompt de texto. Um oval irregular com dois círculos vira um rosto. Uma linha horizontal com saliências irregulares vira uma cordilheira.
Esse fluxo de trabalho é especialmente poderoso para quem tem dificuldade de descrever composições espaciais com palavras. Desenhar é mais rápido do que explicar, e os resultados muitas vezes surpreendem de um jeito bom.
Escolhendo o modelo certo
Nem todos os modelos são iguais e, mais importante, eles não são bons nas mesmas coisas. Usar o modelo errado para uma tarefa é o principal motivo pelo qual as pessoas obtêm resultados decepcionantes, mesmo com um prompt bem escrito.
Flux, Stable Diffusion ou SDXL
Quando usar variantes Ultra ou Turbo
Variantes Turbo e Schnell, como o Flux Schnell e o SDXL Lightning 4Step, sacrificam um pouco da qualidade de detalhe em troca de velocidade de geração. Use-as na fase de iteração, quando você estiver testando um conceito e não precisar da qualidade final. Mude para o modelo completo só depois de ter um seed, uma composição e um prompt que funcionem.
Variantes Pro e Ultra, como o Flux 1.1 Pro Ultra ou o Stable Diffusion 3.5 Large, são para renderizações finais. A diferença na qualidade aparece nos detalhes finos: fios de cabelo, trama do tecido, textura da pele e profundidade do fundo, tudo se resolve em um nível visivelmente mais alto.
Proporção e resolução não são a mesma coisa
Um erro comum é tratar as dimensões da imagem e a proporção como configurações intercambiáveis. Não são, e confundi-las leva a resultados distorcidos.
Proporção determina a forma da imagem (16:9, 1:1, 9:16). Os modelos são treinados com imagens em proporções nativas específicas. Gerar em uma proporção muito distante dessa distribuição de treinamento produz distorções de composição, rostos esticados ou proporções espaciais estranhas.
Resolução determina a quantidade de pixels nessa proporção. A maioria dos modelos gera em uma resolução base de cerca de 1024 px de largura. Gerar muito acima da resolução nativa causa artefatos de mosaico, porque o modelo preenche os pixels extras repetindo ou distorcendo padrões existentes, em vez de criar detalhes novos e coerentes.
O fluxo certo: gere pequeno, depois amplie
Primeiro gere na resolução nativa do modelo. Acerte a composição, a iluminação e os detalhes nessa escala base. Depois use um upscaler de Super Resolution dedicado para ampliar o resultado 2x ou 4x. Upscalers são treinados especificamente para essa tarefa de ampliação e produzem resultados mais nítidos e coerentes do que tentar gerar na resolução máxima em uma única passagem.
Esse fluxo é mais rápido, usa menos créditos e produz consistentemente uma qualidade final melhor.
Empilhamento de LoRA e mistura de estilos
Os LoRA (Low-Rank Adaptation) são ajustes finos leves de estilo ou de personagem que se acoplam a um modelo base. A maioria dos usuários aplica um LoRA na força total e para por aí. O truque é empilhar vários LoRAs com valores de peso reduzidos para misturar suas influências.
Empilhe LoRAs sem quebrar a imagem
Em vez de aplicar um LoRA na força total (1.0), aplique dois ou três em força parcial, normalmente entre 0,4 e 0,6 cada. Isso mistura as influências estilísticas na geração sem deixar que nenhum deles domine ou sobrescreva o fotorrealismo do modelo base.
Um exemplo prático usando o LoRA p-image no PicassoIA:
- LoRA de iluminação cinematográfica com peso 0,5
- LoRA de detalhe de textura da pele com peso 0,4
- LoRA de fotografia de moda com peso 0,6
O resultado combinado é um estilo composto que nenhum LoRA isolado conseguiria produzir sozinho. A qualidade cinematográfica aparece sem que a textura da pele fique artificial, e a nitidez da fotografia de moda acrescenta um acabamento editorial sem deixar a imagem com aparência processada.
Img2Img como ferramenta de transferência de estilo
A geração de imagem para imagem pega uma imagem existente como entrada e a regenera com seu prompt aplicado por cima. Com uma força de remoção de ruído entre 0,3 e 0,5, o resultado permanece estruturalmente próximo da fonte, enquanto a iluminação, a paleta de cores e a textura se deslocam em direção à sua descrição-alvo.
Esta é a forma mais rápida de aplicar um estilo fotorrealista a um esboço conceitual aproximado, a uma foto de produto sem tratamento ou até a uma captura de tela. As regras são simples:
- Abaixo de 0,5 de remoção de ruído: preserva a composição original de perto
- De 0,5 a 0,7 de remoção de ruído: mistura a estrutura original com a nova direção do prompt
- Acima de 0,7 de remoção de ruído: o modelo gera em grande parte do zero, tratando a entrada apenas como referência vaga
Mantenha a remoção de ruído abaixo de 0,6 quando quiser preservar a composição espacial. Ultrapasse 0,7 apenas quando quiser que o modelo reinterprete a cena livremente.
Como usar o Flux 1.1 Pro no PicassoIA
O Flux 1.1 Pro é um dos modelos de texto para imagem mais fortes disponíveis para trabalhos de retrato fotorrealista e editorial. Aqui está um fluxo de trabalho passo a passo que produz resultados de alta qualidade de forma consistente.
Passo 1: escreva um prompt estruturado em quatro partes
Divida seu prompt em sujeito, ambiente, iluminação e câmera. Por exemplo:
"Uma mulher de cabelo cacheado escuro vestindo um blazer de linho, sentada a uma mesa de café ao ar livre, rua de paralelepípedos atrás, luz difusa suave de céu nublado vinda do alto, lente de retrato de 85mm f/1.8 com profundidade de campo rasa"
Escrever esses quatro elementos em sequência dá ao modelo um contexto hierárquico claro, em vez de uma lista de ideias desconectadas.
Passo 2: defina a proporção para combinar com o enquadramento pretendido
Use 2:3 ou 9:16 para close-ups em formato retrato. Use 16:9 para planos abertos e de apresentação. Use 1:1 para o formato quadrado editorial. O Flux 1.1 Pro tem o melhor desempenho quando a proporção combina naturalmente com o enquadramento do sujeito.
Passo 3: adicione prompts negativos mínimos e direcionados
Para modelos Flux, mantenha os prompts negativos focados: cartoon, illustration, anime, low quality, deformed hands, extra fingers, blurry
Prompts negativos longos, usados com modelos de estilo SDXL, costumam reduzir a qualidade no Flux. Menos é mais.
Passo 4: trave um seed para sua primeira iteração
Defina o seed como qualquer número (por exemplo, 42) para sua primeira geração. Se você obtiver um resultado forte, esse seed se torna a base de todas as variações do mesmo sujeito ou cena.
Passo 5: amplie a melhor versão
Quando tiver uma versão de que esteja satisfeito, passe-a pelo Super Resolution para obter uma ampliação 2x ou 4x limpa. O Flux 1.1 Pro gera com qualidade alta o bastante para que o upscaling preserve, em vez de ampliar, quaisquer imperfeições.
💡 Dica: o Flux 1.1 Pro responde fortemente à terminologia fotográfica. Termos como "iluminação volumétrica", "Kodak Portra 400", "grão de filme", "fotografia RAW" e distâncias focais específicas dão ao modelo âncoras contextuais fortes que empurram o resultado em direção ao fotorrealismo verdadeiro.
O que a maioria nunca testa
A diferença entre resultados médios de IA e uma saída de qualidade profissional quase nunca depende do modelo em si. Depende da precisão do prompt, da disciplina com o seed e de saber quando trocar de ferramenta. Só os prompts negativos melhoram a qualidade do resultado mais do que fazer upgrade para uma faixa de modelo mais cara. A reutilização de seed elimina a maior parte da inconsistência que torna os fluxos de personagem frustrantes. O ControlNet transforma adivinhação espacial em controle exato de composição.
Nada disso exige conhecimento técnico. Exige o uso intencional de recursos que já estão incorporados às ferramentas que você usa hoje.
Se você tem dependido apenas do texto do prompt para fazer todo o trabalho, tem deixado sem uso a maior parte da capacidade do gerador. Os modelos do PicassoIA, do Flux 2 Pro ao Imagen 4 e ao Recraft V4, foram criados para lidar com muito mais nuances do que uma única linha de texto consegue transmitir. O prompt é onde você começa. O controle de seed, a ponderação de atenção, os prompts negativos, o ControlNet e o fluxo de resolução são onde você termina.
Comece a criar no PicassoIA
O PicassoIA oferece acesso direto a mais de 91 modelos de texto para imagem, incluindo o Flux 1.1 Pro Ultra, o GPT Image 1.5, o Stable Diffusion 3.5 Large e o Ideogram V3, tudo em um só lugar. Você pode executar todas as técnicas descritas neste artigo sem trocar de plataforma nem pagar assinaturas separadas por modelo.
Comece com um prompt que você já usou. Aplique prompts negativos. Trave o seed. Compare dois modelos lado a lado usando o mesmo prompt e o mesmo seed. A diferença nos resultados será imediata e óbvia.
A plataforma foi feita exatamente para esse tipo de experimentação. Esse é o objetivo.


